Întrebarea „ce model AI să folosesc în compania mea?" nu are un răspuns universal — și oricine îți promite altceva îți vinde marketing, nu inginerie. În septembrie 2026 există patru ecosisteme dominante care merită analizate pentru orice decizie business: OpenAI cu familia GPT-6 (Astra, Sol, Luna), Anthropic cu Claude Fable 5.1, Opus 5.5 și Sonnet 5, Google cu Gemini 3.1 Pro și Gemini 3.8 Flash și DeepSeek cu seria V4, modele open-weight care au forțat redefinirea pragului de cost. Acest ghid îți oferă un cadru de decizie cu 6 dimensiuni, comparație directă pe categorii relevante pentru business și un proces practic de pilot pe care îl poți rula în 14 zile pentru a alege modelul potrivit cazului tău, nu modelul „cel mai popular".

De ce „cel mai bun model AI" nu există în 2026
Întreaga industrie a tratat în 2024-2025 alegerea modelului AI ca pe o competiție sportivă cu un câștigător clar. Realitatea din 2026 a demolat acest mit. Fiecare familie excelează într-un subset diferit de sarcini: Claude Fable 5.1 e poziționat de Anthropic pentru raționament exigent și sarcini agentice de lungă durată, GPT-6 Astra e cel mai capabil model OpenAI pe cod, matematică, computer use și cercetare, Gemini 3.1 Pro este cel mai bun pe multimodal raționament cu video, iar DeepSeek, cu modele open-weight sub licență MIT, a coborât pragul de cost sub un dolar per milion de tokeni de input.
MMLU este saturat — toate modelele frontier ating 90-92% — deci nu mai e un benchmark util. Clasamentul pe SWE-bench Verified este diferit de clasamentul pe GPQA Diamond, iar performanța pe HumanEval nu prezice performanța pe sarcini juridice sau medicale. Pentru o companie românească, întrebarea corectă nu este „care e cel mai bun model în lume?" ci „care model maximizează rezultatul acceptat per euro cheltuit pe cazul meu specific de utilizare, cu constrângerile mele de conformitate?".
Această schimbare de mindset — de la căutarea unui campion la proiectarea unei arhitecturi multi-model — este tocmai diferența dintre echipele AI mature și cele care încă învață.
Cei patru jucători dominanți în 2026
OpenAI — Familia GPT-6
Familia GPT-6 are trei modele: GPT-6 Astra, disponibil public din 4 septembrie 2026 și cel mai capabil model OpenAI pentru cod, matematică, computer use, cercetare și muncă profesională, plus GPT-6 Sol și GPT-6 Luna, lansate pe 22 septembrie 2026. Toate trei au fereastră de context de 1,05 milioane de tokeni și output de până la 128.000 de tokeni. GPT-5.5, lansat pe 23 aprilie 2026 și prezentat atunci ca primul model nativ omnimodal, este acum cu două generații în urmă. Detalii în analizele noastre despre GPT-6 Astra și GPT-6 Sol și Luna.
Variante disponibile:
- GPT-6 Astra — varianta de top, $10/$50 per milion tokeni input/output (input din cache: $1), pentru sarcinile unde calitatea e critică și costul e secundar.
- GPT-6 Sol — $2/$10 per milion tokeni, nivelul de mijloc al familiei; în ChatGPT, Sol rulează pe planurile plătite.
- GPT-6 Luna — $0,10/$0,50 per milion tokeni, varianta pentru volum mare și cost minim.
- GPT-5.6 (Sol, Terra, Luna) — generația anterioară, încă disponibilă în API pentru pipeline-uri deja calibrate.
La toate modelele GPT-6, dacă inputul depășește 272.000 de tokeni, întreaga cerere se facturează cu 2× la input și 1,5× la output.
Ecosistemul OpenAI rămâne cel mai matur: ChatGPT Enterprise, Codex, Responses API, integrări native cu Microsoft 365 Copilot, Azure OpenAI Service pentru deployment regional UE. Pentru companii deja investite în Microsoft, costul de switching este foarte ridicat — un factor real în decizie, nu doar tehnic.
Anthropic — Familia Claude
Anthropic ocupă o poziție distinctă prin filozofia „safety-first" și investiția în aliniere (Constitutional AI). Familia Claude în 2026:
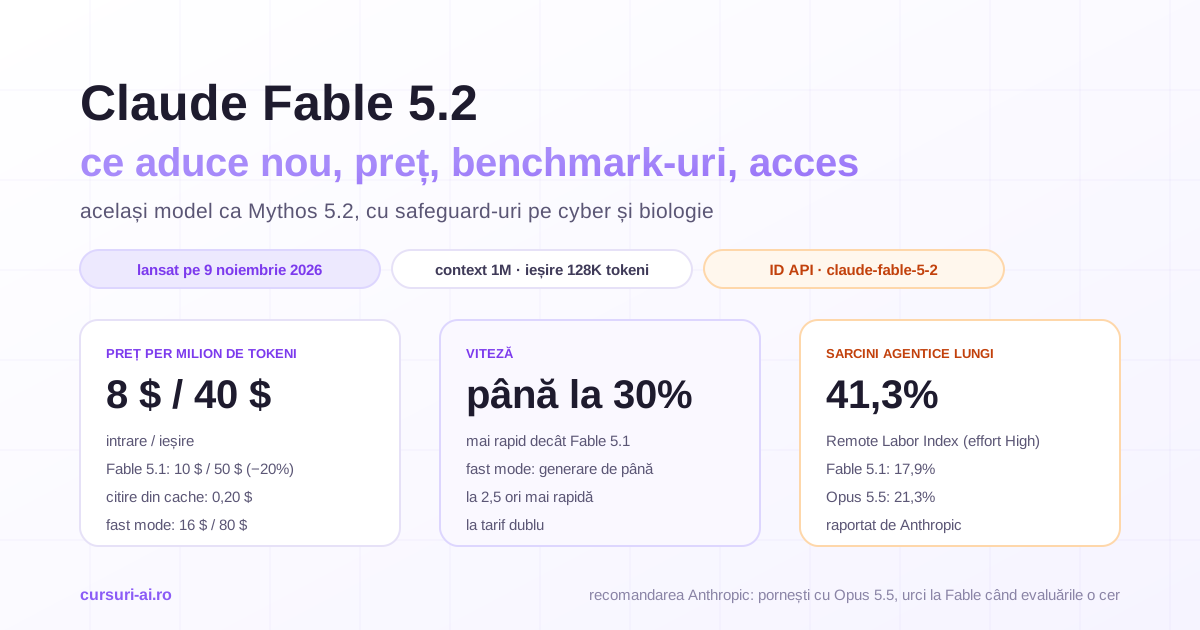
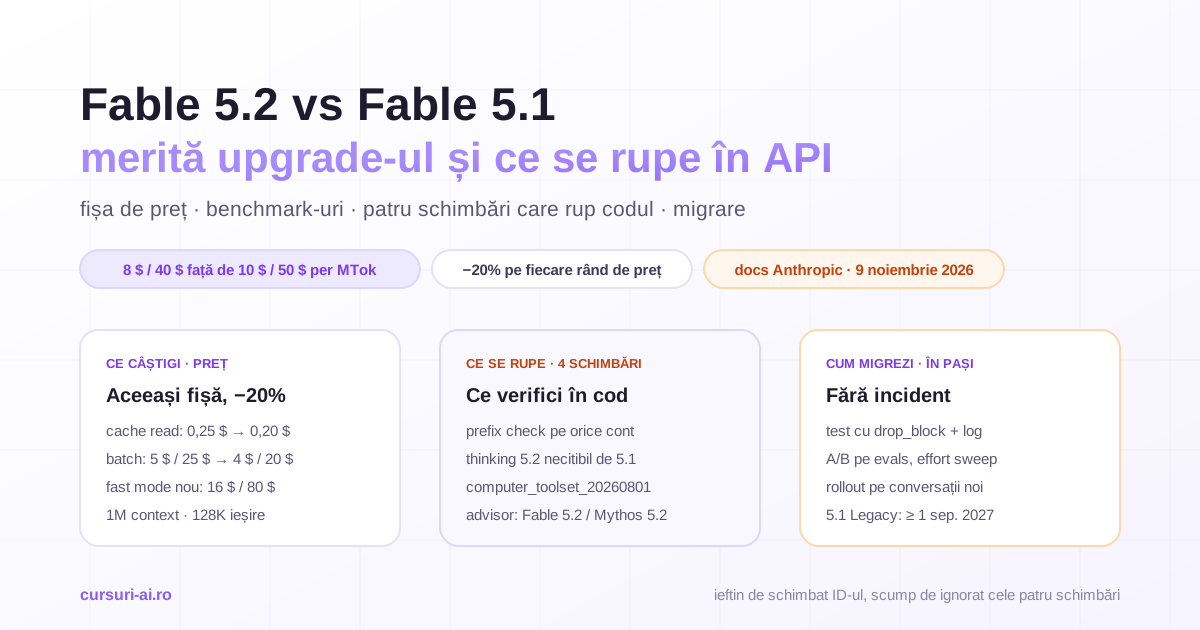
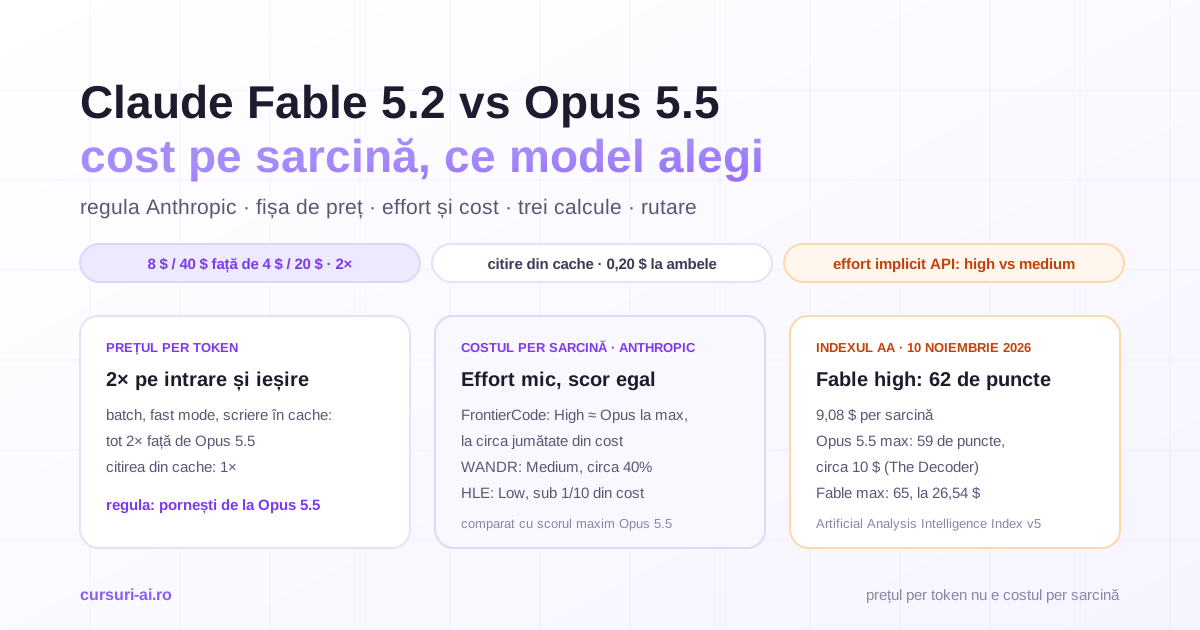
- Claude Fable 5.1 (lansat 1 septembrie 2026) — cel mai capabil model Anthropic, pentru raționament exigent și sarcini agentice de lungă durată. Context 1M tokeni, $10/$50 per milion tokeni input/output.
- Claude Opus 5.5 (lansat 22 septembrie 2026) — recomandarea implicită: documentația Anthropic spune că, dacă nu știi ce model să alegi, pornești de la Opus 5.5. Context 1M tokeni, $4/$20.
- Claude Sonnet 5 (lansat 30 iunie 2026) — modelul balanced, $2/$10, context 1M.
- Claude Haiku 4.5 — rapid și economic, $1/$5, context 200K. Ideal pentru clasificare, extracție entități, sumarizare la volum mare. Din 7 octombrie 2026, treapta mică este Claude Haiku 5.5, la 0,10 $ / 0,50 $ pe un milion de tokeni pentru prompturi de cel mult 100.000 de tokeni.
Opus 4.7, Opus 4.8, Opus 5 și Sonnet 4.6 au trecut la statutul de modele legacy. Când merită diferența de preț dintre Opus 5.5 și Fable 5.1 am analizat separat, în Claude Opus 5.5 vs Fable 5.1.
Avantajul distinct al Anthropic pentru piața europeană: Anthropic nu folosește datele clienților API pentru antrenament, iar contractele enterprise oferă garanții explicite GDPR. Pentru organizații cu DPO funcțional și risc reputațional ridicat (financiar, juridic, sănătate), Claude tinde să fie alegerea care trece mai ușor de comitetul de risc.
Ecosistemul include Claude Code (CLI agentic pentru development), MCP (Model Context Protocol — standard deschis pentru conectarea modelelor la unelte și date) și integrare prin Amazon Bedrock plus Google Vertex AI.
Google — Gemini 3.1 Pro și Gemini 3.8 Flash
Google a continuat investiția masivă în multimodalitate și eficiență. Modelele relevante pentru business în septembrie 2026:
- Gemini 3.1 Pro (Preview,
gemini-3.1-pro-preview) — flagship, context 1M, $2/$12 pentru prompturi de până la 200K tokeni ($4/$18 peste). Performanță de top pe GPQA Diamond și raționament multimodal. Capacitățile native de procesare video și audio sunt cele mai bune din industrie. - Gemini 3.8 Flash (lansat 2 septembrie 2026) — cel mai nou Flash, $0,75/$3,75 per milion tokeni până la 31 decembrie 2026, apoi $1,50/$7,50.
- Gemini 3.1 Flash-Lite — optimizat cost și viteză, $0,25/$1,50 per milion tokeni. Ideal pentru producție cu volum mare.
- Gemini 3.8 Live — specializat interacțiuni real-time: voice, video streaming, latență minimă.
- Deep Think — mod de raționament extins din aplicația Gemini, nu un model separat în API.
Avantajul Google pentru business: integrarea nativă cu Google Workspace (Gmail, Docs, Sheets, Drive), context caching cu reduceri până la 90% din cost (critic pentru aplicații care procesează repetat documente mari), și ecosistemul extins — Veo 3.1 (generare video), Lyria 3 (muzică), Google Antigravity (orchestrare multi-agent), protocolul A2A v1.0 (Agent-to-Agent) adoptat de peste 150 organizații.
DeepSeek — Disrupția prin cost
DeepSeek a demonstrat că performanța frontier nu necesită bugete astronomice:
- DeepSeek V4.1-Flash (
deepseek-flash) — context 1M tokeni, licență MIT, suportă input de imagine. În API costă $0,30 input (fără cache) și $1,20 output per milion tokeni în orele de vârf, la jumătate în rest. Pentru organizații cu volume mari și buget restrâns, e imposibil de ignorat. - DeepSeek V4-Pro (
deepseek-v4-pro) — modelul mare al seriei (1,6T parametri, 49B activi), context 1M, $1,32/$3,96 per milion tokeni în orele de vârf. Ambele modele au mod de raționament (thinking) și mod rapid. - Endpoint-urile vechi
deepseek-chatșideepseek-reasonerau fost retrase după 24 iulie 2026, iar V3.2 și R1 sunt generații depășite.
Avantajul fundamental: open-weight. Companiile pot rula modelele on-premise, fine-tune pe date proprietare, fără dependență de API extern. Dezavantajul: costul infrastructurii (GPU-uri H100/H200) și expertiza necesară pentru operare. Plus considerente geopolitice — DeepSeek e o companie chineză, ceea ce ridică întrebări legitime de governance pentru anumite verticale (apărare, infrastructură critică, date guvernamentale).

Cadrul de decizie cu 6 dimensiuni
Echipele AI mature nu aleg modelul după benchmark-uri publice. Aleg după un cadru cu șase dimensiuni evaluate simultan, cu ponderi specifice cazului de utilizare.
1. Performanță pe sarcina ta specifică
Benchmark-urile publice (MMLU, HumanEval, GPQA) sunt utile ca filtru inițial, dar nu prezic performanța pe datele tale. Construiește un eval set propriu cu 50-200 de exemple reprezentative pentru cazurile reale din business — inclusiv edge case-uri, instrucțiuni ambigue și sarcini din zona ta gri. Rulează același eval pe toate modelele candidate și măsoară rata de rezultate acceptabile (passed criteria definite explicit, nu „pare ok").
Clasamentele publice se schimbă la fiecare lansare, așa că tratează-le ca pe o fotografie datată: în aprilie 2026, Claude Opus 4.7 obținea 87,6% pe SWE-bench Verified; în septembrie 2026, OpenAI raporta pentru GPT-6 Astra 96,0% pe GPQA Diamond. Pentru sumarizare și clasificare la volum mare, punctul de plecare sunt modelele mici și ieftine (Claude Haiku 4.5, GPT-6 Luna, Gemini 3.8 Flash, DeepSeek V4.1-Flash), iar eval set-ul tău decide care dintre ele trece pragul de calitate.
2. Cost per rezultat acceptat (nu cost per token)
Aceasta este metrica pe care echipele AI mature o folosesc, iar comitetele financiare o cer:
Cost real = (cost input + cost output) × tokens per task × 1 / rate_de_acceptare
Un model la $30/M output care răspunde corect la 95% din încercări poate fi mai ieftin decât unul la $5/M cu rată de acceptare de 60% care necesită 3 re-încercări. Calculează pe cazurile tale reale, nu extrapola din pricing list.
Pentru o sarcină tipică enterprise — extragere structurată din contracte de 20 pagini cu validare — am văzut diferențe de 4× în cost real între modele cu pricing similar pe foaie.
3. Latență la volumul tău de producție
Latența medie pe API documentation este utilă, dar irelevantă pentru producție. Ce contează:
- P95 latency — al 95-lea percentil, nu media
- Latency under load — cum se comportă modelul când rulezi 100 requests/sec, nu unul
- Time-to-first-token vs total time — pentru aplicații conversaționale, primul token rapid e critic
- Cold start și rate limiting în regiunea ta — UE West vs US East au comportament diferit
Pentru aplicații real-time (voice, suport client live), pornește de la modele gândite pentru latență mică, precum Gemini 3.8 Live pentru voce sau Claude Haiku 4.5 pentru text. Pentru batch processing peste noapte, latența nu mai contează — costul devine factor unic.
4. Context window și gestionarea acestuia
Toate modelele flagship oferă acum 1M tokeni context. Întrebarea relevantă nu mai este „cât de mare e contextul" ci cât de bine își menține modelul performanța la 80% din context. Studiile interne ale fiecărui furnizor arată o degradare a calității între 50-90% utilizare context — dar curba e diferită pentru fiecare model.
Comportamentul la context lung se schimbă de la o generație la alta, deci nu transfera concluziile de la un model vechi la succesorul lui: testează pe documentele tale. Diferențele care se pot verifica pe hârtie sunt de preț: la GPT-6, peste 272.000 de tokeni de input întreaga cerere costă 2× la input și 1,5× la output, iar la Gemini 3.1 Pro prompturile de peste 200.000 de tokeni trec de la $2/$12 la $4/$18. DeepSeek, care la V3.2 avea doar 128K, oferă acum 1M tokeni în seria V4.
Context caching (oferit de Google și Anthropic) reduce dramatic costul pentru aplicații care procesează același document repetat — până la 90% reducere la Google, 90% la Anthropic prin prompt caching. Pentru un sistem de Q&A pe documentație internă, această diferență poate transforma un proiect neviabil într-unul profitabil.
5. Conformitate, securitate și suveranitate date
Pentru companii românești, cinci aspecte legale impactează direct alegerea:
- GDPR — toți cei patru furnizori oferă DPA-uri (Data Processing Agreement) și opțiuni de procesare în UE. Verifică explicit în contract că datele tale nu sunt folosite la antrenament (default la Anthropic și Google enterprise; opt-out la OpenAI).
- EU AI Act — pentru sisteme AI clasificate high-risk (recrutare, scoring credit, securitate), ai nevoie de furnizori care oferă documentație tehnică completă, audit trail și mecanisme de supraveghere umană. Anthropic și Google au răspuns cel mai rapid cu documentație conformă; OpenAI a recuperat în 2026.
- Suveranitatea datelor — pentru sectoare reglementate (financiar BNR, sănătate, apărare), procesarea trebuie să se facă în UE. Toate cele trei mari (OpenAI prin Azure, Anthropic prin Bedrock UE, Google prin Vertex AI EU) oferă deployment regional. DeepSeek nu oferă deployment UE oficial — un blocker pentru multe industrii.
- Confidențialitate IP — codul tău, datele tale, prompturile tale sunt active strategice. Audit-urile de securitate ale procesării lor sunt obligatorii înainte de orice deployment producție.
- Audit logs — pentru ANSPDCP, BNR, ASF sau orice autoritate de supraveghere, ai nevoie de jurnale complete de procesare. Verifică ce oferă fiecare furnizor și pentru câte luni reține log-urile.
6. Ecosistem, integrare și total cost of ownership
Costul real al unui model AI nu este pricing-ul API. Este suma a:
- Licența / costul tokenilor
- Infrastructura (proxy, gateway, monitoring, observability)
- Integrarea cu sistemele existente (ERP, CRM, ITSM, baze de date)
- Formarea echipelor și suportul ongoing
- Costul de switching când inevitabil schimbi modelul
Pentru o companie deja pe Microsoft 365 cu Power Platform, modelele OpenAI prin Azure au cel mai mic cost de integrare. Pentru o companie pe Google Workspace, Gemini 3.1 e alegerea naturală. Pentru companii care construiesc produse AI proprii cu cerințe stricte de calitate, Anthropic prin Bedrock oferă cel mai bun raport calitate-control. Pentru companii cu volum masiv și sensibilitate de cost extremă, candidații sunt DeepSeek (open-weight, rulabil on-premise) și modelele mici ale furnizorilor mari, precum GPT-6 Luna, care la prețul de listă e chiar mai ieftin.
Comparație directă pe cazuri de utilizare business
Generare de conținut și marketing
Verdict: Claude Sonnet 5 sau GPT-6 Sol.
Claude excelează pe ton natural în limba română și nuanță stilistică — articolele, email-urile și conținutul long-form sunt vizibil mai naturale. Modelele GPT sunt ușor mai versatile pe formate diverse (twitter threads, ad copy, product descriptions), iar ecosistemul OpenAI acoperă și generarea de imagini, pentru un pipeline complet text + imagine. Gemini 3.1 e suficient, dar tonul în română rămâne mai mecanic. DeepSeek nu este recomandat pentru conținut vizibil clienților — calitatea în română e clar inferioară.
Suport client și chatbot
Verdict: Gemini 3.8 Live pentru voice, Haiku 4.5 sau GPT-6 Luna pentru text high-volume, Sonnet 5 pentru cazuri complexe escaladate.
Arhitectura tipică: Haiku 4.5, GPT-6 Luna sau Gemini Flash-Lite ca prim layer pentru întrebări frecvente (FAQ, status comandă, informații generice), cu escaladare la Sonnet 5 pentru cazuri care necesită raționament sau acces la sisteme multiple. Pentru voice agents, Gemini 3.8 Live e construit pentru conversație în timp real, cu latență mică; testează-l pe scenariile tale înainte de lansare.
Coding și development assistant
Verdict: Claude Opus 5.5 sau Sonnet 5, cu Fable 5.1 pentru sarcinile cele mai grele.
Claude Code (CLI-ul Anthropic), care rulează implicit pe Opus 5.5, e construit pentru editare de cod în proiecte mari. Înțelegerea contextului pe sute de fișiere, refactorizarea cu păstrarea convențiilor codebase-ului și debugging-ul complex sunt zone unde Anthropic conduce. Modelele OpenAI, prin Codex, sunt un competitor serios; în Cursor, autocompletarea (Tab) rulează pe modelul propriu al Cursor, iar alegerea LLM-ului contează în chat și în modul agent. Pentru o analiză detaliată a comparației, vezi articolul nostru Claude Code vs Cursor vs GitHub Copilot.
Analiză documente și extracție structurată
Verdict: Claude Opus 5.5 pentru documente complexe, Gemini 3.1 Pro pentru documente cu imagini/tabele scanate.
Pentru contracte juridice, rapoarte financiare lungi și documente structurate text-only, pornește de la Opus 5.5 și măsoară pe eval set-ul tău acuratețea extracției și respectarea schemei de output. Pentru documente cu PDF-uri scanate, formulare cu checkbox-uri, tabele din imagini — Gemini 3.1 Pro este superior datorită OCR-ului nativ integrat în model. Pentru volum mare cu structură simplă, modelele ieftine (DeepSeek V4.1-Flash, GPT-6 Luna, Gemini 3.8 Flash) merită testate, dacă acuratețea măsurată pe datele tale e acceptabilă.
Cercetare și raționament științific
Verdict: GPT-6 Astra sau Claude Fable 5.1, la efort de raționament ridicat.
Pentru sarcini care necesită raționament științific extins — analiză de literatură medicală, calcule complexe, design experimental — modelele de tip „extended thinking" sunt clar superioare. GPT-6 Astra (cu efort de raționament reglabil până la max) și Claude Fable 5.1 (cu thinking mereu activ) alocă timp și resurse computaționale per întrebare, oferind răspunsuri pe care modelele standard le ratează; în aplicația Gemini, modul Deep Think face același lucru.
Aplicații cu volum mare și sensibilitate de cost
Verdict: GPT-6 Luna, DeepSeek V4.1-Flash sau Haiku 4.5.
Clasificare emails, moderare conținut, sumarizare batch, scoring lead-uri — toate aplicații unde costul per task contează mai mult decât ultimul 5% din calitate. La prețul de listă, GPT-6 Luna ($0,10/$0,50 per milion tokeni) și DeepSeek V4.1-Flash ($0,30/$1,20 în orele de vârf, jumătate în rest) sunt cele mai ieftine; Gemini 3.1 Flash-Lite ($0,25/$1,50) și Haiku 4.5 ($1/$5) rămân opțiuni la cost rezonabil pentru volume foarte mari.

Arhitectura multi-model: alegerea matură
Echipele AI care livrează valoare reală în 2026 nu folosesc un singur model. Folosesc o arhitectură multi-model unde rutarea task-urilor către modele diferite se face automat, în funcție de complexitate, cost și cerințe specifice.
Pattern-uri tipice în producție:
-
Cascadă — încearcă modelul ieftin (Haiku 4.5, GPT-6 Luna sau DeepSeek V4.1-Flash) pentru task-uri simple. Dacă outputul nu trece de validare automată, escaladează la modelul mediu (Sonnet 5 sau GPT-6 Sol). Pentru cazuri marcate ca high-stakes sau care eșuează din nou, ajunge la flagship (Opus 5.5, Fable 5.1 sau GPT-6 Astra). Reduce costul cu 60-80% față de a folosi modelul flagship pe tot.
-
Specializare pe domeniu — Claude pentru cod și raționament juridic, modelele OpenAI pentru creativ și pipeline-uri text+imagine, Gemini pentru video și voice real-time, DeepSeek pentru clasificare batch. Un router intern direcționează request-urile către modelul optim per task type.
-
Fallback și redundanță — toate modelele majore au incidente de disponibilitate. Pentru aplicații critice, ai nevoie de fallback automat între cel puțin doi furnizori, cu păstrarea latency budget. Anthropic plus OpenAI, sau Anthropic plus Google sunt combinațiile cele mai robuste.
-
Validare cross-model — pentru output-uri high-stakes (extras juridic, recomandări medicale, decizii financiare), un model second-opinion validează rezultatul primarului înainte ca acesta să fie afișat utilizatorului. Costul aproape se dublează, dar reduce dramatic riscul de halucinație și acțiune greșită.
Construirea unei astfel de arhitecturi nu este trivială. Implică gateway-uri AI (LiteLLM, Portkey, Helicone), evaluare continuă în producție, monitoring drift, alerting pe quality regression. Acestea sunt competențe de inginerie AI senioră — nu se învață în câteva tutoriale online.
Cinci capcane de selecție pe care le văd la majoritatea companiilor
1. „Folosim ChatGPT pentru că e popular". Popularitatea nu e calitate. Pentru cazul tău, alt model poate fi cu 30% mai ieftin și 15% mai bun. Datele decid, nu marketingul.
2. „Ne-am angajat exclusiv la un singur furnizor". Single-vendor lock-in pentru AI e o decizie strategică riscantă. Furnizorii își ajustează prețurile (în aprilie 2026, OpenAI a dublat prețul la GPT-5.5 față de GPT-5.4), modelele se depreciază, incidentele apar. Arhitectura ta trebuie să fie multi-model by design, chiar dacă în practică folosești 90% un singur furnizor.
3. „Ne-am uitat doar la pricing per token". Cum am arătat mai sus, costul real e calculat per rezultat acceptat. Un model care pare scump poate fi cel mai ieftin în practică — și invers.
4. „Am ales pe baza unei demonstrații live". Demo-urile sunt cherry-picked. Singura validare credibilă e un pilot real de 14 zile pe traficul tău, cu evaluare pe eval set-ul tău. Tot restul e teatru.
5. „Conformitatea o rezolvăm la sfârșit". Pentru sectoare reglementate (financiar, sănătate, juridic), conformitatea trebuie să fie criteriu de selecție de la început, nu addendum la final. Schimbarea modelului după ce ai construit aplicația costă de 5-10× mai mult decât integrarea conformității din ziua unu.
Cum rulezi un pilot serios de 14 zile
Pentru orice decizie de model AI cu impact business real, recomand acest proces:
Ziua 1-2: Definirea cazului și a criteriilor. Ce sarcini vor rula prin model? Care sunt criteriile de calitate? Care e bugetul lunar la volumul așteptat? Care sunt cerințele de conformitate?
Ziua 3-5: Construirea eval set-ului. Adună 100-200 exemple reale din business. Pentru fiecare, definește output-ul corect (sau acceptabil — adesea sunt mai multe variante valide). Include 20% edge case-uri — situații ambigue, input-uri rele, sarcini la limita scope-ului.
Ziua 6-9: Rularea pe toate modelele candidate. GPT-6 Sol, Claude Opus 5.5 sau Sonnet 5, Gemini 3.1 Pro, DeepSeek V4.1-Flash — minim. Măsoară pe fiecare: rata de acceptare, latență P95, cost real. Notează observații calitative — unde greșesc fiecare?
Ziua 10-12: Shadow testing pe trafic real. Rulează modelele candidate în paralel cu sistemul existent (sau între ele) pe 5-10% din trafic. Compară output-urile. Aici descoperi probleme pe care evaluarea sintetică le ratează.
Ziua 13-14: Decizia și plan de implementare. Sintetizează rezultatele. Calculează cost per rezultat acceptat la volumul lunar așteptat. Verifică conformitatea finală. Decide arhitectura — single model, cascadă, multi-model — și plan de rollout cu monitoring.
Acest proces nu e opțional pentru orice deployment serios. E diferența dintre o decizie informată și o speculație care va costa de 3× bugetul prevăzut în primul an.
Cum te ajută cursurile Cursuri AI să iei decizia corectă
Alegerea unui model AI pentru business este o competență strategică, nu doar tehnică. Cursurile noastre te pregătesc pentru această decizie din mai multe unghiuri:
Comparație Modele AI 2026 (Enterprise Edition) — programul complet de 24+ ore care acoperă exact ce am rezumat aici și mult mai mult: metodologie de evaluare cu benchmark-uri custom, comparații pe cazuri de utilizare reale, modelare de costuri, arhitecturi multi-model, governance enterprise, strategii de hedging între furnizori. E cursul pe care îl parcurg AI Engineers și CTO-urile care construiesc strategia AI a companiei.
AI System Architecture — pentru arhitecții de sisteme și echipele care proiectează aplicații AI scalabile. Acoperă pattern-uri multi-model, fallback și redundanță, gateway-uri AI, observability, performance engineering. Complementează perfect cursul de comparație modele — unul te învață ce alegi, celălalt cum construiești.
AI pentru CEO și Lideri Business — pentru directori executivi și board members care trebuie să înțeleagă landscape-ul fără a deveni experți tehnici. Acoperă strategie AI la nivel de companie, decizii de investiție, governance, KPI-uri, EU AI Act, comunicare cu echipele tehnice. Dacă ești CEO-ul care semnează contractul cu OpenAI sau Anthropic, acest curs te asigură că nu semnezi orb.
Toate cursurile sunt în limba română, cu profesor virtual AI integrat pentru întrebări contextualizate, exemple concrete din piața românească și sunt actualizate periodic pe măsură ce apar modele și capacități noi.
Întrebări frecvente
Care este cel mai bun model AI pentru business în 2026? Nu există un „cel mai bun" universal — fiecare familie excelează pe un subset diferit de sarcini. În septembrie 2026, Claude Fable 5.1 e vârful Anthropic pentru raționament exigent și sarcini agentice lungi, iar Opus 5.5 e recomandarea implicită; GPT-6 Astra e cel mai capabil model OpenAI; Gemini 3.1 Pro este cel mai bun pe raționament multimodal cu video, iar DeepSeek V4.1-Flash și GPT-6 Luna coboară pragul de cost sub un dolar per milion de tokeni de input. Întrebarea corectă este care model maximizează rezultatul acceptat per euro cheltuit pe cazul tău specific, cu constrângerile tale de conformitate.
Cum compari corect costurile modelelor AI? Nu după prețul per token, ci după costul per rezultat acceptat: cost input plus output, înmulțit cu tokenii per sarcină și împărțit la rata de acceptare. Un model la 30 de dolari per milion de tokeni output care răspunde corect în 95% din încercări poate fi mai ieftin decât unul la 5 dolari cu rată de acceptare de 60%, care necesită trei re-încercări. Pe o sarcină tipică enterprise, diferențele de cost real pot ajunge la 4x între modele cu pricing similar.
Ce este o arhitectură multi-model și de ce e recomandată? Echipele AI mature nu folosesc un singur model, ci rutează automat task-urile către modele diferite în funcție de complexitate, cost și cerințe. Pattern-urile tipice sunt cascada (model ieftin întâi, escaladare la flagship doar când e nevoie — reduce costul cu 60-80%), specializarea pe domeniu, fallback-ul între cel puțin doi furnizori pentru redundanță și validarea cross-model pentru output-uri high-stakes, care reduce dramatic riscul de halucinație.
Concluzie: alegerea modelului este o competență, nu o căutare
Diferența dintre companiile care livrează valoare reală cu AI în 2026 și cele care ard buget fără rezultate nu este accesul la modele — toate au acces la aceiași patru jucători. Diferența este competența de a alege strategic, evalua riguros și construi arhitecturi care evoluează odată cu peisajul.
GPT-6 nu e mai bun decât Claude Opus 5.5. Gemini 3.1 nu e inferior Anthropic. DeepSeek nu e doar pentru cei săraci. Fiecare are scenariile în care domină și scenariile în care e alegerea greșită. Saltul calitativ pentru organizația ta vine atunci când nu mai întrebi „care e cel mai bun?" și începi să întrebi „care e cel mai bun pentru sarcina X cu constrângerile Y, validat pe datele Z?".
Aceasta este competența pe care comitetele de investiție o caută la responsabilii de AI în 2026. Aceasta este diferența între un buget AI care produce ROI și unul care produce slide-uri de PowerPoint.
Investiția în înțelegerea profundă a peisajului AI — nu a unui singur instrument — este cea care diferențiază profesionistul strategic de consumatorul de hype. În deceniul următor, capacitatea de a alege corect modelul AI per caz va fi la fel de fundamentală cum este astăzi alegerea bazei de date sau a cloud provider-ului.
Surse și resurse pentru aprofundare

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.