Grok 4.7 a fost anunțat de xAI pe 21 septembrie 2026, la nici șase săptămâni după Grok 4.6, cu același preț de listă și cu scoruri mai mari pe fiecare test din tabelul publicat. Partea interesantă nu e însă tabelul, ci două lucruri pe care anunțul le arată fără să le sublinieze: modelul pierde clar pe câteva teste în fața concurenței, iar costul real al unei sarcini depinde mai mult de nivelul de efort ales decât de prețul per token.
Ce este Grok 4.7 și ce spune xAI că a schimbat
În anunțul oficial, xAI (site-ul apare acum sub marca SpaceXAI) descrie Grok 4.7 drept cel mai capabil model al său pentru coding și muncă de birou bazată pe cunoștințe: „lucrează mai mult timp la sarcini dificile, își verifică mai atent propria muncă” și vine cu un set nou de mecanisme de siguranță. Tot acolo apar trei afirmații tehnice, fără alte detalii:
- folosește un model de bază nou, mai mare decât cel al lui Grok 4.6;
- a trecut printr-o rundă mai lungă de reinforcement learning, pe un amestec mai greu de sarcini, „ponderat spre probleme care durează multe ore”;
- a fost antrenat să înțeleagă nativ mediul de lucru din Grok Bot, produsul de agenți persistenți al companiei.
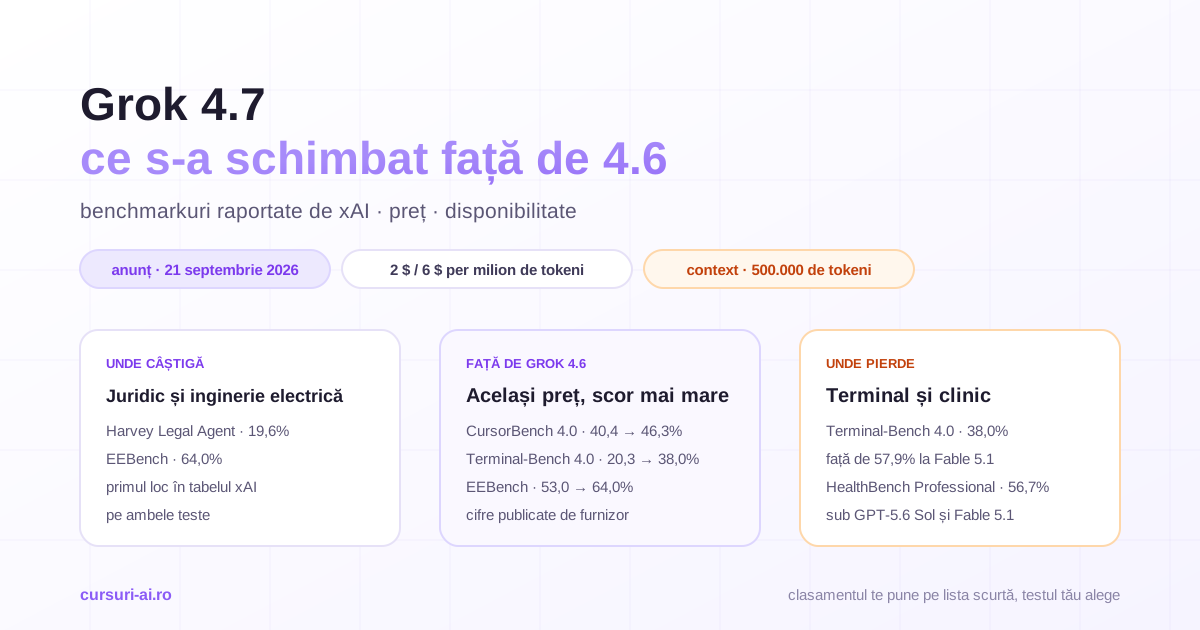
Documentația pentru dezvoltatori completează fișa tehnică: numele de model în API este grok-4.7, fereastra de context este de 500.000 de tokeni, data-limită a cunoștințelor este mai 2026, intrarea acceptă text și imagini, ieșirea este doar text, iar raționamentul are patru niveluri — low, medium, high (implicit) și xhigh — și nu poate fi dezactivat.
Ce nu apare în anunț: numărul de parametri, o fișă de model sau de sistem, metodologia de rulare a testelor, intervale de încredere pentru scoruri.
Pentru context: versiunea anterioară este analizată în articolul despre Grok 4.6, iar comparația pe criterii de producție cu modelele OpenAI și Anthropic — în Grok 4.6 vs GPT-5.6 Sol vs Claude Opus 5. Aici ne uităm strict la ce s-a schimbat și la cum verifici singur dacă schimbarea contează pentru tine.
Grok 4.7 vs Grok 4.6: tabelul delta
Toate cifrele de mai jos sunt din tabelul publicat de xAI. Coloana Grok 4.7 este rulată la efort xHigh, coloana Grok 4.6 la High. Diferența e calculată de noi, în puncte procentuale.
| Test (ce măsoară, în formularea xAI) | Grok 4.6 (High) | Grok 4.7 (xHigh) | Diferență |
|---|---|---|---|
| CursorBench 4.0 (inginerie software) | 40,4% | 46,3% | +5,9 pp |
| DeepSWE v1.1 (inginerie software) | 65,2% | 71,0%* | +5,8 pp |
| EEBench (inginerie electrică) | 53,0% | 64,0% | +11,0 pp |
| AA Briefcase v1.1 (muncă de birou de mai multe ore) | 1.546 | 1.657 | +111 puncte |
| Terminal-Bench 4.0 (lucru de mai multe ore în terminal) | 20,3% | 38,0% | +17,7 pp |
| Harvey Legal Agent Benchmark (muncă juridică) | 15,8% | 19,6% | +3,8 pp |
| HealthBench Professional (raționament clinic) | 48,5% | 56,7% | +8,2 pp |
| GDPval (muncă profesională, scor Elo) | 1.605 | 1.695 | +90 puncte |
* Scorul Grok 4.7 pe DeepSWE este raportat la efort „high”, nu „xHigh” — nota aparține xAI.
Trei observații înainte să tragi concluzii din tabel:
- Nivelurile de efort nu sunt aceleași. Grok 4.6 e măsurat la
High, Grok 4.7 laxHigh. Anunțul nu separă efectul modelului de cel al efortului suplimentar. Graficul de cost per sarcină de mai jos ajută: pe CursorBench 4.0, Grok 4.7 laHighobține 43,9% — deci tot peste cei 40,4% ai lui 4.6 la același nivel, dar cu un avans de 3,5 puncte, nu de 5,9. - Cifrele pentru 4.6 nu coincid cu cele din august. La lansarea Grok 4.6, xAI raporta 65,9% pe DeepSWE 1.1; în tabelul de acum, același model apare cu 65,2%. Pagina nu explică diferența; tratează zecimalele ca orientative.
- Versiunile de test s-au schimbat. În august se raportau CursorBench 3.2 și Terminal-Bench 3.0; acum, CursorBench 4.0 și Terminal-Bench 4.0. Un 46,3% pe versiunea 4.0 nu se compară cu un 69,9% pe versiunea 3.2 — sunt examene diferite.
Grok 4.7 benchmarks: unde câștigă și unde pierde
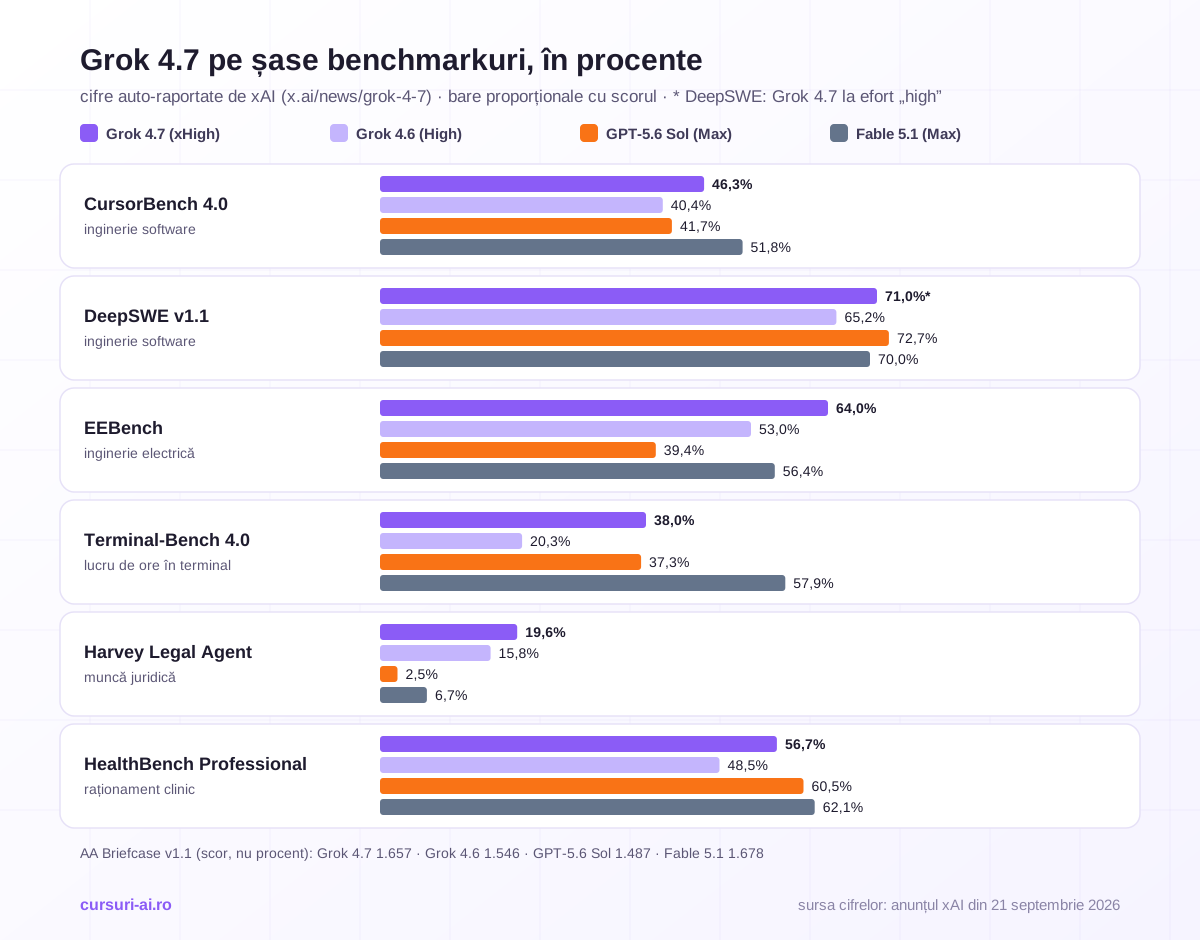
Aceleași teste, cu toate cele patru coloane din tabelul xAI; GPT-5.6 Sol și Fable 5.1 sunt rulate la efort Max.
| Test | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
Pe GDPval, comparația din anunț este cu alt set de modele: Fable 5.1 (max) 1.735, Grok 4.7 (xhigh) 1.695, Grok 4.6 (high) 1.605, GPT-6 Astra (max) 1.542.
Pe scurt: Grok 4.7 este pe primul loc la două teste din șapte (EEBench și Harvey), pe locul al doilea la patru și pe locul al treilea la HealthBench Professional. Nu este liderul tabelului pe care chiar furnizorul l-a ales.
Ce înseamnă fiecare test, pe înțelesul unui om de business
Descrierile de mai jos urmează etichetele din anunț; xAI nu publică acolo metodologia detaliată a niciunui test.
- CursorBench 4.0 și DeepSWE v1.1 — inginerie software. Despre CursorBench 4.0, anunțul spune că „pune accent pe sarcini de coding de durată mai lungă”. Pentru un manager: cât de des duce agentul la capăt o modificare reală într-un proiect. Pe CursorBench, Grok 4.7 e la 5,5 puncte sub Fable 5.1; pe DeepSWE, cele trei modele de vârf sunt la mai puțin de trei puncte distanță, adică practic la egalitate.
- Terminal-Bench 4.0 — lucru de mai multe ore în terminal. Aici e cel mai mare salt față de 4.6 (aproape dublu) și, în același timp, cea mai mare distanță față de lider: 38,0% față de 57,9%. Dacă agentul tău administrează servere sau depanează un pipeline din linia de comandă, acesta e testul care te privește — și nu e în favoarea lui Grok 4.7.
- EEBench — inginerie electrică. Un test de nișă, pe care Grok 4.7 conduce cu 7,6 puncte. Relevant pentru proiectare hardware; irelevant pentru majoritatea firmelor de servicii.
- AA Briefcase v1.1 și GDPval — muncă de birou. xAI le descrie ca teste în care modelul primește sarcini făcute de profesioniști „precum avocați, asistenți medicali și analiști financiari” și spune că Grok 4.7 e mai bun la crearea de documente și prezentări. Pe ambele, Grok 4.7 e pe locul al doilea, după Fable 5.1, iar formularea xAI este prudentă: „performează comparabil cu alte modele de frontieră”.
- Harvey Legal Agent Benchmark — muncă juridică. Procentual, e cea mai clară victorie: 19,6% față de 6,7% și 2,5%. În valoare absolută, e cel mai important avertisment din tabel: cel mai bun model din comparație obține sub 20%. „Mai bun decât ceilalți” nu înseamnă „suficient de bun ca să lucreze nesupravegheat pe un dosar”.
- HealthBench Professional — raționament clinic. Grok 4.7 urcă 8,2 puncte față de 4.6, dar rămâne sub ambii concurenți. Niciun scor de aici nu înlocuiește validarea clinică și cadrul de reglementare aplicabil.
De ce contează că sunt cifre auto-raportate
Toate aceste scoruri sunt publicate de furnizor, la lansarea propriului produs. Asta nu le face false; le face selectate: xAI a ales testele, versiunile, nivelurile de efort și modelele cu care se compară, iar pagina nu spune de unde provin cifrele concurenților. Până când evaluatori independenți repetă măsurătorile, tabelul e o listă scurtă, nu un verdict.
Trecerea de la „clasament” la „decizie” — metodologie de evaluare pe sarcinile tale, interpretarea corectă a unui benchmark, ponderarea criteriilor — este subiectul primului modul din cursul Comparație Modele AI, care se încheie cu un cadru decizional complet pentru alegerea modelului în practică.
Grok 4.7 preț: ce plătești, de fapt
Prețul de listă este neschimbat față de Grok 4.6. Conform paginii de prețuri din documentația xAI, tarifele per milion de tokeni sunt:
| Variantă | Intrare | Intrare din cache | Ieșire |
|---|---|---|---|
grok-4.7, prompt sub 200.000 de tokeni |
2,00 $ | 0,50 $ | 6,00 $ |
grok-4.7, prompt de la 200.000 de tokeni |
4,00 $ | 1,00 $ | 12,00 $ |
| Grok 4.7 Fast, prompt sub 200.000 | 4,00 $ | 1,00 $ | 12,00 $ |
| Grok 4.7 Fast, prompt peste 200.000 | 6,00 $ | 1,50 $ | 18,00 $ |
| Endpoint regional SUA, prompt sub 200.000 | 2,20 $ | 0,55 $ | 6,60 $ |
Patru detalii care schimbă factura:
- Pragul de 200.000 de tokeni. Când promptul atinge pragul, tariful mai mare se aplică tuturor tokenilor din cerere, nu doar celor de peste prag. Mecanica e cea de la Grok 4.6, tratată pe larg în ghidul despre costul unui agent AI cu context lung.
- Varianta Fast. Anunțul o descrie ca având „de două ori viteza de ieșire la de două ori prețul”. Documentația precizează că este același model, servit pe infrastructură mai rapidă, disponibil doar în Cursor și Grok Build — nu și prin API-ul public — și că nu intră în nivelul fără plată al Grok Build. Cursor își facturează propria variantă rapidă prin planul Cursor.
- Tokenii de raționament se plătesc, conform paginii de prețuri. Cum raționamentul nu poate fi oprit, nivelul de efort e o pârghie de cost, nu doar de calitate.
- Fără reducere la Batch. Lista modelelor cu 20% reducere în Batch API nu include
grok-4.7; documentația spune că modelele nelistate nu au reducere. Procesarea prioritară costă dublu.
Tabelul din anunț listează alături prețurile concurenților: GPT-5.6 Sol la 4 $ / 20 $ și Fable 5.1 la 10 $ / 50 $ per milion de tokeni. Am verificat ambele pe paginile oficiale: la OpenAI, 4 $ / 20 $ este un preț promoțional, valabil „cel puțin până la 21 noiembrie 2026”; la Anthropic, 10 $ / 50 $ este tariful de listă al lui Claude Fable 5.1.
Abonamentele pentru aplicațiile de consum nu sunt menționate în anunț: despre planurile din aplicațiile Grok, xAI nu a publicat nimic pe pagina de lansare.
Cost per sarcină: metoda care bate prețul per token
Prețul per token îți spune cât costă materia primă. Ce te interesează e cât costă o sarcină terminată corect:
cost per sarcină = (tokeni de intrare noi × tarif intrare) + (tokeni din cache × tarif cache) + (tokeni de ieșire, inclusiv raționament × tarif ieșire) + apeluri de unelte
iar cifra finală este costul per sarcină reușită: costul total al rulărilor împărțit la numărul de sarcini trecute, nu încercate.
Exemplu de calcul (cifre ipotetice, doar pentru aritmetică). O sarcină de agent consumă 60.000 de tokeni de intrare noi, 90.000 din cache și 12.000 de ieșire:
- standard: 60.000 × 2 $ + 90.000 × 0,50 $ + 12.000 × 6 $, totul împărțit la un milion = 0,12 + 0,045 + 0,072 = 0,237 $;
- aceeași sarcină pe Fast: 0,474 $; pe endpointul regional SUA: 0,261 $;
- fără cache (150.000 de tokeni de intrare noi): 0,372 $, cu 57% mai mult;
- dacă promptul ajunge la 210.000 de tokeni noi: 210.000 × 4 $ + 12.000 × 12 $ = 0,984 $, față de 0,452 $ la 190.000.
Documentația xAI insistă pe un detaliu practic: setează un prompt_cache_key, care trimite cererile aceleiași conversații către același server; fără el, „plătești adesea prețul întreg de intrare pe un server cu cache-ul rece”.
Ce arată datele publicate de xAI
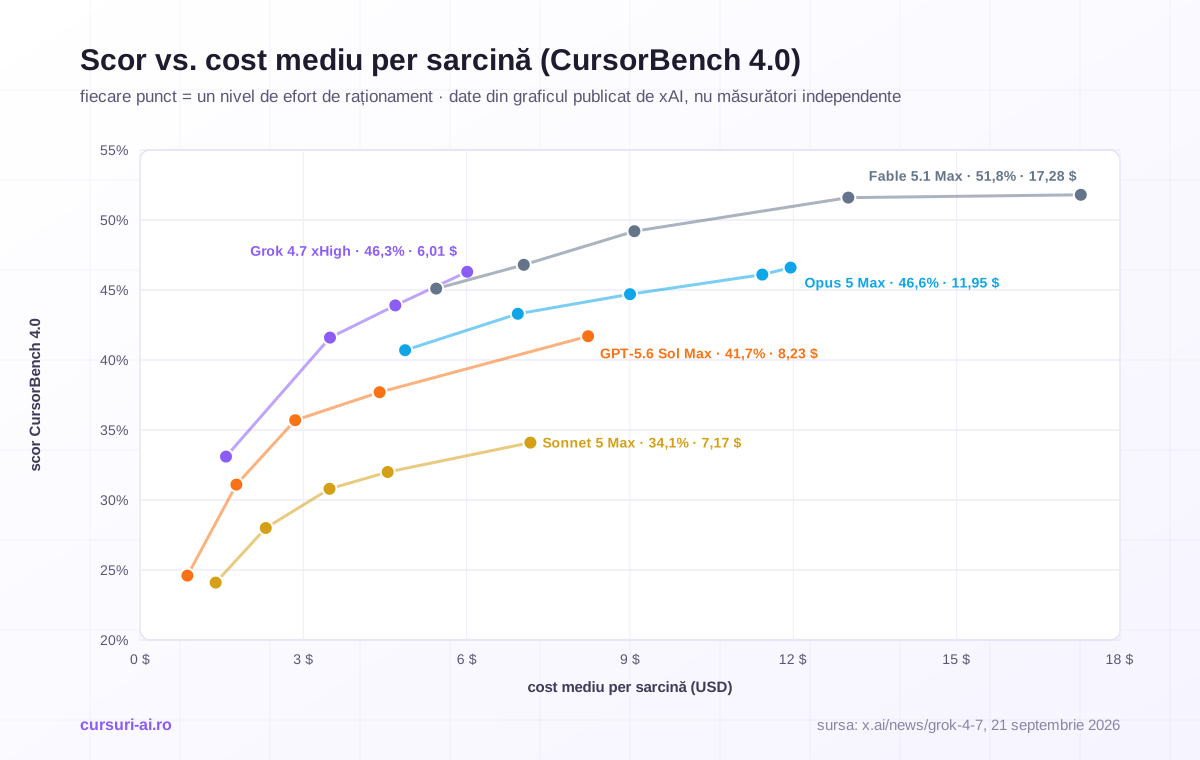
Anunțul include un grafic pe CursorBench 4.0 cu scorul și costul mediu per sarcină pentru fiecare nivel de efort — cea mai utilă parte a paginii.
| Model și efort | Scor CursorBench 4.0 | Cost mediu per sarcină |
|---|---|---|
| Grok 4.7 Low | 33,1% | 1,58 $ |
| Grok 4.7 Medium | 41,6% | 3,49 $ |
| Grok 4.7 High | 43,9% | 4,69 $ |
| Grok 4.7 Extra High | 46,3% | 6,01 $ |
| GPT-5.6 Sol Max | 41,7% | 8,23 $ |
| Opus 5 Max | 46,6% | 11,95 $ |
| Fable 5.1 Low | 45,1% | 5,44 $ |
| Fable 5.1 Max | 51,8% | 17,28 $ |
Trei lecții din aceste rânduri:
- Afirmația „la jumătate de preț față de modele comparabile” are o bază concretă în grafic: Opus 5 la Max obține practic același scor (46,6% față de 46,3%) la un cost per sarcină aproape dublu (11,95 $ față de 6,01 $).
- Prețul per token minte în ambele direcții. Fable 5.1 costă de cinci ori mai mult per token de intrare și de peste opt ori mai mult per token de ieșire decât Grok 4.7, dar la efort
Lowobține 45,1% la 5,44 $ per sarcină — adică la 1,2 puncte de scor și la 57 de cenți distanță de Grok 4.7 la efort maxim. Un model scump care consumă mai puțini tokeni poate ieși la același cost. - Ultimul nivel de efort e cel mai scump per punct câștigat. De la
HighlaExtra High, Grok 4.7 câștigă 2,4 puncte pentru un cost cu 28% mai mare. De laLowlaMedium, câștigă 8,5 puncte pentru un cost cu 121% mai mare. Nivelul potrivit depinde de cât te costă o sarcină ratată, nu de cât de sus e scorul.
Și aceste cifre sunt publicate de xAI, pe un singur test. Costul tău per sarcină se măsoară, nu se citește.
Unde merită testat Grok 4.7 și unde nu
Pornind strict de la ce arată tabelul și documentația:
Merită pus pe lista de test dacă:
- rulezi agenți de coding cu volum mare și costul per sarcină e criteriul principal. Raportul scor/cost de pe CursorBench 4.0 e argumentul cel mai solid al lansării. Modelul este disponibil în Cursor pe toate planurile și este implicit în Grok Build; alegerea și rutarea modelelor pe tip de sarcină sunt detaliate în cursul Cursor ca Pro.
- faci analiză pe documente juridice sau contractuale, cu un om care verifică rezultatul. Avansul pe Harvey Legal Agent Benchmark e real în termeni relativi; scorul absolut spune că supervizarea rămâne obligatorie.
- produci documente și prezentări în flux. Scorurile pe AA Briefcase și GDPval îl plasează imediat după lider.
- ai deja Grok 4.6 în producție. Același preț, același context: migrarea e o schimbare de identificator de model, urmată de testele tale de regresie.
Nu te grăbi dacă:
- agentul tău trăiește în terminal. Distanța de aproape 20 de puncte față de lider pe Terminal-Bench 4.0 e prea mare ca să fie ignorată.
- lucrezi în zona clinică. Locul al treilea din trei modele de vârf pe HealthBench Professional, plus cerințele de reglementare din domeniu.
- depinzi de procesare în Batch pentru cost. OpenAI și Anthropic listează jumătate de preț pentru procesarea asincronă; aici reducerea lipsește.
- ai cerințe contractuale de rezidență a datelor în UE. Vezi secțiunea următoare.
Grok 4.7 în România și UE: ce e confirmat și ce nu
Anunțul spune că Grok 4.7 este disponibil „astăzi” în Cursor și Grok Build, prin API-ul Grok, prin unelte terțe de coding, rutere de modele și platforme cloud. Documentația numește explicit gateway-urile OpenRouter, Vercel și Cloudflare și are pagini dedicate pentru Google Cloud Vertex AI și Microsoft Foundry. Nici anunțul, nici documentația nu menționează o restricție pentru Uniunea Europeană.
Asta nu e același lucru cu o confirmare. Contextul: în articolul despre Grok 4.5 am documentat că modelul nu a fost disponibil în UE la lansarea din iulie 2026, restricție ridicată ulterior, potrivit relatărilor de presă din acea perioadă. Pentru Grok 4.7, xAI nu a publicat o listă de țări sau regiuni, iar pagina de prețuri păstrează o rezervă generală: accesul la modele „poate varia în funcție de diverși factori, precum locația geografică”.
Cum verifici singur, în cinci minute:
- creează sau deschide echipa în consola xAI și uită-te la pagina Models — documentația o indică drept sursa la zi pentru disponibilitatea pe echipa ta;
- apelează
GET https://api.x.ai/v1/modelscu cheia ta și cautăgrok-4.7în listă; - dacă lucrezi prin Cursor sau printr-un gateway, verifică lista de modele din contul tău, nu din anunț.
Al doilea subiect, separat de disponibilitate, este unde se procesează datele. Documentația despre endpointuri regionale e neobișnuit de directă: endpointul global api.x.ai „nu garantează locația procesării”, cererile putând fi rutate între regiuni. Există un singur endpoint regional documentat, cel din SUA, cu 10% în plus la preț. Un endpoint regional pentru UE nu este documentat. Mai mult, xAI avertizează că un endpoint regional „nu este, în sine, o garanție completă de rezidență a datelor” și că uneltele server-side, fișierele și colecțiile rămân în afara garanției.
Pentru o firmă din România care procesează date cu caracter personal, asta înseamnă o analiză de transfer de date înainte de primul apel cu date reale.
Securitate și guvernanță la adoptarea în firmă
Ce afirmă xAI despre siguranța modelului
Anunțul spune că Grok 4.7 are un set complet nou de mecanisme de protecție și că este cel mai puternic model testat de companie la refuzuri și rezistență la jailbreak. Două cifre susțin afirmația: 62,4% pe testul de biosecuritate al LatchBio și 3,3% dintre prompturile riscante cu dublă utilizare lăsate să treacă pe HackerBench v0.3. HackerBench este, în formularea xAI, „benchmarkul nostru” — un test intern, nu o evaluare externă.
Niciuna dintre aceste cifre nu măsoară ce te interesează într-o firmă: ce se întâmplă cu datele tale.
Ce scrie în documentație despre date
Din întrebările frecvente de securitate din documentația xAI (link la Surse):
- xAI declară că nu antrenează pe intrările și ieșirile din API fără permisiunea explicită a clientului;
- implicit, cererile și răspunsurile sunt stocate 30 de zile, criptate, pentru audit în caz de abuz, apoi șterse automat;
- Zero Data Retention se activează la nivel de echipă, dar dezactivează funcțiile care depind de stocare (Responses API cu stare, Files, Collections, Batch API). Antetul
x-zero-data-retentiondin fiecare răspuns îți permite să verifici programatic; - compania declară conformitate SOC 2 Type 2; la întrebarea despre GDPR, răspunsul trimite către Trust Center, accesibil clienților cu acord de confidențialitate semnat;
- uneltele de consum au alte reguli decât API-ul: în modul Build de pe grok.com și din aplicațiile mobile, conversațiile sunt păstrate și, dacă opțiunea de îmbunătățire a modelului e activă, pot fi folosite pentru dezvoltarea produsului.
Ultimul punct e cel care produce incidente: un developer care testează modelul nou din contul personal, cu cod de client, a creat deja o problemă pe care nicio politică scrisă ulterior nu o repară.
Lista scurtă înainte de primul apel cu date reale
- Inventar: cine din firmă are deja acces la Grok 4.7 — prin Cursor, prin chei API personale, prin aplicații de consum?
- Clasificare: ce categorii de date au voie să ajungă la model și care nu (date personale, cod de client, secrete comerciale, date medicale).
- Contract: acord de prelucrare a datelor, retenția aleasă conștient (30 de zile sau ZDR), analiza transferului în afara UE.
- Chei: una per serviciu, rotite, nepartajate între colegi; jurnalul de audit din consolă verificat periodic.
- Om în buclă pentru orice ieșire cu efect juridic, financiar sau medical — scorul de 19,6% pe sarcini juridice e argumentul.
- Cadru legal: obligațiile furnizorilor de modele de uz general din Regulamentul (UE) 2024/1689 privind inteligența artificială sunt ale xAI; obligațiile tale, ca firmă care folosește modelul, și cele din GDPR rămân ale tale, indiferent de furnizor.
Cum transformi această listă într-o politică internă — registru de unelte aprobate, reguli pe categorii de date, proces de aprobare pentru modele noi — este subiectul cursului Politică de Utilizare AI și Combaterea Shadow AI.
Informațiile din această secțiune au caracter general și nu constituie consultanță juridică.
Testul tău de o oră, înainte să schimbi modelul
Structura de mai jos încape într-o oră dacă ai deja sarcinile la îndemână.
Minutele 0–10: alege cinci sarcini reale, rezolvate de echipă în ultima lună, pentru care știi rezultatul corect: un bug reparat și testele care îl confirmă, un contract cu clauzele-problemă deja marcate de un jurist, un raport cu cifrele verificate. Include cel puțin una la care modelul actual a greșit.
Minutele 10–20: îngheață condițiile. Același prompt de sistem, aceleași unelte, aceleași fișiere pentru ambele modele. La Grok 4.7, fixează explicit reasoning_effort — implicit este high — și rulează fiecare sarcină la high și la xhigh. Două detalii de migrare din documentație: parametrii presencePenalty, frequencyPenalty și stop returnează eroare pe modelele cu raționament, iar pe Responses API modelul întoarce mereu conținutul de raționament criptat, pe care trebuie să îl trimiți înapoi neschimbat în turul următor.
Minutele 20–45: rulează și notează. Pentru fiecare rulare: reușit sau ratat (după criteriul stabilit înainte, nu după impresie), tokenii de intrare, din cache și de ieșire din câmpul de utilizare al răspunsului, durata, numărul de pași.
Minutele 45–55: calculează costul per sarcină reușită. Aplică formula din secțiunea de cost pe tokenii măsurați, adună pe fiecare configurație și împarte la numărul de sarcini trecute.
Minutele 55–60: aplică o regulă de decizie scrisă dinainte. De exemplu: „schimbăm doar dacă rata de reușită e cel puțin egală și costul per sarcină reușită scade cu minimum 30%” Regula se scrie înainte de rulare, ca să nu o ajustezi după rezultat.
Cinci sarcini nu fac o evaluare statistică; fac un filtru. Dacă rezultatul e promițător, pasul următor e un set mai mare de cazuri și o evaluare automatizată, descrisă în ghidul despre cum evaluezi un model AI înainte de producție. Dacă nu, ai economisit o migrare.
Întrebări frecvente
Ce este Grok 4.7 și când a fost lansat? Grok 4.7 este modelul de vârf al xAI pentru coding, sarcini agentice și muncă de birou, anunțat pe 21 septembrie 2026. Are o fereastră de context de 500.000 de tokeni, cunoștințe până în mai 2026 și patru niveluri de efort de raționament: low, medium, high și xhigh.
Cât costă Grok 4.7 prin API? Tariful standard este de 2 $ per milion de tokeni de intrare, 0,50 $ pentru intrarea din cache și 6 $ per milion de tokeni de ieșire, pentru prompturi sub 200.000 de tokeni; de la acest prag, tarifele se dublează pentru întreaga cerere. Varianta Fast costă dublu și există doar în Cursor și Grok Build.
Este Grok 4.7 mai bun decât GPT-5.6 Sol? Depinde de sarcină. În tabelul publicat de xAI, Grok 4.7 depășește GPT-5.6 Sol pe CursorBench 4.0, EEBench, AA Briefcase, Terminal-Bench 4.0 și Harvey Legal Agent Benchmark, dar pierde pe DeepSWE v1.1 și HealthBench Professional. Cifrele sunt raportate de furnizor, nu de un evaluator independent, așa că decizia se ia pe un test cu sarcinile tale.
Pot folosi Grok 4.7 din România? Anunțul și documentația xAI nu menționează restricții pentru UE, dar nici nu publică o listă de regiuni, iar pagina de prețuri precizează că accesul poate varia în funcție de locație. Verifici direct în consola xAI, pe pagina Models. Un endpoint regional pentru UE nu este documentat; există doar cel global și cel din SUA.
Merită să trec de la Grok 4.6 la Grok 4.7? Prețul și fereastra de context sunt identice, iar toate scorurile publicate sunt mai mari, deci riscul financiar al migrării este mic. Rulează totuși testele tale de regresie înainte: o parte din avansul din tabel vine din nivelul de efort xhigh, care consumă mai mulți tokeni de raționament și ridică, prin urmare, costul per sarcină.
Concluzie
Grok 4.7 este o actualizare reală față de 4.6: același preț, același context, scoruri mai mari pe toate testele publicate, cu salturi mari pe lucrul în terminal și pe ingineria electrică. Nu este liderul propriului tabel — pierde în fața lui Fable 5.1 pe patru teste și în fața lui GPT-5.6 Sol pe două — iar cea mai spectaculoasă victorie a sa, pe sarcini juridice, înseamnă tot sub 20% reușită. Argumentul lui solid este costul per sarcină la coding agentic, acolo unde datele publicate îl arată la jumătate din costul unui model cu scor echivalent.
Ce nu știm încă: rezultate independente, metodologia testelor, disponibilitatea pe regiuni și orice opțiune de procesare în UE. Până apar, tabelul furnizorului îți spune doar dacă modelul merită o oră din timpul tău — iar ora aceea, cu cinci sarcini reale și o regulă de decizie scrisă dinainte, e singurul benchmark care se aplică firmei tale.
Surse
- xAI, „Introducing Grok 4.7” (anunț oficial, 21 septembrie 2026): https://x.ai/news/grok-4-7
- xAI Docs, fișa modelului Grok 4.7 (context, niveluri de raționament, varianta Fast, unde rulează): https://docs.x.ai/developers/grok-4-7
- xAI Docs, Pricing (tarife, prag de 200.000 de tokeni, Fast, Batch, endpoint SUA): https://docs.x.ai/developers/pricing
- xAI Docs, Regional Endpoints: https://docs.x.ai/developers/advanced-api-usage/regions
- xAI Docs, Security FAQ (retenție, Zero Data Retention, SOC 2): https://docs.x.ai/developers/faq/security
- Regulamentul (UE) 2024/1689 privind inteligența artificială: https://eur-lex.europa.eu/eli/reg/2024/1689/oj
Articol informativ, publicat la 22 septembrie 2026. Cifrele de benchmark, costurile per sarcină și prețurile provin din comunicarea și documentația oficială xAI, consultate la 22 septembrie 2026; sunt raportate de furnizor și se pot schimba. Prețurile modelelor OpenAI și Anthropic au fost verificate pe paginile oficiale de prețuri ale celor două companii. Conținutul are caracter educativ și nu constituie consultanță juridică sau financiară.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.