Integrarea a mers un an fără o singură reclamație. Apoi, într-o dimineață, jumătate din cereri se întorc cu eroare, iar în jurnale apare un cod de stare pe care nu l-ai mai văzut. Modelul pe care l-ai pus în producție nu s-a stricat: a fost retras, conform unui calendar publicat cu luni înainte, într-un e-mail care a ajuns la altcineva. Retragerea modelelor nu e un incident, e o operațiune recurentă de întreținere — iar echipele care o tratează așa plătesc pentru ea o zi de muncă, nu o săptămână de urgență.
Migrarea se rezolvă cu două lucruri, pe care le construiești o singură dată: un strat de integrare în care identificatorul modelului e configurare, nu cod, și o suită de regresie care îți spune în douăzeci de minute dacă noul model se comportă ca vechiul — disciplina tratată în cursul AI Evals pentru LLM-uri în Producție. Restul articolului e despre cum arată amândouă, cu termenele reale pe care le publică furnizorii în septembrie 2026.
Trei calendare, nu unul
Prima greșeală de planificare e să crezi că ai un singur termen de urmărit. Ai trei, iar ele nu coincid.
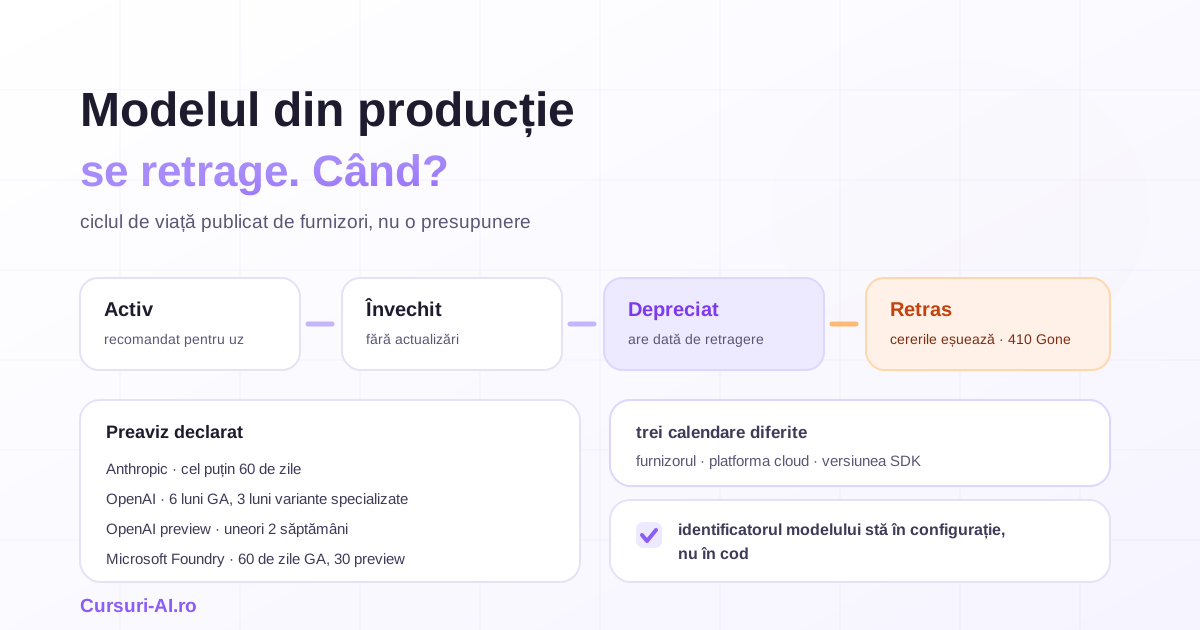
Calendarul furnizorului de model. Anthropic descrie ciclul de viață în patru stări: Active, Legacy („nu mai primește actualizări și poate fi depreciat în viitor"), Deprecated („încă funcțional, dar nerecomandat", cu înlocuitor și dată de retragere) și Retired („cererile către modelele retrase vor eșua"). Angajamentul declarat: cel puțin 60 de zile de preaviz înainte de retragere, pentru modelele lansate public.
Calendarul platformei pe care rulezi. Aici se rupe presupunerea. Documentația Anthropic precizează explicit că datele publicate se aplică platformelor proprii, în timp ce platformele operate de parteneri — Amazon Bedrock și Google Cloud — își stabilesc propriile programe de retragere, deci starea și datele unui model pot diferi. Dacă ai dezvoltat pe API-ul direct și ai livrat clientului pe Bedrock, ai două calendare pentru același model.
Calendarul SDK-ului. Bibliotecile client își fac propriile versiuni majore, iar acolo dispar parametri și se schimbă semnături, independent de modele. Revenim imediat la asta.
Ce promit, de fapt, furnizorii
Cifrele de mai jos sunt din documentația publică a furnizorilor, verificată în septembrie 2026. Merită citite ca limite inferioare, nu ca planificare.
| Furnizor / platformă | Preaviz declarat |
|---|---|
| Anthropic (platforme proprii) | cel puțin 60 de zile înainte de retragere, pentru modele publice |
| OpenAI — modele general disponibile | cel puțin 6 luni |
| OpenAI — variante specializate (chat, codex, deep research) | cel puțin 3 luni |
| OpenAI — modele preview | uneori doar 2 săptămâni |
| Microsoft Foundry — modele GA | cel puțin 60 de zile |
| Microsoft Foundry — modele preview | cel puțin 30 de zile |
| Google (Gemini API) | datele publicate sunt „cele mai devreme date posibile", cu comunicarea ulterioară a datei exacte |
Cum arată asta în practică, tot din tabelele oficiale:
- Anthropic a anunțat pe 5 iunie 2026 retragerea unui model din familia Opus, programată pe 5 august 2026 — la două luni distanță, adică la limita de jos a angajamentului. Modelele Claude Sonnet 4 și Opus 4, depreciate pe 14 aprilie 2026, au fost retrase pe 15 iunie 2026.
- La OpenAI, o variantă specializată depreciată pe 11 septembrie 2026 are oprirea programată pe 1 octombrie 2026 — douăzeci de zile, semn că politicile de preaviz admit excepții, pe care documentația le invocă pentru motive de siguranță sau de conformitate. Tot acolo, versiunile vechi ale unei familii de modele generale sunt programate pentru retragere pe 11 decembrie 2026, iar două modele de transcriere pe 26 februarie 2027.
- Pe Microsoft Foundry, modelele general disponibile au data de retragere stabilită programatic la lansare, la 18 luni distanță, iar modelele GA provenite de la parteneri precum Anthropic, DeepSeek, Fireworks și Mistral urmează un ciclu de 12 luni în loc de 18.
- Google a oprit
text-embedding-004pe 14 ianuarie 2026 șigemini-2.0-flashpe 1 iunie 2026.
Concluzia de planificare: pentru o funcționalitate pe care intenționezi să o menții doi ani, vei migra cel puțin o dată, probabil de două ori. Nu e un risc de gestionat, e o activitate de bugetat.
Ce se întâmplă la ora zero
Aici merită să știi exact ce vezi în jurnale, ca să nu pierzi prima oră căutând cauza.
Pe Microsoft Foundry, un model retras returnează 410 Gone la toate cererile de inferență, iar crearea de noi implementări nu mai e posibilă. Pe Gemini API, după oprire „endpoint-ul nu mai este disponibil". La Anthropic, cererile către modelele retrase eșuează.
Diferența care contează cel mai mult e ce face platforma fără tine:
- Pentru implementările de tip Standard pe Microsoft Foundry, Microsoft gestionează actualizarea automată la retragerea unei versiuni, eșalonat pe regiuni. Poți controla comportamentul prin proprietatea
versionUpgradeOption, cu trei valori — actualizare la apariția unei versiuni implicite noi, actualizare doar la expirare, sau fără actualizare automată, caz în care implementarea pur și simplu nu mai funcționează la data retragerii. - Implementările provisioned nu sunt actualizate automat; migrarea e manuală.
- Modelele preview nu au opțiunea de a rămâne pe loc: sunt fie actualizate forțat, fie retrase.
Cu alte cuvinte, în funcție de tipul de implementare, riscul tău e fie „se oprește", fie „se schimbă modelul sub aplicație fără ca nimeni din echipă să atingă ceva". A doua variantă e mai periculoasă, pentru că nu produce o alertă, ci o deviere tăcută de comportament.
Mai e o capcană de operare pe care documentația Microsoft o semnalează singură: terminologia din API diferă de cea din portal. Un model pe care documentația îl numește „Deprecated" apare în API cu lifecycleStatus: "Deprecating", iar valoarea "Deprecated" din API înseamnă că modelul e deja retras. Dacă scrii o alertă automată pe câmpul greșit, ea se declanșează exact când e prea târziu.
Nu doar modelele se retrag. Și parametrii
Cazul care prinde echipele pe picior greșit, pentru că nu implică nicio schimbare de model în configurația ta.
Anthropic listează în aceeași pagină de depreciere și parametri de cerere: temperature, top_p și top_k sunt depreciați începând cu Claude Opus 4.7 și modelele ulterioare, iar setarea lor la o valoare diferită de cea implicită returnează eroare 400. În plus, SDK-ul Python în versiunea 1.0 și ulterioare elimină complet acești parametri, deci transmiterea lor ridică TypeError — o eroare care apare la actualizarea bibliotecii, nu la schimbarea modelului.
Un exemplu detaliat de schimbări incompatibile la trecerea unei generații de modele — parametri care dispar, comportament de gândire extinsă, facturare diferită — e analizat în articolul despre modificările incompatibile din API.
Lecția generală, independent de furnizor: „migrare" nu înseamnă doar înlocuirea unui șir de caractere cu altul. Poate însemna renunțarea la parametri de eșantionare pe care logica ta îi considera esențiali, schimbarea formei răspunsului, un comportament diferit la apelarea uneltelor sau o altă politică de refuz. De aceea inventarul de mai jos include și SDK-urile, nu doar identificatorii de model.
Suita de regresie: ce măsori, concret
Fără ea, migrarea e o schimbare de configurație urmată de speranță. Cu ea, e o decizie cu cifre.
Un set minim, care se construiește într-o zi și se amortizează la prima migrare:
Cazurile. Între 50 și 200 de intrări reale, anonimizate, alese să acopere: fluxul obișnuit, intrările scurte și lungi, limba română cu diacritice, cazurile care au produs incidente în trecut, intrările ostile (tentative de injecție) și cazurile în care răspunsul corect e „nu știu".
Ce verifici automat, nu „la ochi":
- Validitate structurală. Dacă aplicația așteaptă JSON conform unei scheme, rata de răspunsuri valide e prima metrică. O scădere de la 99,4% la 96% e o regresie majoră, invizibilă într-un test manual pe cinci exemple.
- Respectarea contractului de unelte. Apelurile de funcții au numele și argumentele corecte? Modelul cheamă unealta când trebuie și, mai ales, se abține când nu trebuie?
- Corectitudine pe cazurile cu răspuns cunoscut. Acolo unde există un adevăr de referință.
- Rata de refuz și tonul. Un model mai prudent poate refuza cereri legitime. E cea mai frecventă surpriză la migrarea către o generație nouă.
- Latență la percentila 95 și cost pe cerere. Un model mai bun și mai scump poate fi o regresie de produs, dacă ecranul tău are un buget de timp.
Pragurile. Scrise înainte de rulare, nu după: ce scădere accepți pe fiecare metrică. Altfel, orice rezultat se justifică.
Rularea în umbră. Înainte de comutare, trimiți o fracțiune din traficul real către noul model, fără să-i afișezi răspunsul, și compari. E cel mai bun test pe care îl poți face, pentru că folosește distribuția reală a intrărilor, nu pe cea imaginată de tine.
Stratul de integrare care face migrarea ieftină
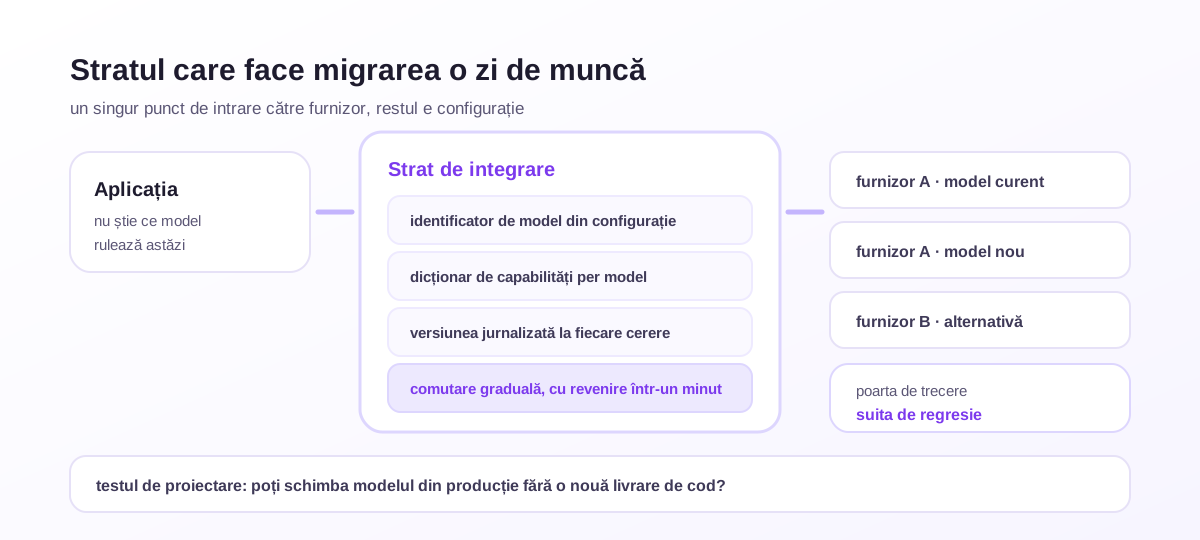
Cinci reguli de proiectare, toate ușor de respectat de la început și scumpe de adăugat ulterior:
- Identificatorul modelului stă în configurație, pe mediu, nu în cod și nu în prompt. Testul: poți schimba modelul din producție fără o nouă livrare?
- Un singur punct de intrare către furnizor, în toată baza de cod. Dacă ai apeluri directe în șapte fișiere, ai șapte locuri de modificat și de testat.
- Versiunea modelului se jurnalizează la fiecare cerere, împreună cu identificatorul solicitării. Fără asta, la o schimbare de comportament nu poți demonstra ce model a produs un anumit răspuns.
- Capabilitățile se declară explicit, nu se presupun: suportă modelul acesta apelarea uneltelor, răspuns structurat, intrare de imagini, gândire extinsă? Un dicționar de capabilități per model evită eșecuri la runtime când schimbi familia.
- Comutare graduală, cu revenire imediată. Procent din trafic, controlat din configurație. Revenirea la modelul vechi trebuie să dureze un minut, cât timp acesta încă există.
Modelul de integrare complet — streaming, tratarea erorilor, apelarea uneltelor, orchestrare pe mai multe modele și punerea în producție — e subiectul cursului Integrare Avansată LLM în Aplicații de Producție. Iar criteriile după care alegi înlocuitorul, dincolo de clasamentele publice, sunt tratate în Comparație Modele AI.
Cazul special: modelele de embedding
Aici greșeala e de alt ordin de mărime, iar Google a oferit deja exemplul: text-embedding-004 a fost oprit pe 14 ianuarie 2026.
Când se retrage un model de embedding, nu poți doar să schimbi identificatorul. Vectorii existenți în baza ta au fost produși de modelul vechi; cei noi vor trăi într-un alt spațiu. Comparațiile între ele sunt lipsite de sens, iar rezultatul nu e o eroare, ci o căutare care returnează tăcut lucruri irelevante.
Ce înseamnă concret o migrare de embeddings:
- reprocesarea întregului corpus, cu costul și timpul aferente;
- spațiu de stocare dublu pe durata tranziției, plus eventual un index nou, dacă se schimbă dimensiunea vectorilor;
- o perioadă de scriere dublă, în care indexezi în ambele spații;
- un set de evaluare pentru regăsire — precizie pe primele rezultate — rulat pe ambele, înainte de comutare.
Regula practică: pentru un sistem de regăsire în producție, tratează retragerea modelului de embedding ca pe un proiect de două săptămâni, nu ca pe o sarcină de întreținere. Și, cât timp alegi, preferă modelele cu ciclu de viață lung și cu alternative compatibile ca dimensiune.
Runbook: de la e-mail la comutare
Ziua 0 — anunțul. Cineva trebuie să-l primească. Adresa de contact din contul de facturare al furnizorului e, de regulă, a unei persoane din administrativ; schimb-o cu o listă a echipei tehnice. Verifică lunar pagina de depreciere a furnizorilor pe care rulezi — inclusiv cea a platformei cloud, care are alt calendar.
Ziua 1 — inventarul. Unde apare identificatorul modelului: cod, configurație, variabile de mediu, infrastructură ca și cod, sarcini programate, notebook-uri, documentație. Anthropic pune la dispoziție un export CSV al utilizării pe chei API și modele, din consolă; pe Microsoft Foundry, câmpurile de ciclu de viață și de depreciere se pot interoga programatic prin API-ul de modele. Verifică și versiunile SDK-urilor.
Săptămâna 1 — alegerea înlocuitorului. Nu automat cel recomandat de furnizor. Documentația Microsoft e neobișnuit de sinceră aici: înlocuitorul oficial e declarat cu aproximativ 90–120 de zile înainte de retragere, tocmai pentru ca recomandarea să nu fie depășită la momentul migrării — și nu îți limitează opțiunile. Evaluează doi sau trei candidați pe propriile date.
Săptămâna 2 — regresia și umbra. Rulezi suita pe candidați, compari cu referința, apoi trimiți o parte din traficul real în umbră.
Săptămâna 3 — comutarea graduală. 5%, 25%, 50%, 100%, cu revenire pregătită și cu monitorizare pe rata de erori, latență, cost și — dacă ai — semnalele de calitate din produs.
Săptămâna 4 — curățenia. Scoți modelul vechi din configurații, ștergi ramurile de compatibilitate, actualizezi documentația și notezi în calendar următoarea dată de retragere cunoscută.
Un detaliu de contract, pentru cine livrează pe bază de proiect: documentația Microsoft precizează explicit că datele de retragere nu sunt extensibile și nu se acordă excepții. Dacă în oferta ta scrie „mentenanță", merită să scrie și cine plătește migrările de model — altfel, discuția apare în ziua în care clientul vede erori.
Întrebări frecvente
Î: Cu cât timp înainte aflu că un model se retrage? R: Depinde de furnizor și de tipul modelului. Anthropic promite cel puțin 60 de zile de preaviz pentru modelele lansate public. OpenAI declară cel puțin 6 luni pentru modelele general disponibile, cel puțin 3 luni pentru variantele specializate și, pentru modelele preview, uneori doar două săptămâni. Microsoft Foundry anunță retragerile GA cu cel puțin 60 de zile și pe cele preview cu cel puțin 30 de zile. Google publică date care sunt, prin definiție, „cele mai devreme posibile", urmate de comunicarea datei exacte.
Î: Ce eroare primesc cererile către un model retras?
R: Pe Microsoft Foundry, toate cererile de inferență returnează 410 Gone. Pe Gemini API, endpoint-ul nu mai este disponibil. La Anthropic, cererile către modelele retrase eșuează. Important: pe unele tipuri de implementare nu primești erori, ci ești migrat automat pe alt model — o schimbare tăcută de comportament, care se vede doar dacă jurnalizezi versiunea modelului la fiecare cerere.
Î: Pot să rămân pe modelul vechi dacă îmi place mai mult? R: Nu, dincolo de data de retragere. Documentația Microsoft precizează că datele de retragere nu sunt extensibile și că nu se acordă excepții. Singura formă de control real asupra calendarului o ai cu modele cu greutăți deschise, găzduite de tine — opțiune care mută problema din calendarul furnizorului în bugetul tău de operare.
Î: Migrarea modelelor de embedding e la fel? R: Nu, e semnificativ mai grea. Vectorii produși de modelul vechi nu sunt comparabili cu cei produși de modelul nou, deci întregul corpus trebuie reprocesat și reindexat. Planifică scriere dublă pe durata tranziției, spațiu suplimentar de stocare și o evaluare a calității regăsirii înainte de comutare. Simptomul unei migrări greșite nu e o eroare, ci rezultate de căutare tăcut mai slabe.
Î: Cum știu că noul model se comportă la fel ca cel vechi? R: Printr-o suită de regresie rulată pe aceleași intrări: validitatea structurii răspunsului, respectarea contractului de apelare a uneltelor, corectitudinea pe cazurile cu răspuns cunoscut, rata de refuz, latența la percentila 95 și costul pe cerere, cu praguri stabilite înainte de rulare. Pasul suplimentar care elimină surprizele e rularea în umbră pe trafic real, înainte de comutare.
Concluzie
Retragerile de modele sunt singura certitudine din acest domeniu: fiecare furnizor major publică un ciclu de viață, iar termenele sunt de ordinul lunilor, nu al anilor. Echipele care suferă nu sunt cele care au ales prost modelul, ci cele care l-au scris în cod, în șapte locuri, fără nicio metodă de a verifica dacă înlocuitorul se comportă la fel.
Investiția care schimbă totul e mică și se face o singură dată: identificatorul în configurație, un singur punct de integrare, versiunea jurnalizată la fiecare cerere și o suită de regresie de o sută de cazuri. După ea, un anunț de retragere nu mai e o urgență, ci o intrare în planificarea sprintului.
Surse: Anthropic — Model deprecations · OpenAI — Deprecations · Microsoft Learn — Foundry Models lifecycle and support policy · Google — Gemini API deprecations
Articol informativ, publicat la 17 septembrie 2026. Datele de retragere și politicile de preaviz se modifică — verifică paginile oficiale de depreciere ale furnizorului și ale platformei pe care rulezi înainte de a planifica o migrare.

Cursul care continuă acest articol
AI Evals pentru LLM-uri în Producție: Testare, Scoring și Calitate pre-Deployment
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Evaluării LLM: De la Vibe-Checks la Măsurare Riguroasă
- Golden Datasets: Curare, Etichetare și Date Sintetice Fără PII
- LLM-as-a-Judge: Rubrici, Calibrare și Mitigarea Bias-urilor
- Metrici pentru RAG și Generare: Faithfulness, Relevancy și Context (RAGAS)
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.