Un agent de programare îți livrează o funcționalitate completă în patru minute: cod, teste, comentarii. Testele trec. Revizuirea umană se uită la logică și aprobă. Peste trei luni, un scaner de securitate găsește în același fișier o interpolare directă în interogare, un secret rămas într-un fișier de configurare și o dependență pe care nimeni din echipă nu a ales-o conștient. Codul generat de AI nu eșuează la funcționalitate, ci la clasele de defect pe care nimeni nu le-a cerut explicit.
Articolul de față nu e despre cum organizezi revizuirea — procesul, clasele de verificări și metricile sunt tratate separat în ghidul despre code review cu agenți AI. Aici e vorba despre ce anume caută cineva când codul a fost scris de un model: tipurile de defecte care apar sistematic, o clasă de atac care nu exista înainte de generarea automată de cod și controalele deterministe care le prind înainte să ajungă în producție.
Ce arată măsurătorile pe cod generat
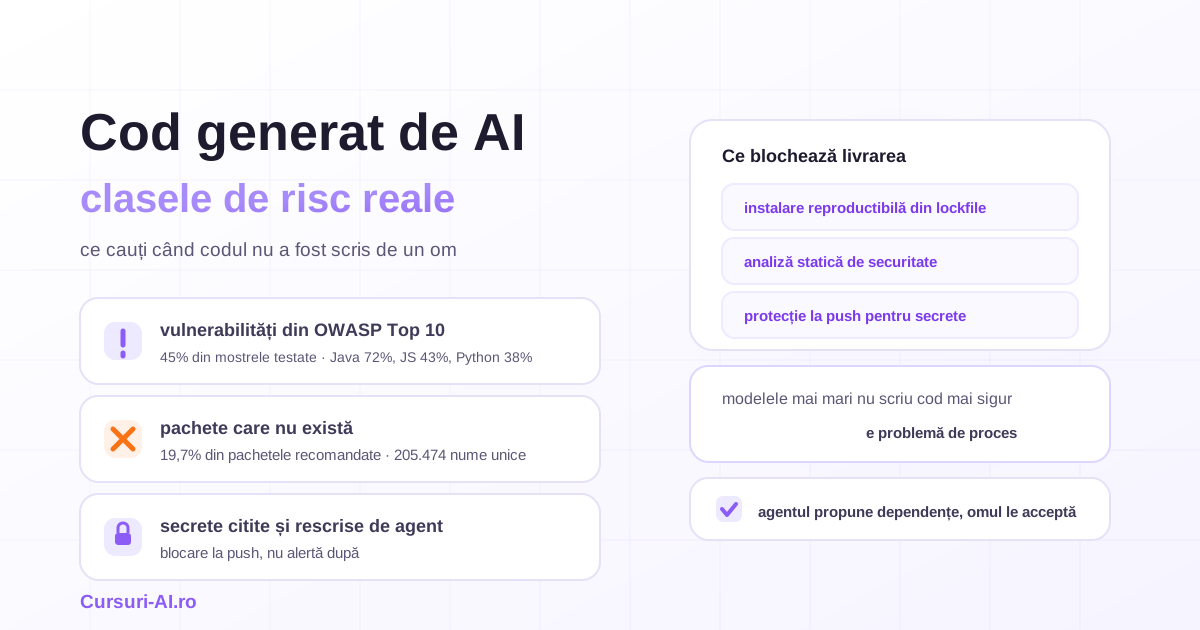
Discuția are, în sfârșit, date. Raportul 2025 GenAI Code Security Report publicat de Veracode a testat peste 100 de modele de limbaj pe sarcini de programare în Java, Python, C# și JavaScript, verificând rezultatul cu analiză statică. Concluzia principală: 45% dintre mostrele de cod au picat testele de securitate și au introdus vulnerabilități din OWASP Top 10.
Distribuția pe limbaje e partea utilă pentru echipe:
| Limbaj | Rata de eșec la securitate |
|---|---|
| Java | 72% |
| C# | 45% |
| JavaScript | 43% |
| Python | 38% |
Java, adică exact limbajul în care rulează sistemele bancare, de asigurări și de telecom din România, e cel mai expus din cele patru măsurate. Pe categorii de vulnerabilitate, cross-site scripting-ul (CWE-80) a fost cel mai prost tratat: modelele nu s-au apărat împotriva lui în 86% dintre mostrele relevante.
A doua concluzie e cea care schimbă planificarea: raportul notează că, deși modelele au devenit mai bune la a scrie cod funcțional și corect sintactic, nu au devenit mai bune la a scrie cod sigur — performanța de securitate a rămas plată, indiferent de dimensiunea modelului sau de sofisticarea antrenării. Cu alte cuvinte, nu e o problemă care se rezolvă singură la următoarea generație de modele. E o problemă de proces, pe care o rezolvi cu unelte deterministe și cu reguli de echipă.
Modul de lucru cu agenți pe depozite reale — permisiuni, instrucțiuni de proiect, hooks care rulează verificări la fiecare modificare, integrarea în fluxul de versionare — e tratat pe larg în cursul Claude Code Mastery. Fără această parte, discuția despre securitatea codului generat rămâne teoretică.
De ce apar aceleași clase de defect
Vulnerabilitățile din codul generat nu sunt exotice. Sunt cele din manual: injecție în interogări, XSS, algoritmi criptografici depășiți, scriere necontrolată în jurnale. Motivul e mecanic: modelul produce codul cel mai probabil pentru cerința ta, iar cerința ta a fost „scrie o funcție care caută utilizatori după nume", nu „scrie o funcție care caută utilizatori după nume și rezistă la intrare ostilă".
Trei consecințe practice:
Contextul de securitate trebuie să fie în cerință, nu în speranță. Un fișier de instrucțiuni la nivel de depozit care spune explicit ce bibliotecă de acces la date se folosește, că interogările sunt parametrizate, ce funcție de escapare se aplică la randare și ce algoritmi de hashing sunt acceptați schimbă rezultatul mai mult decât alegerea modelului.
Volumul mută statistica. Dacă rata de defect pe unitatea de cod rămâne constantă, iar volumul de cod livrat crește, numărul absolut de defecte crește. Asta e tot. Nu ai nevoie de nicio ipoteză despre „AI nesigur" ca să ajungi la concluzia că verificarea determinista trebuie întărită înainte de a accelera livrarea.
Codul care „merge" trece mai ușor de revizuire. Un om care citește o funcție corectă sintactic, cu nume bune și comentarii coerente, revizuiește mai relaxat decât atunci când citește cod stângaci. Aparența de calitate e ea însăși un risc, iar singura contramăsură serioasă e să nu depinzi de atenția umană pentru clasele de defect pe care un instrument le prinde întotdeauna.
Pachetele care nu există: atacul care nu exista înainte
Aceasta e partea pe care majoritatea echipelor nu o au pe radar, deși e cea mai ușor de exploatat.
Lucrarea „We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs", prezentată la USENIX Security 2025 (premiu Distinguished Paper) de cercetători de la University of Texas at San Antonio, University of Oklahoma și Virginia Tech, a generat 576.000 de mostre de cod cu 16 modele, în două limbaje, și a analizat pachetele recomandate în importuri.
Rezultatele, citate din lucrare:
- din cele 2,23 milioane de pachete apărute în răspunsuri, 440.445 (19,7%) nu existau în PyPI sau npm;
- 205.474 de nume unice de pachete inexistente;
- rata medie de halucinare: cel puțin 5,2% pentru modelele comerciale și 21,7% pentru cele open-source;
- pe limbaje, Python a produs mai puține halucinații decât JavaScript — 15,8% față de 21,3%.
Până aici, o curiozitate statistică. Ce o transformă în vector de atac e persistența. Cercetătorii au reluat aceleași solicitări de zece ori: 43% dintre pachetele halucinate au reapărut în toate cele zece rulări, iar 58% au reapărut de mai multe ori. Doar 39% nu s-au repetat deloc. În plus, 81% dintre numele halucinate au fost generate de un singur model — halucinațiile sunt specifice modelului, dar reproductibile în interiorul lui.
Lucrarea descrie explicit scenariul de abuz: un atacator observă numele halucinat repetat și publică în registrul public un pachet cu exact acel nume, conținând cod rău intenționat. Utilizatorii următori, cărora modelul le recomandă același pachet fictiv, îl instalează cu încredere. Numele fenomenului, apărut ulterior în discuția publică, e slopsquatting: varianta în care greșeala de tastare a omului e înlocuită cu halucinația modelului.
Șase controale care taie acest risc
- Registru intern ca unic punct de instalare. Un proxy de registru (Artifactory, Nexus, Verdaccio, un index PyPI intern) cu listă de pachete aprobate înseamnă că un nume inventat nu se rezolvă niciodată, indiferent ce scrie modelul în import.
- Fișier de blocare obligatoriu și instalare reproductibilă.
npm ci, nunpm install;poetry.locksaurequirements.txtcu sume de control. Instalarea în integrarea continuă nu are voie să rezolve versiuni noi. - Aprobare umană explicită pentru dependențe noi. Regulă de echipă, nu recomandare: orice pull request care adaugă o dependență primește o etichetă separată și un revizor desemnat. Agentul are voie să propună, nu să introducă.
- Verificare automată a importurilor noi față de registru. Un pas de integrare care extrage importurile adăugate în modificare și verifică existența, vârsta, numărul de descărcări și depozitul sursă al fiecărui pachet. Un pachet publicat acum trei zile, cu zece descărcări, care apare într-un cod generat, e un semnal, nu o coincidență.
- Dezactivarea scripturilor la instalare în mediile automate, acolo unde ecosistemul o permite. Majoritatea încărcăturilor rău intenționate din pachetele publicate rulează la instalare.
- Inventar de componente (SBOM) generat la fiecare livrare. Nu ca exercițiu de conformitate, ci ca să poți răspunde în cinci minute la întrebarea „acest pachet e la noi în producție?" atunci când apare un anunț public.
Niciunul dintre aceste controale nu depinde de model, de furnizor sau de „cât de bun e agentul". Toate rămân valabile și când echipa nu folosește deloc generare automată.
Secretele: unde greșește fluxul cu agenți
Un agent care are acces la arborele de fișiere citește și fișierele de configurare locale. De aici, două riscuri distincte: secretul ajunge în contextul trimis furnizorului și secretul ajunge scris într-un fișier versionat, pentru că modelul a „completat" un exemplu cu valoarea reală pe care tocmai a citit-o.
Controalele care funcționează:
Blocarea la push, nu alerta după. Pentru depozitele găzduite pe GitHub, scanarea de secrete rulează automat pe depozitele publice, fără licență suplimentară, iar pentru cele private și interne necesită GitHub Secret Protection, cu GitHub Team sau Enterprise Cloud. Componenta care contează e protecția la push: aceasta blochează efectiv trimiterea modificărilor care conțin un secret detectat, atât din linia de comandă, cât și din interfață sau prin API. Atenție la portiță — documentația precizează că oricine are drept de scriere poate ocoli blocarea specificând un motiv, iar dintre motivele disponibile doar „o rezolv mai târziu" lasă o alertă deschisă. Pentru organizații există ocolirea delegată, cu aprobare.
Lista de excludere pentru agent. Fișierele de mediu, cheile private, dumpurile de bază de date și directoarele cu date de test reale se exclud explicit din contextul agentului. .gitignore nu e un control de securitate: el oprește versionarea, nu citirea.
Rotația ca reflex. Dacă un secret a ajuns în contextul unui furnizor extern, tratează-l ca expus și rotește-l. E o decizie de cinci minute care înlocuiește o discuție de două ore.
Modelarea amenințărilor pentru sistemele care folosesc modele — inclusiv scurgerile prin context, injecția în prompt și guardrails-urile de execuție — e subiectul cursului AI Security și Ethical Engineering.
Unde pui verificările, pe scurt
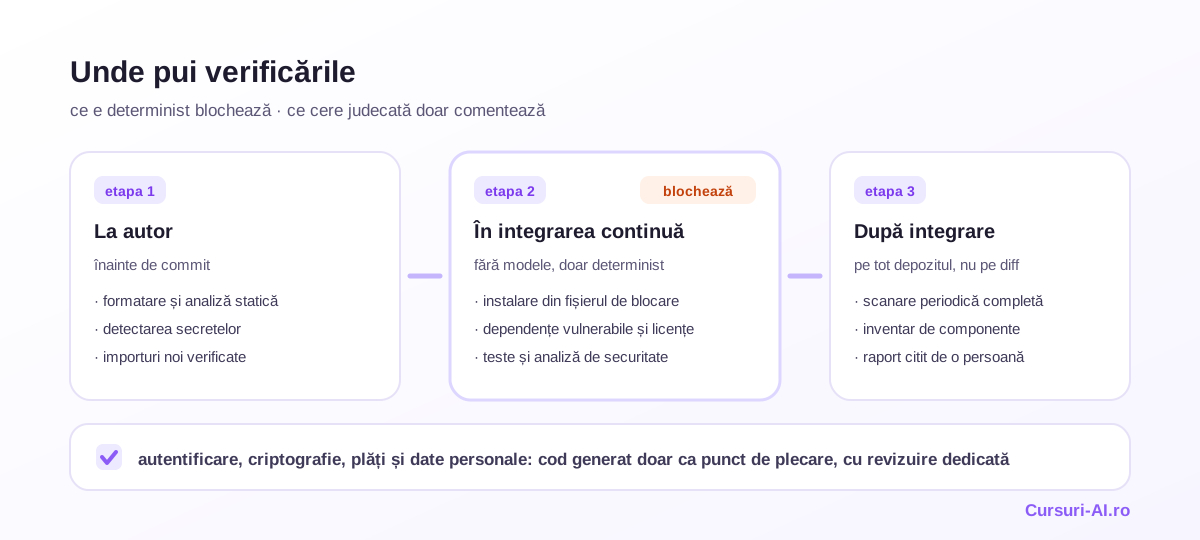
Regula simplă: ce e determinist, blochează; ce cere judecată, comentează.
- La autor, înainte de commit. Formatare, analiză statică, detectarea secretelor, verificarea importurilor noi. Cel mai ieftin loc în care se prinde o problemă.
- În integrarea continuă, cu drept de blocare. Analiză statică de securitate, teste, verificarea dependențelor vulnerabile, instalare reproductibilă din fișierul de blocare, verificarea licențelor.
- După integrare. Scanarea periodică a întregului depozit, nu doar a modificării: defectele apărute între timp în dependențe nu se văd în diff.
Partea de proces — cine aprobă, cum eviți zgomotul, ce metrici urmărești — e detaliată în articolul despre revizuirea cu agenți. Aici e suficient principiul: un model nu are ce căuta pe verificările care au deja răspuns determinist.
Zonele unde codul generat nu intră fără revizuire dedicată
Patru categorii în care rata de defect măsurată devine inacceptabilă, indiferent cât de bine arată codul:
- Autentificare, autorizare și gestiunea sesiunilor. Aici o greșeală nu produce un bug, ci o breșă.
- Orice atinge date cu caracter personal. Logarea „generoasă" pe care o produc modelele scrie frecvent în jurnale exact câmpurile care nu trebuie să ajungă acolo.
- Criptografie și gestiunea cheilor. Modelele reproduc fericit exemple vechi cu algoritmi depășiți, pentru că abundă în datele de antrenare.
- Plăți și facturare. Zona în care un defect are cost direct și vizibil imediat.
În aceste zone, codul generat e un punct de plecare pentru un om care cunoaște domeniul, nu o livrare.
Ce documentezi și de ce contează juridic
Două lucruri merită scrise, nu ținute minte.
Proveniența. Ce parte a bazei de cod a fost generată, cu ce unealtă și sub ce configurare. Nu pentru statistică internă, ci pentru că, la un incident sau la un audit, întrebarea „cum a ajuns asta aici" primește altfel un răspuns din memorie colectivă. Partea de proprietate intelectuală și de licențiere a codului generat — cine deține rezultatul, ce riscuri apar la cod reprodus din date de antrenare — e tratată separat în ghidul despre codul generat cu AI, proprietate și licențe.
Calendarul de conformitate pentru produse cu elemente digitale. Regulamentul (UE) 2024/2847 — Cyber Resilience Act — a intrat în vigoare la 10 decembrie 2024, iar Comisia Europeană precizează că obligațiile de raportare se aplică din 11 septembrie 2026, în timp ce obligațiile principale se aplică din 11 decembrie 2027. Pentru o firmă care livrează software în UE, asta înseamnă că descoperirea unei vulnerabilități exploatate activ nu mai e o chestiune internă. Detaliile de aplicare sunt în articolul despre Cyber Resilience Act și raportarea vulnerabilităților.
Legătura cu subiectul de față e directă: dacă volumul de cod crește, iar controalele rămân la nivelul de acum doi ani, fereastra dintre introducerea unui defect și obligația de a-l raporta se îngustează.
Primele două săptămâni: o listă de control
Ordinea contează — începe cu ce blochează, nu cu ce raportează.
- Instalare reproductibilă în integrarea continuă (
npm cisau echivalent), fără rezolvare de versiuni. - Protecție la push pentru secrete, activată la nivel de organizație, cu ocolire delegată.
- Analiză statică de securitate pe fiecare pull request, blocantă pentru categoriile critice.
- Verificarea dependențelor vulnerabile, blocantă pentru severitate ridicată.
- Pas care listează importurile noi și le verifică vârsta și proveniența.
- Etichetă și revizor desemnat pentru orice modificare ce adaugă o dependență.
- Listă de excludere pentru contextul agentului: fișiere de mediu, chei, date reale.
- Fișier de instrucțiuni la nivel de depozit, cu regulile de securitate ale proiectului.
- Interdicție explicită: fără cod generat direct în modulele de autentificare, criptografie și plăți.
- SBOM generat la fiecare livrare și păstrat.
- Procedură scrisă de rotație a secretelor, cu responsabil.
- O rulare lunară a scanării complete pe depozit, cu raport citit de o persoană.
Zece dintre cele douăsprezece puncte sunt utile și pentru o echipă care nu folosește deloc agenți. Asta e, de fapt, vestea bună: securizarea codului generat nu cere o disciplină nouă, ci aplicarea consecventă a uneia vechi, la un volum mai mare.
Întrebări frecvente
Î: Cât de des conține vulnerabilități codul generat de AI? R: Raportul 2025 GenAI Code Security Report al Veracode, realizat pe peste 100 de modele de limbaj, a constatat că 45% dintre mostrele de cod au picat testele de securitate, introducând vulnerabilități din OWASP Top 10. Ratele diferă pe limbaje: 72% pentru Java, 45% pentru C#, 43% pentru JavaScript și 38% pentru Python. Cifrele descriu mostre de cod generate în condiții de test, nu rata de incidente din producția unei anumite echipe.
Î: Modelele mai noi scriu cod mai sigur? R: Nu, potrivit aceleiași măsurători. Raportul notează că modelele au devenit mai bune la a scrie cod funcțional și corect sintactic, dar performanța de securitate a rămas plată, indiferent de dimensiunea modelului. Concluzia practică e că problema se tratează cu procese și unelte deterministe, nu prin așteptarea următoarei generații de modele.
Î: Ce este slopsquatting și cât de real e riscul? R: Este publicarea, de către un atacator, a unui pachet real cu numele unui pachet inexistent pe care modelele îl recomandă în mod repetat. Lucrarea de la USENIX Security 2025 a găsit 205.474 de nume unice de pachete inexistente în 576.000 de mostre de cod, iar 43% dintre numele halucinate au reapărut în toate cele zece reluări ale aceleiași solicitări. Reproductibilitatea e ceea ce face atacul practic: atacatorul poate anticipa ce nume va fi recomandat din nou.
Î: Ne protejează revizuirea umană a codului? R: Parțial, și nu pe clasele care contează cel mai des. Un om observă greu o dependență inventată sau un algoritm criptografic depășit într-o modificare mare și bine formatată. Revizuirea umană rămâne esențială pentru intenție, arhitectură și zonele sensibile, dar trebuie să se sprijine pe verificări deterministe care rulează întotdeauna: analiză statică, scanarea secretelor, verificarea dependențelor, instalare reproductibilă.
Î: Ce facem dacă un secret a ajuns deja în context sau în istoricul depozitului? R: Îl tratezi ca expus și îl rotești imediat, indiferent dacă depozitul e privat. Ștergerea din istoric nu garantează că valoarea nu a fost deja copiată sau indexată. În paralel, activezi protecția la push pentru a preveni repetarea și verifici cine are drept de ocolire a blocării.
Concluzie
Codul scris de agenți nu e nici mai sigur, nici mai nesigur decât cel scris de oameni sub presiune de timp — e doar mult mai mult, produs mult mai repede, cu aceleași clase de defect. Măsurătorile publice arată un nivel constant de vulnerabilități în rezultat, indiferent de model, și o clasă nouă de risc în lanțul de aprovizionare: pachete care nu există, recomandate în mod repetabil.
Echipele care trec cu bine prin această schimbare nu au un model mai bun. Au un registru intern, o instalare reproductibilă, protecție la push, analiză statică blocantă și o regulă simplă pe care o respectă toată lumea: agentul propune dependențe, omul le acceptă.
Surse: Veracode — 2025 GenAI Code Security Report · USENIX Security 2025 — We Have a Package for You! · Documentația GitHub — scanarea secretelor · Documentația GitHub — protecția la push · Comisia Europeană — Cyber Resilience Act
Articol informativ, publicat la 17 septembrie 2026. Are caracter educativ și nu constituie consultanță juridică sau de securitate. Capacitățile instrumentelor și condițiile de licențiere se modifică — verifică documentația oficială a furnizorului la data implementării.

Cursul care continuă acest articol
Claude Code Mastery: Coding Agentic din Terminal (multi-fișier, git, CI, MCP)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Claude Code: Instalare, CLI și Modelul Mental Agent-First
- Multi-Fișier și Codebase-uri Mari: Plan, Edit, Review și Context Management
- Workflow Git Complet: Branch-uri, Commit-uri, Conflicte, Code Review și PR-uri
- Headless Mode (claude -p) și Automatizare Non-Interactivă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.