Un răspuns de model durează, pentru o cerere obișnuită, între trei și cincisprezece secunde. Fără streaming, utilizatorul se uită la un indicator de încărcare tot acest timp și, în jumătate din cazuri, dă din nou clic sau pleacă. Cu streaming, primul cuvânt apare într-o secundă, iar percepția se schimbă complet — dar abia atunci încep problemele reale: anulare, erori la mijlocul răspunsului, reconectare, apeluri de unelte afișate în interfață, cost plătit pentru tokeni pe care nimeni nu-i mai citește.
Articolul e scris pentru developerii JavaScript și TypeScript care duc un asistent, un chat sau o funcționalitate cu model într-un produs real. Nu e despre generarea aplicației cu un agent, ci despre contractul dintre serverul tău și interfață atunci când răspunsul vine în bucăți.
Ce primești, de fapt, de la server
Furnizorii majori transmit răspunsurile incremental prin server-sent events, cu tipul de conținut text/event-stream. Structura nu e un șir de text tăiat în bucăți, ci o secvență de evenimente cu nume și date JSON.
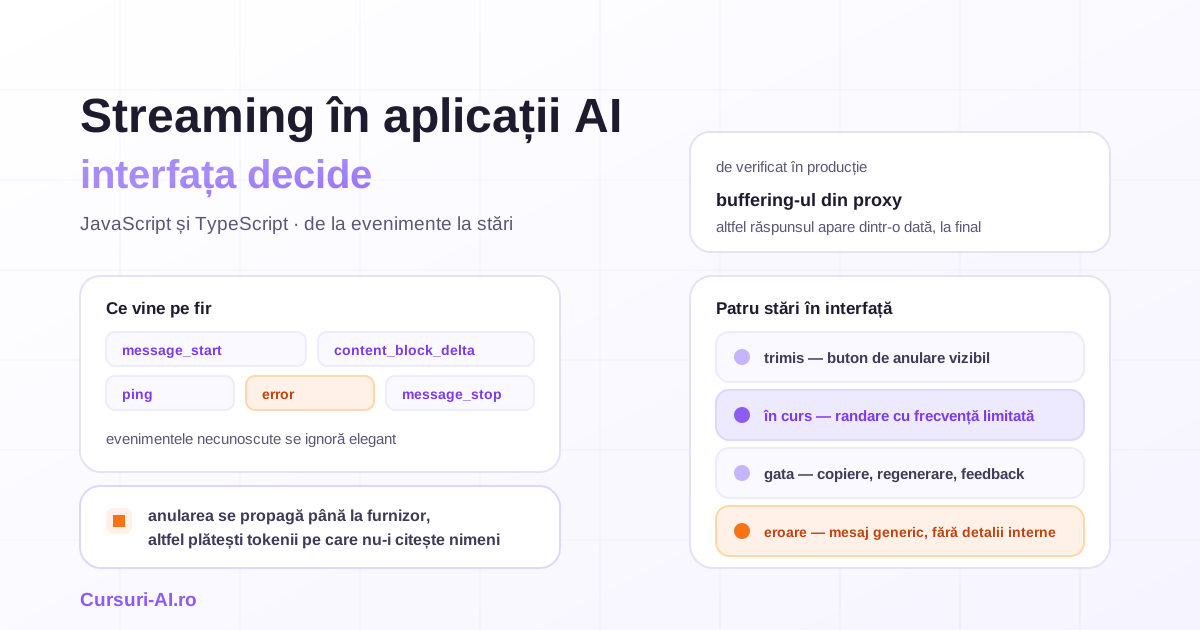
În API-ul Messages de la Anthropic, de exemplu, secvența arată așa: un message_start cu obiectul mesaj și conținut gol, apoi, pentru fiecare bloc de conținut, un content_block_start, una sau mai multe content_block_delta și un content_block_stop, urmate de unul sau mai multe message_delta cu modificările de nivel înalt și, la final, un message_stop.
Trei detalii din documentație care se traduc direct în cod:
Evenimentele ping pot apărea oriunde în flux. Sunt inofensive, dar un parser scris naiv, care presupune că orice eveniment conține text, se oprește la primul.
Erorile vin prin flux, nu prin codul de stare HTTP. Documentația dă exemplul unui overloaded_error, care în context non-streaming ar fi corespuns unui HTTP 529. Practic: conexiunea a reușit, ai început să afișezi text, iar apoi sosește un eveniment de eroare. Interfața ta trebuie să știe ce face cu jumătatea de răspuns deja afișată.
Pot apărea tipuri noi de evenimente. Documentația cere explicit ca aplicația să trateze elegant evenimentele necunoscute. Un switch fără ramură implicită e o eroare de producție care apare la o actualizare a furnizorului, nu la o livrare de-a ta.
Un al patrulea detaliu, util la facturare: în API-ul Messages, numărul de tokeni raportat în usage din evenimentele message_delta este cumulativ. Dacă aduni valorile pe parcursul fluxului, raportezi un cost mai mare decât cel real.
Tratarea completă a acestor cazuri — streaming, erori, apelarea uneltelor, orchestrare și punerea în producție — e subiectul cursului Integrare Avansată LLM în Aplicații de Producție.
De ce EventSource nu e alegerea evidentă
Instinctul e să folosești API-ul nativ pentru server-sent events. Există trei motive practice pentru care majoritatea aplicațiilor nu o fac.
Nu poți trimite un POST. EventSource face o cerere GET, fără corp și fără anteturi personalizate. Conversația ta, cu istoricul mesajelor și cu antetul de autorizare, nu încape acolo.
Limita de conexiuni pe HTTP/1.1. Documentația MDN e explicită: în afara HTTP/2, numărul maxim de conexiuni deschise e limitat, iar limita e per browser și domeniu, fixată la un număr foarte mic — 6. Cu mai multe file deschise pe același domeniu, a șaptea conexiune atârnă. Pe HTTP/2, numărul de fluxuri simultane se negociază între client și server, cu o valoare implicită de 100.
Reconectarea automată poate fi un dezavantaj. EventSource reia singur conexiunea după deconectare, folosind ultimul identificator de eveniment. Pentru o generare de text costisitoare, o reconectare necontrolată înseamnă o a doua facturare pentru același răspuns.
Soluția uzuală: fetch cu POST și citirea corpului ca ReadableStream, cu un decodor de flux SSE scris de tine sau adus din bibliotecă. Câștigi POST, anteturi, control complet asupra anulării — și îți asumi, în schimb, reconectarea și reluarea, dacă le vrei.
Infrastructura care îți înghite streamul
Cel mai frustrant tip de defect din această zonă: codul e corect, funcționează local, iar în producție răspunsul apare dintr-o dată, întreg, după douăsprezece secunde.
Cauza obișnuită e buffering-ul din proxy. În nginx, directiva proxy_buffering este activată implicit: serverul citește răspunsul de la aplicație în buffere și îl trimite clientului când poate, ceea ce anulează exact proprietatea pentru care ai construit streamingul. Când e dezactivată, documentația spune că „răspunsul este transmis clientului sincron, imediat ce este primit". Se poate controla și per răspuns, prin antetul X-Accel-Buffering: no trimis de aplicație — soluția preferabilă, pentru că nu schimbă comportamentul întregului server. Atenție dacă echipa de infrastructură a activat proxy_ignore_headers pentru acest antet: atunci controlul rămâne exclusiv în configurația nginx.
Restul listei de verificat, când streamul „nu curge":
- Compresia intermediară, care poate aștepta un bloc întreg înainte să trimită ceva.
- Timeout-urile de pe traseu: proxy, echilibrator de sarcină, platformă de găzduire. Un răspuns lung cu gândire extinsă poate depăși limita implicită.
- Heartbeat. Trimiterea unui eveniment de menținere a conexiunii la câteva secunde previne închiderea de către intermediari. Furnizorii fac deja asta prin
ping; dacă tu retransmiți către browser un flux propriu, adaugă-ți echivalentul. - Ordinea în care scrii anteturile. Ele trebuie trimise și golite înainte de primul fragment, altfel unele intermediare decid singure cum tratează răspunsul.
Stările interfeței: patru, nu două
O interfață care tratează doar „se încarcă" și „gata" va fi rescrisă. AI SDK de la Vercel expune patru stări în useChat, iar ele descriu bine realitatea oricărei implementări: submitted (mesajul a fost trimis și se așteaptă începerea fluxului), streaming (răspunsul curge activ), ready (răspunsul complet a fost primit și procesat) și error.
Ce afișezi în fiecare:
- În
submitted, un indicator care nu mimează text. Aici se pune și butonul de anulare, pentru că întârzierea până la primul token e momentul cu cel mai mare abandon. - În
streaming, textul care crește, cu cursor, și butonul de oprire vizibil permanent. În AI SDK, funcțiastop()abandonează cerereafetch; echivalentul, dacă îți scrii singur stratul, e unAbortControlleral cărui semnal e propagat până la apelul către furnizor. - În
ready, acțiunile care au sens abia la final: copiere, regenerare, feedback. - În
error, un mesaj neutru și posibilitatea de reluare.
Două decizii pe care majoritatea echipelor le iau abia după primul incident:
Ce faci cu răspunsul parțial. Dacă utilizatorul a oprit generarea sau fluxul s-a rupt, textul afișat există. Îl păstrezi în istoric, marcat explicit ca incomplet, sau îl elimini? Alegerea trebuie să fie conștientă, pentru că un răspuns trunchiat păstrat fără marcaj devine, la următoarea cerere, context care induce modelul în eroare.
Frecvența de randare. Un token per randare înseamnă sute de actualizări pe secundă și o interfață care se împotmolește pe dispozitive slabe. AI SDK oferă o opțiune de limitare a frecvenței — documentația exemplifică o valoare de 50 ms. Dacă îți scrii singur stratul, adună fragmentele într-un tampon și randează pe interval fix.
Apelurile de unelte, în interfață
Când modelul cheamă o unealtă, utilizatorul vede, în lipsa unui tratament explicit, o pauză inexplicabilă în mijlocul răspunsului.
Regulile care funcționează:
- Arată pasul, nu detaliile. „Caut în documentele tale…" e informație; argumentele funcției și răspunsul brut al uneltei nu sunt, iar afișarea lor scurge adesea structura internă a sistemului.
- Confirmare umană pentru orice acțiune cu efect. Citirea poate fi automată; trimiterea unui e-mail, emiterea unei facturi sau modificarea unei înregistrări cer un clic. Aceasta e și o măsură de securitate, nu doar de produs: e bariera care oprește o instrucțiune ostilă ajunsă în context.
- Stare separată pentru „modelul lucrează". Între apelul uneltei și reluarea generării, interfața trebuie să arate altceva decât cursorul de text.
Diferența dintre un asistent care doar răspunde și unul care execută pași cu unelte e explicată pe larg în articolul despre ce sunt AI agents.
Arhitectura agenților cu unelte, cu guardrails și observabilitate, e tratată în cursul AI Agents: arhitectură și automatizare.
Erori fără scurgeri de informație
Recomandarea din documentația AI SDK e scurtă și corectă: afișează un mesaj generic, de tipul „Ceva nu a funcționat", tocmai pentru a evita scurgerea de informații dinspre server. Mesajul de eroare este, implicit, mascat.
Peste asta, patru comportamente utile:
- Distinge între „nu a început" și „s-a rupt la mijloc". În primul caz, reluarea automată e sigură. În al doilea, reluarea produce un răspuns dublat: ori reiei complet și înlocuiești, ori marchezi vizibil răspunsul ca incomplet.
- Reîncercare cu pauză crescătoare, doar pentru erori tranzitorii — suprasolicitare, limitare de rată, erori de rețea. Niciodată pentru erori de validare sau de autorizare.
- Identificator de corelare trimis în răspuns și jurnalizat pe server. Când un utilizator raportează „mi-a dat eroare", vrei să regăsești cererea în cinci secunde.
- Jurnalizare pe server, nu în browser. Conținutul promptului și al răspunsului nu are ce căuta în consola clientului, iar în jurnalele serverului intră doar după o decizie explicită privind datele cu caracter personal.
Costul pe care îl plătești fără să-l vezi
Trei scurgeri specifice interfețelor cu streaming:
Anularea care nu ajunge la furnizor. Utilizatorul apasă „Stop", interfața încetează să afișeze, dar serverul tău continuă să citească fluxul până la capăt și plătește fiecare token. Semnalul de anulare trebuie propagat până la apelul către furnizor, iar închiderea conexiunii de către client trebuie tratată pe server ca abandon.
Fila închisă. Același caz, declanșat de browser.
Reluările tăcute. O reconectare automată care repornește generarea dublează costul fără niciun semnal vizibil.
Contramăsuri: limită de tokeni per răspuns, limită de cereri per utilizator și per sesiune, jurnalizarea costului pe conversație și o alertă pe media zilnică. Modelul de cost pentru agenți cu context lung e detaliat separat în articolul despre costul unui agent AI.
Ce cere legea să fie vizibil în interfață
Partea care se implementează tot în front-end, deci intră în aceeași listă de livrare.
Regulamentul (UE) 2024/1689 — Regulamentul privind inteligența artificială — prevede la articolul 50 alineatul (1) că furnizorii se asigură că sistemele de AI destinate să interacționeze direct cu persoane fizice sunt proiectate astfel încât persoanele să fie informate că interacționează cu un sistem de inteligență artificială. Alineatul (2) privește marcarea, într-un format care poate fi citit automat, a conținutului sintetic generat — audio, imagine, video sau text. Aceste obligații de transparență se aplică începând cu 2 august 2026, potrivit articolului 113.
Traducerea în interfață e banală și se face o dată: o etichetă vizibilă care spune că răspunsurile sunt generate de un asistent AI, fără ca produsul să sugereze că vorbești cu un om, plus tratarea marcării pentru conținutul generat. Cadrul complet — cine e furnizor, ce se marchează, ce excepții există — e subiectul cursului Transparența conținutului AI și articolul 50.
Merită tratat din prima versiune, nu adăugat ulterior: e singura cerință din acest articol care nu se poate rezolva printr-o corecție tehnică rapidă, pentru că atinge modul în care produsul se prezintă utilizatorului.
Listă de livrare
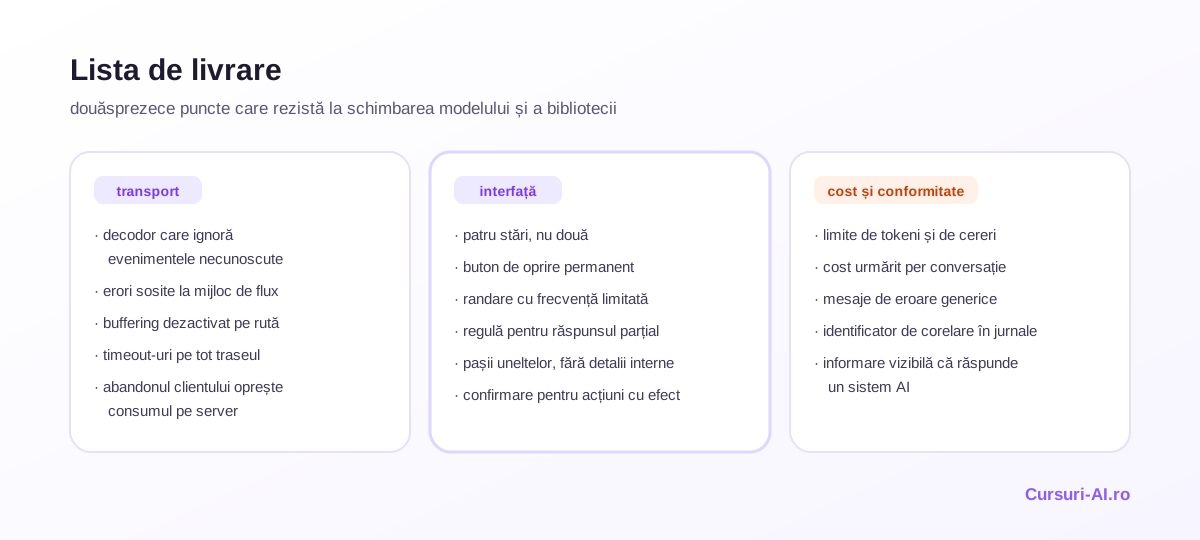
- Decodor SSE care ignoră elegant evenimentele necunoscute și
ping. - Tratarea evenimentelor de eroare sosite la mijlocul fluxului.
AbortControllerpropagat de la butonul de oprire până la apelul către furnizor.- Abandonul clientului tratat pe server, cu oprirea consumului.
- Antet
X-Accel-Buffering: nosau configurație de proxy verificată în mediul real. - Timeout-uri verificate pe tot traseul, pentru cel mai lung răspuns plauzibil.
- Randare cu frecvență limitată, testată pe un telefon de gamă medie.
- Patru stări distincte în interfață, nu două.
- Decizie explicită privind răspunsurile parțiale: păstrate și marcate, sau eliminate.
- Mesaje de eroare generice pentru utilizator, cu identificator de corelare în jurnale.
- Limite de tokeni și de cereri, plus urmărirea costului per conversație.
- Informarea vizibilă că utilizatorul interacționează cu un sistem AI.
Traseul complet de cursuri pentru acest limbaj, de la fundamentele modelelor la evaluare și securitate, e în secțiunea AI pentru programatori JavaScript și TypeScript.
Întrebări frecvente
Î: Ce folosesc pentru streaming — EventSource sau fetch?
R: În majoritatea aplicațiilor, fetch cu POST și citirea corpului ca flux. EventSource face doar cereri GET, fără anteturi personalizate, deci nu poate trimite istoricul conversației și antetul de autorizare. În plus, documentația MDN notează că, în afara HTTP/2, numărul de conexiuni deschise e limitat per browser și domeniu la 6, ceea ce devine o problemă reală cu mai multe file deschise.
Î: De ce răspunsul apare dintr-o dată în producție, deși local curge normal?
R: Aproape întotdeauna din cauza buffering-ului dintr-un proxy. În nginx, proxy_buffering este activat implicit, iar răspunsul e reținut în buffere înainte de a fi trimis. Soluția obișnuită e antetul X-Accel-Buffering: no pe răspunsurile de tip flux sau dezactivarea buffering-ului pe ruta respectivă. Verifică și compresia intermediară și timeout-urile de pe traseu.
Î: Ce fac cu textul deja afișat dacă utilizatorul oprește generarea? R: Alege o regulă și aplic-o consecvent: fie păstrezi răspunsul parțial marcat vizibil ca incomplet, fie îl elimini. Cazul de evitat e păstrarea nemarcată, pentru că textul trunchiat ajunge în contextul cererii următoare și degradează răspunsurile ulterioare. Indiferent de alegere, semnalul de anulare trebuie să ajungă până la furnizor, altfel continui să plătești tokenii generați.
Î: Cum tratez o eroare care apare după ce am afișat jumătate de răspuns? R: Ca pe un caz distinct de eroarea la pornire. Erorile pot sosi prin fluxul de evenimente — de exemplu o eroare de suprasolicitare — după ce conținutul a început să curgă. Afișează un mesaj neutru, oferă reluarea și decide dinainte dacă reluarea înlocuiește răspunsul parțial sau continuă de unde s-a oprit. Reîncercarea automată se aplică doar erorilor tranzitorii.
Î: Trebuie să scriu undeva în interfață că utilizatorul vorbește cu un AI? R: Da. Articolul 50 alineatul (1) din Regulamentul (UE) 2024/1689 prevede că sistemele destinate să interacționeze direct cu persoane fizice trebuie proiectate astfel încât persoanele să fie informate că interacționează cu un sistem de inteligență artificială, iar obligațiile de transparență se aplică din 2 august 2026. Practic: o etichetă vizibilă, un produs care nu sugerează că răspunde un om și tratarea marcării pentru conținutul generat.
Concluzie
Diferența dintre o demonstrație și o funcționalitate livrabilă nu stă în model, ci în tot ce se întâmplă în jurul fluxului de răspuns: evenimente necunoscute tratate elegant, erori sosite la mijloc, anulare propagată până la furnizor, buffering dezactivat pe traseu, randare limitată ca frecvență și o decizie explicită despre răspunsurile incomplete.
Sunt douăsprezece puncte, se implementează într-o săptămână și rezistă la schimbarea modelului, a furnizorului și a bibliotecii. Iar ultimul dintre ele — informarea că utilizatorul interacționează cu un sistem AI — e, din august 2026, și o obligație legală.
Surse: Anthropic — Streaming Messages · MDN — Using server-sent events · AI SDK — Chatbot · nginx — ngx_http_proxy_module · Regulamentul (UE) 2024/1689
Articol informativ, publicat la 17 septembrie 2026. Are caracter educativ și nu constituie consultanță juridică. API-urile și bibliotecile menționate evoluează — verifică documentația oficială la data implementării.

Cursul care continuă acest articol
Integrare Avansată LLM în Aplicații de Producție
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Integrării LLM în 2026
- Streaming și Error Handling
- Function Calling și Tool Use
- Model Context Protocol (MCP)
+ încă 5 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.