Gemini 4 Carbon API e disponibil din 10 noiembrie 2026 pentru toți developerii cu facturare activă, sub ID-ul stabil gemini-4-carbon. Pe hârtie, migrarea de pe Gemini 4 Argon e o linie de cod: aceeași schemă a cererii, aceleași tarife ca Argon. În producție însă Carbon gândește mai mult pe fiecare tură, iar asta se vede în trei locuri: în max_output_tokens, în timeout-urile HTTP și în factură. Mai jos: fișa tehnică, apelurile, setările și protocolul de migrare.
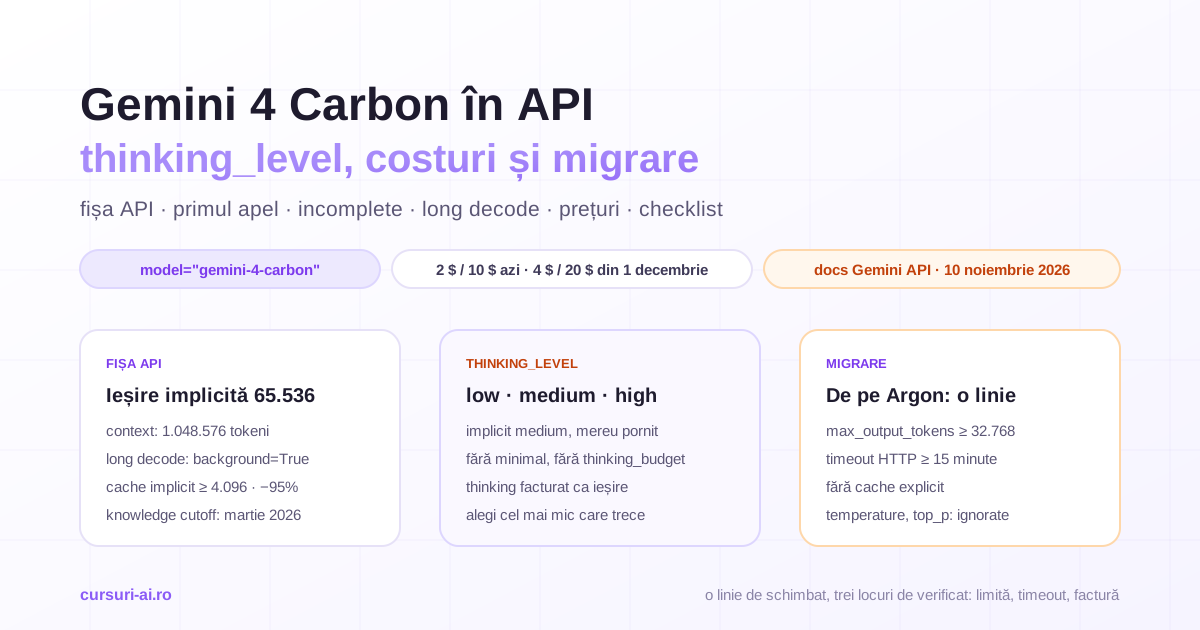
Gemini 4 Carbon API pe scurt: ce schimbi în cod
- Thinking-ul e mereu pornit, reglat doar cu
thinking_level(low,medium,high); fărăminimalșithinking_budget. max_output_tokensinclude thinking-ul: o limită mică dă statusul"incomplete", cu text gol, dar facturat.- Peste 64K tokeni de ieșire lucrezi în background (long decode); cache-ul explicit și parametrii de sampling dispar.
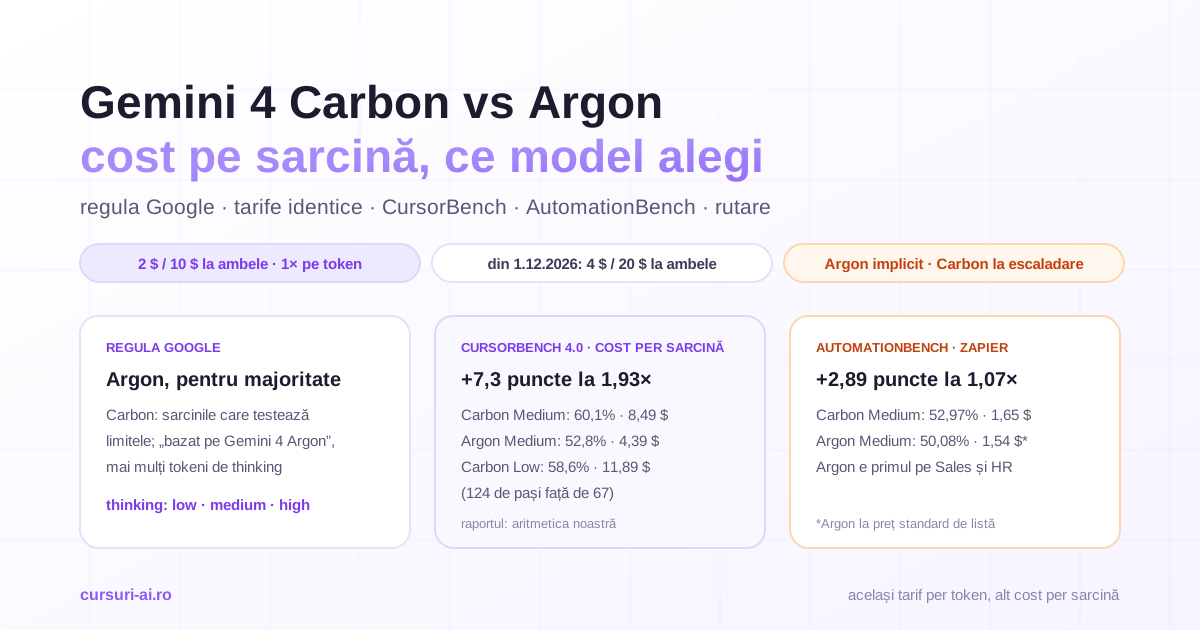
- Prețul se dublează pe 1 decembrie 2026: 2 $ / 10 $ până atunci, 4 $ / 20 $ după, per milion de tokeni.
Sunt probleme de integrare, nu de prompt. Tiparele de bază sunt construite în modulul „Producție de bază: cost, erori, retry și logging” din cursul Construire de Aplicații AI cu Python și SDK-uri, în lecțiile „Error handling și retry: cod robust care nu cade la prima eroare” și „Cost și rate limits: tokeni, bugete și limite ale API-ului”. Cursul folosește SDK-urile OpenAI și Anthropic; aici le aplicăm pe google-genai.
Ce este Carbon e în articolul de prezentare Gemini 4 Carbon. Migrarea e o linie; decizia, pe rute și cost pe sarcină, e în Gemini 4 Carbon vs Gemini 4 Argon.
Fișa tehnică Gemini 4 Carbon în API
Valorile vin din pagina modelului, din „What's new in Gemini 4 Carbon” și din model card, la 10 noiembrie 2026.
| Criteriu | Gemini 4 Carbon |
|---|---|
| ID API | gemini-4-carbon (stabil, actualizat în noiembrie 2026) |
| Fereastră de context | 1.048.576 tokeni, comună pentru intrare, thinking și ieșire |
| Ieșire maximă implicită (sincron) | 65.536 tokeni |
| Ieșire maximă cu long decode | până la 1.048.576 minus intrarea |
| Un „hop” în foreground | 65.536 (streaming) / 32.768 (fără streaming) |
| Intrare | text, imagini, audio, PDF, clipuri |
| Ieșire | text |
| Knowledge cutoff | martie 2026 (model card) |
| Thinking | low, medium (implicit), high |
| Cache | doar implicit, minimum 4.096 tokeni |
| Nivel fără plată | nu |
La limitări, model card-ul trece „ocazional lentoare sau timeout-uri” și faptul că modelul „poate folosi mai mulți tokeni pentru a maximiza performanța, mai ales la nivelurile de thinking mai mari” (traducerea noastră). Ambele se tratează în cod.
Primul apel: Python, JavaScript și REST
Cheia, Prepay și limitele contului sunt în ghidul despre cheia API Gemini. Quickstart-ul oficial pentru Carbon folosește Interactions API.
Python, cu pachetul google-genai:
from google import genai

client = genai.Client()  # citește GEMINI_API_KEY din mediu

interaction = client.interactions.create(
    model="gemini-4-carbon",
    input="Testul de integrare pică doar în CI. Care sunt cauzele probabile?",
    generation_config={"thinking_level": "medium"},
)
print(interaction.status)
print(interaction.output_text)
print(interaction.usage)
JavaScript, cu pachetul @google/genai:
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

const interaction = await client.interactions.create({
  model: "gemini-4-carbon",
  input: "Testul de integrare pică doar în CI. Care sunt cauzele probabile?",
  generation_config: { thinking_level: "medium" },
});
console.log(interaction.status);
console.log(interaction.output_text);
console.log(interaction.usage);
REST, cu curl:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-carbon",
    "input": "Testul de integrare pică doar în CI. Care sunt cauzele probabile?",
    "generation_config": {"thinking_level": "medium"}
  }'
Răspunsul REST nu are output_text: unești textul din pașii model_output din steps. Din primul apel loghezi status, usage și id; fără ele nu poți depana nici răspunsurile incomplete, nici factura.
thinking_level: cum alegi nivelul
Carbon are thinking mereu pornit. Singurul control e generation_config={"thinking_level": ...}, cu trei valori, descrise așa în documentația pentru Carbon:
| Nivel | Ce face | Unde îl folosești |
|---|---|---|
low |
cei mai puțini tokeni, latență minimă | sarcini mai simple, unde calitatea rămâne peste prag |
medium (implicit) |
echilibrat | majoritatea sarcinilor, inclusiv cod complex |
high |
cei mai mulți tokeni, primul token cel mai lent | matematică, știință și cod foarte grele |
Sfatul oficial: rulezi evaluările pe toate trei nivelurile și alegi cel mai mic nivel care trece pragul de calitate. Două capcane:
lownu înseamnă automat cost mai mic pe sarcină. Pe un agent, mai puțin thinking poate lungi bucla: mai mulți pași, mai multă intrare recitită. Măsori costul pe sarcină reușită. Cifrele publicate pe benchmark-uri de agenți sunt în comparația Carbon vs Argon.- Nu copia nivelul de pe alt model. Google precizează că Carbon „cheltuie mai mulți tokeni de thinking per tură” decât Argon, fără un procent.
Rezumatele de raționament le pornești cu thinking_summaries: "auto" în generation_config (implicit primești doar răspunsul final). Rezumatul nu schimbă factura: plătești toți tokenii de thinking. Codul care citește pașii thought trebuie să accepte un summary gol sau absent.
max_output_tokens și statusul „incomplete”
Aici se rup cele mai multe integrări vechi. max_output_tokens e o limită comună pentru thinking și răspuns: dacă e atinsă în timpul raționamentului, statusul e "incomplete", textul poate fi trunchiat sau gol, iar thinking-ul se facturează.
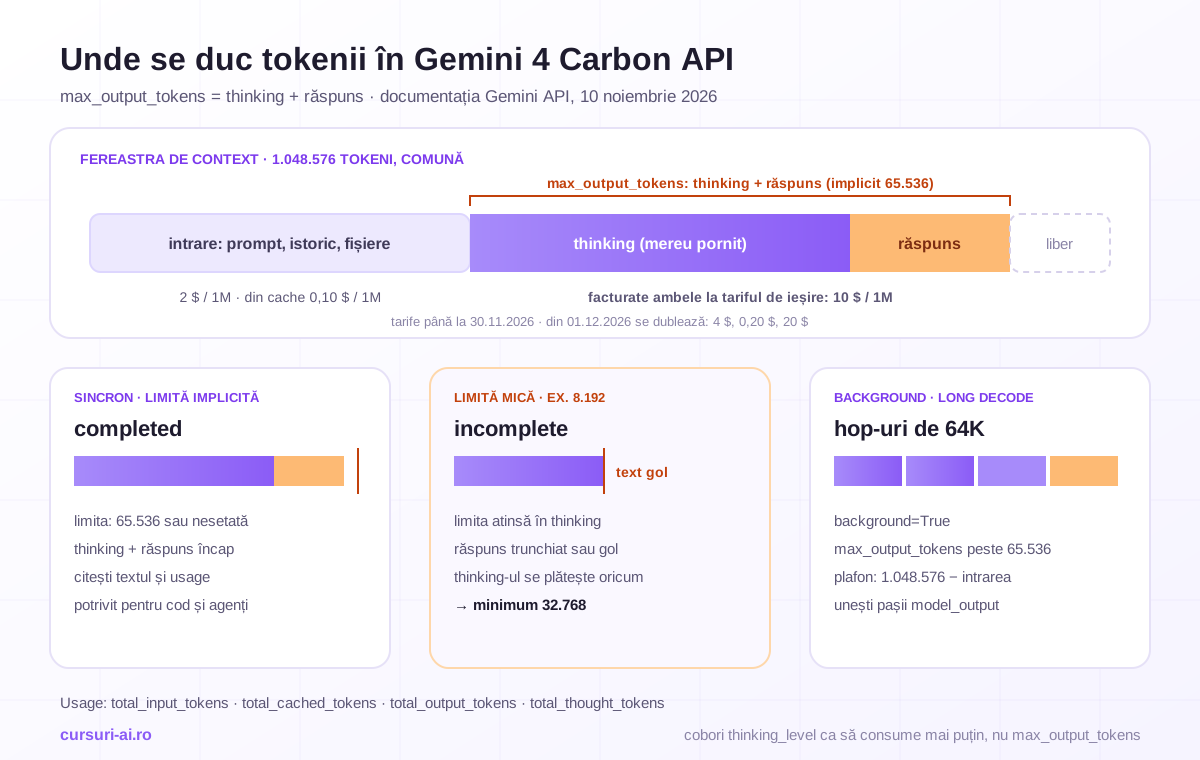
Recomandările oficiale:
- Lași 65.536 sau nu setezi parametrul pentru sarcinile obișnuite, inclusiv coding și agenți.
- Aplicațiile care aveau o limită sub 32K o urcă la minimum 32.768. Documentația dă exemplul unui 8.192 care oprește modelul înainte să termine de gândit; verifică și valoarea din framework-ul de agenți sau din unealta de evaluare.
- Pentru raționament și cod complex:
background: true, cu 131.072 sau 262.144.
Documentația despre long decode precizează că o limită mai mică nu face modelul mai concis, doar îl oprește mai devreme. Ca să consume mai puțini tokeni, cobori thinking_level.
Statusurile pe care codul trebuie să le trateze explicit:
| Status | Ce înseamnă | Ce faci |
|---|---|---|
completed |
modelul a terminat | citești textul și usage |
incomplete |
s-a consumat tot max_output_tokens; textul poate fi gol |
retrimiți cu limită mai mare sau reiei cu previous_interaction_id + continuation_token |
requires_action |
modelul cere un apel de funcție | rulezi unealta și trimiți rezultatul cu id-ul interacțiunii |
failed |
serverul nu a putut termina | reîncerci; dacă pică din nou, trimiți id-ul la suport |
La incomplete, loghezi total_thought_tokens și nu reîncerci cu aceeași limită: repeți cheltuiala pe thinking și, de regulă, rezultatul. Urci limita, cobori nivelul sau muți ruta în background.
Long decode în background
Când un răspuns are nevoie de peste 64K tokeni, setezi background=True și max_output_tokens peste 65.536. Serverul continuă în hop-uri de 64K, fiecare cu un pas model_output, iar textul îl unești din toți. O interacțiune în background rulează până la 24 de ore și cere store: true (implicit).
import time
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-carbon",
    input="Analizează modulul de facturare atașat și propune refactorizarea completă.",
    background=True,
    generation_config={"max_output_tokens": 262144, "thinking_level": "high"},
)

while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    content.text
    for step in interaction.steps
    if step.type == "model_output"
    for content in step.content
    if content.type == "text"
)
print(interaction.status, interaction.usage)
Reguli din documentație:
- Fără
max_output_tokens, o interacțiune în background se oprește la 64K. - Plafonul real e fereastra minus intrarea: 1.048.576 minus promptul.
- Nu folosi long decode pentru chat, clasificare, extracție sau agenți cu multe ture scurte; documentația le marchează explicit ca nepotrivite.
La facturare, fiecare hop retrimite promptul plus tot ce s-a generat până atunci, iar usage.total_input_tokens adună intrările tuturor hop-urilor. În exemplul din documentație, un prompt de 1.000 de tokeni care produce 200.000 de tokeni de thinking și răspuns trece prin patru hop-uri și raportează circa 397.000 de tokeni de intrare, la un context real de circa 201.000. Intrarea repetată primește automat reducerea de 95% a cache-ului implicit. Calcul ilustrativ, la tarifele introductive: 200.000 × 10 $ / 1M = 2,00 $ pe ieșire, plus circa 396.000 × 0,10 $ / 1M ≈ 0,04 $ pe intrarea repetată, deci aproximativ 2,04 $; din 1 decembrie, aproximativ 4,08 $. Reține și că total_input_tokens nu măsoară contextul: nu-l folosi ca să decizi când comprimi istoricul.
Timeout-uri: clientul nu trebuie să închidă primul
Fără background, adică la continuarea din client, documentația long decode dă o durată de cel mult 10 minute pentru un hop fără streaming și 20 de minute pentru unul cu streaming; modul background merge până la 24 de ore. Ghidul de migrare pentru Carbon cere un timeout HTTP de cel puțin 15 minute sau trecerea pe background. Un timeout de 3 sau 5 minute taie cererea înainte să termine modelul.
În SDK-ul Python, timeout-ul se setează pe client, în milisecunde:
from google import genai
from google.genai import types

client = genai.Client(http_options=types.HttpOptions(timeout=1_200_000))  # 20 de minute
Verifică tot lanțul (load balancer, proxy, worker, serverless): o verigă sub 15 minute înseamnă background cu polling, nu retry-uri.
Cache implicit: −95%, fără cache explicit
Pe Carbon, cache-ul e doar implicit: pornit automat pentru prompturi de minimum 4.096 tokeni, cu reducere de 95% pe tokenii citiți din cache (0,10 $ per milion în loc de 2 $, până la 30 noiembrie). Cache-ul explicit (caches.create, cached_content) nu e suportat: elimini apelurile care îl creează sau îl referă.
Ca să prinzi cache-ul implicit, conform ghidului de caching:
- pui conținutul mare și comun (instrucțiuni, documentație, schema bazei de date) la începutul promptului;
- trimiți cererile cu același prefix la intervale scurte;
- în conversații și bucle de agent, pe modelele Gemini 4, cererea anterioară se cachează integral doar dacă cea nouă adaugă cel puțin 2.050 de tokeni; altfel, ultimii 2.050 se reprocesează la tariful standard.
Tokenii din cache apar în usage.total_cached_tokens; aproape zero pe o rută cu prefix mare înseamnă de obicei o dată sau un ID pus înaintea conținutului fix.
Parametrii de sampling ignorați
temperature, top_p și top_k se scot din cerere: pe Carbon sunt ignorați, fără eroare. Riscul e tăcut: codul care se baza pe temperature=0 pentru răspunsuri repetabile nu mai primește ce credea, iar testele care comparau textul exact trec pe verificări de structură (structured outputs) sau pe evaluări cu criterii.
Conversații multi-tur: previous_interaction_id și thought signatures
Thought signatures sunt semnăturile criptate care permit modelului să-și continue raționamentul între ture. Varianta recomandată e stateful: store: true (implicit) și previous_interaction_id, iar serverul gestionează semnăturile.
tura1 = client.interactions.create(
    model="gemini-4-carbon",
    input="Analizează diff-ul de mai jos și listează riscurile.\n" + diff,
)
tura2 = client.interactions.create(
    model="gemini-4-carbon",
    input="Scrie testele pentru primele două riscuri.",
    previous_interaction_id=tura1.id,
)
Dacă ții singur istoricul (stateless), regulile sunt stricte:
- retrimiți exact toate blocurile
thought, fără să le modifici sau să le scurtezi; - retrimiți și pașii uneltelor built-in (
google_search_call,google_search_result), care au semnături proprii; - le retrimiți și când schimbi modelul în aceeași sesiune, de exemplu la un fallback pe Argon; documentația spune că backend-ul gestionează compatibilitatea.
Semnăturile apar doar pe pașii thought și pe uneltele built-in. Disciplina istoricului construit doar prin adăugare e în lecția „Conversații multi-tur: istoric, roluri și gestionarea contextului” din același curs Construire de Aplicații AI cu Python și SDK-uri.
Unelte suportate și nesuportate
| Suportate | Nesuportate |
|---|---|
| function calling, structured outputs, code execution | generare audio |
| computer use, URL context, file search | generare de imagini |
| grounding cu Google Search și Google Maps | Live API |
| cache implicit, thinking, Batch, Flex, Priority | cache explicit |
| înțelegerea agentică a clipurilor (implicit statică) |
Cu computer use, Carbon poate conduce un agent care operează ecranul; fiabilitatea buclei (retry, verificarea rezultatului, idempotență) nu ține de model și e tratată în lecția „Retry, Verificarea Rezultatelor și Idempotență” din cursul Computer Use și Browser Agents.
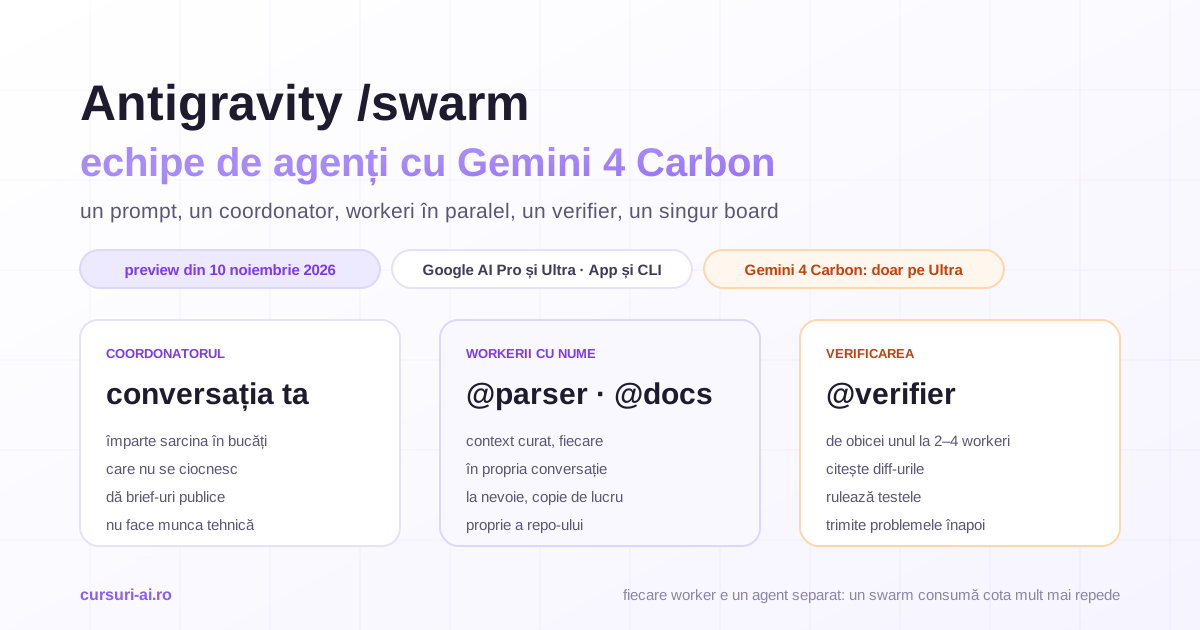
Pentru sarcini lungi, documentația arată și agentul gestionat Antigravity cu Carbon: agent="antigravity-preview-09-2026", agent_config={"type": "antigravity", "model": "gemini-4-carbon"} și environment="remote". Echipele de agenți din aplicația Antigravity, cu /swarm, țin de abonament, nu de API: sunt în ghidul despre /swarm și Gemini 4 Carbon.
Prețul Gemini 4 Carbon API înainte și după 1 decembrie
Tarifele de pe pagina de prețuri Gemini API, în dolari per milion de tokeni, identice cu ale lui Argon pe fiecare rând și fără trepte după lungimea promptului.
| Tarif | până la 30.11.2026 | din 01.12.2026 |
|---|---|---|
| Standard, intrare | 2,00 $ | 4,00 $ |
| Standard, ieșire (inclusiv thinking) | 10,00 $ | 20,00 $ |
| Cache implicit | 0,10 $ | 0,20 $ |
| Batch și Flex: intrare / ieșire / cache | 1,00 $ / 5,00 $ / 0,05 $ | 2,00 $ / 10,00 $ / 0,10 $ |
| Priority: intrare / ieșire / cache | 3,60 $ / 18,00 $ / 0,18 $ | 7,20 $ / 36,00 $ / 0,36 $ |
Ce mai intră în factură:
- Grounding cu Google Search: 5.000 de cereri pe lună incluse, comune pentru Gemini 3 și modelele mai noi, apoi 14 $ la 1.000, cu un plafon de 1.500 de cereri pe zi. O cerere poate genera mai multe interogări, iar fiecare e taxată.
- Fiecare token procesat, inclusiv thinking-ul, instrucțiunile interne ale uneltelor și declarațiile de funcții când folosești grounding.
Batch și Flex înjumătățesc fiecare rând: din 1 decembrie, un job Batch costă cât apelul Standard de azi, deci evaluările și rapoartele peste noapte pleacă de pe Standard.
Controlul costului: formula și câmpurile de usage
Formula costului pe Carbon, cu tarifele pe milion de tokeni:
cost = (intrare necachată × tarif intrare + intrare din cache × tarif cache + (răspuns + thinking) × tarif ieșire) / 1.000.000
plus grounding-ul peste cota inclusă. În interaction.usage ai total_input_tokens, total_cached_tokens, total_output_tokens, total_thought_tokens și total_tokens. În exemplul din documentația de thinking, total_tokens e suma intrării, răspunsului și thinking-ului, deci total_output_tokens nu include thinking-ul: le aduni tu.
TARIF = {"intrare": 2.00, "cache": 0.10, "iesire": 10.00}  # până la 30.11.2026; din 01.12: 4 / 0,20 / 20

def cost_usd(usage):
    cache = usage.total_cached_tokens or 0
    necachat = (usage.total_input_tokens or 0) - cache
    generat = (usage.total_output_tokens or 0) + (usage.total_thought_tokens or 0)
    return (necachat * TARIF["intrare"] + cache * TARIF["cache"] + generat * TARIF["iesire"]) / 1_000_000
Formula presupune, ca exemplul de long decode din documentație, că tokenii din cache sunt incluși în total_input_tokens; confirm-o pe primele zile de factură. Loghezi costul pe interacțiune, cu ruta și nivelul de thinking, și îl agregi pe sarcină.
Calcul ilustrativ: o tură de agent de cod
Ipoteze (nu măsurători): 60.000 de tokeni de intrare, din care 50.000 citiți din cache; 3.000 de tokeni de răspuns și 12.000 de tokeni de thinking.
| Componentă | până la 30.11 | din 01.12 | Batch/Flex din 01.12 |
|---|---|---|---|
| Intrare necachată, 10.000 | 0,020 $ | 0,040 $ | 0,020 $ |
| Intrare din cache, 50.000 | 0,005 $ | 0,010 $ | 0,005 $ |
| Răspuns + thinking, 15.000 | 0,150 $ | 0,300 $ | 0,150 $ |
| Total pe tură | 0,175 $ | 0,350 $ | 0,175 $ |
| La 1.000 de ture pe zi | 175 $ | 350 $ | 175 $ |
Thinking-ul face 0,12 $ din 0,175 $, circa 69% din cost, la doar 16% din tokeni. Pârghiile: nivelul de thinking pe rută, Batch sau Flex pentru ce nu e interactiv, un prefix stabil pentru cache. Pentru bugete și plafoane pe proiect vezi ghidul cheii API Gemini.
Checklist de migrare: de pe Argon și de pe Gemini 3
De pe gemini-4-argon, fără schimbări de schemă: schimbi stringul modelului, păstrezi medium dacă nu ai nevoie de high și lași loc pentru raționament mai lung în max_output_tokens și în timeout-uri.
De pe Gemini 3 și mai vechi, lista e mai lungă:
| Înainte (Gemini 3.x) | După (Gemini 4 Carbon) |
|---|---|
model="gemini-3…" |
model="gemini-4-carbon" |
max_output_tokens sub 32K |
minimum 32.768, ideal 65.536 sau nesetat |
thinking_budget sau nivelul minimal |
doar thinking_level: low, medium, high, testate toate |
caches.create / cached_content |
eliminate; prefix stabil pentru cache-ul implicit |
temperature, top_p, top_k |
scoase (sunt ignorate) |
| răspunsuri peste 64K într-un apel sincron | background=True + max_output_tokens > 65.536 |
| timeout HTTP de câteva minute | cel puțin 15 minute sau background |
| istoric retrimis de client | previous_interaction_id pentru multi-tur și function calling |
| estimare de cost pe vechiul model | re-estimare cu thinking-ul inclus |
Dacă vii de pe Gemini 3.1 Pro și treci întâi prin Argon, schimbările pas cu pas sunt în articolul despre Gemini 4 Argon.
Protocolul, de la inventar la 100% trafic
- Inventarul. ID-urile vechi din cod și configurări, plus rutele cu
max_output_tokensmic, cache explicit, sampling setat sau timeout-uri scurte. - Evaluarea. Aceleași sarcini reale pe modelul actual și pe Carbon la
low,mediumșihigh: rată de reușită, cost pe sarcină reușită, latență, procent deincomplete, cu regula de decizie scrisă înainte. Verificarea automată la schimbarea modelului are o lecție dedicată, „Eval-Gating la Schimbarea Modelului: Migrare și A/B între Versiuni”, în cursul AI Evals pentru LLM-uri în Producție. - Infrastructura. Timeout-uri, cozi și plafoane de cost, înainte de primul procent de trafic.
- Rollout treptat. Model și nivel fixate pe rută, apoi 5%, 25%, 50%, 100%, cu praguri de oprire pe
incomplete,failed, latență și cost pe sarcină. - Rollback. Pe Argon schema e aceeași, deci întoarcerea e tot o linie; în modul stateless retrimiți blocurile
thoughtși după schimbarea modelului. Testează calea înainte să ai nevoie de ea. - Calendarul. Costurile măsurate în noiembrie folosesc tariful introductiv; bugetele pentru decembrie le faci pe tariful dublu.
Carbon pe Google Cloud: Gemini Enterprise Agent Platform
Pe Gemini Enterprise Agent Platform (fostul Vertex AI), Carbon e disponibil general din 10 noiembrie 2026, cu același ID. Conform paginii modelului pe Google Cloud:
- Locații:
globalși multi-regiunileusșieu, pentru disponibilitate, procesare ML, Provisioned Throughput, Standard PayGo și Priority PayGo. - Controale: data residency, CMEK, VPC-SC.
- Varianta cyber,
gemini-4-carbon-cyber-permissive, e în spatele unui allowlist, prin programul Fairwind, doar înglobalșiusși fără computer use.
Pentru o firmă din UE care vrea procesarea în Uniune, eu e motivul principal să aleagă Agent Platform în locul cheii din AI Studio. Unele mecanisme, cum ar fi long decode, pot funcționa diferit între platforme, deci verifică ghidul Agent Platform înainte de a muta codul.
Întrebări frecvente
Ce schimb în cod ca să trec de pe Gemini 4 Argon pe Gemini 4 Carbon?
Doar ID-ul modelului, gemini-4-carbon, fără alte schimbări de schemă. Verifici însă că max_output_tokens și timeout-urile HTTP lasă loc unui raționament mai lung.
De ce primesc statusul „incomplete” cu text gol?
max_output_tokens include și thinking-ul. Dacă limita e atinsă înainte ca modelul să termine de gândit, răspunsul poate fi gol, iar tokenii de thinking se facturează. Urci limita la cel puțin 32.768 (ideal 65.536 sau nesetat) ori cobori thinking_level.
Ce nivel de thinking_level aleg pentru Gemini 4 Carbon?
Implicitul medium e recomandarea Google pentru majoritatea sarcinilor, inclusiv cod complex. Rulezi evaluările pe toate trei nivelurile și păstrezi cel mai mic care trece pragul de calitate.
Cât costă Gemini 4 Carbon API după 1 decembrie 2026? 4 $ per milion de tokeni de intrare și 20 $ per milion de tokeni de ieșire, cu thinking-ul inclus la ieșire; cache-ul implicit 0,20 $. Până la 30 noiembrie, tarifele sunt la jumătate: 2 $ și 10 $. Batch și Flex costă jumătate din Standard pe fiecare rând.
Concluzie
Gemini 4 Carbon API se adoptă cu o linie dacă vii de pe Argon, dar se operează diferit: mai mult thinking pe tură, deci max_output_tokens generos, timeout-uri de cel puțin 15 minute, background pentru ieșirile mari și cost urmărit pe sarcină, cu thinking-ul inclus. Ordinea: inventar, evaluare pe trei niveluri, infrastructură, rollout treptat, bugete pe tariful din 1 decembrie.
Surse
- Google, „Gemini 4 Carbon is now available”: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- Google AI Studio Docs, „What's new in Gemini 4 Carbon”: https://aistudio.google.com/docs/whats-new-gemini-4-carbon
- Google AI Studio Docs, „Gemini 4 Carbon”: https://aistudio.google.com/docs/models/gemini-4-carbon
- Google AI Studio Docs, „Gemini thinking”: https://aistudio.google.com/docs/thinking
- Google AI Studio Docs, „Long decode”: https://aistudio.google.com/docs/long-decode
- Google AI Studio Docs, „Context caching”: https://aistudio.google.com/docs/caching
- Google AI Studio Docs, „Gemini API pricing”: https://aistudio.google.com/docs/pricing
- Google DeepMind, „Gemini 4 Carbon Model Card”: https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Carbon-Model-Card.pdf
- Google Cloud, „Gemini 4 Carbon” pe Gemini Enterprise Agent Platform: https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-carbon
Verificat la 10 noiembrie 2026 pe anunțul Google, în documentația Gemini API din Google AI Studio, pe pagina de prețuri, în model card și în documentația Google Cloud. Calculele de cost sunt ilustrative, cu ipoteze declarate; tarifele introductive expiră pe 30 noiembrie 2026. Conținutul are caracter informativ.

Cursul care continuă acest articol
Construire de Aplicații AI cu Python și SDK-uri (OpenAI, Anthropic): de la API la Produs
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente: de la API de LLM la mediul tău Python
- Primul apel: chat completions, mesaje și parametri
- Streaming și UX: răspunsuri în timp real
- Function calling / tool use: conectează modelul la codul tău
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.