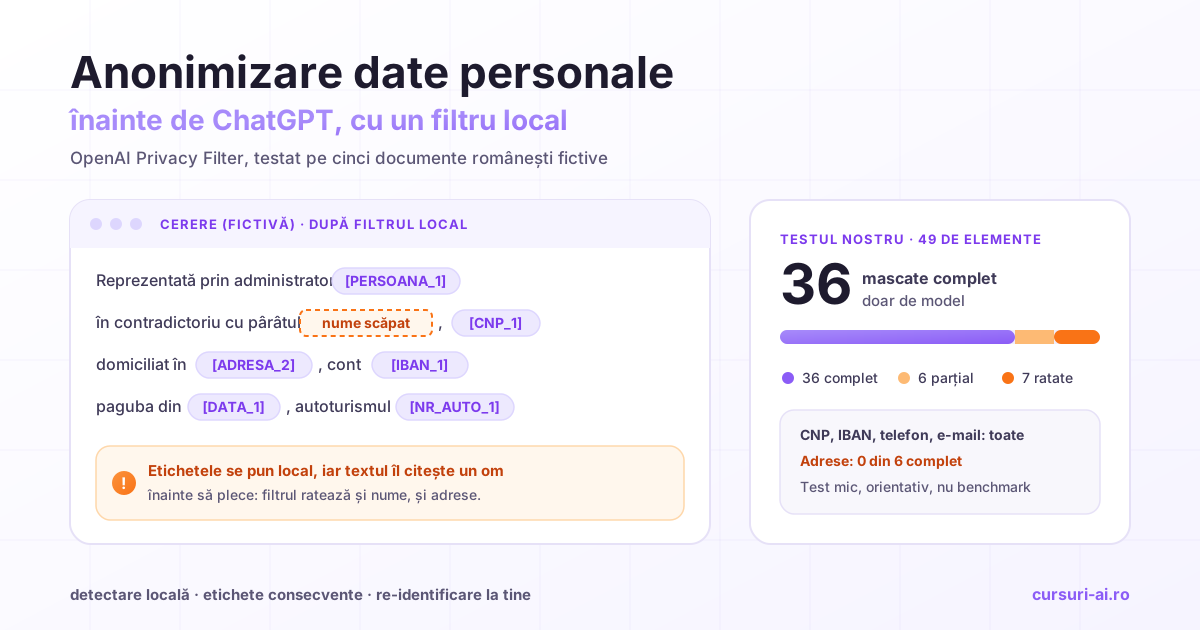
Anonimizare date personale, înainte să lipești un contract sau un e-mail de la client în ChatGPT, se recomandă des, dar rar se arată cum. Am luat unealta publicată de OpenAI pentru asta, modelul local OpenAI Privacy Filter, și am rulat-o pe cinci documente românești fictive, cu CNP-uri, IBAN-uri, serii de buletin și adrese cu bloc și scară. Din 49 de date personale, modelul singur a mascat complet 36, iar printre cele scăpate au fost numele unei cliente și adresa ei de livrare. Mai jos: protocolul, cifrele pe categorii, fluxul de lucru și ce nu face nicio unealtă în locul tău.
Anonimizare date personale sau pseudonimizare: ce faci de fapt
Termenii se folosesc ca sinonime, dar GDPR îi separă, iar diferența decide dacă textul trimis mai e „date personale”.
Pseudonimizarea e definită la art. 4 pct. 5 din Regulamentul (UE) 2016/679: „prelucrarea datelor cu caracter personal într-un asemenea mod încât acestea să nu mai poată fi atribuite unei anume persoane vizate fără a se utiliza informații suplimentare, cu condiția ca aceste informații suplimentare să fie stocate separat și să facă obiectul unor măsuri de natură tehnică și organizatorică”.
Anonimizarea nu are un articol propriu. Considerentul 26 spune că datele pseudonimizate, „care ar putea fi atribuite unei persoane fizice prin utilizarea de informații suplimentare, ar trebui considerate informații referitoare la o persoană fizică identificabilă”. Regulamentul nu se aplică doar datelor „anonimizate astfel încât persoana vizată nu este sau nu mai este identificabilă”, ținând cont de toate mijloacele pe care e probabil, în mod rezonabil, să le folosească cineva.
Când înlocuiești „Ioan Popescu” cu [PERSOANA_1] și păstrezi tabelul care face legătura înapoi, faci pseudonimizare. Pentru tine, textul trimis rămâne date personale. Ghidurile EDPB 01/2025 despre pseudonimizare (versiunea pusă în consultare publică în ianuarie 2025) spun explicit că tabelele de corespondență sunt ele însele date personale și trebuie protejate de acces neautorizat.
O nuanță pentru DPO: în cauza C-413/23 P (EDPS contra SRB, hotărârea din 4 septembrie 2025, pe regulamentul aplicabil instituțiilor UE), Curtea de Justiție a confirmat că datele pseudonimizate nu sunt, în toate cazurile și pentru orice persoană, date personale. Pentru un destinatar fără mijloace rezonabile de re-identificare, pot să nu fie. Pentru obligația de informare, însă, caracterul identificabil se apreciază din perspectiva operatorului, la colectare. Practic, pseudonimizarea nu te scoate din GDPR, dar te ajută la minimizarea datelor și la securitate: art. 25 și art. 32 o numesc explicit printre măsurile tehnice potrivite.
Temeiul legal, planul de cont și contractul de prelucrare sunt tratate în ghidul despre datele clienților în ChatGPT și GDPR. Aici rămânem la partea tehnică. Guvernanța unui sistem AI care prelucrează date personale pe infrastructura proprie (pseudonimizarea înainte de prompt, DPIA, jurnalul de audit) are un modul dedicat în cursul LLM-uri locale cu Ollama: privacy, self-hosting și inferență offline.
Articolul are caracter informativ și nu constituie consultanță juridică.
Ce este OpenAI Privacy Filter, după fișa oficială
OpenAI Privacy Filter a apărut pe Hugging Face în aprilie 2026, cu un repository de cod pe GitHub. Datele de mai jos vin din fișa modelului și din README, consultate la 22 octombrie 2026:
- Ce face: clasificare la nivel de token. Etichetează fiecare token într-o singură trecere, apoi un decodor Viterbi construiește intervale coerente. Nu generează text.
- Licență: Apache 2.0, deci uz comercial permis.
- Dimensiune: 1,5 miliarde de parametri în total, din care 50 de milioane activi per token (arhitectură mixture-of-experts). Fișa spune că rulează într-un browser sau pe un laptop.
- Context: 128.000 de tokeni, fără împărțire în bucăți. Atenția e însă „în bandă”: fiecare token vede 128 de tokeni în stânga și 128 în dreapta, adică o fereastră efectivă de 257 de tokeni.
- Cele 8 categorii:
account_number,private_address,private_email,private_person,private_phone,private_url,private_date,secret. - Rulare: cu Transformers (Python) sau Transformers.js. Repository-ul are în folderul
onnx/variante fp32, fp16, q4 și q4f16. Pachetul oficialopfde pe GitHub oferă o linie de comandă și un API Python, cu decodarea Viterbi inclusă. - Limba: „Primarily English”. Fișa avertizează că performanța poate scădea pe text care nu e în engleză și că modelul poate rata nume neobișnuite sau convenții regionale de denumire.
Fișa mai spune că Privacy Filter e un ajutor pentru redactare și minimizarea datelor, „not an anonymization, compliance, or a safety guarantee”, și cere prudență suplimentară în domeniile medical, juridic, financiar și de resurse umane.
Testul: cinci documente românești fictive, rulate local
Protocolul
- Runtime: pachetul oficial
opf0.1.0 (commitf7f00cadin repository-ul openai/privacy-filter), PyTorch 2.14.1, Python 3.13, pe procesorul unui laptop Apple cu 16 GB de memorie, fără GPU. - Model: checkpoint-ul complet din folderul
original/de pe Hugging Face, cu greutăți bf16. Nu am folosit o variantă cuantizată. - Decodare: Viterbi, cu punctul de operare implicit din fișierul de calibrare. Am rulat și decodarea simplă (argmax), pentru comparație.
- Date: cinci texte scrise de noi, cu persoane inventate: contract de închiriere, reclamație pe e-mail, cerere de chemare în judecată, fișă de consultație, e-mail intern de HR. CNP-urile, IBAN-urile și CUI-ul au cifre de control valide, dar sunt generate.
- Adnotare: 49 de date personale marcate manual (plus 4 date de firmă și 4 numere interne, separat). „Complet” înseamnă că toate literele și cifrele sunt acoperite, „parțial” că rămâne o bucată, „ratat” că nu e atins deloc.
- Reproductibilitate: am rulat testul de trei ori. Intervalele detectate au fost identice de fiecare dată.
E un test mic și orientativ, nu un benchmark: cifrele descriu aceste cinci texte, nu o rată de detecție generală.
Rezultatele, pe categorii
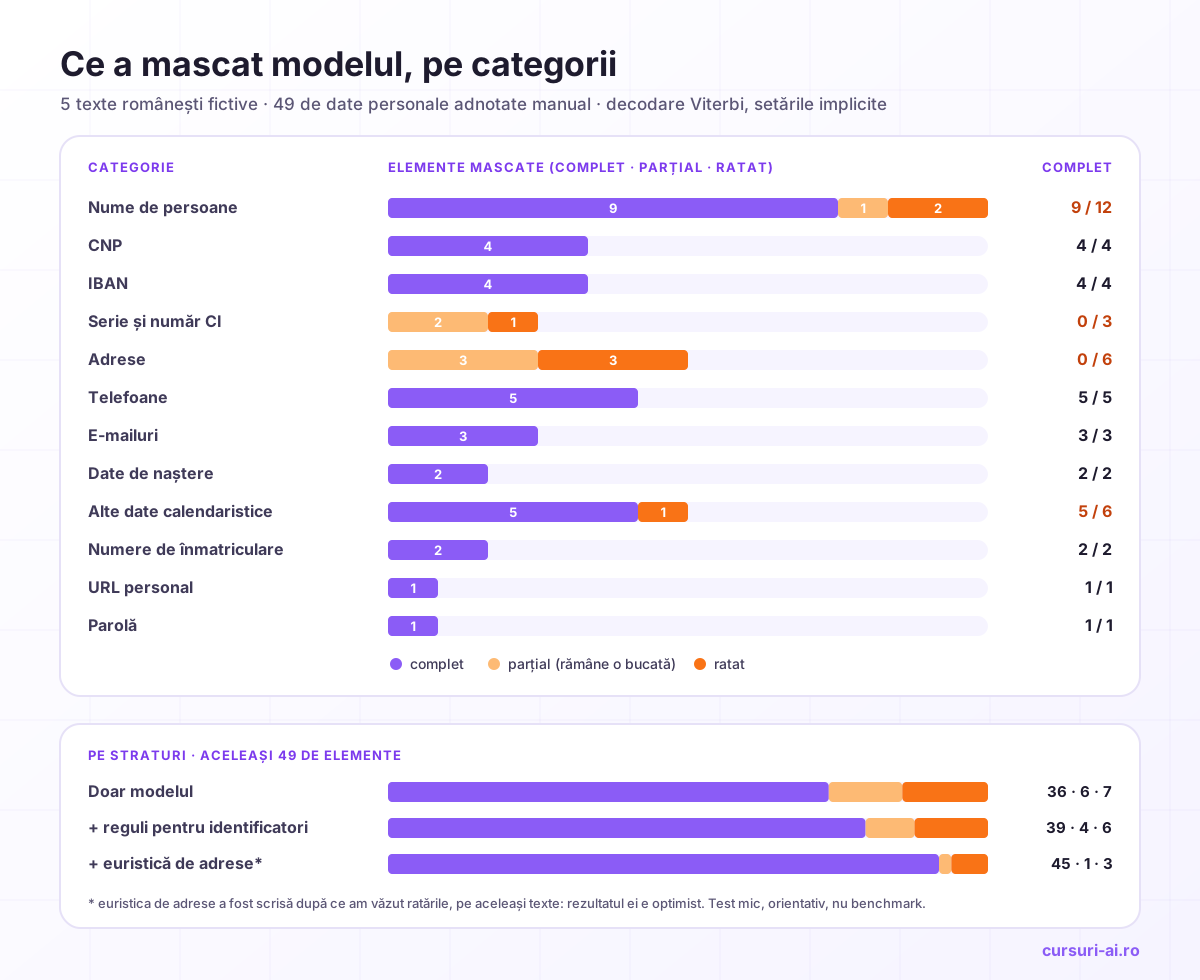
| Categorie | Elemente | Mascat complet | Parțial | Ratat | Eticheta pusă de model |
|---|---|---|---|---|---|
| Nume de persoane | 12 | 9 | 1 | 2 | private_person (cel parțial, private_address) |
| CNP | 4 | 4 | 0 | 0 | account_number |
| IBAN | 4 | 4 | 0 | 0 | account_number |
| Serie și număr CI | 3 | 0 | 2 | 1 | account_number, doar pe număr |
| Adrese | 6 | 0 | 3 | 3 | private_address |
| Telefoane | 5 | 5 | 0 | 0 | private_phone |
| E-mailuri | 3 | 3 | 0 | 0 | private_email |
| Date de naștere | 2 | 2 | 0 | 0 | private_date |
| Alte date calendaristice | 6 | 5 | 0 | 1 | private_date |
| Numere de înmatriculare | 2 | 2 | 0 | 0 | private_person și account_number |
| URL personal | 1 | 1 | 0 | 0 | private_url |
| Parolă | 1 | 1 | 0 | 0 | secret |
| Total | 49 | 36 | 6 | 7 |
Ce se vede din tabel:
- CNP, IBAN, telefoane, e-mailuri, URL și parolă: toate mascate. Modelul nu are o categorie „CNP”, dar l-a prins ca
account_numberîn toate cele patru cazuri. - Adresele românești au fost punctul cel mai slab: niciuna din șase mascată complet, trei ratate în întregime. Într-un caz a prins doar orașul („Cluj-Napoca”, cu strada, blocul și apartamentul lăsate la vedere), în altul a lăsat la vedere scara, etajul și apartamentul („B, et. 5, ap. 61”). În fișa de pacient, numele satului a fost etichetat drept persoană.
- Data scrisă cu luna în litere („14 octombrie 2026”) a scăpat. Toate datele în format cu puncte au fost prinse.
- Seria buletinului a rămas la vedere în cele două cazuri parțiale. Modelul a mascat doar cele șase cifre.
Ce a scăpat, concret
Cele mai grave ratări nu se văd în tabel:
- În e-mailul de reclamație, fraza „Mă numesc Ancuța Țîrlea” a rămas neatinsă, la fel și adresa de livrare. În semnătură, modelul a mascat doar numele de familie și l-a etichetat drept adresă. Telefonul, e-mailul, IBAN-ul, linkul către poze și parola din același mesaj au fost mascate corect.
- În cererea de chemare în judecată, numele administratorului firmei și al martorului au fost mascate, dar numele pârâtului și domiciliul lui au rămas în clar. Adică exact persoana despre care e cererea.
- Etichetele greșite contează și ele. Numărul de înmatriculare din cerere a fost etichetat
private_person. Dacă pui etichetele direct în text, ChatGPT primește „autoturismul cu nr. de înmatriculare [PERSOANA_2]”, iar în răspuns mașina poate deveni martor.
Supra-mascarea a fost redusă: două intervale fără date personale („48 ani”, etichetat drept persoană, și „CEC Bank”, drept cont). Celelalte bănci, instanța și diagnosticul au rămas neatinse. Decodarea argmax a dat aproape același tablou (35 de elemente complete), dar cu cinci intervale mascate fără motiv.
La firme, denumirea și sediul au rămas la vedere, iar numărul de registru și CUI-ul au fost mascate drept account_number. Numărul de comandă și marca angajatei au rămas în clar.
Viteză și memorie. Pe procesorul laptopului, un text de 169–318 tokeni a durat 1,3–4,4 secunde, încărcarea modelului în jur de 6 secunde, iar procesul a ajuns la 2,6–3,9 GB de memorie.
Un test suplimentar: ajută dacă scoți diacriticele?
Am rulat aceleași texte fără diacritice, plus câteva fraze izolate. Nu iese o regulă simplă:
- Fraza izolată „Mă numesc Ancuța Țîrlea și am primit coletul ieri.” a fost mascată corect, cu diacritice. Aceeași frază fără diacritice nu a fost mascată deloc.
- În cererea fără diacritice, numele pârâtului și cea mai mare parte a adresei lui au fost prinse, dar „Timis” din adresa sediului firmei a fost etichetat drept persoană.
- În e-mailul fără diacritice, numele clientei a rămas tot nemascat în prima frază, iar linkul și parola, prinse în varianta cu diacritice, au scăpat. Cuvântul „Daca” a fost etichetat drept persoană.
Comportamentul depinde de context și nu poți prezice dinainte ce va scăpa. Nu modifica textul ca să „ajuți” modelul; verifică rezultatul pe fiecare document.
Fluxul complet: detectare locală, etichete, ChatGPT, re-identificare
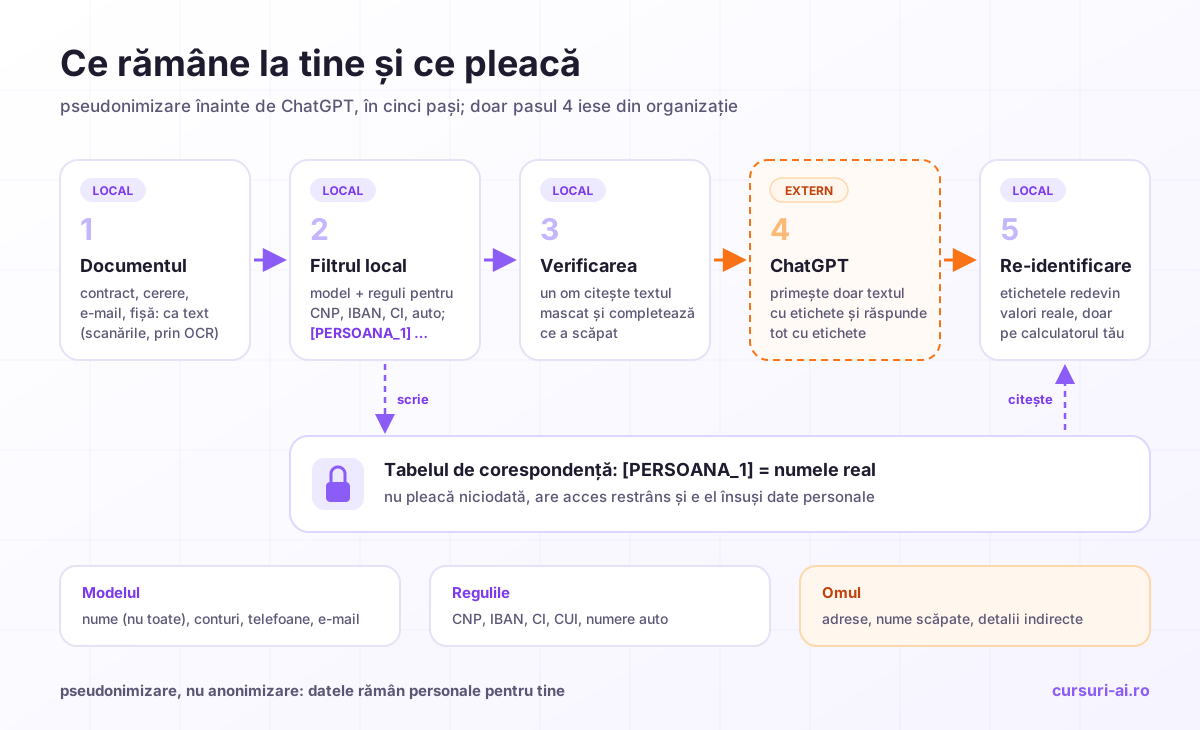
- Textul, nu fișierul. Un PDF scanat trece întâi prin OCR, iar ce trimiți e textul pseudonimizat, nu PDF-ul original. Modelul nu vede imagini sau metadate.
- Detectare locală. Modelul și regulile rulează pe calculatorul tău sau pe un server intern. La prima rulare se descarcă greutățile (aproximativ 2,8 GB) și vocabularul tokenizerului; apoi, în testul nostru, rularea a mers cu modul offline al bibliotecii Hugging Face (
HF_HUB_OFFLINE=1). - Etichete consecvente. Aceeași valoare primește mereu aceeași etichetă în tot documentul. Altfel, ChatGPT nu mai poate urmări cine ce a făcut.
- Verificare umană. Un om citește textul înainte să plece. Testul arată de ce pasul nu e opțional.
- Re-identificare locală. Înlocuiești etichetele din răspuns cu valorile reale, la tine. Tabelul de corespondență nu pleacă din organizație.
Codul de mai jos e varianta scurtă a scriptului de test: aceeași logică, cu două dintre reguli (CNP și IBAN), rulată pe textele de test.
import re
from opf import OPF  # pachetul oficial: github.com/openai/privacy-filter

def cnp_valid(c):
    k = "279146358279"
    s = sum(int(a) * int(b) for a, b in zip(c[:12], k)) % 11
    return c[12] == ("1" if s == 10 else str(s))

def iban_valid(i):
    r = i[4:] + i[:4]
    return int("".join(str(int(ch, 36)) for ch in r)) % 97 == 1

REGULI = [
    ("CNP", re.compile(r"\b[1-9]\d{12}\b"), cnp_valid),
    ("IBAN", re.compile(r"\bRO\d{2}[A-Z]{4}[A-Z0-9]{16}\b"), iban_valid),
]
ETICHETE = {"private_person": "PERSOANA", "private_address": "ADRESA",
            "private_phone": "TELEFON", "private_email": "EMAIL",
            "private_date": "DATA", "account_number": "CONT",
            "private_url": "URL", "secret": "SECRET"}

filtru = OPF(device="cpu")  # prima rulare descarcă modelul; decodare Viterbi implicită

def detecteaza(text):
    spans = [(s.start, s.end, ETICHETE[s.label], 0) for s in filtru.redact(text).detected_spans]
    for eticheta, rx, valid in REGULI:
        spans += [(m.start(), m.end(), eticheta, 1) for m in rx.finditer(text) if valid(m.group())]
    spans.sort(key=lambda s: (s[0], -(s[1] - s[0])))
    unite = []
    for s in spans:  # suprapuneri: reuniune; eticheta regulii are prioritate
        if unite and s[0] < unite[-1][1]:
            a, b, e, r = unite[-1]
            if s[3] > r or (s[3] == r and s[1] - s[0] > b - a):
                e, r = s[2], s[3]
            unite[-1] = (a, max(b, s[1]), e, r)
        else:
            unite.append(s)
    return unite

def pseudonimizeaza(text):
    harta, vazute, contor, bucati, poz = {}, {}, {}, [], 0
    for a, b, e, _ in detecteaza(text):
        cheie = (e, text[a:b].casefold())
        if cheie not in vazute:
            contor[e] = contor.get(e, 0) + 1
            vazute[cheie] = f"[{e}_{contor[e]}]"
            harta[vazute[cheie]] = text[a:b]
        bucati += [text[poz:a], vazute[cheie]]
        poz = b
    return "".join(bucati) + text[poz:], harta

def reidentifica(raspuns, harta):
    for eticheta, valoare in harta.items():
        raspuns = raspuns.replace(eticheta, valoare)
    return raspuns
harta e tabelul de corespondență: îl păstrezi local, cu acces restrâns, și îl ștergi la final. În test nu am trimis nimic la ChatGPT; re-identificarea am verificat-o pe un răspuns scris de noi cu etichetele din cerere, iar numele, data, numărul auto și telefonul au revenit corect.
Completarea cu reguli: CNP, IBAN, CI, numere auto
Modelul nu știe ce e un CNP, o serie de buletin sau un număr auto românesc. A prins CNP-urile din context, dar nimic nu garantează că le va prinde și în documentul următor. Pentru identificatorii cu formă fixă, o regulă e mai sigură:
- CNP: 13 cifre, ultima fiind cifra de control calculată din primele 12. Validarea cifrei de control elimină cele mai multe potriviri false (numere de dosar, coduri de produs), dar nu pe toate: un număr oarecare de 13 cifre are cam o șansă din zece să treacă. Verificarea lunii, a zilei și a codului de județ le mai reduce.
- IBAN: „RO”, două cifre de control, codul băncii din patru litere și 16 caractere, verificate cu algoritmul modulo 97 din standardul IBAN.
- Serie și număr CI: două litere și șase cifre după cuvântul „seria”. Aici modelul a lăsat seria la vedere de fiecare dată.
- Numere de înmatriculare: indicativul județului, două cifre și trei litere; în București, B urmat de două sau trei cifre și trei litere.
Scriptul complet are reguli și pentru telefon, CUI, număr de registru și e-mail. La suprapunere câștigă eticheta regulii: CNP-ul prins ca account_number devine [CNP_1], iar numărul auto devine [NR_AUTO_1] în loc de [PERSOANA_2].
Efectul pe aceleași 49 de elemente:
| Configurație | Mascat complet | Parțial | Ratat |
|---|---|---|---|
| Doar modelul | 36 | 6 | 7 |
| Model + reguli pentru identificatori | 39 | 4 | 6 |
| Model + reguli + euristică de adrese | 45 | 1 | 3 |
Euristica de adrese caută un declanșator („domiciliat în”, „cu sediul în”, „Adresa:”) și ia segmentele separate prin virgulă cât timp arată a adresă (str., nr., bl., sc., ap., sector, jud.). Am scris-o după ce am văzut ratările, pe aceleași texte, deci rezultatul ei e optimist și trebuie testat pe documentele tale.
Ce rămâne după toate straturile: numele clientei din e-mail (o dată nemascat deloc, o dată pe jumătate), numele pârâtului și data scrisă cu luna în litere. Pentru nume există o soluție simplă, nemăsurată pentru că ar reuși prin construcție: lista numelor deja cunoscute. La un dosar știi părțile, la o reclamație știi expeditorul din CRM. Le înlocuiești peste tot, inclusiv fără diacritice și la genitiv („lui Bălan”).
Ce rămâne de verificat de om
Citește textul pseudonimizat ca un străin: ai putea afla despre cine e vorba? Verifică:
- Nume în orice formă: prenume singur („Salut, Andrei”), diminutive, inițiale, nume la genitiv, nume de familie folosit singur.
- Adrese complete: stradă, număr, bloc, scară, etaj, apartament, sat și comună, cod poștal.
- Date în toate formatele, inclusiv cu luna în litere.
- Numere interne: comandă, dosar, marcă, contract, parafă. Unele identifică o persoană în sistemele tale.
- Identificarea indirectă: „singurul administrator al firmei X din comuna Y”. Considerentul 26 vorbește despre toate mijloacele rezonabile de identificare, nu doar despre nume.
- Denumiri de firmă care conțin nume de persoane (PFA, întreprinderi individuale).
Unde nu ajunge unealta
Date privind sănătatea. În fișa de consultație, modelul a mascat numele, CNP-ul, telefonul și numele medicului, dar diagnosticul și tratamentul au rămas întregi: nu sunt în cele 8 categorii. Art. 9 din GDPR interzice în principiu prelucrarea datelor privind sănătatea, cu excepțiile enumerate acolo. O fișă pseudonimizată rămâne, pentru clinică, date despre sănătatea unui pacient identificabil. Întrebarea nu e „am mascat numele?”, ci dacă există temei pentru prelucrare și garanții contractuale la serviciul folosit.
Secretul profesional al avocatului. Art. 11 din Legea nr. 51/1995 (forma republicată în 2018) spune că avocatul „este dator să păstreze secretul profesional privitor la orice aspect al cauzei care i-a fost încredințată, cu excepția cazurilor prevăzute expres de lege”. Textul vorbește despre orice aspect al cauzei, nu doar despre datele de identificare: un dosar pseudonimizat poate rămâne recognoscibil prin fapte și sume, iar decizia aparține avocatului. Cum își alege un cabinet uneltele și regulile de confidențialitate e tratat în cursul AI pentru Avocați și Juriști, în lecția despre GDPR, secret profesional și Private AI.
Documente lungi și scanări. Fereastra de 128.000 de tokeni procesează un document lung dintr-o trecere, dar fiecare token „vede” doar 257 de tokeni în jur; consecvența etichetelor între documentele unui dosar e treaba tabelului tău. Iar o ștampilă sau un buletin scanat nu sunt văzute deloc: modelul primește doar text.
Alte probleme, alte articole. Mascarea unei baze de date întregi pentru dezvoltare e tratată în articolul despre date de test sintetice și GDPR, iar setările din contul tău de ChatGPT sau Claude, în ghidul de confidențialitate a datelor personale în AI.
Când nici textul pseudonimizat nu are voie să plece, varianta e să rulezi și modelul de limbaj local. Opțiunile, costurile și limitele sunt în articolul despre LLM local cu Ollama și self-hosting.
Regula pentru echipă. Un filtru pe calculatorul unui singur om nu ajută dacă ceilalți lipesc documente direct în ChatGPT. Ce date au voie în ce unealtă se stabilește într-o politică scrisă, subiectul cursului Politică de utilizare AI și securitatea datelor în companie.
Întrebări frecvente
Ce înseamnă anonimizarea datelor cu caracter personal în GDPR? Înseamnă că persoana nu mai poate fi identificată, direct sau indirect, ținând cont de toate mijloacele pe care e probabil, în mod rezonabil, să le folosească cineva (considerentul 26 din Regulamentul (UE) 2016/679). Datele cu adevărat anonime ies din GDPR. Înlocuirea numelor cu etichete, cu un tabel care permite revenirea, e pseudonimizare (art. 4 pct. 5), iar datele rămân personale.
Cum fac anonimizarea unui document sau a unui PDF înainte să-l pun în ChatGPT? Extragi textul (cu OCR dacă e scanat), rulezi local un model ca OpenAI Privacy Filter plus reguli pentru CNP, IBAN și CI, înlocuiești valorile cu etichete consecvente, citești rezultatul și abia apoi trimiți textul, nu PDF-ul original. Răspunsul îl re-identifici local.
Este pseudonimizarea suficientă pentru GDPR când folosesc ChatGPT? Nu, singură. Te ajută la minimizarea datelor și la securitate, dar pentru tine textul rămâne date personale. Ai nevoie în continuare de temei legal, de un plan de cont potrivit și, unde e cazul, de contractul de prelucrare cu furnizorul.
Pot face anonimizarea unui dosar de instanță cu OpenAI Privacy Filter? Tehnic, faci pseudonimizare, nu anonimizare. Poți folosi modelul ca prim strat, dar în testul nostru, pe o cerere de chemare în judecată, numele pârâtului și domiciliul lui au rămas în clar. Adaugă lista numelor părților, reguli pentru identificatori și o citire integrală. Decizia privind secretul profesional rămâne a avocatului.
OpenAI Privacy Filter trimite textele la OpenAI?
Modelul rulează local, pe calculatorul sau serverul tău. La prima rulare se descarcă greutățile și vocabularul tokenizerului. În codul pachetului opf nu am găsit alte apeluri de rețea, iar în testul nostru rularea a funcționat apoi cu modul offline al bibliotecii Hugging Face activat.
Concluzie
Anonimizarea datelor personale înainte de ChatGPT e, în practică, pseudonimizare: textul pleacă fără nume, dar tu păstrezi cheia, iar datele rămân personale pentru tine. OpenAI Privacy Filter e un prim strat bun pentru identificatorii cu formă fixă și rulează pe un laptop obișnuit. Pe documente românești a ratat însă exact ce contează mai mult: adrese întregi și numele persoanei despre care era documentul. Combinația care a funcționat are patru straturi: modelul, reguli cu cifră de control pentru CNP, IBAN și CI, lista numelor pe care le cunoști deja și un om care citește textul înainte să plece. Rezultatele sunt orientative; pe documentele tale, rulează testul tu.
Surse și resurse oficiale
- OpenAI Privacy Filter: fișa modelului pe Hugging Face (licență, arhitectură, categorii, limitări) și repository-ul de cod openai/privacy-filter (pachetul
opf, decodarea Viterbi). - Regulamentul (UE) 2016/679 (GDPR), textul în limba română pe EUR-Lex: art. 4 pct. 5, art. 9, art. 25, art. 32 și considerentul 26.
- EDPB, Guidelines 01/2025 on Pseudonymisation, versiunea adoptată pe 16 ianuarie 2025 pentru consultare publică.
- Curtea de Justiție a UE, comunicatul de presă nr. 107/25 despre hotărârea din cauza C-413/23 P, EDPS contra SRB.
- Legea nr. 51/1995 pentru organizarea și exercitarea profesiei de avocat, republicată, pe legislatie.just.ro.
Verificat la 22 octombrie 2026, pe fișa modelului și pe repository-ul oficial, pe textul GDPR publicat în Jurnalul Oficial, pe documentele EDPB și CJUE citate și pe legislatie.just.ro. Testul a fost rulat în aceeași zi, pe date fictive. Modelul și ghidurile se pot actualiza: reverifică înainte de a te baza pe ele.

Cursul care continuă acest articol
LLM-uri Locale cu Ollama: Privacy, Self-Hosting și Inferență Offline
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- De Ce LLM Local: Privacy, Data Residency și Cadrul Legal ca Motoare de Adopție
- Instalare și Fundamente Ollama: Primul Model și API-ul REST OpenAI-Compatible
- Peisajul Modelelor Open-Weight 2026: Criterii Reale de Alegere
- Cuantizare și Hardware: GGUF, q4_K_M vs q8_0 și Dimensionare Realistă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.