Întrebi într-o echipă de unde vin datele din mediul de test și primești, în jumătate din cazuri, același răspuns: „avem o copie a producției, mai veche". Copia aceea conține nume reale, adrese de e-mail reale, CNP-uri reale și istoricul comenzilor unor clienți care nu au aflat niciodată că datele lor stau pe laptopul unui developer. Nu e o scurtătură tehnică, e o prelucrare de date cu caracter personal fără scop declarat — iar de la ea începe cel mai ieftin incident de conformitate pe care îl poate avea o firmă de software.
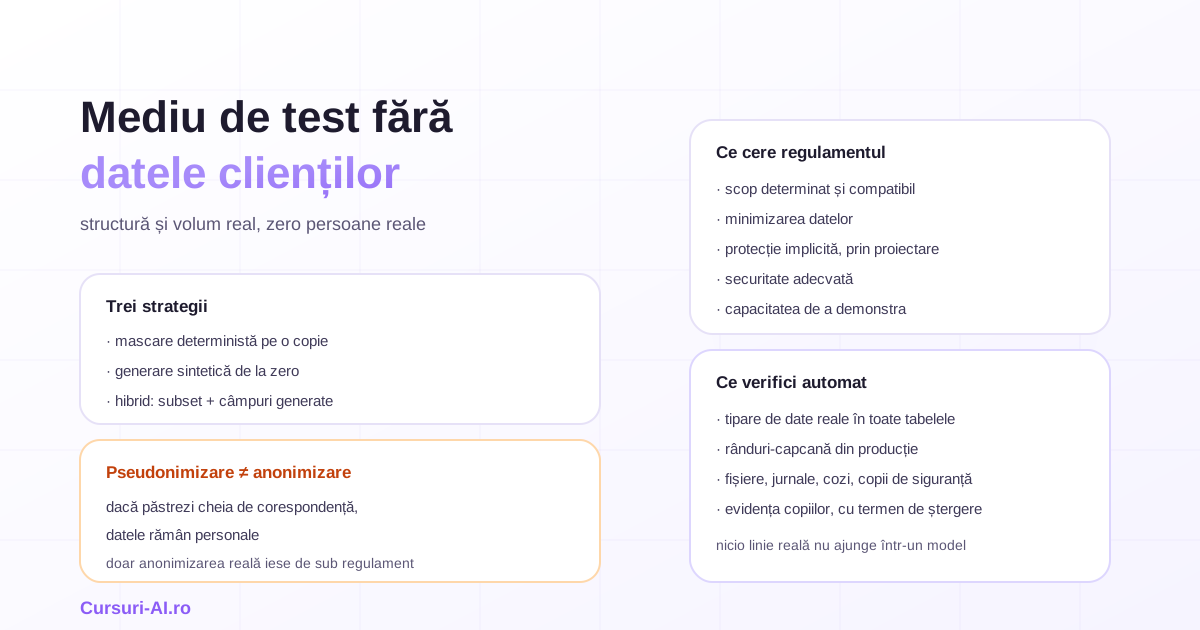
Articolul e despre cum construiești medii de dezvoltare și de test cu date utile, dar fără date personale reale: ce spune regulamentul, ce diferență face anonimizarea față de pseudonimizare, ce strategii funcționează și unde ajută un model în tot acest proces.
De ce copia producției e o problemă
Regulamentul general privind protecția datelor nu interzice explicit „date de producție în test". Interzice ceva mai general, care acoperă exact situația.
Scopul. Articolul 5 alineatul (1) litera (b) cere ca datele să fie „colectate în scopuri determinate, explicite și legitime" și să nu fie prelucrate ulterior „într-un mod incompatibil cu aceste scopuri". Clientul ți-a dat datele ca să-i procesezi comanda, nu ca să testezi o funcționalitate nouă.
Minimizarea. Litera (c) a aceluiași articol cere date „adecvate, relevante și limitate la ceea ce este necesar" pentru scopul prelucrării. Un mediu de test are nevoie de structură și volum, nu de identitatea reală a 40.000 de oameni.
Proiectarea implicită. Articolul 25 cere măsuri tehnice „cum ar fi pseudonimizarea", menite să pună în aplicare principii precum minimizarea, și impune ca, în mod implicit, să fie prelucrate „numai datele cu caracter personal care sunt necesare pentru fiecare scop specific". „Implicit" înseamnă că varianta sigură trebuie să fie cea mai ușoară, nu cea care cere efort suplimentar.
Securitatea. Litera (f) cere o prelucrare care asigură „securitatea adecvată", inclusiv protecția împotriva prelucrării neautorizate. Un mediu de test are, de regulă, controale mai slabe decât producția: mai mulți oameni cu acces, jurnale mai puțin protejate, copii locale.
Răspunderea. Alineatul (2) al articolului 5 spune că operatorul „este responsabil de respectarea alineatului (1) și poate demonstra această respectare". La un control sau la un chestionar de securitate venit de la un client mare, „avem o copie a producției în test" e exact opusul unei demonstrații.
Cadrul complet de guvernanță pentru sistemele care prelucrează date, inclusiv partea de evaluare a riscurilor și de conformitate, e tratat în cursul AI Security și Ethical Engineering.
Anonimizare și pseudonimizare: nu sunt același lucru
Distincția asta decide ce obligații îți rămân după ce „ai curățat" datele.
Considerentul 26 al regulamentului spune că principiile protecției datelor nu se aplică informațiilor anonime, adică datelor „care nu sunt legate de o persoană fizică identificată sau identificabilă" ori datelor „devenite anonime astfel încât persoana vizată nu mai este identificabilă". Tot acolo se precizează testul: pentru a decide dacă o persoană e identificabilă, se iau în calcul „toți factorii obiectivi, precum costurile și timpul necesar identificării", ținând cont de tehnologia disponibilă și de evoluția ei.
Consecința practică, pe care multe echipe o descoperă târziu: dacă păstrezi o cheie de corespondență, datele rămân personale. Înlocuirea numelui cu „Utilizator 4172" e pseudonimizare — o măsură de securitate valoroasă, recunoscută explicit de articolul 25, dar care nu scoate datele de sub regulament. Anonimizarea reală înseamnă că nimeni, nici măcar tu, nu poate reface legătura cu persoana.
De aceea generarea sintetică e, de obicei, soluția mai curată: nu transformi date reale, ci produci date care nu au avut niciodată un corespondent real.
Trei strategii, cu compromisurile lor
1. Mascare deterministă pe o copie. Restaurezi o copie a producției și treci fiecare câmp sensibil printr-o funcție care produce mereu aceeași valoare falsă pentru aceeași intrare. Avantaj: păstrezi distribuția reală și relațiile între tabele. Dezavantaj: rămâi în zona pseudonimizării, deci mediul de test trebuie protejat în continuare ca unul cu date personale, iar copia trebuie ștearsă după utilizare.
2. Generare sintetică de la zero. Construiești setul pornind de la schemă și de la reguli de business. Avantaj: nu există date personale, deci obligațiile dispar odată cu ele. Dezavantaj: e mult mai ușor să ratezi cazurile ciudate care apar doar în date reale — conturi fără adresă, comenzi cu valoare negativă, nume cu apostrof, adrese din 1998.
3. Hibrid, în practică cel mai bun raport. Pornești de la un subset al producției, ales să acopere cazurile de structură, apoi înlocuiești complet câmpurile identificatoare cu date generate. Volumul îl obții prin multiplicare sintetică, nu prin copierea întregii baze.
Regula de dimensionare: pentru teste funcționale ai nevoie de câteva mii de rânduri bine alese; pentru teste de performanță ai nevoie de volum, dar volumul nu trebuie să fie real — un generator produce patruzeci de milioane de rânduri cu aceeași distribuție statistică și fără nicio persoană în ele. Diagnosticul de performanță care are nevoie de acest volum e descris în ghidul despre optimizarea SQL cu AI.
Ce strică majoritatea implementărilor
Șase greșeli care transformă un set de test într-o sursă de erori false:
Integritatea referențială ruptă. Dacă maschezi identificatorul clientului într-o tabelă și nu în celelalte, comenzile rămân orfane. De aceea mascarea trebuie să fie deterministă: aceeași intrare, aceeași ieșire, în toate tabelele și în toate sistemele.
Formate românești invalide. Un CNP generat aleatoriu pică la validare, iar echipa ajunge să dezactiveze validarea în test — adică exact verificarea pe care ar trebui să o testeze. Generatorul trebuie să producă valori valide ca format și invalide ca realitate: cifră de control corectă, dar neatribuită vreunei persoane. Același principiu pentru IBAN, cod fiscal, serie și număr de document.
Distribuția plată. Dacă fiecare client are exact trei comenzi, niciun test nu va descoperi ce se întâmplă la clientul cu douăzeci de mii. Realitatea are cozi lungi; generatorul trebuie să le reproducă.
Cazurile limită șterse. Datele reale conțin diacritice, apostrofuri, nume de o literă, adrese cu numere de bloc ciudate, sume zero. Un generator „curat" produce un set pe care aplicația trece perfect și producția nu.
Timpul înghețat. Un set generat o dată rămâne cu datele din trecut, iar testele care depind de „luna curentă" încep să pice aleatoriu. Datele trebuie generate relativ la momentul rulării.
Legătura între sisteme. Dacă maschezi baza de date, dar nu și fișierele încărcate, jurnalele sau coada de mesaje, datele personale rămân în mediu pe alte căi.
Unde ajută un model, concret
Partea repetitivă a acestui proiect e exact ce face bine un model:
- Inventarul câmpurilor sensibile, pornind de la schema bazei și de la denumirile coloanelor: propune ce e identificator direct, ce e indirect și ce e nesensibil. Tu confirmi; el face propunerea în câteva minute în loc de o zi.
- Regulile de mascare per câmp, inclusiv funcțiile care păstrează formatul (cifră de control, lungime, prefixe).
- Generatoarele, ca scripturi, cu distribuții și cazuri limită descrise în limbaj natural. Partea de scriere efectivă a acestor unelte, cu SDK-urile oficiale, e acoperită în cursul Construire de aplicații AI cu Python și SDK-uri.
- Setul de cazuri neplăcute: nume cu caractere speciale, adrese incomplete, valori la limită, combinații rare.
- Verificările finale: scripturi care caută în mediul de test tipare de date reale.
Și o regulă absolută, care anulează tot efortul dacă o încalci: nu îi dai modelului rânduri reale ca „exemplu". Îi dai schema, tipurile, regulile de validare și o descriere a distribuției. Dacă are nevoie de un exemplu, îl construiești manual.
Cum verifici că nu a rămas nimic real
Trei mecanisme, rulate automat, nu o dată la implementare:
1. Căutare de tipare. Un script care caută în toate tabelele și în fișierele de jurnal tipare care arată a date reale: adrese de e-mail cu domenii ale clienților cunoscuți, numere de telefon românești valide, coduri fiscale existente, IBAN-uri ale băncilor reale. Rulează la fiecare reîmprospătare a mediului.
2. Rânduri-capcană. Introduci în producție câteva înregistrări unice, inofensive, cu valori imposibil de generat aleatoriu. Dacă vreuna apare vreodată într-un mediu de test, într-un jurnal sau într-un raport, știi imediat că fluxul de copiere a ocolit mascarea.
3. Evidența copiilor. Cine a restaurat, când, unde, până când. O copie „temporară" pe un server de test uitat timp de doi ani e cel mai comun mod în care firmele descoperă că aveau o problemă.
La final, partea administrativă: mediile de test intră în evidența prelucrărilor, iar politica internă spune explicit că accesul la date de producție e o excepție care se aprobă, nu o practică. Aceleași răspunsuri îți sunt cerute, aproape cuvânt cu cuvânt, în evaluările de securitate ale clienților mari — subiect tratat separat în ghidul despre chestionarul de securitate al clientului enterprise.
Cum arată fluxul, pas cu pas
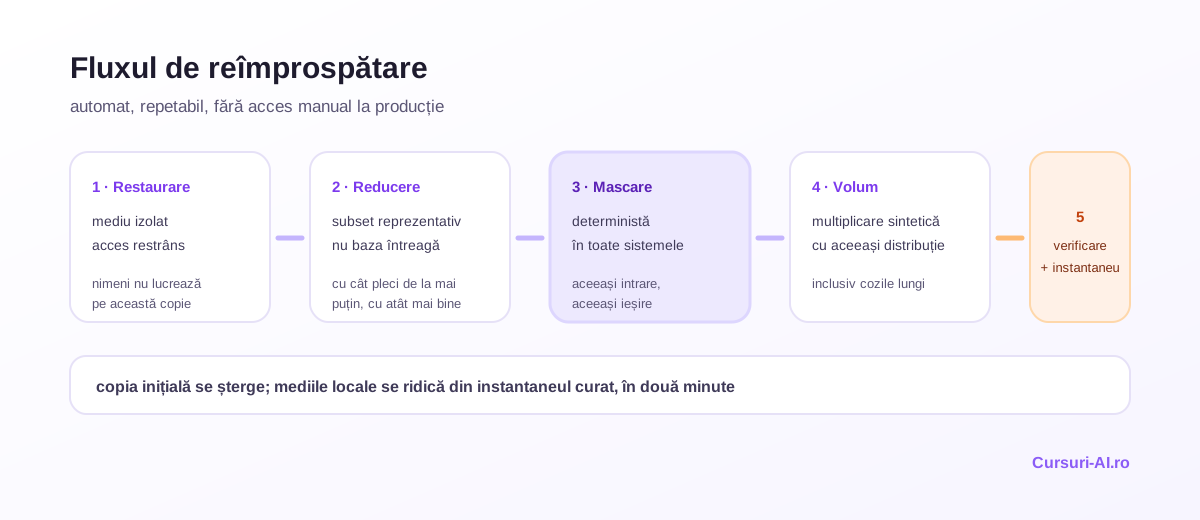
Un proces care se poate rula oricând, de oricine din echipă, arată așa:
- Restaurare într-un mediu izolat, cu acces restrâns, fără conexiuni către alte sisteme. Nimeni nu lucrează direct pe această copie.
- Reducere: păstrezi un subset reprezentativ — de exemplu ultimele trei luni plus clienții aleși pentru cazurile speciale — în loc de baza întreagă. Cu cât pleci de la mai puțin, cu atât riscul e mai mic.
- Mascare deterministă a tuturor câmpurilor din inventar, aplicată în aceeași rulare și în bazele conectate.
- Multiplicare sintetică până la volumul necesar testelor de performanță.
- Verificare automată: tiparele și rândurile-capcană, rulate ca un test care trebuie să treacă.
- Publicare ca instantaneu versionat, din care dezvoltatorii își creează mediile locale. Din acest moment, copia inițială se șterge.
- Jurnalizare: cine a rulat procesul, când, ce versiune de reguli s-a folosit.
Pasul 6 e cel care schimbă cultura echipei: dacă un mediu local se ridică în două minute dintr-un instantaneu curat, nimeni nu mai are motiv să ceară acces la producție. Ideea e aceeași ca la repetiția unei migrări pe o copie restaurată, descrisă în ghidul despre migrări de schemă cu agenți — doar că aici copia nu se întoarce niciodată cu date reale.
Cât durează. Pentru o aplicație de dimensiune medie, inventarul și regulile de mascare iau una-două zile, generatoarele încă două, iar verificările o zi. Cu un model care propune inventarul și scrie scripturile, jumătate din acest timp dispare. Este, în mod evident, mai puțin decât costul unui singur incident în care datele clienților ajung unde nu trebuie.
Listă de control
- Inventar al câmpurilor sensibile, actualizat la fiecare migrare de schemă.
- Decizie explicită per mediu: sintetic complet, mascat determinist sau hibrid.
- Mascare deterministă, aplicată identic în toate sistemele conectate.
- Generatoare care produc valori valide ca format, dar fără corespondent real.
- Distribuții realiste, inclusiv cozile lungi și cazurile limită.
- Date relative la momentul rulării, nu înghețate în trecut.
- Acoperire completă: bază de date, fișiere, jurnale, cozi, copii de siguranță.
- Verificare automată, cu tipare și rânduri-capcană, la fiecare reîmprospătare.
- Evidența copiilor, cu termen de ștergere.
- Nicio linie de date reale trimisă vreodată către un model sau într-un instrument extern.
Întrebări frecvente
Î: E ilegal să folosesc o copie a bazei de producție în mediul de test? R: Nu există o interdicție formulată în acești termeni, dar prelucrarea trebuie să respecte principiile din articolul 5: scop determinat, minimizare, securitate adecvată și capacitatea de a demonstra conformitatea. O copie integrală, cu date reale, într-un mediu cu controale mai slabe, e greu de justificat prin oricare dintre ele — mai ales când există alternative tehnice accesibile.
Î: Dacă înlocuiesc numele cu pseudonime, mai sunt date personale? R: Da. Pseudonimizarea e o măsură de securitate recunoscută de articolul 25, dar datele rămân sub incidența regulamentului cât timp legătura cu persoana poate fi refăcută cu informații suplimentare. Doar anonimizarea reală — în sensul considerentului 26, unde persoana „nu mai este identificabilă" ținând cont de toate mijloacele susceptibile a fi utilizate în mod rezonabil — scoate datele din domeniul de aplicare.
Î: Cum obțin volum realist fără date reale? R: Prin generare: pornești de la distribuțiile observate în producție — câte comenzi are un client în medie, care e coada lungă, cum arată sezonalitatea — și produci oricâte rânduri ai nevoie. Distribuția e o statistică, nu o dată personală; ea poate fi extrasă și documentată fără să copiezi vreo înregistrare.
Î: Pot să-i cer unui model să-mi genereze date de test pornind de la câteva exemple reale? R: Nu. Transmiterea unor rânduri reale către un serviciu extern e o prelucrare în sine și, în plus, riscă să reapară în rezultate. Metoda corectă e să îi dai schema, tipurile, regulile de validare și descrierea distribuției. Rezultatul e la fel de bun, iar riscul dispare.
Î: Cât de des trebuie reîmprospătat setul de test? R: Ori de câte ori se schimbă schema și, în rest, suficient de des încât datele relative la timp să rămână valide. Important e ca reîmprospătarea să fie automată: dacă procesul cere o zi de muncă manuală, echipa va ajunge inevitabil, într-o zi aglomerată, la scurtătura cu copia producției.
Concluzie
Un mediu de test bun nu are nevoie de datele clienților tăi. Are nevoie de structura lor, de distribuția lor și de cazurile lor ciudate — toate obținute fără să iasă o singură persoană reală din producție.
Efortul inițial e de câteva zile: inventarul câmpurilor, regulile de mascare, generatoarele, verificările automate. Un model scurtează partea repetitivă la câteva ore. Ce rămâne după aceea e un mediu în care echipa poate lucra liber, un răspuns onest la orice chestionar de securitate și o întreagă categorie de incidente eliminată din start.
Surse: Regulamentul (UE) 2016/679 — articolul 5 · articolul 25 — protecția datelor începând cu momentul conceperii · considerentul 26 — informații anonime · textul integral al regulamentului, EUR-Lex
Articol informativ, publicat la 19 septembrie 2026. Are caracter educativ și nu constituie consultanță juridică. Pentru încadrarea unei prelucrări concrete, consultă responsabilul cu protecția datelor sau un avocat specializat.

Cursul care continuă acest articol
AI Security și Ethical Engineering 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Security & Ethics AI
- Atacuri asupra Sistemelor AI
- Apărare și Guardrails
- Privacy și Protecția Datelor
+ încă 6 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.