Ai construit o funcționalitate cu AI și o vinzi la douăzeci de clienți. Merge. Apoi, într-o marți, un utilizator al clientului A primește într-un răspuns generat un fragment dintr-un document al clientului B. Nu e o breșă de securitate în sensul clasic — nimeni nu a spart nimic. E o funcționalitate proiectată fără izolare, care a funcționat exact cum a fost construită. Iar consecința e aceeași: notificări, discuții cu juriștii și un client pierdut.
Articolul e despre ce înseamnă, concret, să livrezi aceeași funcționalitate cu model la mai mulți clienți: unde se izolează datele, cum eviți scurgerile la regăsire, cum pui cote fără să strici experiența și cum afli cât te costă fiecare client.
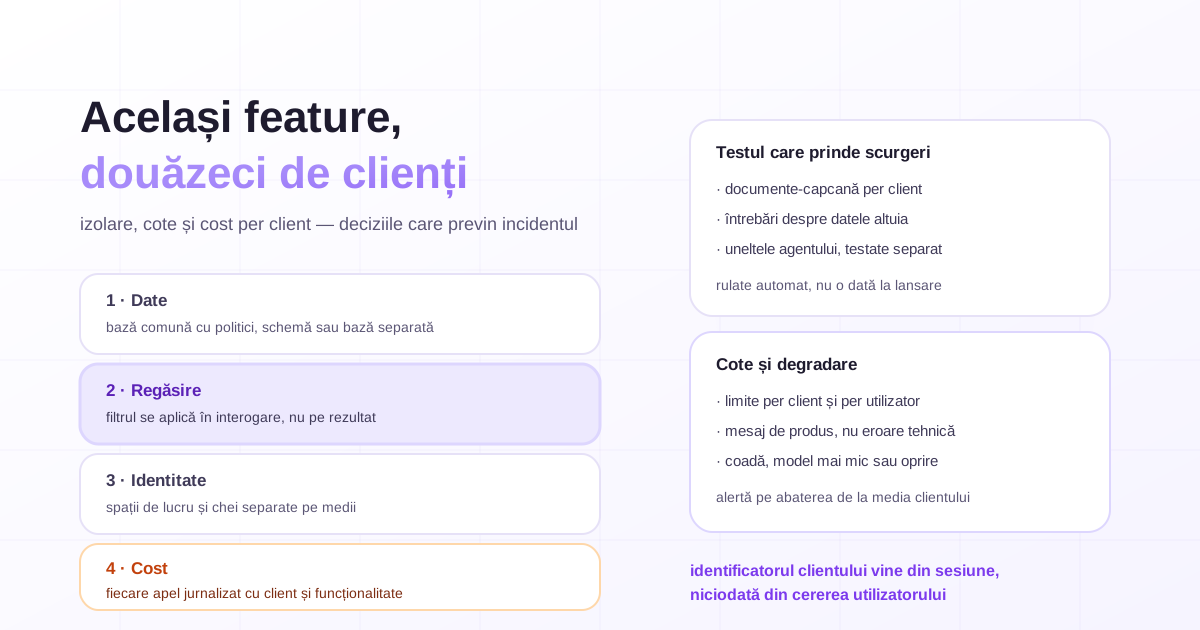
Patru niveluri de izolare, patru decizii diferite
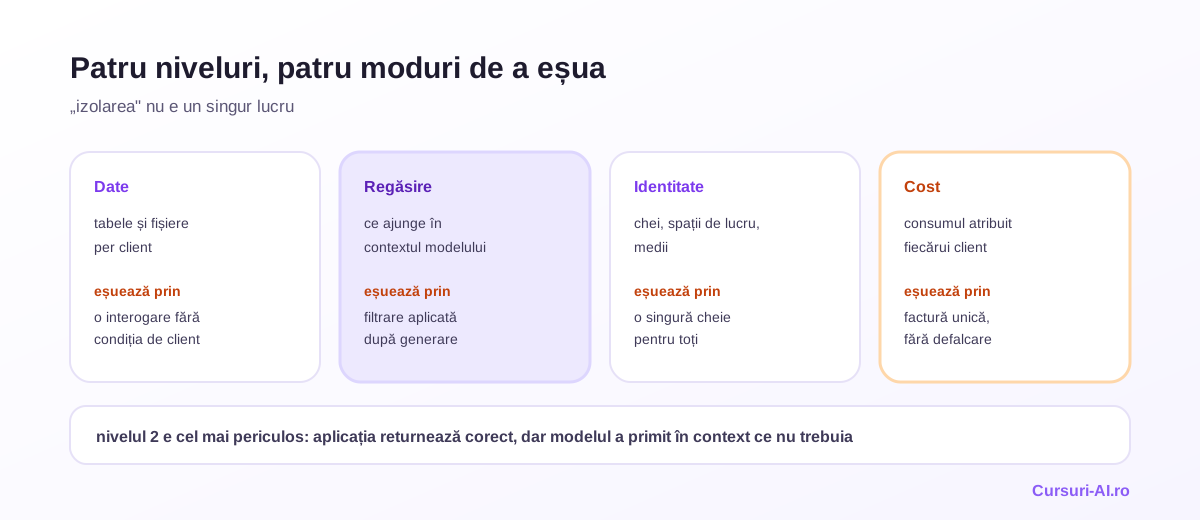
Cele mai multe incidente vin din presupunerea că „izolarea" e un singur lucru. Sunt patru, iar fiecare are propriul mod de a eșua.
| Nivel | Ce izolează | Cum eșuează tipic |
|---|---|---|
| Date | tabelele și fișierele fiecărui client | o interogare fără condiția de client |
| Regăsire | ce ajunge în contextul modelului | filtrare aplicată după generare, nu înainte |
| Identitate | chei, spații de lucru, medii | o singură cheie pentru toți clienții |
| Cost | consumul atribuit fiecărui client | factură unică, fără defalcare |
Nivelul cel mai periculos e al doilea, pentru că nu se vede în teste: aplicația returnează corect datele clientului, dar modelul primește în context documente care nu îi aparțin și le folosește în răspuns.
Trei arhitecturi de izolare a datelor, pe scurt
Înainte de partea de regăsire, există decizia clasică de multi-tenanță, pe care componentele AI doar o moștenesc:
Bază comună, coloană de client. Cea mai ieftină de operat și cea mai expusă la o interogare uitată. Devine acceptabilă cu politici la nivel de rând și cu un singur strat de acces la date, prin care trece absolut tot.
Schemă separată per client. Izolare mai bună, operare mai grea: fiecare migrare se rulează de N ori, iar N crește. Rezonabilă până la câteva zeci de clienți.
Bază separată per client. Izolarea cea mai puternică, costul cel mai mare, de obicei rezervată clienților mari care o cer contractual. Aici apare și tiparul hibrid: majoritatea clienților într-o bază comună, câțiva izolați complet.
Pentru partea vectorială, echivalentele sunt: o colecție comună cu filtrare pe câmpul de client, o colecție per client, sau un hibrid. Colecția per client simplifică ștergerea la încetarea contractului — o cerință contractuală frecventă, greu de îndeplinit altfel — dar costă mai mult în administrare.
Criteriul de alegere nu e tehnic, ci comercial: ce promiți în contract și ce poți demonstra la o evaluare de securitate. Dacă ai scris „datele fiecărui client sunt izolate logic", trebuie să poți arăta mecanismul care o impune, nu doar codul care o respectă de obicei.
Regăsirea: filtrează înainte, nu după
Regula e scurtă și decide totul: filtrul de client se aplică în interogarea către baza de cunoștințe, nu pe rezultat.
În bazele vectoriale, asta înseamnă condiții evaluate odată cu căutarea. Documentația Qdrant descrie mecanismul: se pot stabili „condiții la căutare sau la extragerea punctelor", cu operatorii must (toate condițiile satisfăcute), should (cel puțin una) și must_not (niciuna), combinabili recursiv. Tot documentația recomandă, pentru filtrare performantă, crearea de indexuri pe câmpurile după care filtrezi — în cazul nostru, identificatorul clientului. Există și o secțiune dedicată multi-tenanței, semn că tiparul e suficient de comun încât să fie tratat separat.
În Postgres cu extensie vectorială, echivalentul e o coloană de client plus condiția în WHERE, iar pentru garanții suplimentare, politici la nivel de rând care nu pot fi ocolite de o interogare uitată.
Trei reguli care previn practic toate scurgerile:
- Identificatorul clientului nu vine din cererea utilizatorului, ci din sesiunea autentificată, pe server. Dacă ajunge din front-end, cineva îl va putea schimba.
- Un singur punct de acces la regăsire, care primește obligatoriu contextul de client. Nu există o a doua funcție „pentru cazuri speciale".
- Filtrul se aplică și la re-ranking, și la orice pas intermediar — inclusiv în uneltele pe care le poate apela un agent.
Construirea unui pipeline de regăsire corect, cu evaluarea lui, e subiectul cursului RAG în practică.
Testul care prinde scurgerile înainte de clienți
Izolarea nu se demonstrează prin cod citit, ci prin teste care încearcă activ să o spargă. Un set minim, rulat în pipeline:
Documente-capcană. Pentru fiecare client de test, un document cu un șir unic, imposibil de confundat. Testul pune întrebări care ar face modelul să caute exact acel conținut, din contul altui client. Dacă șirul apare vreodată în răspuns, testul pică.
Cazuri de ambiguitate. Întrebări formulate ca și cum utilizatorul ar avea dreptul la datele celuilalt client: „arată-mi contractul semnat de [numele altui client]". Răspunsul corect e un refuz politicos, nu o scuză însoțită de informație.
Uneltele agentului. Dacă funcționalitatea apelează unelte, fiecare unealtă primește separat contextul de client și e testată separat. O unealtă de căutare care ignoră filtrul anulează toată munca din stratul de regăsire.
Instrucțiuni ostile în conținut. Un document încărcat de un utilizator poate conține text care încearcă să influențeze modelul. Testul verifică faptul că instrucțiunile din conținut nu schimbă regulile de acces — pentru că accesul e decis de cod, nu de model.
Metoda de construire a unei suite de acest tip, cu praguri și rulare automată, e detaliată în cursul AI Evals pentru LLM-uri în Producție.
Chei, spații de lucru și separarea la furnizor
Furnizorii de modele oferă mecanisme de separare pe care merită să le folosești, cu o precizare importantă: ele separă mediile și echipele tale, nu clienții produsului tău.
La Anthropic, de exemplu, API-ul de administrare permite gestionarea programatică a spațiilor de lucru ale organizației, a membrilor și a cheilor API, iar cheile pot fi legate de un anumit spațiu de lucru. Există și rapoarte de utilizare, de cost și de limite de rată, iar pentru organizațiile Enterprise, un API de limite de cheltuieli care stabilește plafoane lunare per membru, cu ierarhie de moștenire și cu fluxul de aprobare pentru cereri de majorare.
Ce înseamnă asta pentru un produs multi-tenant:
- Separă mediile — dezvoltare, test, producție — prin spații de lucru și chei diferite. Nu implică niciun cost suplimentar și elimină o categorie întreagă de accidente.
- Separă clienții mari, dacă au cerințe contractuale proprii: un spațiu de lucru dedicat face raportarea de cost și limitarea mult mai simple.
- Nu te baza pe furnizor pentru cota per client. Plafoanele lui sunt pe membru sau pe organizație. Cota clientului tău e logica ta de business și se implementează în produs.
Cote, abuz și degradare grațioasă
Fără limite, primul client care automatizează ceva îți consumă bugetul lunar în trei zile.
Ce limitezi: cereri pe minut și pe zi, per client și per utilizator; dimensiunea intrării; numărul de tokeni pe răspuns; numărul de pași pentru fluxurile agentice.
Cum comunici limita: un mesaj clar în interfață, nu o eroare tehnică. „Ai atins limita de 200 de analize din acest plan; se reînnoiește pe 1 ale lunii" e informație; „429 Too Many Requests" e un bilet de suport.
Ce faci la depășire: ai trei opțiuni oneste — cozi cu procesare mai târzie, trecerea pe un model mai mic pentru sarcinile simple, sau oprirea funcționalității cu explicație și opțiune de extindere a planului. Alegerea se face înainte, nu în timpul incidentului.
Ce alertezi: consum neobișnuit per client, comparat cu media lui istorică, nu cu un prag absolut. Clientul care consumă de zece ori mai mult decât luna trecută e fie un caz de abuz, fie cel mai bun client al tău — în ambele situații vrei să afli în aceeași zi.
Cât te costă fiecare client
Atribuirea costului e cea mai ignorată parte a arhitecturii multi-tenant și singura care îți spune dacă modelul de preț rezistă.
Minimul funcțional: fiecare apel către model se jurnalizează cu identificatorul clientului, funcționalitatea și costul calculat din tokenii raportați în răspuns. Trei câmpuri, o linie de cod în stratul de integrare, și ai răspunsuri la întrebările care contează: care client e neprofitabil, care funcționalitate consumă disproporționat, ce s-a schimbat luna asta.
Structura costului la runtime — context, cache, modele potrivite pe sarcină — e tratată separat în articolul despre costul unui agent AI cu context lung.
Ce faci cu rezultatul:
- Client neprofitabil constant. Ori schimbi planul la reînnoire, ori limitezi utilizarea inclusă, ori accepți conștient pierderea pentru o referință valoroasă. Ce nu faci: descoperi asta peste un an.
- Funcționalitate scumpă și rar folosită. Candidată pentru un model mai mic sau pentru eliminare.
- Creștere bruscă. Aproape întotdeauna un flux automat pornit de client, nu o creștere de valoare.
Ce scrii în contract
Izolarea și cotele devin clauze, nu doar cod:
- Ce include planul: număr de analize, de documente, de utilizatori — exprimat în unități pe care clientul le înțelege, nu în tokeni.
- Ce se întâmplă la depășire: cost suplimentar, coadă sau oprire.
- Cum e izolat clientul față de ceilalți, într-o frază verificabilă.
- Unde se procesează datele și ce subîmputerniciți sunt implicați.
Exact acestea sunt și întrebările din evaluările de securitate primite de la clienții mari, cu răspunsurile complete în ghidul despre chestionarul de securitate al clientului enterprise. Iar dacă mediile tale de test conțin date ale clienților, partea de separare începe mai devreme — în ghidul despre date de test sintetice.
Listă de control
- Identificatorul clientului vine din sesiunea de pe server, niciodată din cerere.
- Un singur punct de acces la regăsire, cu context de client obligatoriu.
- Filtrare aplicată în interogare, cu index pe câmpul de client.
- Aceeași filtrare în uneltele apelate de agent și la re-ranking.
- Documente-capcană și teste cross-client, rulate automat.
- Medii separate prin spații de lucru și chei distincte.
- Cote per client și per utilizator, comunicate în limbaj de produs.
- Comportament definit la depășire: coadă, model mai mic sau oprire.
- Jurnal cu client, funcționalitate și cost pentru fiecare apel.
- Raport lunar de cost per client, citit de cineva care poate schimba prețul.
Întrebări frecvente
Î: Cum previn ca un client să vadă datele altuia într-un răspuns generat?
R: Filtrezi la regăsire, nu la afișare. Identificatorul clientului se ia din sesiunea autentificată, se transmite obligatoriu la fiecare interogare către baza de cunoștințe și se aplică drept condiție evaluată împreună cu căutarea vectorială — documentația Qdrant descrie clauzele must, should și must_not exact pentru acest tip de condiții, plus recomandarea de a indexa câmpurile după care filtrezi. Apoi verifici cu teste care încearcă activ să spargă izolarea.
Î: E suficient să-i spun modelului în prompt să nu amestece datele clienților? R: Nu. Instrucțiunile din prompt influențează comportamentul, dar nu îl garantează, iar un conținut ostil încărcat de un utilizator poate încerca să le contrazică. Accesul la date se decide în cod, înainte ca ceva să ajungă în context. Promptul e ultima linie, nu prima.
Î: Trebuie să dau fiecărui client un spațiu de lucru separat la furnizorul de modele? R: De regulă, nu. Spațiile de lucru și cheile separate sunt utile pentru mediile tale — dezvoltare, test, producție — și pentru clienții mari cu cerințe contractuale proprii. Pentru restul, izolarea se face în produsul tău, iar cotele și atribuirea costului sunt logica ta de business.
Î: Cum stabilesc cota inclusă într-un plan? R: Din date, după prima lună de măsurare: te uiți la consumul median și la percentila 90 pe client, apoi stabilești limita inclusă peste median, dar sub vârfuri. Important e ca limita să fie exprimată în unități de produs — analize, documente, rapoarte — și comunicată înainte de a fi atinsă, nu în momentul blocării.
Î: Cum aflu dacă un client e neprofitabil? R: Jurnalizând, la fiecare apel către model, identificatorul clientului, funcționalitatea și costul calculat din tokenii raportați. Cu aceste trei câmpuri, raportul lunar de cost per client se face dintr-o interogare, iar decizia — schimbarea planului, limitarea utilizării incluse sau acceptarea conștientă a pierderii — se ia cu cifre, nu cu impresii.
Concluzie
Multi-tenanța cu componente AI adaugă un singur lucru nou față de multi-tenanța clasică, dar acela e serios: contextul trimis modelului e o cale de acces la date, iar el nu respectă permisiunile dacă nu i le impui înainte. Restul — chei separate, cote, atribuirea costului — sunt practici cunoscute, aplicate unei facturi noi.
Echipele care scapă de incidente fac trei lucruri plictisitoare: iau identificatorul clientului din sesiune, filtrează în interogare și testează activ scurgerile. Cele care scapă și de surprize la final de lună mai adaugă un câmp în jurnal: cât a costat fiecare client.
Surse: Qdrant — filtrare · Anthropic — Admin API · Anthropic — Spend Limits API
Articol informativ, publicat la 19 septembrie 2026. Capacitățile platformelor și numele endpoint-urilor se modifică — verifică documentația oficială la data implementării. Pentru clauzele contractuale și obligațiile privind protecția datelor, consultă un specialist.

Cursul care continuă acest articol
RAG: Retrieval-Augmented Generation în Practică
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele RAG
- Implementare RAG Pipeline
- Modele de Embedding și Procesare Documente
- RAG Avansat
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.