Interogarea care ținea 40 de milisecunde acum un an ține acum 40 de secunde. Copiezi SQL-ul într-un chat, ceri optimizare și primești în trei secunde un răspuns care sună convingător: „adaugă un index pe coloana asta". Poate are dreptate. Dar modelul nu știe câte rânduri ai în tabel, cum sunt distribuite valorile, câte scrieri pe secundă primești și ce indexuri există deja. Optimizarea nu începe cu interogarea, ci cu planul de execuție — singurul document care spune ce face, de fapt, baza de date.
Articolul e despre cum folosești un model ca să accelerezi interogări reale, fără să-i trimiți datele companiei și fără să ajungi cu cinci indexuri inutile care încetinesc scrierile. Exemplele sunt pe PostgreSQL și MariaDB, cele două baze pe care le întâlnești cel mai des în proiectele din România.
Ce îi dai modelului — și ce nu
Un model nu are acces la baza ta. Tot ce poate face e să interpreteze ce îi dai. Deci calitatea răspunsului e determinată complet de calitatea intrării.
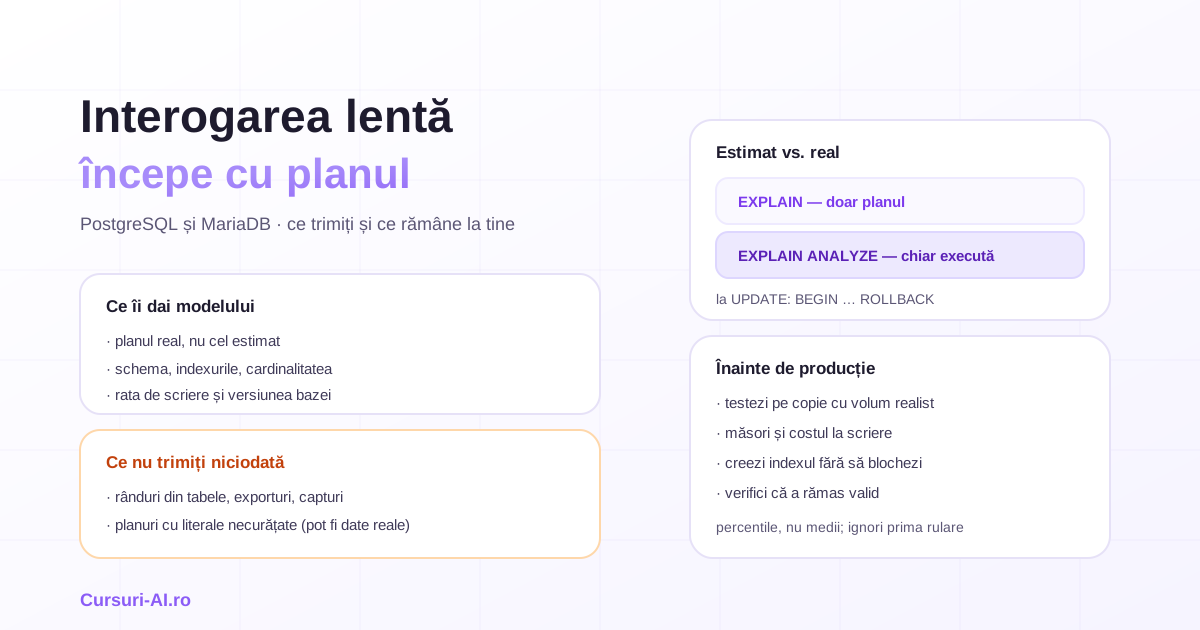
Ce merită trimis:
- interogarea, cu parametrii înlocuiți cu valori reprezentative;
- planul de execuție real, nu cel estimat (vezi mai jos diferența);
- definițiile tabelelor implicate și lista indexurilor existente;
- ordinele de mărime: câte rânduri are fiecare tabel, câte valori distincte are coloana pe care ai vrea indexul, câte scrieri pe secundă primește tabela;
- ce ai încercat deja și ce s-a întâmplat.
Ce nu trimiți niciodată: rânduri din tabele, exporturi, capturi din interfața de administrare. Atenție și la plan: în anumite forme, planul de execuție conține valorile literale din interogare, iar acelea pot fi un CNP, un e-mail sau un IBAN. Curăță-le înainte, exact cum ai face cu un fișier de jurnal.
Modul de lucru cu un agent direct pe depozit, cu permisiuni și verificări — inclusiv rularea comenzilor de diagnostic într-un mediu izolat — e tratat în cursul Claude Code Mastery.
Planul estimat și planul real: nu sunt același lucru
Aici se pierde majoritatea timpului, pentru că oamenii trimit ce e mai la îndemână.
În PostgreSQL, EXPLAIN arată planul pe care îl alege planificatorul, fără să execute interogarea. EXPLAIN ANALYZE chiar o execută și afișează numărul real de rânduri și timpul acumulat în fiecare nod, alături de estimări. Documentația oficială spune direct ce trebuie să cauți: „lucrul cel mai important de urmărit e dacă numărul estimat de rânduri e rezonabil de apropiat de realitate". Când estimarea spune 10 și realitatea e 400.000, ai găsit cauza — statistici vechi sau o condiție pe care planificatorul nu o poate evalua.
Opțiunea BUFFERS adaugă ce s-a citit din cache și ce de pe disc; documentația precizează că ANALYZE o activează implicit. Tot de acolo vine și avertismentul de care ai nevoie ca să nu faci pagube: pentru că EXPLAIN ANALYZE chiar rulează interogarea, orice efect secundar se produce normal. Pentru UPDATE, DELETE sau INSERT, documentația recomandă explicit tiparul cu tranzacție:
BEGIN;
EXPLAIN (ANALYZE, BUFFERS) UPDATE facturi SET stare = 'platita' WHERE id < 100;
ROLLBACK;
Un detaliu care lipsește din majoritatea discuțiilor: costurile din plan sunt exprimate în unități arbitrare, determinate de parametrii de cost ai planificatorului. Nu sunt milisecunde. Un model căruia îi ceri „redu costul de la 445 la sub 100" va inventa o țintă care nu înseamnă nimic.
În MariaDB, echivalentul se numește chiar ANALYZE: documentația spune că acesta „invocă optimizatorul, execută instrucțiunea și apoi produce rezultatul EXPLAIN în locul setului de rezultate", tocmai ca să poți compara estimările cu realitatea. Coloanele care contează sunt r_rows — câte rânduri au fost citite efectiv — și r_filtered, fracțiunea rămasă după aplicarea condiției WHERE. Când r_filtered e mult sub estimare, documentația însăși sugerează că e momentul unui index potrivit. Pentru interogări complexe, ANALYZE FORMAT=JSON dă semnificativ mai multă informație decât varianta tabelară.
De unde iei interogările care contează
Optimizarea interogării pe care ți-a semnalat-o un coleg e loterie. Lista corectă vine din instrumentație.
PostgreSQL: extensia pg_stat_statements urmărește statistici de planificare și execuție pentru toate instrucțiunile rulate pe server. Se activează adăugând-o în shared_preload_libraries, pentru că are nevoie de memorie partajată. Expune, printre altele, calls, total_exec_time, mean_exec_time, rows și statisticile de blocuri (shared_blks_hit, shared_blks_read). Important pentru confidențialitate: extensia normalizează textul interogărilor — constantele sunt înlocuite cu simboluri de parametru de tipul $1, iar interogările cu aceeași structură sunt agregate într-o singură intrare.
MariaDB: jurnalul de interogări lente, plus statisticile din schema de performanță.
Regula de prioritizare e simplă și contraintuitivă: nu începi cu interogarea cea mai lentă, ci cu cea care are timpul total cel mai mare — adică durată medie înmulțită cu numărul de apeluri. O interogare de 8 milisecunde rulată de două milioane de ori pe zi costă mai mult decât raportul de 40 de secunde rulat o dată.
Cele patru întrebări pe care le pui modelului
„Optimizează interogarea asta" produce sugestii generice. Întrebările de mai jos produc răspunsuri utile, pentru că forțează modelul să lucreze cu planul, nu cu textul SQL.
- „Unde se pierde timpul în planul ăsta și de ce?" — atașezi planul real. Ceri identificarea nodului dominant și explicația, nu soluția.
- „Unde diferă semnificativ estimările de realitate și ce explicații sunt posibile?" — aici ies la iveală statisticile vechi, corelațiile între coloane și condițiile pe funcții.
- „Ce indexuri ar ajuta, în ordinea raportului beneficiu/cost, și ce mă costă fiecare la scriere?" — cererea explicită a costului elimină jumătate din propunerile inutile.
- „Ce rescriere a interogării ar schimba comportamentul, nu doar viteza?" — întrebarea de siguranță, pe care o punem înainte de a accepta orice rescriere.
Adaugă în cerere și constrângerile reale: „tabela primește 200 de scrieri pe secundă", „nu pot schimba schema în următoarele două săptămâni", „aplicația rulează pe MariaDB 11". Fără ele, primești răspunsul pentru un sistem imaginar.
Ce accepți și cum verifici
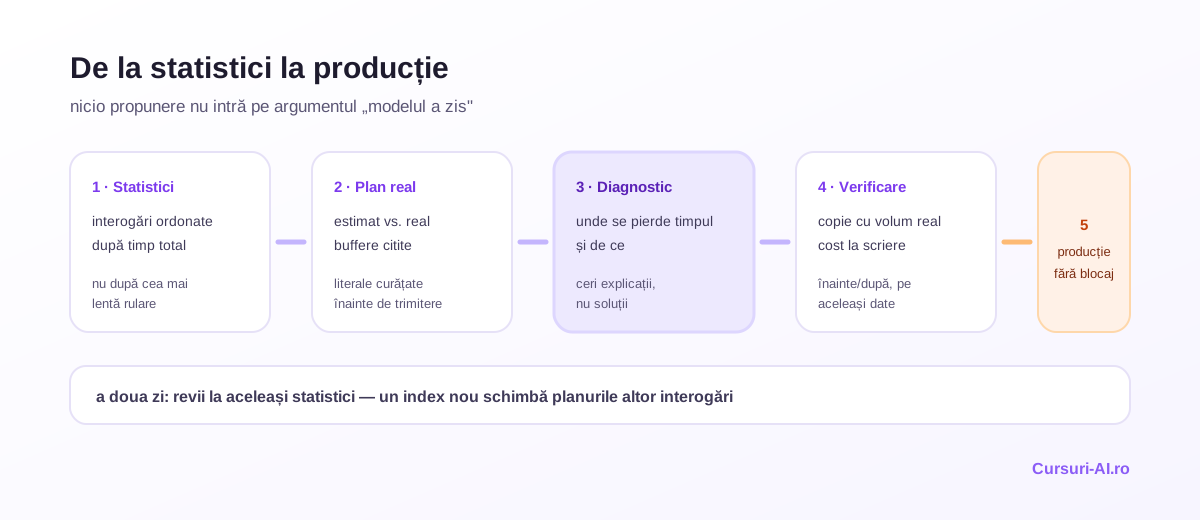
Nicio propunere nu intră în producție pe baza argumentului „modelul a zis". Ordinea de verificare:
1. Pe o copie cu volum realist. Nu pe baza de dezvoltare cu 500 de rânduri: acolo orice plan arată bine. Ai nevoie de o copie cu distribuție similară cu producția — obținută prin restaurare dintr-o copie de siguranță, cu datele anonimizate.
2. Măsori înainte și după, pe aceleași date. Rulezi de mai multe ori, ignori prima rulare (cache rece) și te uiți la percentile, nu la medie.
3. Verifici efectul asupra scrierilor. Fiecare index nou încetinește INSERT, UPDATE și DELETE și ocupă spațiu. Un index care accelerează un raport rulat zilnic, dar încetinește cu 15% o operațiune rulată de un milion de ori pe zi, e o pierdere.
4. Îl creezi fără să blochezi producția. În PostgreSQL, documentația e explicită: în mod normal, baza blochează tabela împotriva scrierilor pe durata construirii indexului, iar celelalte tranzacții care încearcă să insereze, să actualizeze sau să șteargă rânduri vor aștepta până la finalizare. Varianta CREATE INDEX CONCURRENTLY evită blocarea, dar cu trei costuri pe care trebuie să le știi dinainte: necesită două scanări ale tabelei și e semnificativ mai lentă; dacă apare o problemă în timpul scanării, comanda eșuează și lasă în urmă un index „invalid", care nu e folosit la interogări, dar consumă efort la fiecare actualizare; și, spre deosebire de varianta normală, nu poate rula într-un bloc de tranzacție.
5. Verifici că nu ai stricat altceva. Un index nou schimbă planurile altor interogări. După livrare, te uiți a doua zi la aceleași statistici din care ai pornit.
Greșelile pe care le fac modelele pe SQL
Din experiența pe cod real, se repetă cinci:
- Indexuri pe coloane cu puține valori distincte. Un index pe o coloană „status" cu trei valori posibile rareori ajută, dar întotdeauna costă la scriere.
- Indexuri redundante. Dacă ai deja un index compus pe (client_id, data), unul separat pe client_id e, de obicei, inutil. Modelul nu vede indexurile pe care nu i le-ai arătat.
- Rescrieri care schimbă semantica. Transformarea unui
NOT INînNOT EXISTS, tratarea valorilor nule, eliminarea unuiDISTINCT„inutil" — toate pot schimba rezultatul, nu doar viteza. De aceea întrebarea 4 din lista de mai sus e obligatorie. - Explicații plauzibile pentru cifre inventate. Dacă nu i-ai dat planul, modelul îl va descrie oricum. Cere-i mereu să indice nodul din planul pe care i l-ai atașat.
- Ignorarea cauzei reale. Uneori interogarea e corectă, iar problema e că statisticile sunt vechi, tabela e umflată sau conexiunile așteaptă la un blocaj. Niciun index nu repară asta.
Cum arată o cerere bună, concret
Structura de mai jos scurtează drumul spre un răspuns util. Completeaz-o cu datele tale și păstreaz-o ca șablon în echipă.
Context: PostgreSQL 17, tabela `comenzi` are ~42 de milioane de rânduri,
primește ~150 de inserări/secundă. Indexuri existente: (client_id),
(creat_la), (client_id, stare).

Interogarea: [SQL, cu parametri reprezentativi]

Planul real (EXPLAIN ANALYZE, BUFFERS), cu literalele curățate: [plan]

Ce vreau: identifică nodul unde se pierde timpul și explică de ce.
Spune-mi unde diferă estimările de realitate. Propune maximum trei
schimbări, fiecare cu costul ei la scriere. Nu propune rescrieri care
schimbă rezultatul; dacă una schimbă semantica, marcheaz-o explicit.
Diferența față de „optimizează asta" e că răspunsul devine verificabil: fiecare afirmație trimite la un nod din planul pe care l-ai atașat, iar propunerile vin cu preț, nu doar cu promisiune.
Trei cauze care nu se rezolvă cu un index
Când modelul insistă cu indexuri și nimic nu se îmbunătățește, cauza e, de obicei, una dintre acestea — și niciuna nu se vede în textul interogării.
Statistici vechi. Planificatorul decide pe baza statisticilor colectate despre distribuția datelor. După o încărcare masivă sau o ștergere mare, ele nu mai descriu realitatea, iar planurile devin absurde. Simptomul e exact cel din documentație: estimări foarte departe de numărul real de rânduri. Remediul e reîmprospătarea statisticilor, nu un index nou.
Volum inutil de date citite. O interogare care aduce toate coloanele dintr-o tabelă lată, apoi folosește două, plătește citirea completă. La fel, paginarea cu decalaj mare: pentru a returna rândurile de la 100.000 încolo, baza trebuie să treacă peste primele 100.000. Soluția e schimbarea abordării, nu accelerarea ei.
Așteptarea la blocaje. Dacă interogarea stă la coadă după o tranzacție lungă care ține un blocaj, timpul măsurat de aplicație nu are nimic de-a face cu planul. Se vede în vizualizările de activitate ale bazei, nu în EXPLAIN — iar dacă îi dai modelului doar interogarea, va încerca degeaba să o optimizeze.
Regula care economisește cel mai mult timp: înainte de a cere o optimizare, verifică dacă problema e în plan, în date sau în concurență. Sunt trei diagnostice diferite, cu trei remedii diferite.
Confidențialitate: ce iese din firmă
Trei reguli care rezolvă discuția cu securitatea înainte să apară:
- Structura da, datele nu. Schema, indexurile și planurile pot ieși, cu literalele curățate; conținutul tabelelor, nu.
- Interogările normalizate sunt mai sigure. Textul din
pg_stat_statementsare deja constantele înlocuite cu parametri. - Dacă politica firmei interzice complet transmiterea către exterior, metoda rămâne identică, doar unealta se schimbă: un model găzduit intern citește la fel de bine un plan de execuție.
Deciziile de arhitectură din jurul stratului de date — indexare, caching, scalare, observabilitate — sunt tratate pe larg în cursul Arhitectura Sistemelor AI la Scară.
Listă de control
- Pornești de la statistici, nu de la impresii: interogările ordonate după timp total.
- Iei planul real, nu cel estimat.
- Cureți literalele din plan înainte să-l trimiți.
- Adaugi context: dimensiuni, cardinalitate, rata de scriere, versiunea bazei.
- Ceri explicația nodului dominant, nu soluția.
- Ceri costul fiecărei propuneri, nu doar beneficiul.
- Testezi pe o copie cu volum realist, anonimizată.
- Măsori percentile, nu medii, și ignori prima rulare.
- Creezi indexurile fără să blochezi scrierile și verifici că au rămas valide.
- Revii a doua zi la statistici, ca să vezi ce s-a schimbat în rest.
Dacă schimbarea implică și modificarea structurii tabelelor, nu doar adăugarea unui index, partea de migrare are propriile reguli — le-am detaliat separat în ghidul despre migrări de schemă cu agenți. Iar dacă tocmai ai preluat o bază de date pe care nu o cunoști, ordinea corectă de explorare e în articolul despre onboarding într-un codebase necunoscut.
Întrebări frecvente
Î: Pot să-i dau modelului doar interogarea, fără plan? R: Poți, dar primești sfaturi generale, nu diagnostic. Fără plan, modelul nu are cum să știe unde se pierde timpul, dacă estimările sunt greșite sau ce indexuri se folosesc deja. Diferența de calitate între „iată interogarea" și „iată interogarea, planul real, schema și dimensiunile" e mai mare decât diferența dintre două modele.
Î: Care e diferența dintre EXPLAIN și EXPLAIN ANALYZE?
R: EXPLAIN arată planul pe care l-ar alege planificatorul, fără să execute interogarea. EXPLAIN ANALYZE execută interogarea și afișează numărul real de rânduri și timpii, alături de estimări. Atenție: pentru instrucțiuni care modifică date, efectele se produc real — documentația PostgreSQL recomandă rularea între BEGIN și ROLLBACK. În MariaDB, echivalentul e instrucțiunea ANALYZE, care adaugă coloanele r_rows și r_filtered.
Î: E sigur să trimit planul de execuție către un serviciu extern?
R: Structura nu e, de regulă, sensibilă, dar planul poate conține valorile literale din interogare — inclusiv date cu caracter personal. Curăță-le înainte. Textul din pg_stat_statements e deja normalizat, cu constantele înlocuite prin parametri, deci e o sursă mai sigură pentru discuție.
Î: Cum știu dacă indexul propus merită? R: Îl creezi pe o copie cu volum realist și măsori trei lucruri: timpul interogării vizate, timpul operațiunilor de scriere pe acea tabelă și spațiul ocupat. Dacă interogarea se accelerează, dar scrierile încetinesc mai mult decât câștigi, e o pierdere. În producție, îl creezi fără să blochezi scrierile și verifici apoi că indexul e valid.
Î: Modelul propune o rescriere a interogării. E riscant? R: Mai riscant decât un index, pentru că poate schimba rezultatul, nu doar viteza — tratarea valorilor nule, duplicatele și ordinea sunt capcanele obișnuite. Regula practică: orice rescriere se validează comparând rezultatele vechi și noi pe un set de date reprezentativ, nu doar timpii de execuție.
Concluzie
Un model e un partener excelent la citit planuri de execuție: vede rapid nodul dominant, observă diferența dintre estimări și realitate și explică de ce apare. Nu are însă acces la datele tale, la rata de scriere sau la ce s-a mai încercat înainte — iar în lipsa lor produce sfaturi care sună bine și costă scump.
Metoda care funcționează e aceeași de douăzeci de ani, doar că acum are un ajutor: pornești de la măsurători, ceri diagnostic, nu soluții, verifici propunerile pe o copie realistă și livrezi fără să blochezi producția.
Surse: PostgreSQL — Using EXPLAIN · PostgreSQL — pg_stat_statements · PostgreSQL — CREATE INDEX · MariaDB — instrucțiunea ANALYZE
Articol informativ, publicat la 19 septembrie 2026. Comportamentul planificatorului și opțiunile de sintaxă diferă între versiuni — verifică documentația versiunii tale de bază de date înainte de a aplica modificări în producție.

Cursul care continuă acest articol
Claude Code Mastery: Coding Agentic din Terminal (multi-fișier, git, CI, MCP)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Claude Code: Instalare, CLI și Modelul Mental Agent-First
- Multi-Fișier și Codebase-uri Mari: Plan, Edit, Review și Context Management
- Workflow Git Complet: Branch-uri, Commit-uri, Conflicte, Code Review și PR-uri
- Headless Mode (claude -p) și Automatizare Non-Interactivă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.