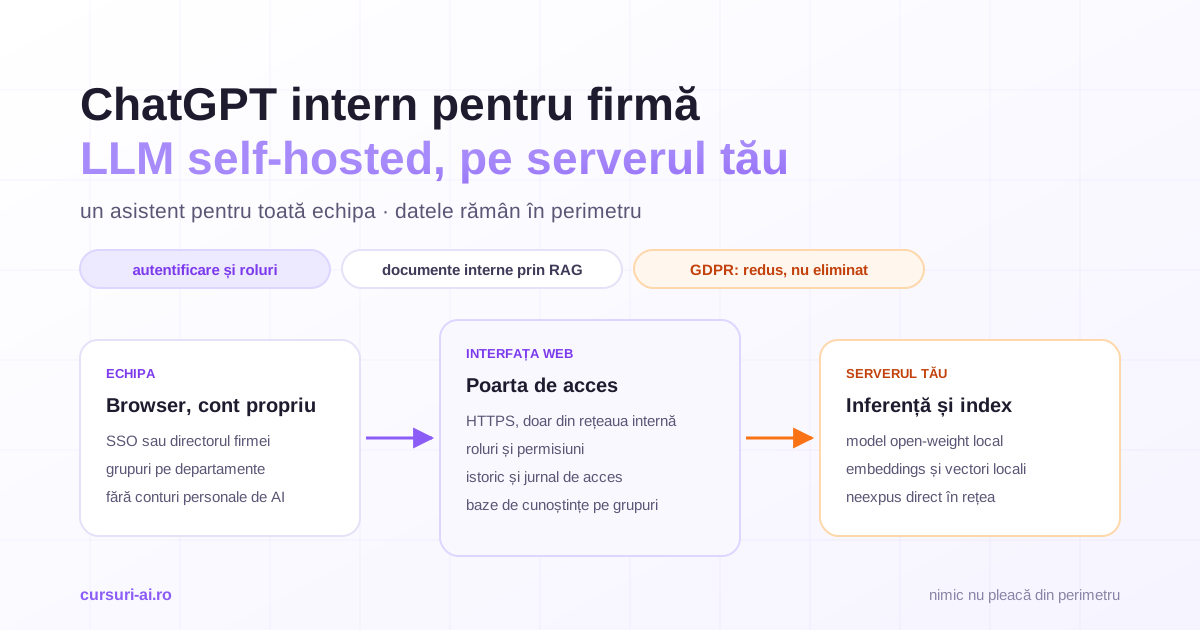
Un ChatGPT intern pentru firmă înseamnă un asistent AI pe care îl folosește toată echipa din browser, dar care rulează pe serverul tău: modelul, conversațiile și documentele interne nu părăsesc perimetrul companiei. Pentru firmele cu date confidențiale — contracte, dosare de clienți, date medicale, cod proprietar — întrebarea nu mai e „avem voie să folosim AI?", ci „construim un asistent intern sau plătim abonamente Team ori Enterprise?". Ghidul acesta e scris pentru cine trebuie să ia decizia și să o poată apăra în fața conducerii, a responsabilului cu protecția datelor și a echipei de IT.
Un lucru de stabilit de la început: un LLM self-hosted pentru o echipă e alt proiect decât un model pornit pe laptopul unui developer. Instalarea Ollama, cuantizarea și alegerea modelului sunt tratate pas cu pas în ghidul despre LLM-uri locale cu Ollama, iar dimensionarea GPU-ului și a memoriei în ghidul de hardware pentru LLM local. Aici ne ocupăm de ce vine după: mai mulți utilizatori, conturi, roluri, documente interne, costuri, răspundere.
Ce înseamnă, concret, un ChatGPT intern pentru firmă
Din perspectiva utilizatorului, experiența e cea cunoscută: o pagină web, un câmp de text, istoric de conversații, posibilitatea de a atașa un fișier. Diferențele sunt toate în spate și toate țin de control:
- Identitate. Fiecare om intră cu contul lui din firmă, nu cu o adresă personală și nu cu o parolă comună.
- Drepturi. Departamentul juridic vede baza de contracte; vânzările nu. Un model mare și lent e rezervat analizelor; unul mic și rapid, tuturor.
- Cunoștințe interne. Asistentul răspunde pe baza procedurilor, ofertelor și documentației firmei, cu trimitere la sursă.
- Urme. Se știe cine a folosit sistemul și când, iar conversațiile au un termen de păstrare stabilit de firmă, nu de un furnizor.
Mai e un efect, rar pus în calcul: un asistent intern bun e cel mai eficient remediu pentru folosirea pe ascuns a conturilor personale de AI. Oamenii nu lipesc date de clienți în unelte neaprobate din rea-voință, ci pentru că nu au o alternativă aprobată la fel de comodă. Fenomenul și politica ce îl ține sub control sunt descrise în articolul despre shadow AI în companie.
Arhitectura unui LLM self-hosted multi-utilizator
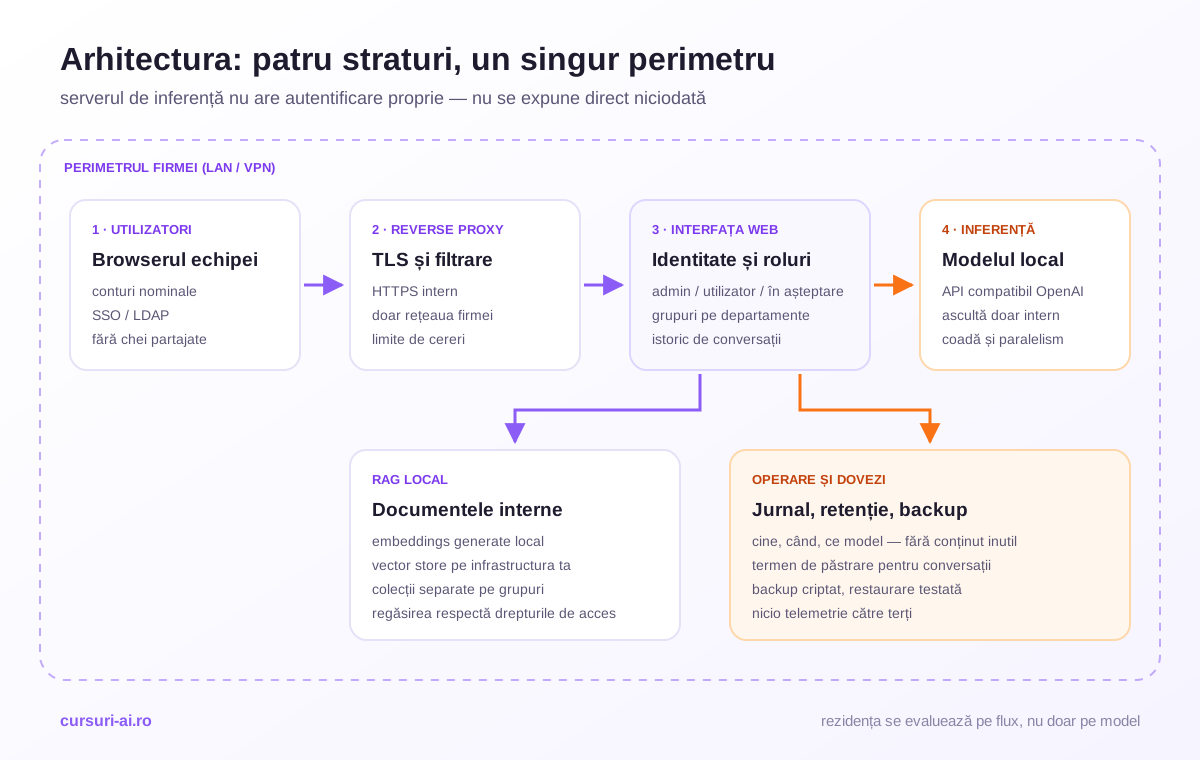
Patru straturi, fiecare cu o singură responsabilitate. Greșeala clasică e să le comprimi în două — „am pornit modelul și am dat colegilor adresa IP".
Serverul de inferență: nu se expune niciodată direct
Serverul de inferență încarcă modelul și răspunde la cereri HTTP. Pentru un pilot, Ollama e alegerea firească; are însă o proprietate pe care trebuie să o cunoști înainte de orice: nu are autentificare proprie. Conform documentației oficiale Ollama, serverul ascultă implicit pe 127.0.0.1:11434, iar adresa se schimbă cu variabila OLLAMA_HOST. În clipa în care îl muți pe 0.0.0.0, oricine ajunge la port poate folosi modelul, fără cont și fără urmă. De aici regula: serverul de inferență ascultă doar intern, iar singurul client care îi vorbește e interfața web.
A doua proprietate ține de concurență. Aceeași documentație precizează că OLLAMA_NUM_PARALLEL — numărul de cereri procesate simultan de un model — are valoarea implicită 1, iar OLLAMA_MAX_QUEUE, coada de așteptare înainte ca serverul să refuze cereri, are valoarea implicită 512. Tradus pentru o echipă: cu setările din fabrică, al doilea coleg care apasă Enter așteaptă ca primul să termine. Creșterea paralelismului consumă memorie suplimentară pentru context, deci se leagă direct de dimensionarea hardware.
Diferența dintre un server care merge pe laptop și unul pe care se bazează o echipă — pornire ca serviciu, variabilele OLLAMA_*, memoria ocupată de modele, punctul în care treci la un motor de servire construit pentru trafic concurent, precum vLLM — este exact ce aprofundează cursul LLM-uri Locale cu Ollama: Privacy, Self-Hosting și Inferență Offline, în modulele despre operare locală și despre scaling on-premise.
Interfața web: autentificare, roluri și grupuri
Interfața web e stratul care transformă un model într-un produs intern. Nu o scrii de la zero; există proiecte open-source mature. Două dintre cele mai folosite, cu faptele verificate în documentația lor la data publicării:
Open WebUI. Documentația descrie un sistem de control al accesului bazat pe roluri (RBAC) pe trei niveluri: roluri (Admin, User, Pending — un cont în așteptare nu are acces până la aprobare), permisiuni granulare și grupuri. Permisiunile sunt aditive: un utilizator primește reuniunea drepturilor din toate grupurile lui, fără mecanism de „interzicere". Prin grupuri se restricționează modele, baze de cunoștințe, unelte și prompturi, cu două niveluri de acces — citire și scriere. La autentificare sunt documentate conturi locale, SSO prin OIDC, LDAP, provizionare SCIM 2.0 și chei de API.
Atenție la licență, pentru că aici apar surprizele: potrivit paginii de licență a proiectului, codul până la versiunea 0.6.5 este BSD-3-Clause, iar de la v0.6.6 licența include o clauză de protecție a brandului. Elementele de identitate „Open WebUI" nu pot fi eliminate sau modificate, cu excepții — între ele, instalările cu cel mult 50 de utilizatori într-un interval de 30 de zile și licența enterprise. Dacă planul tău e „îi punem logoul firmei și îl dăm la 300 de oameni", citește clauza înainte, nu după.
LibreChat. Depozitul oficial indică licența MIT și descrie autentificare multi-utilizator cu OAuth2, LDAP și email, un panou de administrare pentru utilizatori, grupuri și roluri, compatibilitate cu orice API de tip OpenAI — inclusiv furnizori locali precum Ollama — și conversație pe fișiere.
Nu există un câștigător universal, iar ambele proiecte evoluează rapid. Criteriile de alegere care contează pentru o firmă:
| Criteriu | Întrebarea de pus |
|---|---|
| Identitate | Se leagă de directorul existent (OIDC, LDAP) sau creez conturi de mână? |
| Roluri | Pot separa cine vede ce model și ce bază de documente? |
| Licență | Ce am voie să modific și de la câți utilizatori se schimbă regulile? |
| Date | Unde se stochează conversațiile și fișierele și cum le șterg? |
| Actualizări | Cât de des apar versiuni și cine le aplică la noi? |
Verifică fiecare răspuns în documentația curentă a proiectului, în ziua deciziei.
RAG pe documentele interne, cu drepturi de acces
Un asistent care nu știe nimic despre firmă e doar un model generalist mai slab decât cele comerciale. Valoarea apare când răspunde din procedurile, contractele-cadru și documentația ta — adică prin RAG: documentele se sparg în fragmente, fiecare fragment primește o reprezentare numerică (embedding), iar la întrebare se regăsesc fragmentele relevante și se dau modelului drept context.
Două capcane specifice variantei private:
Embedding-urile pleacă în cloud pe ușa din dos. Multe tutoriale de RAG vectorizează documentele printr-un API extern. În clipa aceea, textul integral al documentelor confidențiale a ieșit din perimetru, chiar dacă generarea e locală. Într-un lanț cu adevărat privat, și modelul de embedding, și baza vectorială rulează pe infrastructura ta.
Regăsirea ignoră drepturile de acces. Dacă toate documentele ajung într-un singur index, asistentul îi va servi unui stagiar fragmente din statul de plată, cu cea mai bună intenție. Soluția simplă e separarea pe colecții legate de grupuri: o bază de cunoștințe pentru juridic, una pentru HR, una comună. Soluția riguroasă e filtrarea la regăsire după drepturile utilizatorului care întreabă. În ambele cazuri, regula e aceeași: asistentul nu are voie să știe mai mult decât omul care îl întreabă.
Calitatea răspunsurilor depinde mai mult de pregătirea documentelor decât de model. PDF-urile scanate, diacriticele stricate și tabelele sunt problemele reale ale arhivelor românești, tratate în ghidul despre RAG pe documente românești. Pentru partea de inginerie — strategii de chunking, reranking, evaluarea regăsirii, operarea în producție — reperul este cursul RAG: Retrieval-Augmented Generation în Practică.
Jurnal, retenție, backup
Stratul pe care îl sare toată lumea la pilot și pe care îl cere toată lumea la primul audit:
- Jurnal de acces: cine, când, ce model, ce bază de cunoștințe. Nu jurnaliza conținutul integral al conversațiilor „ca să fie" — creezi o a doua arhivă de date sensibile, mai prost păzită decât prima.
- Retenție: conversațiile au un termen de păstrare scris. „Pentru totdeauna" nu e un termen.
- Backup criptat și restaurare testată, inclusiv pentru baza vectorială.
- Zero telemetrie către terți. Verifică setările interfeței, ale proxy-ului și ale sistemului de monitorizare. Rezidența datelor se evaluează pe tot fluxul, nu doar pe model: un serviciu de loguri configurat neglijent anulează tot restul.
Cost total de proprietate: asistent intern vs abonamente Team/Enterprise
Nu îți dau cifre. Prețurile pe loc ale planurilor comerciale, prețul acceleratoarelor grafice și tarifele de inginerie se schimbă de la un trimestru la altul și diferă de la o ofertă la alta; orice sumă scrisă aici ar fi greșită până la data la care o citești. Îți dau, în schimb, metoda — cea cu care o astfel de decizie rezistă în fața unui director financiar.
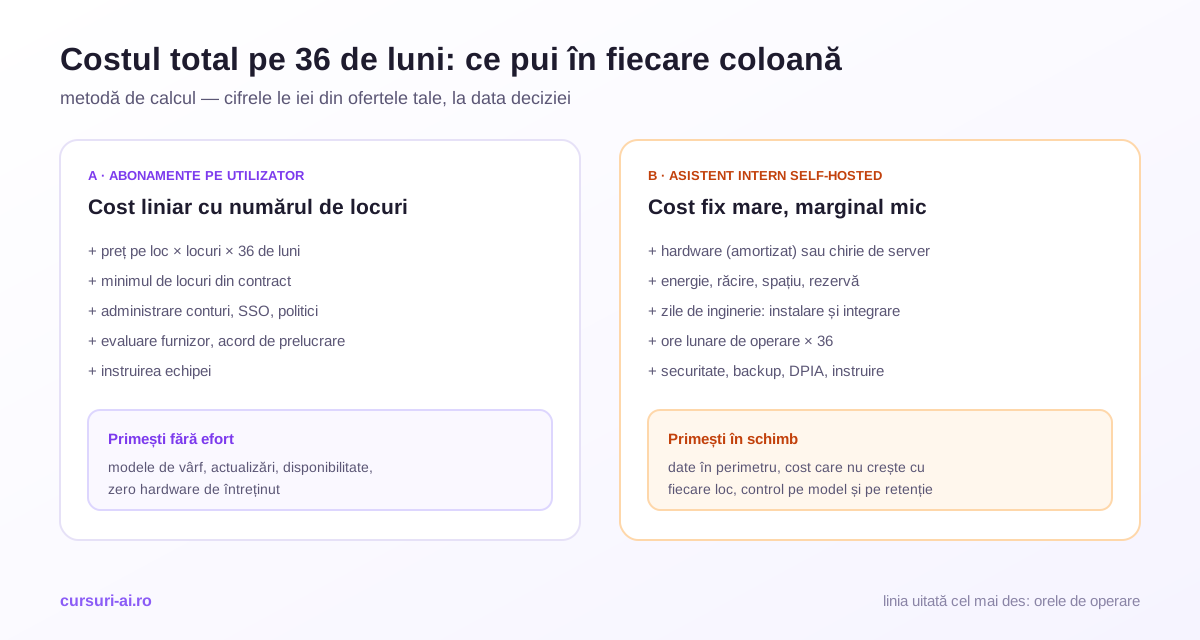
Orizontul: 36 de luni. E un interval rezonabil de amortizare pentru hardware și suficient de lung ca orele de operare să devină vizibile.
Coloana A — abonamente. Prețul pe loc × numărul de locuri × 36, ținând cont de minimul de locuri din contract și de oamenii care vor primi licență deși o folosesc de două ori pe lună. Adaugă administrarea conturilor, evaluarea furnizorului, acordul de prelucrare a datelor și instruirea. Costul crește liniar cu echipa.
Coloana B — self-hosted. Hardware amortizat sau chiria unui server dedicat; energie, răcire, spațiu și o rezervă pentru defecte; zilele de inginerie pentru instalare, integrarea cu directorul firmei și ingestia documentelor; apoi linia pe care o uită aproape toți: orele lunare de operare × 36 — actualizări, monitorizare, modele noi, utilizatori care nu se pot autentifica luni dimineața. La final, securitate, backup, evaluarea de impact și instruire. Costul fix e mare; costul unui utilizator în plus e aproape zero, până la pragul la care îți trebuie alt server.
Pragul de rentabilitate e numărul de utilizatori activi la care coloana B scade sub coloana A. Calculează-l cu ofertele tale reale, apoi refă calculul cu orele de operare dublate. Dacă decizia se răstoarnă, ai aflat cât de fragilă e.
Trei corecții care schimbă frecvent rezultatul:
- Utilizatori activi, nu angajați. Dimensionarea și costul se fac pe cei care folosesc zilnic sistemul și pe vârful de cereri simultane, nu pe organigramă.
- Calitatea nu e egală. Modelele de vârf din planurile comerciale rămân, de regulă, peste modelele open-weight pe care le poți rula pe un singur server, mai ales la raționament complex și la cod. Dacă diferența înseamnă ore pierdute de oameni scumpi, ea aparține calculului.
- Costul de a nu avea nimic aprobat. Dacă alternativa reală la asistentul intern nu sunt abonamentele, ci conturile personale folosite pe ascuns, compari cu un risc, nu cu un preț.
Varianta hibridă e adesea răspunsul corect: asistent intern pentru datele care nu au voie să iasă, abonamente comerciale pentru munca fără date sensibile — cu o politică scrisă care spune clar ce merge unde.
Securitate și GDPR: self-hosting reduce, nu elimină obligațiile
Argumentul „rulăm local, deci suntem conformi" e fals, și e bine să o audă conducerea de la tine, nu de la un auditor. Self-hosting-ul rezolvă o categorie de probleme — transferul către un terț, relația cu o persoană împuternicită, rezidența datelor. Restul Regulamentului (UE) 2016/679 (GDPR) rămâne integral în sarcina ta, pentru că ești operator indiferent unde rulează modelul.
Ce dispare sau se simplifică. Când folosești un serviciu cloud, furnizorul prelucrează date în numele tău, iar art. 28 îți cere să recurgi doar la persoane împuternicite care oferă garanții suficiente, pe bază de contract. Cu inferența pe serverul propriu, această relație nu mai există pentru model. Atenție: dacă serverul e închiriat de la un furnizor de găzduire, relația reapare, cu acel furnizor.
Ce rămâne.
- Principiile de la art. 5 — scop determinat, minimizare, limitarea stocării. Un asistent în care oricine poate încărca orice document, păstrat oricât, le încalcă pe toate trei, oricât de local ar fi.
- Protecția datelor începând cu momentul conceperii și în mod implicit (art. 25) — rolurile, colecțiile separate și retenția se proiectează de la început, nu se adaugă după incident.
- Securitatea prelucrării (art. 32) — măsuri tehnice și organizatorice adecvate riscului. Textul enumeră, între altele, pseudonimizarea și criptarea, capacitatea de a restabili accesul la date după un incident și un proces de testare periodică a eficacității măsurilor. În cloud, o parte din această muncă o face furnizorul; pe serverul tău, o faci toată tu.
- Evidența activităților de prelucrare (art. 30) — asistentul intern este o prelucrare nouă și se trece în evidență.
- Evaluarea impactului (art. 35) — obligatorie înaintea prelucrării atunci când un tip de prelucrare, „în special cel bazat pe utilizarea noilor tehnologii", este susceptibil să genereze un risc ridicat; textul indică, între situațiile vizate, prelucrarea pe scară largă a categoriilor speciale de date. O clinică sau un cabinet care indexează dosare de pacienți nu are ce discuta aici. Pentru restul, analiza de necesitate a evaluării se documentează oricum.
- Drepturile persoanelor vizate — accesul (art. 15) și ștergerea (art. 17) se aplică și datelor ajunse în conversații și în baza vectorială. Dacă nu poți găsi și șterge fragmentele provenite dintr-un document, ai o problemă de proiectare, nu de conformitate.
Cum se face, concret, o evaluare de impact pentru un sistem LLM intern, ce intră într-un jurnal de audit care nu devine el însuși un risc și cum arată o listă de verificare GDPR pentru un deployment privat sunt subiectele modulului de securitate și guvernanță și ale proiectului final din cursul despre LLM-uri locale, menționat mai sus.
Și AI Act. Regulamentul (UE) 2024/1689 privind inteligența artificială nu face distincție între un sistem din cloud și unul din subsol. Articolul 4 cere furnizorilor și implementatorilor să ia măsuri pentru un nivel suficient de alfabetizare în domeniul IA a personalului care operează și utilizează sistemele. Articolul 50 alin. (1) cere ca sistemele destinate să interacționeze direct cu persoane fizice să fie proiectate astfel încât acestea să fie informate că interacționează cu un sistem de IA, cu excepția situațiilor în care acest lucru e evident. Pentru un instrument intern, e evident; dacă însă expui mai târziu același asistent clienților, obligația devine practică. Licența modelului open-weight ales e un subiect separat, tratat în ghidul Ollama citat la început: open-weight nu înseamnă automat utilizare comercială fără condiții.
Instruirea oamenilor și regulile de folosire — ce date intră în asistent, ce nu intră nici măcar acolo, cine aprobă o nouă bază de documente — nu se rezolvă cu tehnologie. Structura unei astfel de politici, inclusiv clasificarea uneltelor pe niveluri de risc și cerința de alfabetizare din art. 4, e subiectul cursului Politică de Utilizare AI și Securitatea Datelor în Companie.
Când NU merită un asistent intern
Self-hosting-ul e o decizie de inginerie cu cost recurent, nu o insignă. Nu merită când:
- Nu ai cine să îl opereze. Fără o persoană cu timp alocat lunar, sistemul va rula versiuni vechi, cu vulnerabilități cunoscute, pe date sensibile — adică mai rău decât un serviciu comercial.
- Datele tale nu sunt, de fapt, atât de sensibile. Marketing, texte publice, cod open-source: un plan comercial pentru business rezolvă cazul fără niciun server. Planurile pentru organizații vin, de regulă, cu angajamente contractuale pe care conturile personale nu le au — de exemplu, termenii comerciali ai Anthropic prevăd explicit că furnizorul nu antrenează modele pe conținutul clientului. Citește termenii și acordul de prelucrare ai furnizorului tău; ce ai voie să pui într-un astfel de serviciu e discutat în ghidul despre datele clienților în ChatGPT și GDPR.
- Ai nevoie de calitate de vârf la raționament. Dacă sarcina principală e analiză juridică fină sau cod complex, diferența de calitate față de modelele comerciale de top se simte zilnic.
- Echipa e mică. Sub pragul de rentabilitate din calculul tău, plătești un server ca să economisești câteva abonamente.
Merită, în schimb, când datele nu au voie contractual sau legal să iasă din rețea, când clienții îți cer asta în scris — vezi ce întreabă, de obicei, un chestionar de securitate AI de la un client enterprise — când lucrezi în medii fără internet sau când numărul de utilizatori activi face costul pe loc greu de justificat.
Plan de pilot în 30 de zile
Un pilot bun răspunde la o singură întrebare: merită să construim varianta de producție? Tot ce nu servește această întrebare se amână.
Săptămâna 1 — cadrul. Alegi un singur departament (8–15 oameni) și un singur caz de utilizare, de pildă întrebări pe procedurile interne. Scrii criteriile de succes înainte de a instala ceva: un set de 30–50 de întrebări reale cu răspunsuri considerate corecte, un prag de acuratețe acceptat, un timp de răspuns tolerabil. Implici responsabilul cu protecția datelor de acum, nu la final, și folosești doar documente fără date personale în prima fază.
Săptămâna 2 — instalarea minimă corectă. Server de inferență care ascultă doar intern, interfață web în spatele unui reverse proxy cu HTTPS, accesibilă numai din rețeaua firmei sau prin VPN. Conturi nominale și un grup pentru departamentul pilot. O singură bază de cunoștințe, cu embedding-uri generate local. Fără personalizări, fără integrări suplimentare.
Săptămâna 3 — utilizare reală și măsurare. Oamenii lucrează cu el la sarcini reale. Rulezi setul de întrebări și notezi: acuratețe, răspunsuri fără sursă, timp de răspuns cu trei–patru utilizatori simultan, câți oameni revin a doua zi fără să li se amintească.
Săptămâna 4 — decizia. Compari rezultatele cu pragurile scrise în prima săptămână, completezi calculul de cost cu orele de operare măsurate efectiv și alegi una din trei concluzii: construim varianta de producție (cu lista de lucruri amânate: SSO, colecții pe grupuri, retenție, backup, evaluare de impact); rămânem pe abonamente comerciale, cu o politică de utilizare clară; mergem hibrid. Toate trei sunt rezultate bune, pentru că sunt decizii luate pe măsurători.
Întrebări frecvente
Ce este un ChatGPT intern pentru firmă? Este un asistent conversațional folosit de toată echipa din browser, care rulează pe infrastructura companiei: un server de inferență cu un model open-weight, o interfață web cu autentificare și roluri și, de regulă, acces la documentele interne prin RAG. Conversațiile și documentele nu sunt trimise unui furnizor extern de AI.
Dacă rulez modelul pe serverul propriu, mai am obligații GDPR? Da. Self-hosting-ul elimină transferul către un furnizor de AI și relația cu o persoană împuternicită pentru model, dar rămâi operator: se aplică în continuare principiile de minimizare și limitare a stocării, securitatea prelucrării, evidența activităților, evaluarea de impact acolo unde riscul e ridicat și drepturile persoanelor vizate, inclusiv pentru datele ajunse în conversații și în indexul de documente.
Pot da colegilor acces direct la serverul Ollama? Nu e recomandat. Conform documentației oficiale, Ollama ascultă implicit doar pe adresa locală și nu are un mecanism propriu de autentificare; expus în rețea, poate fi folosit de oricine ajunge la port. Accesul echipei se face printr-o interfață web cu conturi, în spatele unui reverse proxy cu HTTPS, iar serverul de inferență rămâne accesibil doar intern.
Este mai ieftin un asistent intern decât abonamentele Team sau Enterprise? Uneori. Abonamentele cresc liniar cu numărul de locuri, iar varianta internă are cost fix mare și cost marginal mic. Pragul de rentabilitate se calculează pe 36 de luni, cu ofertele tale reale, incluzând hardware, inginerie și mai ales orele lunare de operare. Pentru echipe mici, abonamentele ies de obicei mai bine; decizia de self-hosting se justifică atunci prin confidențialitate, nu prin preț.
Concluzie
Un ChatGPT intern pentru firmă nu e un model pornit pe un server, ci un mic produs intern cu patru straturi: inferență care nu se expune direct, interfață web cu identitate și roluri, RAG care respectă drepturile de acces și un strat de jurnal, retenție și backup. Partea tehnică e rezolvabilă în câteva săptămâni; partea care decide succesul e operarea pe termen lung și disciplina din jurul datelor.
Decizia dintre asistent intern și abonamente se ia cu un calcul pe 36 de luni în care orele de operare apar explicit, cu o evaluare onestă a sensibilității datelor și cu un pilot de 30 de zile care are criterii scrise înainte de instalare. Self-hosting-ul reduce riscul de transfer al datelor, dar nu mută răspunderea nicăieri: rămâne la tine, împreună cu controlul.
Surse și resurse oficiale
- Ollama — FAQ oficial: adresa de ascultare, OLLAMA_HOST, cereri concurente
- Open WebUI — controlul accesului bazat pe roluri (RBAC)
- Open WebUI — licența și clauza de brand
- LibreChat — depozitul oficial (licență MIT, autentificare, furnizori compatibili)
- Regulamentul (UE) 2016/679 (GDPR), EUR-Lex
- Regulamentul (UE) 2024/1689 privind inteligența artificială, EUR-Lex
Articol informativ, publicat la 22 septembrie 2026. Funcțiile și licențele proiectelor open-source menționate, precum și termenii planurilor comerciale, se modifică — verifică-le în documentația oficială la data deciziei. Nu constituie consultanță juridică; pentru aplicarea GDPR și a Regulamentului privind IA în situația firmei tale, consultă responsabilul cu protecția datelor sau un avocat.

Cursul care continuă acest articol
LLM-uri Locale cu Ollama: Privacy, Self-Hosting și Inferență Offline
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- De Ce LLM Local: Privacy, Data Residency și Cadrul Legal ca Motoare de Adopție
- Instalare și Fundamente Ollama: Primul Model și API-ul REST OpenAI-Compatible
- Peisajul Modelelor Open-Weight 2026: Criterii Reale de Alegere
- Cuantizare și Hardware: GGUF, q4_K_M vs q8_0 și Dimensionare Realistă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.