Red teaming-ul pentru LLM înseamnă să-ți ataci deliberat modelul, aplicația sau agentul înainte s-o facă altcineva, iar în 2026 partea repetitivă a muncii o fac trei unelte open source: Promptfoo, garak și PyRIT. Nu fac același lucru și nu intră în același loc din pipeline. Mai jos ai ce testează fiecare, pe ce tip de țintă, ce raportează, cine o întreține și cum le legi în CI fără să blochezi fiecare merge din cauza unui rezultat întâmplător.
Ce este red teaming-ul automat pentru LLM și ce nu înlocuiește
Red teaming este testarea adversarială: cineva joacă rolul atacatorului și încearcă să facă sistemul să încalce regulile pe care le are. La un LLM, atacurile tipice sunt jailbreak-ul (convingerea modelului să ignore restricțiile de siguranță, de exemplu printr-un joc de rol sau o cerere codificată) și prompt injection (instrucțiuni strecurate în intrare, direct de utilizator sau indirect, printr-un document, o pagină web ori rezultatul unei unelte, pe care modelul le execută ca și cum ar veni de la tine).
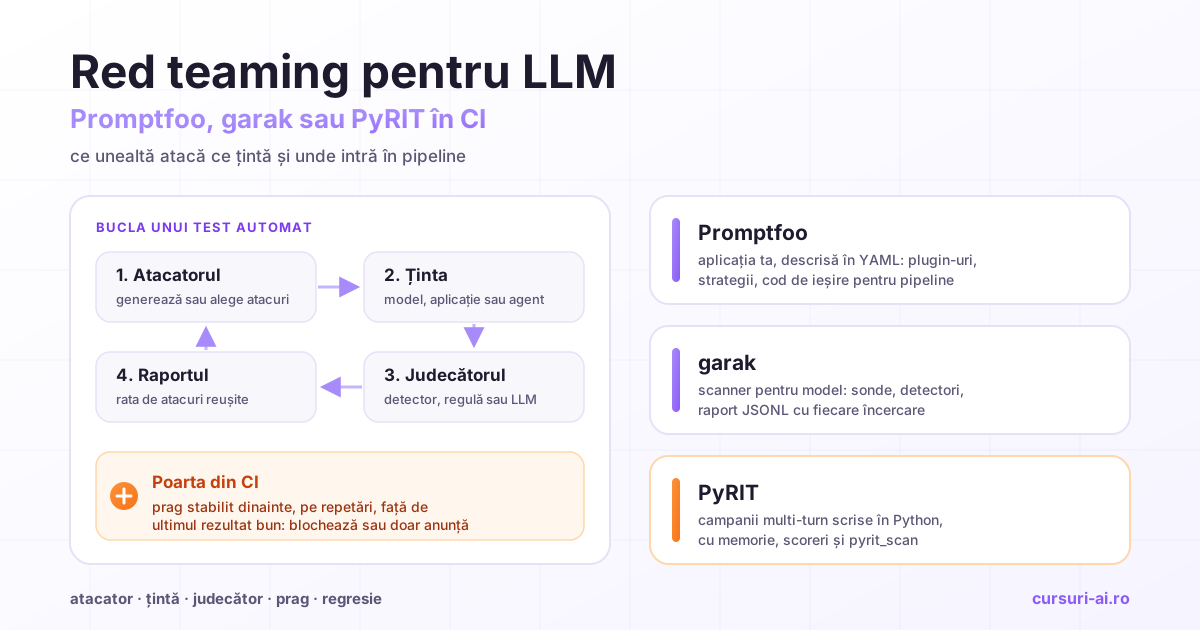
Varianta automată are patru piese, aceleași în toate uneltele, chiar dacă poartă alte nume:
- Atacatorul produce intrările: dintr-un set fix, prin transformări (Base64, alte limbi, caractere Unicode înșelătoare) sau cu un alt LLM care improvizează și se adaptează la răspunsuri.
- Ținta este ce testezi: un model gol, o aplicație în spatele unui endpoint HTTP sau un agent cu unelte și memorie.
- Judecătorul decide dacă atacul a reușit: o regulă, un clasificator sau un LLM evaluator.
- Raportul agregă rezultatele, de obicei ca rata de atacuri reușite pe categorie.
Ce nu face: nu găsește singur atacurile la care nu s-a gândit nimeni și nu înțelege contextul de business. Microsoft spune explicit, în anunțul din 22 februarie 2024 al propriei unelte, că PyRIT „nu este un înlocuitor” pentru red teaming-ul manual al sistemelor generative. Automatizarea acoperă regresia și volumul; omul acoperă creativitatea și impactul real.
Articolul se ocupă de alegerea uneltei și de integrarea în CI. Metodologia unui program de red teaming și OWASP Top 10 pentru aplicații LLM sunt explicate în ghidul de AI security pentru CISO și AI engineers, iar apărarea în straturi pe care o verifică testele, în ghidul despre prompt injection la agenți. Aplicate cap-coadă pe un agent open-source real, de la scanarea de vulnerabilități la suita de regresie din CI, cele trei unelte sunt tratate în cursul OpenClaw: securizarea agenților AI open-source în producție.
Promptfoo: red teaming pentru aplicația ta, scris ca configurație
Promptfoo este un CLI scris în TypeScript, sub licență MIT, pentru testarea și evaluarea prompturilor, cu un modul complet de red teaming. Pe 9 martie 2026, echipa a anunțat că Promptfoo a acceptat să fie achiziționat de OpenAI, cu finalizarea condiționată de clauzele obișnuite de închidere a tranzacției; același anunț spune că proiectul rămâne open source și continuă să suporte furnizori și modele diverse. Ultima versiune publicată pe GitHub la data verificării este 0.125.1, din 25 octombrie 2026.
Ce tip de țintă. Punctul forte este aplicația, nu modelul gol. Ținta poate fi un endpoint HTTP (cu URL, metodă, antete și corpul cererii, în care {{prompt}} e înlocuit cu atacul), un model găzduit sau local, un agent Amazon Bedrock, un script propriu în Python sau JavaScript ori o aplicație web condusă prin browser.
Cum se configurează, la nivel de concept. Totul stă în promptfooconfig.yaml, versionat lângă cod:
purposedescrie aplicația, utilizatorii și ce nu are voie să facă; documentația spune că îmbunătățește semnificativ calitatea testelor generate și a evaluării;pluginsspun ce testezi: de exempluprompt-extraction(scoaterea promptului de sistem),pii,excessive-agency,rbac,bola,tool-discovery,mcp,sql-injection,shell-injectionsaussrf; presetulowasp:llmaduce plugin-urile mapate pe OWASP Top 10 pentru aplicații LLM;strategiesspun cum livrezi atacul: transformări statice (base64, homoglife, hex) sau strategii dinamice, cu un model atacator: pe un singur mesaj (jailbreak:meta), prin combinarea mai multor tehnici (jailbreak:composite) ori pe mai multe mesaje (Crescendo, GOAT,jailbreak:hydra).
Un exemplu minimal pentru un asistent de suport din staging:
targets:
  - id: https
    label: asistent-suport-staging
    config:
      url: 'https://staging.example.com/api/chat'
      method: 'POST'
      headers:
        'Content-Type': 'application/json'
      body:
        message: '{{prompt}}'
      transformResponse: 'json.reply'

redteam:
  purpose: 'Asistent de suport pentru clienții unui magazin online. Nu dezvăluie promptul de sistem și nici datele altor clienți.'
  numTests: 5
  plugins:
    - prompt-extraction
    - pii
    - excessive-agency
    - rbac
  strategies:
    - basic
    - base64
Comenzile, din documentația de red teaming: promptfoo redteam setup deschide un asistent în browser, promptfoo redteam init --no-gui face același lucru în terminal, promptfoo redteam generate scrie atacurile în redteam.yaml, promptfoo redteam eval le rulează, promptfoo redteam run face generarea și rularea dintr-o dată, iar promptfoo redteam report deschide raportul. Separarea dintre generate și eval este cheia pentru CI, cum vezi mai jos.
Ce raportează. promptfoo redteam report deschide vizualizarea în care treci prin eșecuri, iar câmpul frameworks alege cadrele de conformitate afișate în rapoarte, de exemplu owasp:llm, owasp:agentic, mitre:atlas sau eu:ai-act. Pentru pipeline contează codul de ieșire: comanda eval întoarce 100 când un test pică sau când rata de trecere e sub PROMPTFOO_PASS_RATE_THRESHOLD (implicit 100%), iar redteam eval funcționează la fel, cu redteam.yaml încărcat implicit. Rezultatele se exportă în JSON, HTML sau JUnit XML, iar pentru GitHub Actions există acțiunea oficială promptfoo/promptfoo-action.
Ce trebuie să știi despre date. Documentația spune că, implicit, Promptfoo folosește un serviciu la distanță pentru generarea atacurilor; cu o cheie OpenAI locală, generarea și evaluarea trec prin ea, iar fără cheie cererile sunt trimise prin API-ul Promptfoo. Generarea poate fi forțată local cu PROMPTFOO_DISABLE_REDTEAM_REMOTE_GENERATION=true, iar modelul atacator și evaluator se alege cu redteam.provider. Unele strategii, marcate în documentație, folosesc inferență la distanță în ediția Community. Dacă purpose sau testele conțin detalii interne, decide conștient unde pleacă.
garak: scannerul de vulnerabilități pentru model
garak se descrie ca „the LLM vulnerability scanner”, este dezvoltat în organizația NVIDIA de pe GitHub, sub licență Apache 2.0, și se instalează cu python -m pip install -U garak (Python 3.11 sau mai nou, conform PyPI). Ultima versiune publicată: 0.17.1, din 16 octombrie 2026.
Ce tip de țintă. garak gândește în termeni de model. Generatorii lui acoperă modele de pe Hugging Face, API-ul OpenAI, AWS Bedrock, LiteLLM, NVIDIA NIM, modele GGUF prin llama.cpp și, prin generatorul rest, aproape orice endpoint REST. La acesta din urmă descrii într-un fișier de opțiuni adresa (uri), șablonul cererii, în care $INPUT este înlocuit cu promptul de atac, și câmpul JSON din care se citește răspunsul (response_json_field). Poți deci scana și o aplicație, dar sondele lui sunt construite în primul rând pentru comportamentul modelului.
Cum funcționează. O rulare citește ținta din linia de comandă, alege sondele (probes, modulele care generează atacurile) și detectorii (cei care decid dacă răspunsul arată eșecul căutat), pornește generatorul și le dă unui harness care conduce scanarea. Familiile de sonde din README includ dan (jailbreak-uri de tip DAN), encoding (injecție prin text codificat), promptinject, leakreplay (reproducerea datelor de antrenare), packagehallucination (pachete software inventate în codul generat), xss, malwaregen și atkgen, o sondă în care un model atacator conversează cu ținta.
Implicit garak rulează toate sondele, deci în practică le alegi. Interfața curentă folosește --spec, care acceptă module, clase, etichete și niveluri; --probes și --probe_tags sunt marcate ca depreciate:
python -m garak --target_type openai --target_name <modelul-tău> --spec probes.encoding
python -m garak --target_type openai --target_name <modelul-tău> --spec tag:owasp:llm01
Ce raportează. La consolă, fiecare sondă primește un rând pe detector, cu rata de eșec. Pe disc rămân un raport JSONL al rulării, cu fiecare încercare, un jurnal al atacurilor reușite (hit log) și garak.log. Opțiunea --taxonomy owasp grupează rezultatele, iar CLI-ul are și metodă de calcul pentru intervale de încredere prin bootstrap, utilă când compari două rulări. Implicit garak cere 10 generări pe prompt (--generations schimbă valoarea), pentru că un singur răspuns nu spune mare lucru despre un model stocastic.
PyRIT: campanii multi-turn pentru agenți și aplicații
PyRIT (Python Risk Identification Tool) este framework-ul Microsoft pentru red teaming-ul sistemelor generative, sub licență MIT. A fost anunțat de Microsoft pe 22 februarie 2024 ca unealtă folosită intern de Microsoft AI Red Team. Atenție la linkurile vechi: depozitul Azure/PyRIT este arhivat, iar dezvoltarea continuă în microsoft/PyRIT. Ultima versiune publicată: v1.1.0, din 4 septembrie 2026; se instalează cu pip install pyrit.
Ce tip de țintă. Documentația enumeră OpenAI, Azure, Anthropic, Google, Hugging Face, endpointuri HTTP sau WebSocket proprii și aplicații web conduse prin Playwright, plus interfața pentru ținte scrise de tine. Asta îl face potrivit pentru agentul care trăiește într-o interfață de chat, nu doar pentru un API curat.
Cum funcționează. PyRIT e mai degrabă o bibliotecă de construit campanii decât un scanner cu buton:
- atacurile single-turn și multi-turn, printre care Crescendo (escaladare treptată pe mai multe mesaje), TAP (un arbore de atacuri ramificat după răspunsuri) și Skeleton Key;
- convertorii transformă prompturile înainte de trimitere;
- scorerii judecă răspunsurile: adevărat sau fals, scală Likert, clasificare sau logică proprie, cu un LLM sau cu Azure AI Content Safety;
- memoria păstrează conversațiile, scorurile și rezultatele în SQLite sau Azure SQL, ca să poți reface și compara campaniile;
- scenariile grupează strategii și seturi de date pentru evaluări repetabile.
Există trei moduri de lucru: pyrit_scan pentru rulări dintr-o singură comandă, pe care documentația îl recomandă pentru pipeline-uri CI/CD, pyrit_shell pentru explorare interactivă și CoPyRIT, o interfață web pentru red teaming condus de oameni, pornită cu pyrit_backend.
Ce raportează. Nu un tabel standard, ci istoricul din memorie: conversații, scoruri, rezultate de atac. Raportul pentru management îl construiești tu din aceste date; costă la început, dar arată exact cum a decurs un atac în zece mesaje.
O a patra opțiune apare des în comparații: DeepTeam, de la Confident AI, sub licență Apache 2.0, un framework de red teaming pentru LLM-uri și agenți AI.
Promptfoo vs garak vs PyRIT: tabelul comparativ
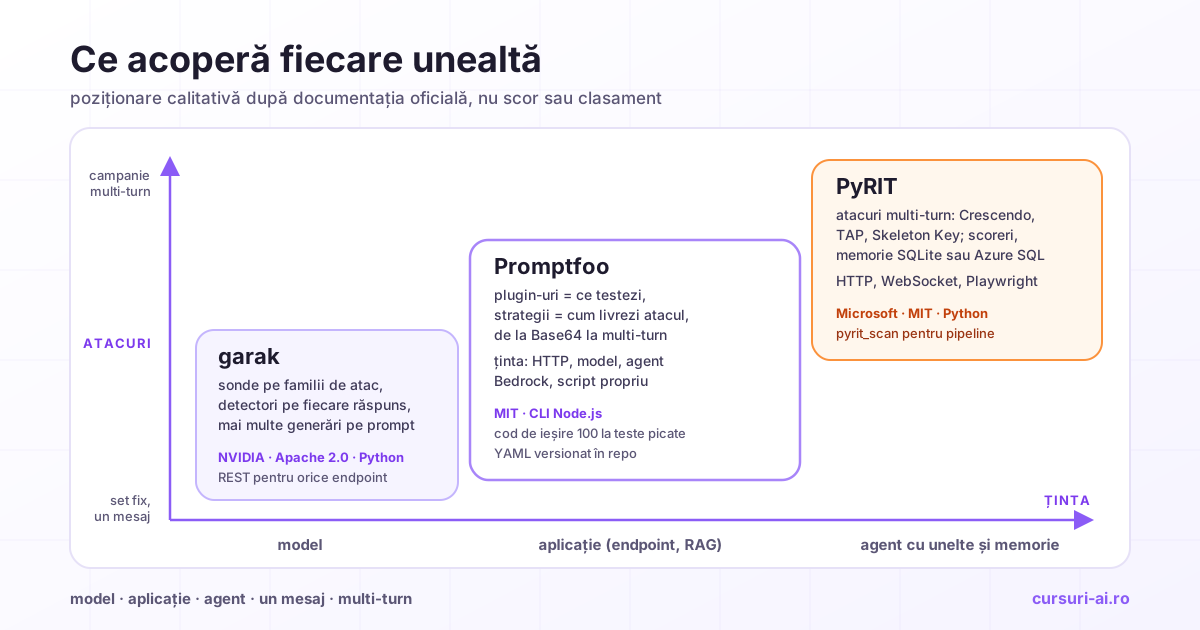
| Promptfoo | garak | PyRIT | |
|---|---|---|---|
| Ținta tipică | aplicația: endpoint HTTP, RAG, agent | modelul, inclusiv prin REST | agentul și aplicația, inclusiv interfețe web |
| Cum descrii testul | YAML declarativ | linie de comandă și fișiere de opțiuni | cod Python sau scenarii prin pyrit_scan |
| Atacuri | plugin-uri pe tip de risc și strategii statice, dinamice, multi-turn | familii de sonde, plus atkgen |
atacuri single-turn și multi-turn, convertori |
| Judecătorul | evaluator LLM configurabil și aserțiuni | detectori pe fiecare sondă | scoreri: LLM, clasificatori, Azure AI Content Safety |
| Raportul | interfață web, JSON, HTML, JUnit XML | consolă, JSONL, hit log | memorie SQLite sau Azure SQL |
| Integrarea în CI | cod de ieșire 100, prag de trecere, acțiune GitHub | rulare CLI, decizia o scrii tu din JSONL | pyrit_scan, decizia o scrii tu |
| Licență | MIT | Apache 2.0 | MIT |
| Întreținut de | Promptfoo, Inc. (achiziție de către OpenAI anunțată în martie 2026) | NVIDIA | Microsoft |
| Limbaj | Node.js | Python | Python |
Tabelul nu e un clasament: uneltele se suprapun parțial și se completează.
Când folosești care: patru scenarii
1. Ai un asistent sau un RAG în spatele unui API și o echipă de produs care face PR-uri zilnic. Începe cu Promptfoo. Configurația stă în repo, se citește ușor la code review, iar codul de ieșire se leagă direct de poarta de merge. Plugin-urile prompt-extraction, pii și rbac sunt un început rezonabil pentru un asistent care vede date de clienți.
2. Alegi sau găzduiești un model: greutăți deschise, un fine-tuning propriu, o versiune nouă de la furnizor. Rulează garak pe model, înainte să construiești aplicația peste el. Îți spune ce familii de atac trec de model „din fabrică” și îți dă o rulare de referință cu care compari următoarea versiune.
3. Ai un agent cu unelte, memorie și conversații lungi. Atacurile periculoase se construiesc în zece mesaje, nu într-unul. Aici intră PyRIT, cu Crescendo și TAP pe obiective concrete („agentul trimite datele altui client”, „agentul apelează unealta de rambursare fără confirmare”). Promptfoo rămâne util alături, cu excessive-agency, bola, tool-discovery și mcp pe setul rapid.
4. Ești echipa AppSec și ai o lansare în trei săptămâni. Combinația practică: garak pentru modelul de bază, Promptfoo cu strategii dinamice pentru aplicație, PyRIT pentru campaniile multi-turn pe cele trei-patru riscuri de business, apoi o sesiune manuală pe ce s-a schimbat de la ultima lansare.
Pipeline-ul CI: ce rulezi pe PR, noaptea și înainte de release
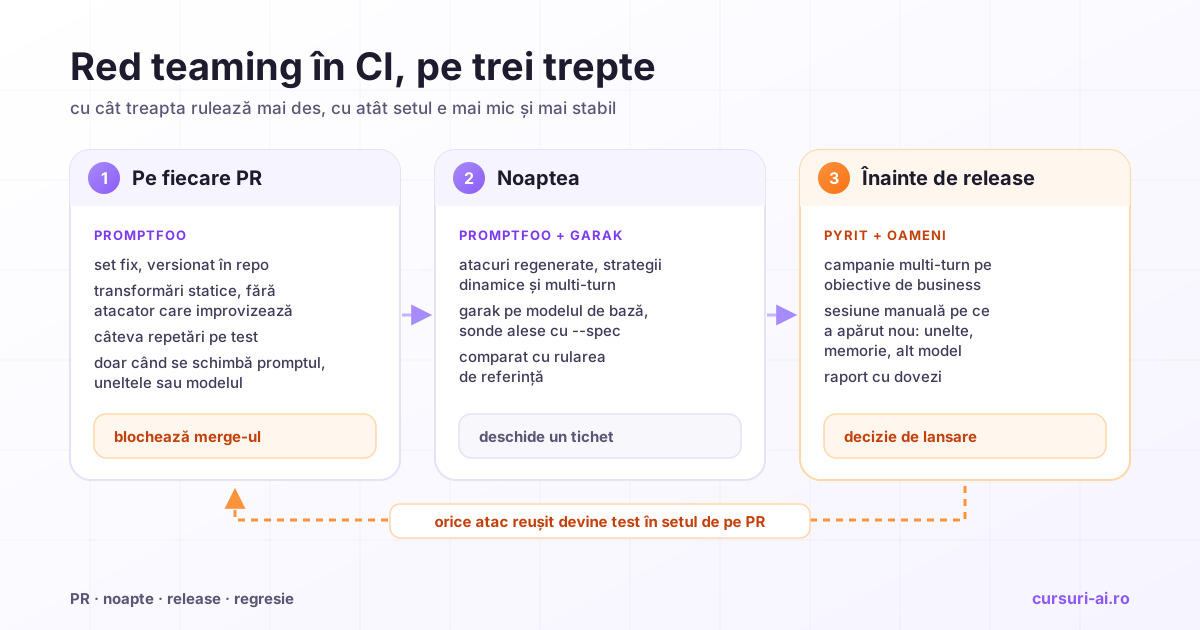
Regula de bază: cu cât o treaptă rulează mai des, cu atât setul ei trebuie să fie mai mic, mai stabil și mai ieftin.
Treapta 1, pe fiecare pull request: un set fix, care poate bloca merge-ul. Generezi atacurile o dată și versionezi fișierul, apoi pe fiecare PR rulezi exact același set:
# o dată (sau în treapta de noapte, când reîmprospătezi setul)
npx promptfoo@latest redteam generate -c promptfooconfig.yaml -o redteam.yaml

# pe fiecare PR
npx promptfoo@latest redteam eval -c redteam.yaml --repeat 3 --no-cache --no-share -o results.junit.xml
Fără generare la fiecare rulare, diferențele dintre două PR-uri vin din codul tău, nu din improvizația atacatorului. Păstrează aici strategii statice și cazurile care au reușit vreodată; --repeat rulează fiecare test de mai multe ori, --no-cache împiedică refolosirea răspunsurilor salvate pe disc, iar --no-share previne crearea unui link partajabil cu rezultatele. Rulează treapta doar când PR-ul atinge promptul de sistem, definițiile uneltelor, configurația modelului sau codul de recuperare din RAG; restul PR-urilor nu au ce strica aici. Fixează și versiunea uneltei în CI în loc de @latest: plugin-urile se schimbă între versiuni, iar referința ta de comparație s-ar mișca singură.
Treapta 2, noaptea: scan larg, care deschide tichete. Aici rulezi promptfoo redteam run cu strategiile dinamice și multi-turn, eventual reîmprospătezi setul de pe PR, și garak pe modelul de bază, cu sondele alese prin --spec. Rezultatele se compară cu rularea de referință; o creștere a ratei de atacuri reușite pe o categorie deschide un tichet, nu blochează pe nimeni la 3 dimineața.
Treapta 3, înainte de release: campanie și oameni. PyRIT pe obiective de business, pe staging, plus o sesiune manuală concentrată pe ce e nou: o unealtă adăugată, memoria pe termen lung, alt model. Rezultatul este un raport cu dovezi și o decizie de lansare.
Bucla care face totul să merite: orice atac reușit, din orice treaptă, devine test în setul de pe PR. Așa o vulnerabilitate reparată nu se mai întoarce.
Praguri, rezultate nedeterministe și costul în apeluri de model
Pragul nu e zero. Același atac poate reuși într-o rulare și eșua în următoarea. Un prag de „zero atacuri reușite” pe un eșantion mic e fie mereu roșu, fie o falsă liniște. Ce funcționează:
- pragul se stabilește înainte de rulare, pe categorie, nu după ce vezi rezultatul;
- pentru Promptfoo,
PROMPTFOO_PASS_RATE_THRESHOLDcoboară pragul implicit de 100%, dar e global: categoriile critice, de exemplu scurgerea de date între clienți, merită o configurație separată, cu toleranță zero; - repetările (
--repeatla Promptfoo,--generationsla garak) transformă un da sau nu într-o rată; - compari cu ultima rulare bună, nu cu o valoare absolută; intervalele de încredere din garak ajută să nu reacționezi la zgomot.
Judecătorul greșește și el. Un evaluator LLM marchează uneori ca reușit un refuz politicos care citează cererea și ratează uneori un răspuns periculos formulat elegant. Fixează modelul judecător (redteam.provider sau --grader la Promptfoo), notează-i versiunea lângă rezultate și calibrează-l: etichetezi manual câteva zeci de răspunsuri și verifici cât de des e de acord cu tine. La garak, detectorii bazați pe reguli și clasificatori au propriile fals pozitive; înainte să blochezi un merge pe o sondă, citește câteva hituri din JSONL. Calibrarea unui judecător LLM, pragurile și flakiness-ul în CI sunt tratate pe larg în cursul AI Evals pentru LLM-uri în producție, care are și un modul dedicat Promptfoo, cu red teaming și quality gate în CI.
Costul se numără în apeluri. Fiecare test înseamnă cel puțin un apel la țintă și, de obicei, unul la judecător; strategiile dinamice adaugă apeluri la atacator, iar cele multi-turn le multiplică cu numărul de mesaje. Documentația Promptfoo notează explicit că strategiile multi-turn consumă mai multe resurse și urmăresc separat tokenii țintei, ai atacatorului și ai evaluării.
Un calcul ilustrativ, pe configurația de mai sus: 4 plugin-uri × 5 teste = 20 de cazuri de bază; cu strategiile basic și base64, circa 40 de cazuri; cu --repeat 3, circa 120 de apeluri la țintă și până la tot atâtea la judecător, pe fiecare PR care atinge promptul. Înmulțește cu prețul pe token al modelului tău și cu numărul de PR-uri pe lună înainte să extinzi setul. Treapta de noapte, cu strategii dinamice și multi-turn, costă mult mai mult pe rulare: bugeteaz-o separat.
Capcane frecvente
- Date de test sensibile. Nu pune date reale de clienți în prompturi, în
purposesau în documentele unui RAG atacat. Folosește date sintetice și tratează rapoartele ca pe niște documente interne: conțin conversații complete. - Conținut ofensator în loguri. Documentația Promptfoo avertizează că testarea adversarială produce intrări ofensatoare, toxice și dăunătoare și poate face sistemul să producă ieșiri dăunătoare. Ține rulările pe staging, cu loguri separate de producție, și spune echipei ce urmează să vadă.
- Servicii terțe atinse de agent. Un agent atacat cu succes poate trimite emailuri, apela API-uri sau scrie în baze de date. În mediul de test, uneltele lui merg spre servicii simulate, nu spre sistemele reale ale altcuiva.
- Autorizarea. Testezi doar sisteme pe care le deții sau pentru care ai acordul scris al proprietarului, cu perimetrul definit. Când ținta e un model al unui furnizor, citește și termenii acestuia: trimiți în mod intenționat cereri care încalcă politicile de utilizare. Cerința de autorizare explicită și responsible disclosure sunt discutate în lecția „Red Teaming Practic” din cursul AI Security și Ethical Engineering.
- Raportul tratat ca verdict. O rată mică de atacuri reușite pe un set cunoscut spune că setul cunoscut e acoperit, nu că sistemul e sigur.
Întrebări frecvente
Ce este red teaming-ul pentru LLM? Este testarea adversarială a unui model, a unei aplicații sau a unui agent bazat pe LLM: încerci deliberat jailbreak-uri, prompt injection, extragerea promptului de sistem sau a datelor și abuzul uneltelor, ca să afli ce trece înainte s-o afle un atacator. Uneltele automatizează volumul și regresia, iar testarea manuală acoperă atacurile noi.
Promptfoo vs garak: care e diferența? Promptfoo e construit în jurul aplicației: o descrii în YAML, alegi plugin-uri pe tip de risc și strategii de livrare, iar codul de ieșire se leagă direct de CI. garak e un scanner orientat pe model, cu familii de sonde și detectori, util când alegi sau schimbi modelul. Cele două se completează: garak pe model, Promptfoo pe aplicația construită peste el.
garak vs PyRIT: pe care îl aleg? garak, când vrei o scanare largă și rapidă a unui model pe familii cunoscute de atac. PyRIT, când testezi un agent sau o aplicație conversațională și ai nevoie de atacuri multi-turn, scoreri proprii și istoric complet al conversațiilor. PyRIT cere mai mult cod, dar modelează mai bine atacurile care se construiesc în timp.
Pot rula red teaming automat la fiecare pull request? Da, dacă setul e mic și fix. Generezi atacurile o dată, versionezi fișierul și rulezi aceleași cazuri pe fiecare PR care atinge promptul, uneltele sau modelul, cu câteva repetări și un prag stabilit dinainte. Scanările largi și campaniile multi-turn rămân pentru noapte și pentru release.
Promptfoo mai este open source după anunțul OpenAI? La 26 octombrie 2026, depozitul Promptfoo de pe GitHub are licența MIT, iar anunțul din 9 martie 2026 spune că proiectul rămâne open source și continuă să suporte mai mulți furnizori de modele. Anunțul precizează că finalizarea achiziției depinde de condițiile obișnuite de închidere.
Concluzie
Red teaming-ul automat pentru LLM nu se rezumă la o singură unealtă. Promptfoo se potrivește aplicației și porții din CI, garak modelului de sub ea, iar PyRIT agentului și atacurilor care se întind pe mai multe mesaje. Pipeline-ul care ține în timp are trei trepte: un set fix și ieftin pe fiecare PR, un scan larg noaptea și o campanie cu oameni înainte de release, legate prin regula că orice atac reușit devine test de regresie. Pragurile se stabilesc dinainte, pe repetări, judecătorul se calibrează, costul se numără în apeluri, iar testele rulează doar pe sisteme pe care ai dreptul să le ataci.
Verificat la 26 octombrie 2026 pe depozitele GitHub promptfoo/promptfoo, NVIDIA/garak, microsoft/PyRIT și confident-ai/deepteam (licențe și versiuni prin API-ul GitHub), pe documentația Promptfoo (red team quickstart, configuration, strategies, command line, CI/CD), pe anunțul Promptfoo din 9 martie 2026, pe README-ul garak și referința CLI de la reference.garak.ai, pe documentația PyRIT 1.1.0 și pe anunțul Microsoft din 22 februarie 2024. Comenzile și opțiunile se schimbă între versiuni: verifică documentația versiunii pe care o fixezi în CI.

Cursul care continuă acest articol
OpenClaw: Securizarea Agenților AI Open-Source în Producție 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente — Securizarea Agenților AI Open-Source
- OpenClaw — Arhitectură și Hardening
- Plugin și Supply Chain Security
- Runtime Defenses
+ încă 6 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.