GPT-6.2 înseamnă două modele lansate de OpenAI la 17 noiembrie 2026: GPT-6.2 Astra, pentru proiectele grele, și GPT-6.2 Sol, pentru munca de zi cu zi. Pe scurt: în API, Astra costă cu 20 % mai puțin pe token decât GPT-6 Astra (cu 60 % mai puțin la intrarea din cache), Sol păstrează prețul lui GPT-6.1 Sol, iar amândouă rulează în ChatGPT Work, în Codex și în API, nu în Chat-ul obișnuit. Mai jos: planurile, prețul, ce s-a îmbunătățit și ce schimbi în prompturi, verificate la 18 noiembrie 2026.
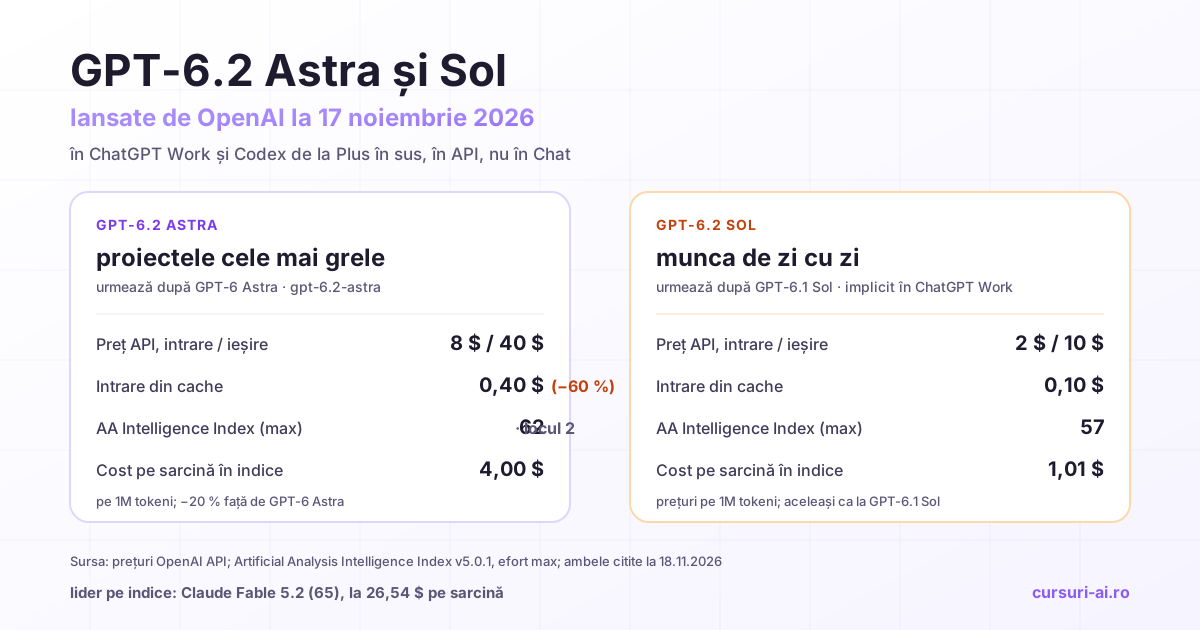
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| Rolul, după OpenAI | proiectele cele mai grele | munca de zi cu zi |
| Identificator în API | gpt-6.2-astra |
gpt-6.2-sol |
| Urmează după | GPT-6 Astra | GPT-6.1 Sol |
| Preț API, intrare / ieșire (1M tokeni) | 8 $ / 40 $ | 2 $ / 10 $ |
| Artificial Analysis Intelligence Index (max) | 62 | 57 |
| În ChatGPT | Work și Codex, de la Plus în sus | la fel; implicit în Work |
Ce a lansat OpenAI la 17 noiembrie 2026
Anunțul OpenAI prezintă GPT-6.2 Astra drept „noul model de frontieră pentru cele mai grele proiecte” și GPT-6.2 Sol drept „modelul eficient și versatil pentru munca de zi cu zi” (traducerea noastră). Promisiunea comună: rezultate mai bune pe sarcini dificile, cu mai puțini tokeni de ieșire.
Predecesorii sunt GPT-6 Astra, lansat în septembrie 2026, și GPT-6.1 Sol, lansat la 29 septembrie. Nu a existat un GPT-6.1 Astra public: Astra sare de la 6 la 6.2. Ce aducea GPT-6.1 Sol găsești în analiza lansării GPT-6.1 Sol. În API, pagina de modele OpenAI recomandă acum GPT-6.2 Astra ca punct de pornire, Sol pentru echilibru între inteligență și cost și GPT-6 Luna pentru volum mare.
Primul lucru de știut dacă ai prompturi vechi. Ghidul OpenAI pentru GPT-6.2 spune că Astra scrie implicit mai concis și mai direct, iar când intenția nu e clară poate propune pasul următor și aștepta confirmarea. Un prompt vechi, cu „fii concis” repetat și fără reguli despre când să continue singur, poate da acum răspunsuri prea seci și sarcini oprite la jumătate. Ghidul cere revizuirea a patru zone: stilul, autonomia pe sarcini lungi, convențiile de cod și cerințele vizuale la frontend. E exact metoda din Prompt Engineering Masterclass: anatomia promptului, instrucțiunile pentru agenți și testul pe un set propriu de cazuri înainte de a schimba modelul. Cursul a fost scris înainte de GPT-6.2, dar metoda e aceeași; ajustările pentru 6.2 sunt mai jos.
Unde găsești GPT-6.2: ChatGPT Work și Codex, nu Chat
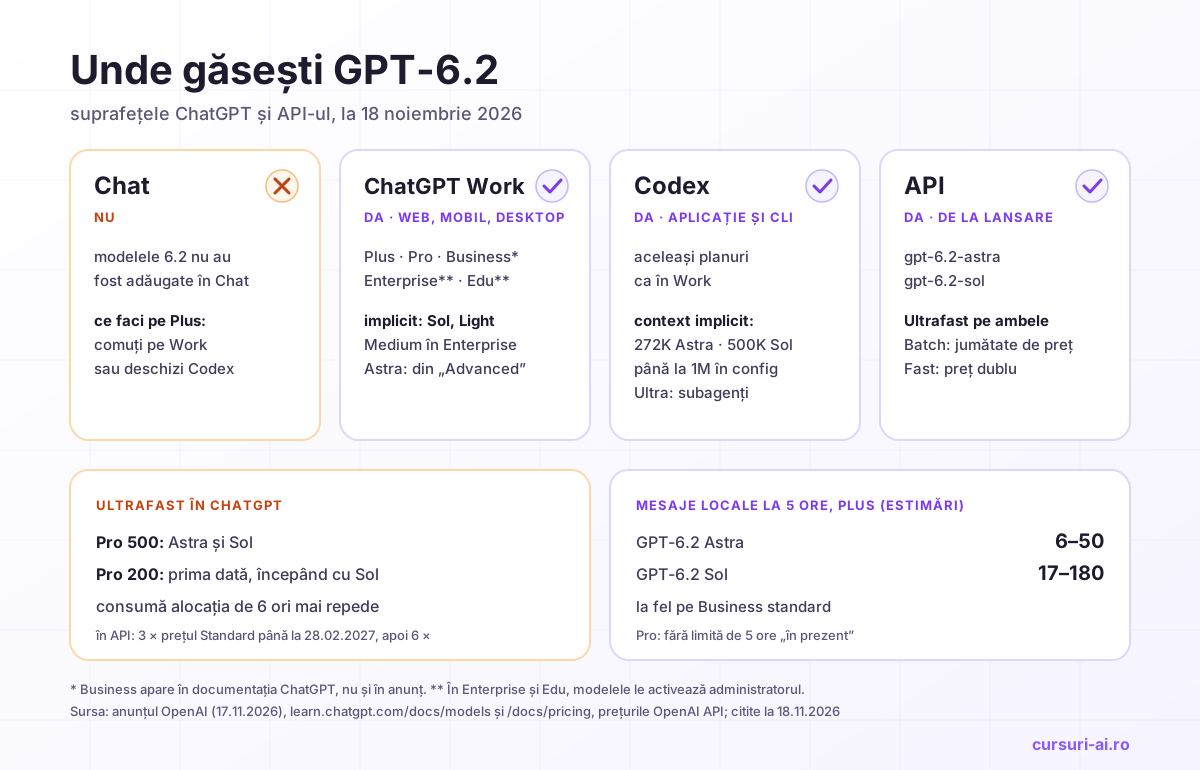
Dacă ai Plus și deschizi Chat, nu le vei vedea. Lansarea aduce modelele în ChatGPT Work și în Codex. Anunțul nu pomenește Chat-ul obișnuit, documentația trimite pentru Chat la centrul de ajutor, iar centrul de ajutor OpenAI, citat pe forumul oficial, spune că modelele 6.2 nu au fost adăugate acolo, ca și GPT-6.1 Sol. Practic, comuți pe Work sau deschizi Codex. Ce face Work și cum îi scrii un brief e în ghidul practic ChatGPT Work.
Planurile. Anunțul spune „toți utilizatorii Plus, Pro, Enterprise și Edu”. Documentația de prețuri ChatGPT adaugă Business, în Work pe web, mobil și desktop și în aplicația și CLI-ul Codex. Pe Business, selectorul din contul tău decide. Planul fără plată și Go nu apar în nicio listă. În Enterprise și Edu, modelele sunt oprite implicit până le activează administratorul din setările de modele ale spațiului de lucru.
Modelul implicit. În Work, conversațiile noi pornesc cu GPT-6.2 Sol la efortul Light pe planurile de consum și la Medium în spațiile Enterprise care l-au activat. Glisorul Power duce spre „Smarter” sau „Faster”, iar din „Advanced” alegi explicit Astra și efortul.
Ultrafast. Pro 500 îl are pe ambele modele; Pro 200 îl primește pentru prima dată, începând cu Sol; în API e disponibil pe ambele de la lansare. Viteza se plătește din alocație: Ultrafast o consumă de 6 ori mai repede decât viteza standard, iar Fast de 2 ori pe modelele 6.2 (față de 2,5 ori pe GPT-6.1 Sol și GPT-6 Astra).
Câte mesaje primești. Documentația estimează mesajele locale pe fereastră de cinci ore, identic pe Plus și pe Business standard:
| Model | Mesaje locale la 5 ore |
|---|---|
| GPT-6.2 Astra | 6–50 |
| GPT-6.2 Sol | 17–180 |
| GPT-6 Astra | 5–45 |
| GPT-6.1 Sol | 15–160 |
Un „mesaj” poate fi o întrebare de un rând sau o sarcină de o oră, de aici intervalul larg. La capătul de jos, șase sarcini grele cu Astra pot consuma fereastra. Pe Plus, regula practică: Sol pentru munca curentă, Astra pentru cele două-trei livrabile pe zi care o cer. Plafonul crește puțin față de generația anterioară, iar Pro nu are „în prezent” limită de cinci ore.
În Codex, contextul implicit e de 272.000 de tokeni la Astra și de 500.000 la Sol, extensibil până la un milion cu model_context_window în config.toml. Modelul se alege cu codex --model gpt-6.2-astra, iar modul Ultra pornește singur subagenți pentru sarcini mari. Comparația cu Claude Code și Antigravity e în GPT-6.2 pentru programatori.
GPT-6.2 preț în API: tabelul și un calcul
Prețurile standard, pentru cereri de până la 272.000 de tokeni de intrare, din pagina de prețuri a API-ului, la 18 noiembrie 2026:
| $ pe 1M tokeni | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Intrare | 8 $ | 10 $ | 2 $ |
| Intrare citită din cache | 0,40 $ | 1,00 $ | 0,10 $ |
| Scriere în cache (30 de minute) | 10 $ | 12,50 $ | 2,50 $ |
| Ieșire (inclusiv raționamentul) | 40 $ | 50 $ | 10 $ |
- Peste 272.000 de tokeni de intrare, intrarea și cache-ul se dublează, iar ieșirea costă de 1,5 ori mai mult, pentru toată cererea.
- Batch costă jumătate, Fast dublu, Ultrafast de 3 ori Standard până la 28 februarie 2027 și de 6 ori din 1 martie 2027.
- Ferestrele de finalizare în fundal din Responses API (beta publică) dau −30 % la două ore și −40 % la opt ore.
Fișa tehnică e aceeași la ambele: context de 1.050.000 de tokeni, cel mult 922.000 la intrare și 128.000 la ieșire, intrare text și imagine, ieșire text. Diferă doar data limită a cunoștințelor: 18 mai 2026 la Astra, 1 iunie 2026 la Sol.
Un exemplu de cost, pe o sarcină ilustrativă
Ipoteza noastră: o cerere cu 50.000 de tokeni de intrare și 5.000 de ieșire, cu tot cu raționamentul. La Astra 6.2, fără cache: 50.000 ÷ 1.000.000 × 8 $ = 0,40 $, plus 5.000 ÷ 1.000.000 × 40 $ = 0,20 $.
| Scenariu | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Fără cache | 0,40 + 0,20 = 0,60 $ | 0,50 + 0,25 = 0,75 $ | 0,10 + 0,05 = 0,15 $ |
| 40.000 de tokeni citiți din cache | 0,016 + 0,08 + 0,20 = 0,296 $ | 0,04 + 0,10 + 0,25 = 0,39 $ | 0,004 + 0,02 + 0,05 = 0,074 $ |
Fără cache, diferența față de GPT-6 Astra e de 20 %, exact reducerea de preț; cu cache urcă la 24 %. Scenariul presupune că prefixul a fost scris în cache de o cerere anterioară, scriere care costă o dată 0,40 $ la Astra 6.2. Al treilea factor e numărul de tokeni: pe benchmark-ul intern GDPval v2, OpenAI raportează cu 22 % mai puțini tokeni de ieșire. Dacă proporția s-ar confirma pe sarcina ta, ieșirea ar scădea la 3.900 de tokeni, iar cererea fără cache ar costa 0,556 $, cu 26 % sub GPT-6 Astra. E o cifră internă, deci o măsori înainte să o pui în buget.
Pe listă, Astra 6.2 costă cât Claude Fable 5.2 (8 $ / 40 $); diferența reală vine din tokenii pe sarcină.
Ce s-a îmbunătățit: exemplele din anunț
Cifrele din această secțiune sunt raportate de OpenAI, pe configurațiile lui de test, cu efortul în paranteză și costul pe sarcină din graficele anunțului.
Slide-uri după șablon. OpenAI numește Astra 6.2 cel mai bun model al său la slide-uri și la respectat un șablon, primit ca fișier sau doar ca captură de ecran: preia aranjarea, culorile și tipografia până la mărimea exactă a fontului și stilul de scriere al șablonului.
Workbook-uri și memo-uri. Pe AA-AnalystAgent, un test al Artificial Analysis pe foi de calcul și rapoarte reale (de exemplu, cât a cheltuit programul Medicaid din California pe transport medical), Astra 6.2 răspunde corect, potrivit OpenAI, la 62,5 % dintre întrebări în toate cele cinci încercări independente, un nou maxim.
Documente după convențiile domeniului. Pe Harvey LAB-AA v1.1, un test juridic care dă punctaj doar dacă livrabilul îndeplinește toate criteriile și nu conține halucinații materiale, Astra 6.2 are 15,0 % (Max, 6,35 $), față de 8,6 % la GPT-6 Astra și 7,2 % la Claude Fable 5.2 (Max, 39,84 $). „Mai mult decât dublu față de Fable, la o șesime din cost” e corect aritmetic, dar procentele absolute sunt mici: și la cel mai bun model, 85 % dintre livrabile au ratat un criteriu sau au conținut o halucinație materială. Orice document juridic generat rămâne un draft de verificat integral. Pe GDPval v2, intern, Astra 6.2 are 50,4 % (Max), cu 6,2 puncte peste GPT-6 Astra, folosind 35.812 tokeni de ieșire în loc de 45.732, cu 22 % mai puțini; Sol 6.2 urcă de la 41,5 % la 46,9 %. Testul e intern, deci nereplicabil.
Computer use în CAD și simulare. Anunțul descrie un computer use care coboară la piese și conexiuni individuale. Exemplul: modelul 3D al unei mașini pe un drum de munte, cu un solver Python pentru dinamica pneuri-suspensie, animat în Blender. Pe BenchCAD 2.1 Core, Astra 6.2 are 82,5 % (Max), față de 62,6 % la GPT-6 Astra; pe același grafic, Fable 5.2 (Max) are 83,5 %, dar la 50,77 $ pe sarcină, față de 5,43 $. Pe AutomationBench 1.0.6, Astra 6.2 are 52,4 %, față de 41,4 %, iar vârful graficului e Gemini 4 Carbon (High), cu 53,9 %. Cum construiești un agent care lucrează pe ecran și unde îi pui puncte de oprire e tema cursului Computer Use și Browser Agents.
Web și 3D. Ambele modele transformă o descriere scrisă într-o experiență interactivă în browser, de la o masă de pinball la o reconstituire a Colosseumului. Pe AA-3D, unde oameni care nu știu ce model a lucrat votează între două rezultate, Astra 6.2 e primul cu 1.318 Elo, urmat de Fable 5.2 (1.271) și de Sol 6.2 (1.259).
Cod mai curat, mai puțini tokeni. OpenAI spune că Astra alege mai bine uneltele și efortul, inclusiv plugin în loc de computer use, iar testerii au raportat cod mai curat și mai puține runde de revizie. Două mărturii din anunț: Niko Grupen (Harvey) spune că Astra 6.2 a finalizat „de peste 3 ori mai multe sarcini” din Legal Agent Benchmark decât GPT-6 Astra, cu 34,5 % mai puțini tokeni de ieșire; Jay Hack (ClickUp), că în teste oarbe a depășit la limită modelul lor din producție, cu circa 40 % mai puțini tokeni și 30 % mai puține runde de revizie.
| Evaluare (raportat de OpenAI) | GPT-6.2 Astra | GPT-6 Astra | GPT-6.2 Sol | Vârful graficului |
|---|---|---|---|---|
| Agents' Last Exam v1.1 | 78,3 % (Xhigh, 2,89 $) | 73,1 % (Max, 8,99 $) | 73,0 % (Max, 1,32 $) | Astra 6.2 |
| Terminal-Bench-Science 0.1 | 77,1 % (Max, 7,15 $) | 68,1 % (Max, 23,80 $) | 68,0 % (Max, 2,21 $) | Astra 6.2 |
| FrontierCode 2.0 | 44,2 % (Max, 5,97 $) | 42,8 % (Max, 6,68 $) | 43,8 % (Max, 1,29 $) | Fable 5.2, 49,1 % (Xhigh) |
| LifeVal (sarcini de zi cu zi) | 86,1 % (Max, 4,23 $) | 79,8 % (Max, 9,04 $) | 83,8 % (Max, 1,27 $) | Astra 6.2 (doar modele OpenAI) |
Pe FrontierCode, Sol 6.2 vine la 0,5 puncte de Astra la circa o cincime din cost; pe LifeVal, depășește GPT-6 Astra la circa o șeptime din cost.
Ce spun măsurătorile independente
Sursele independente, la 18 noiembrie 2026:
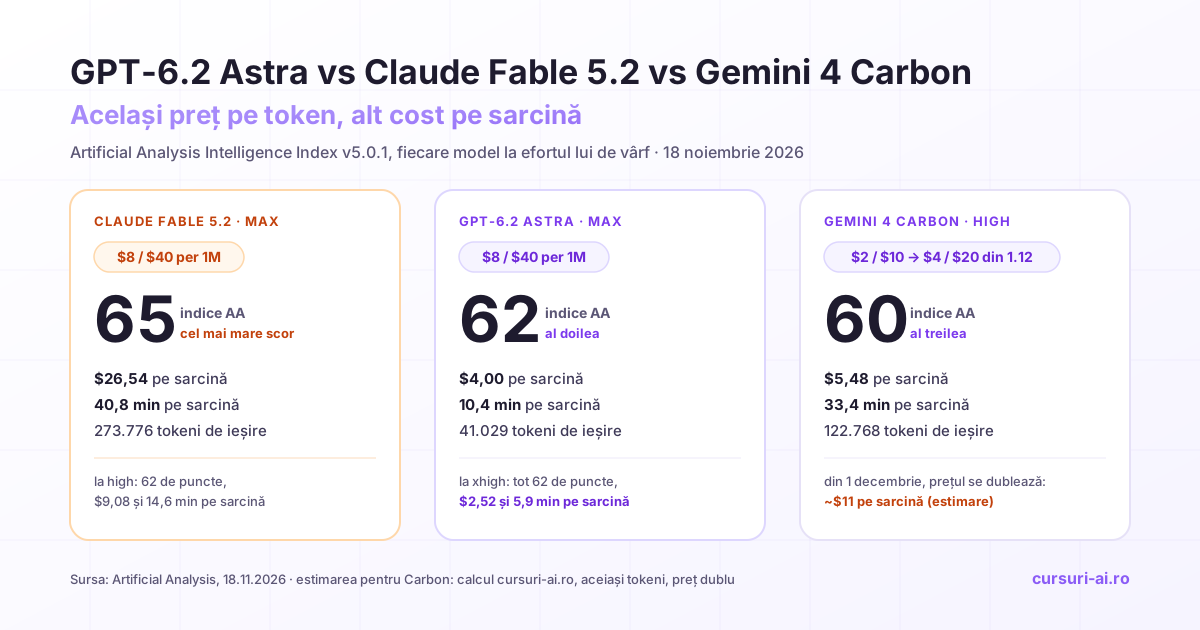
- Artificial Analysis Intelligence Index v5.0.1, nouă evaluări de muncă cu cunoștințe, cod și știință: Claude Fable 5.2 (max) 65, Astra 6.2 (max) 62, Gemini 4 Carbon (high) 60, Sol 6.2 (max) 57. Astra e al doilea. Potrivit The Decoder, Astra câștigă 5 puncte față de GPT-6 Astra, Sol 2 față de GPT-6.1 Sol, iar Sol egalează GPT-6 Astra la circa 15 % din costul pe sarcină.
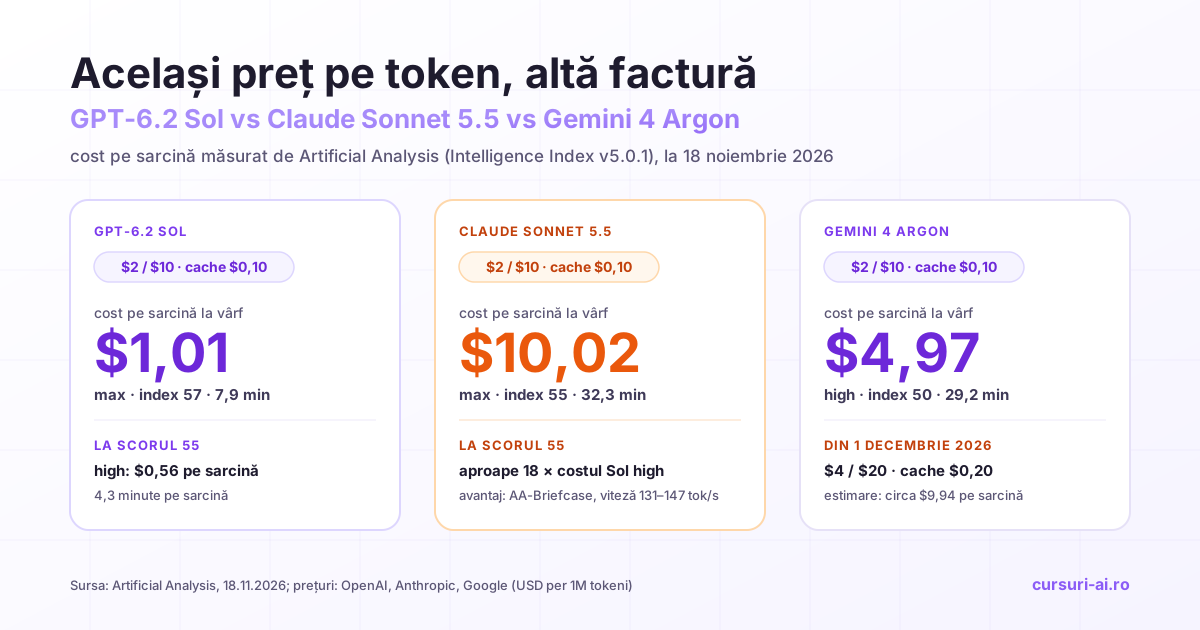
- Costul pe sarcină în indice, la max: 4,00 $ la Astra 6.2, 26,54 $ la Fable 5.2, 1,01 $ la Sol 6.2.
- Coding Agent Index (AA, harness Codex, max): Astra 6.2 neschimbat față de GPT-6 Astra; Sol 6.2 cu 3 puncte sub GPT-6.1 Sol, după o cădere de 14 puncte pe SWE-Atlas-QnA-AA.
- Rata de halucinație pe AA-Omniscience, întrebări neobișnuit de grele, la max: 59 % la Astra, 55 % la Sol. Verificarea factuală rămâne obligatorie.
- Epoch AI: Astra are 174 pe Epoch Capabilities Index, la egalitate cu Fable 5.2, dar pe sarcinile de cercetare reale e sub Fable și „abia îmbunătățit” față de GPT-6 Astra.
- Vals AI: Astra locul 7, Sol locul 9, Fable 5.2 primul. Cost pe sarcină: 10,68 $ la Astra, 3,18 $ la Sol (cel mai mic din primele zece), 21,28 $ la GPT-6 Astra. Ambele fac de aproape două ori mai multe apeluri de unelte și scriu răspunsuri mai scurte.
- Ethan Mollick, citat de TestingCatalog: Astra e „foarte inegal și ciudat”, mai greu de condus, dar i-a livrat un proiect ambițios.
Sursele confirmă eficiența (după AA, modelele OpenAI ocupă cea mai mare parte a frontierei cost-performanță), dar nu că Astra e cel mai bun model în general, nici progresul la agenții de cod.
GPT-6.2 față de concurență, dintr-o privire
| Model (efort) | AA Intelligence Index | Preț API, intrare / ieșire (1M tokeni) | Cost pe sarcină |
|---|---|---|---|
| Claude Fable 5.2 (max) | 65 | 8 $ / 40 $ | 26,54 $ |
| GPT-6.2 Astra (max) | 62 | 8 $ / 40 $ | 4,00 $ |
| Gemini 4 Carbon (high) | 60 | 2 $ / 10 $, din 1.12.2026 4 $ / 20 $ | 5,48 $ |
| GPT-6.2 Sol (max) | 57 | 2 $ / 10 $ | 1,01 $ |
Scorurile și costul pe sarcină: Artificial Analysis, la 18 noiembrie 2026; costul lui Carbon e la prețul introductiv. Unde câștigă fiecare model de vârf pe domenii și cât durează o sarcină: GPT-6.2 Astra vs Claude Fable 5.2 vs Gemini 4 Carbon. Sol față de Sonnet 5.5 și Argon, la același preț, și când trimiți o sarcină de la Sol la Astra: GPT-6.2 Sol vs Sonnet 5.5 vs Argon. Metoda de alegere pe criterii, valabilă la orice versiune nouă, e predată în Comparație Modele AI.
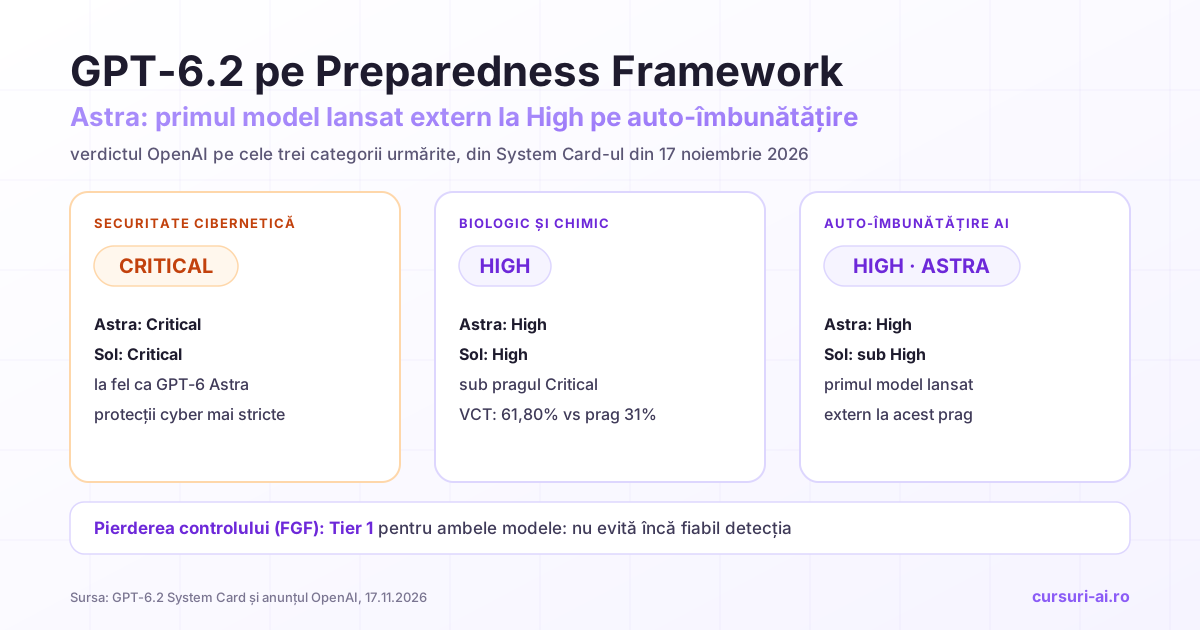
Siguranța are articol separat: Astra 6.2 e primul model OpenAI lansat extern cu pragul „High” la auto-îmbunătățirea AI, explicat în GPT-6.2 Astra și pragul High. Migrarea tehnică în API e în articolul pentru programatori.
Cum îți schimbi prompturile pentru GPT-6.2
Ajustările pornesc din bunele practici ale ghidului OpenAI pentru GPT-6.2 și din ghidul de prompting pentru Codex. Exemplele sunt adaptarea noastră în română după ghidul OpenAI, nu traduceri cuvânt cu cuvânt.
1. Scoate „fii concis” și spune pentru cine scrie. Astra scrie deja scurt; o insistență în plus poate tăia contextul de care cititorul are nevoie.
Folosește termenii utilizatorului și ai surselor. Păstrează detaliile tehnice când fac explicația mai precisă. Spune întâi esențialul și dă destul context încât cititorul să-ți urmărească raționamentul. Când scrii pentru cineva din afara echipei, pornește de la ideea că nu știe ce știm noi.
2. Spune ce decizii îți aparțin și lasă-l să continue în rest. Fără asta, o sarcină lungă poate rămâne oprită la o întrebare.
Continuă până termini. Dacă un detaliu e neclar, alege o variantă rezonabilă și reversibilă, notează ce ai presupus și mergi mai departe. Te oprești doar dacă se schimbă scopul, dacă ești blocat concret sau înainte de orice acțiune ireversibilă: ștergeri, trimiteri, plăți.
3. Cere un răspuns final care se citește singur. Pe sarcini lungi, modelul poate duce în final prescurtările din pașii intermediari.
Răspunsul final e prima privire a cititorului asupra muncii tale. Scrie-l de la zero, fără jargonul din pașii intermediari, ca să poată fi înțeles fără actualizările de progres.
4. Descrie convențiile codului. Codul e mai eficient, dar regulile casei nu le ghicește.
Refolosește clasele, metodele și API-urile existente cât timp rămân corecte. Nu schimba comportamentul pe care se bazează apelanții. Scrie teste noi doar la cerere, dacă proiectul o impune sau dacă prind o regresie nevăzută de testele existente. Codul trebuie să se citească ușor: fără nume prescurtate, fără expresii comprimate pe un rând, fără abstracții inutile.
5. La frontend, numește imaginile și tipografia. Ghidul pentru Codex adaugă: dă o referință vizuală și spune după ce vei judeca rezultatul.
Folosește fotografii realiste, nu ilustrații, și fontul Inter, cu titluri la greutate 700. Pune text doar unde ajută utilizatorul să înțeleagă sau să acționeze. Verifică rezultatul la mărimea reală: iconițele trebuie să se recunoască la 24 de pixeli.
În API mai e o regulă nouă: dacă modifici istoricul conversației la mijloc, API-ul renunță la raționamentul acumulat și calitatea scade, așa că OpenAI recomandă să păstrezi începutul neschimbat și să adaugi instrucțiunile noi la final. Verificarea: același set de 10–20 de sarcini reale, cu promptul vechi și cu cel nou.
Merită să treci la GPT-6.2?
Utilizator Plus. Da, iar dacă lucrezi în Work, trecerea e făcută: Sol 6.2 e implicit. Alege Astra manual pentru livrabilele grele și urmărește alocația. Dacă folosești doar Chat, deocamdată nu se schimbă nimic.
Firmă pe Business sau Enterprise. Pe Business, verifică selectorul din Work. Pe Enterprise și Edu, adminul activează modelele explicit: e momentul pentru un test cu trei-patru livrabile reale, comparate orb cu cele de pe modelele actuale, înainte de activarea pentru toată echipa.
Developer pe API cu GPT-6 Astra. Aproape sigur da: tarif cu 20 % mai mic, cache cu 60 % mai mic, scoruri raportate în creștere. Rezerve: revizuiești prompturile, iar la agenți de cod măsori pe sarcinile tale, pentru că Coding Agent Index nu arată progres.
Developer pe API cu GPT-6.1 Sol. Același preț, +2 puncte pe indicele AA, +5,3 puncte pe GDPval v2 (raportat de OpenAI). Pentru agenți de cod, scăderea de 3 puncte pe Coding Agent Index cere un test pe setul tău înainte de schimbare.
Întrebări frecvente
Ce este GPT-6.2 și când a fost lansat?
Este familia de modele lansată de OpenAI la 17 noiembrie 2026: GPT-6.2 Astra (gpt-6.2-astra), pentru proiectele grele, și GPT-6.2 Sol (gpt-6.2-sol), pentru munca de zi cu zi. Le urmează pe GPT-6 Astra și GPT-6.1 Sol.
Pot folosi GPT-6.2 în ChatGPT Plus? Da, în ChatGPT Work și în Codex, nu în Chat. Documentația estimează pe Plus 6–50 de mesaje locale la cinci ore cu Astra și 17–180 cu Sol. În Enterprise și Edu, le activează adminul.
Cât costă GPT-6.2 în API? Astra: 8 $ pe milion de tokeni de intrare, 0,40 $ din cache, 40 $ la ieșire. Sol: 2 $, 0,10 $ și 10 $. Peste 272.000 de tokeni de intrare, tarifele cresc pentru toată cererea.
Care este diferența dintre GPT-6.2 Astra și GPT-6.2 Sol? Astra e modelul de vârf, de patru ori mai scump pe token, pentru sarcinile cele mai grele. Sol e implicit în Work, mai ieftin și mai rapid. Pe indicele Artificial Analysis, Astra are 62 și Sol 57, la 4,00 $, respectiv 1,01 $ pe sarcină.
Este GPT-6.2 Astra cel mai bun model AI? Nu, după măsurătorile independente. Pe Artificial Analysis Intelligence Index, la 18 noiembrie 2026, Astra e al doilea, cu 62, după Claude Fable 5.2, cu 65, dar la un cost pe sarcină de peste șase ori mai mic (4,00 $ față de 26,54 $).
Concluzie
GPT-6.2 e o lansare de eficiență, nu un salt de generație: Astra se ieftinește pe token și consumă mai puțini tokeni, Sol devine mai bun la același preț. Măsurătorile independente confirmă câștigul de cost și pun Astra pe locul al doilea, după Claude Fable 5.2, fără să confirme încă progresul la agenții de cod. Schimbarea se vede în Work și în Codex, de la Plus în sus, iar pentru echipele cu prompturi vechi, munca reală e revizuirea lor.
Verificat la 18 noiembrie 2026 pe sursele citate. Prețurile și clasamentele se schimbă des.

Cursul care continuă acest articol
Prompt Engineering Masterclass
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Bazele Prompt Engineering
- Tehnici Avansate de Prompting
- Prompt Engineering Multi-Modal
- Prompt Engineering pentru Agenți AI
+ încă 6 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.