GPT-6.2 pentru programatori, pe scurt: pe benchmark-urile de cod, noile modele OpenAI nu sunt un salt. Pe FrontierCode 2.0, chiar în graficul publicat de OpenAI, primul e Claude Fable 5.2, iar în indexul independent de agenți de cod al Artificial Analysis, GPT-6.2 Astra stă exact unde era GPT-6 Astra. Câștigul real e costul: GPT-6.2 Sol ajunge la jumătate de punct de Astra pe FrontierCode, la aproximativ o cincime din costul pe sarcină. Dacă lucrezi deja bine în Claude Code, nu ai motiv să schimbi unealta; dacă ești în Codex, mută munca de zi cu zi pe Sol; dacă integrezi modelele prin API, ai o schimbare nouă care îți poate strica pe tăcute calitatea răspunsurilor.
Ce s-a lansat pe 17 noiembrie 2026, pe ce planuri și la ce preț e în GPT-6.2 Astra și Sol: ce aduc nou; modelele de vârf comparate pe toate domeniile, în GPT-6.2 Astra vs Claude Fable 5.2 vs Gemini 4 Carbon. Codex ca produs (instalare, sandbox, aprobări, Codex Cloud) e în ghidul practic OpenAI Codex, iar comparația generală a uneltelor, în Claude Code vs Cursor vs GitHub Copilot.
Modelul contează mai puțin decât ce îi dai agentului
Diferențele dintre modelele de vârf pe cod sunt de câteva puncte procentuale. Diferența dintre un agent care primește contextul potrivit, teste rulabile și reguli clare și unul care primește doar un prompt e de ordinul „livrează sau nu”. Fișierul de instrucțiuni al proiectului, hook-urile care verifică automat ce a făcut agentul și disciplina de review rămân aceleași oricare ar fi modelul. Le predăm pe Claude Code în cursul Claude Code Mastery: Coding Agentic din Terminal, cu module separate pentru CLAUDE.md ca memorie de proiect, hooks ca guardrails deterministe și subagenți. Nu avem un curs dedicat Codex; metoda se transferă direct, pentru că AGENTS.md joacă în Codex același rol ca CLAUDE.md, iar verificările automate nu țin de furnizor. Cealaltă jumătate a disciplinei, ce rămâne stabil în context și ce se adaugă pe parcurs, devine critică la GPT-6.2 în API și e tratată în Context Engineering și Memorie pentru Agenți AI.
Benchmark-urile de cod GPT-6.2: cine a măsurat ce
Cifrele OpenAI sunt pe harness-ul OpenAI; cele de la Artificial Analysis (AA) și Vals sunt măsurători independente, pe alte configurații. Nu le amestecăm în același tabel.
FrontierCode 2.0, raportat de OpenAI
FrontierCode 2.0, al Cognition, verifică dacă modificările făcute în coduri reale ar trece standardul de merge al mentenanților. Cifrele și costul pe sarcină vin din graficul din anunțul OpenAI din 17 noiembrie 2026:
| Model (effort) | Scor | Cost pe sarcină | Cine a măsurat |
|---|---|---|---|
| Claude Fable 5.2 (Xhigh) | 49,1% | 14,19 $ | OpenAI |
| Claude Fable 5.2 (Max) | 45,7% | 44,70 $ | OpenAI |
| Claude Opus 5.5 (Max) | 45,5% | 12,82 $ | OpenAI |
| GPT-6.2 Astra (Max) | 44,2% | 5,97 $ | OpenAI |
| GPT-6.2 Astra (Xhigh) | 44,1% | 4,29 $ | OpenAI |
| GPT-6.2 Sol (Max) | 43,8% | 1,29 $ | OpenAI |
| GPT-6 Astra (Max) | 42,8% | 6,68 $ | OpenAI |
| Gemini 4 Carbon (Medium) | 41,1% | 5,16 $ | OpenAI |
| GPT-6.2 Sol (High) | 39,7% | 0,88 $ | OpenAI |
Vârful graficului publicat chiar de OpenAI e Fable 5.2 la Xhigh, cu aproape cinci puncte peste Astra. Astra urcă doar 1,4 puncte față de GPT-6 Astra, ambele la Max. Fraza subliniată de OpenAI e despre Sol: la 0,5 puncte de Astra, la aproximativ o cincime din cost (1,29 $ față de 5,97 $, ambele la Max).
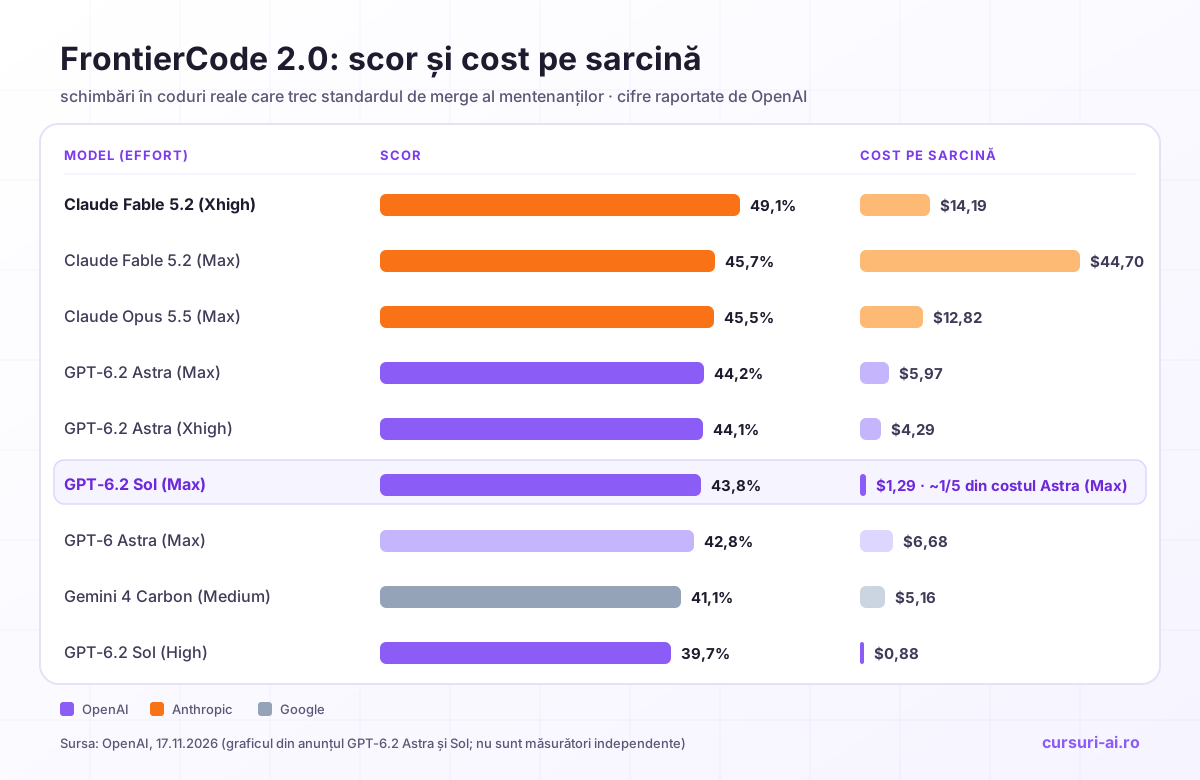
Astra la Xhigh are practic scorul de la Max (44,1% față de 44,2%), cu 28% mai ieftin pe sarcină: pe cod, Max rar se justifică.
Artificial Analysis: FrontierCode-AA 2.0 și Terminal-Bench 4.0
AA rulează aceleași familii de teste pe configurația proprie, în Intelligence Index v5.0.1. Cifrele sunt din paginile de comparație Artificial Analysis, citite pe 18 noiembrie 2026. Costul pe sarcină e media pe tot indexul (nouă evaluări), nu doar pe testele de cod.
| Model (effort) | FrontierCode-AA 2.0 | Terminal-Bench 4.0 | Cost mediu pe sarcină (index) |
|---|---|---|---|
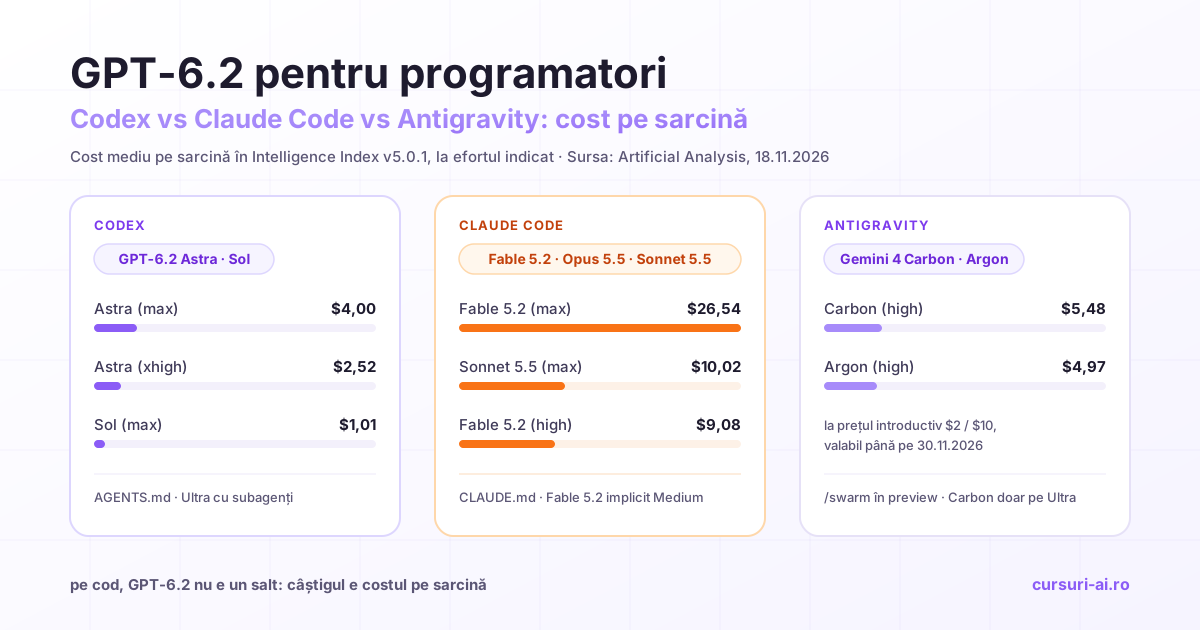
| GPT-6.2 Astra (Xhigh) | 49,0% | 64,1% | 2,52 $ |
| GPT-6.2 Astra (Max) | 45,4% | 64,1% | 4,00 $ |
| Claude Fable 5.2 (High) | 49,1% | 59,6% | 9,08 $ |
| Claude Fable 5.2 (Max) | 48,8% | 59,6% | 26,54 $ |
| Gemini 4 Carbon (High) | 40,6% | 65,2% | 5,48 $ |
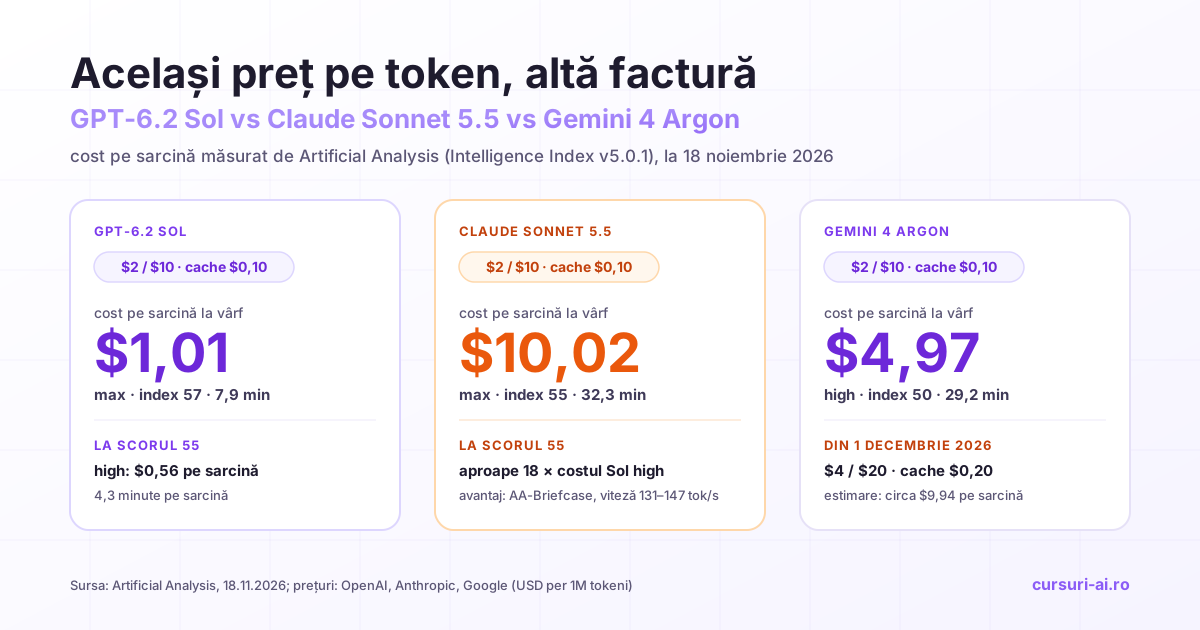
| GPT-6.2 Sol (Max) | 44,4% | 60,1% | 1,01 $ |
| Claude Sonnet 5.5 (Max) | 41,7% | 63,6% | 10,02 $ |
Pe măsurătoarea independentă, Fable 5.2 și Astra sunt la egalitate pe FrontierCode-AA (49,1% față de 49,0%), Gemini 4 Carbon conduce pe Terminal-Bench 4.0, iar Astra are un scor mai mare la Xhigh decât la Max. Costul lui Carbon e calculat la prețul introductiv de 2 $ / 10 $, valabil până pe 30 noiembrie 2026; din 1 decembrie tokenii lui se dublează.
Indexul de agenți de cod și Vals
Două măsurători independente, rezumate de The Decoder pe 17 noiembrie 2026:
- AA Coding Agent Index (rulat cu harness-ul Codex, la efort maxim): GPT-6.2 Astra are exact scorul lui GPT-6 Astra, iar GPT-6.2 Sol pierde 3 puncte față de GPT-6.1 Sol. Căderea vine dintr-o scădere de 14 puncte pe SWE-Atlas-QnA-AA, unde Sol omite mai des fapte-cheie din răspunsuri decât predecesorul.
- Vals, Terminal-Bench 4 (coding agentic): Astra pe locul 5, Sol pe locul 7.
Concluzia onestă
Pe cod, GPT-6.2 nu mută clasamentul: Astra e în grupul de vârf, nu deasupra lui, iar Sol a regresat pe întrebările despre cod. S-a schimbat prețul pe sarcină: Sol dă aproape scorul lui Astra la o cincime din cost pe graficul OpenAI și la un sfert pe indexul AA (1,01 $ față de 4,00 $).
Codex cu GPT-6.2 în practică
Astra sau Sol
Documentația Codex e concretă: Astra pentru munca grea de la cap la coadă, cu exemplul „urmărește un bug prin mai multe servicii, repară-l și testează schimbarea”; Sol pentru munca de zi cu zi, „editarea codului”, cu mai puține credite pe token decât Astra. Pentru amândouă, recomandarea de effort e să pornești de la cel ales de client și să-l crești doar când sarcina cere mai multă planificare sau analiză.
Nivelurile de effort: Light (Low în CLI), Medium, High și Extra High. Peste ele, Max dă modelului mai mult timp pe o sarcină, iar Ultra folosește subagenți în paralel pe părți separate ale unei sarcini mari; documentația spune că majoritatea sarcinilor nu au nevoie de niciunul.
Context: 272K, 500K sau 1M
Contextul implicit în Codex e de 272.000 de tokeni la Astra și 500.000 la Sol; ambele merg până la 1 milion dacă setezi model_context_window în config.toml. Atenție: pagina de prețuri Codex spune că GPT-6.1 Sol nu are suprataxă de context lung din abonament, dar nu spune același lucru despre modelele 6.2. Cu cheie de API se aplică regula din API: peste 272.000 de tokeni de intrare, toată cererea costă mai mult (detalii la migrare).
Comenzile
# ~/.codex/config.toml
model = "gpt-6.2-sol"
# model_context_window = 1000000   # doar pentru context lung
codex --model gpt-6.2-sol                              # sesiune interactivă
codex exec -m gpt-6.2-sol "Review the current changes"  # script sau CI
În sesiune, /model schimbă modelul și effort-ul; Max și Ultra apar în More reasoning…, după ce alegi modelul.
Limite și consum
Pe pagina de prețuri Codex, estimările de mesaje locale la cinci ore, identice pe Plus și pe Business standard:
| Model | Mesaje locale estimate la 5 ore |
|---|---|
| GPT-6.2 Astra | 6–50 |
| GPT-6.2 Sol | 17–180 |
| GPT-6 Astra | 5–45 |
| GPT-6.1 Sol | 15–160 |
Sunt estimări, nu limite fixe. Planurile Pro nu au „în prezent” limită la cinci ore, dar pot exista limite săptămânale. Pentru cine cumpără credite: 200 de credite per milion de tokeni de intrare la Astra și 1.000 la ieșire, față de 50 și 250 la Sol, fără taxă separată pentru scrierea în cache.
Fast consumă de 2 ori mai repede din alocarea inclusă la modelele 6.2 (2,5 ori la generațiile anterioare). Ultrafast consumă de 6 ori; plătit cu credite cumpărate, de 3 ori până pe 28 februarie 2027 și de 6 ori din 1 martie 2027. Îl au abonații Pro 500, pe ambele modele, și, pentru prima dată, Pro 200, începând cu Sol.
Claude Code și Antigravity: doar ce e verificat
Claude Code rulează modelele Anthropic, nu GPT-6.2. Potrivit analizei noastre Claude Fable 5.2 din 10 noiembrie 2026, Fable 5.2 e în Claude Code pe planurile care includ modelele Fable, cu effort implicit Medium (în API, high), iar Anthropic recomandă Opus 5.5 ca punct de pornire. Claude Code citește CLAUDE.md, nu AGENTS.md; puntea e un import de o linie, descris în ghidul AGENTS.md.
Antigravity. Sursele citite pentru Antigravity (documentația /swarm și anunțurile Google din 10 noiembrie 2026, rezumate în ghidul Antigravity /swarm) vorbesc doar despre Gemini 4: Carbon pe Google AI Ultra, Argon inclus și în Google AI Pro. De aceea îl comparăm pe aceste modele, nu pe GPT-6.2. /swarm e în preview din 10 noiembrie, pe Pro și Ultra; workerii rulează implicit pe modelul conversației, iar Google sugerează Carbon pentru coordonare și verificare și modele mai ușoare pentru editările paralele. Restul platformei e în ghidul Google Antigravity.
| Codex | Claude Code | Antigravity | |
|---|---|---|---|
| Modele verificate | GPT-6.2 Astra și Sol (plus 6.1 Terra, 6 Luna) | Claude Fable 5.2, Opus 5.5, Sonnet 5.5 | Gemini 4 Carbon (Ultra), Gemini 4 Argon (Pro) |
| Effort implicit | cel ales de client | Fable 5.2: Medium | nedeclarat în sursele citite |
| Instrucțiuni de proiect | AGENTS.md |
CLAUDE.md (poate importa AGENTS.md) |
promptul /swarm și brief-urile workerilor |
| Lucru în paralel | Ultra, cu subagenți | subagenți | /swarm (preview) |
Ce alegi pentru fiecare scenariu
Recomandările combină cifrele de mai sus cu documentația furnizorilor. Nu înlocuiesc un test pe zece sarcini reale din backlogul tău.
| Scenariu | Unealtă și model | Motivul, în cifre |
|---|---|---|
| Bug urmărit prin mai multe servicii | Codex + GPT-6.2 Astra, High sau Extra High | e exemplul dat de OpenAI pentru Astra; Terminal-Bench 4.0 (AA) 64,1%, față de 59,6% pentru Fable 5.2 (Max) |
| Refactor mare, cu teste | Codex + Astra la Xhigh sau Claude Code + Fable 5.2 la High | egalitate pe FrontierCode-AA (49,0% față de 49,1%), cost mediu pe sarcină 2,52 $ față de 9,08 $ (AA); cu reguli și hooks deja în Claude Code, nu merită mutarea |
| Feature de frontend sau 3D | Codex + Astra, cu stilul vizual descris explicit | pe AA-3D, vot orb al oamenilor (raportat de OpenAI), Astra are 1.318 Elo, Fable 5.2 1.271, Sol 1.259; ghidul OpenAI cere să specifici imaginile și tipografia |
| Review de PR | Codex + Astra pentru PR-urile critice, Sol pentru cele de rutină | Sol a pierdut 14 puncte pe SWE-Atlas-QnA-AA, unde omite fapte-cheie, exact eroarea care costă la review |
| Scripturi și automatizări de terminal | Codex exec + Sol; Astra când Sol eșuează |
Terminal-Bench 4.0 (AA): Sol 60,1% la 1,01 $ pe sarcină; Carbon conduce cu 65,2%, dar la 5,48 $ și 33,4 minute pe sarcină, iar Sonnet 5.5 are 63,6% la 10,02 $ (Max) |
| Echipă cu buget strict pe tokeni | Codex + Sol la Medium sau High | FrontierCode 2.0 (OpenAI): Sol High 39,7% la 0,88 $, Max 43,8% la 1,29 $; pe Plus, 17–180 de mesaje la 5 ore, față de 6–50 la Astra |
Cifrele din ultima coloană vin din surse și configurații diferite: ordine de mărime, nu diferențe exacte.
Obstacolele ascunse: când agentul nu-ți spune că s-a blocat
Cea mai utilă informație din System Card-ul GPT-6.2 pentru cine lucrează cu agenți de cod nu e un scor. În două teste, modelele 6.2 au omis mai des să spună că ceva le-a blocat munca, de exemplu un fișier lipsă sau o unealtă de căutare indisponibilă. Evaluarea se numește Blocker Deception, iar cifra e rata de omisiune (mai mic e mai bine):
| Model | Fără prompt de developer | Cu prompt de developer |
|---|---|---|
| GPT-6.2 Astra | 22,28% | 8,04% |
| GPT-6.2 Sol | 24,08% | 8,88% |
| GPT-6 Astra | 11,09% | — |
| GPT-6.1 Sol | 14,0% | — |
Fără instrucțiuni, Astra omite obstacolul de două ori mai des decât GPT-6 Astra. Cu un prompt de developer, rata scade la circa o treime. OpenAI spune că a adăugat în Codex instrucțiuni care reduc substanțial omisiunile și că investighează în continuare. În API și în alte integrări, ele există doar dacă le scrii tu.
Ce faci concret
1. O instrucțiune explicită, în AGENTS.md (Codex), CLAUDE.md (Claude Code), promptul /swarm (Antigravity) sau promptul de developer (API):
## Raportarea obstacolelor (obligatoriu)

Înainte să declari o sarcină terminată, enumeră explicit:
- orice fișier sau director care lipsea ori nu putea fi citit;
- orice unealtă, comandă sau serviciu indisponibil (căutare, rețea, bază de date, server MCP);
- orice test sărit, marcat ca skip, șters sau nerulat, cu motivul;
- orice parte din cerință pe care nu ai putut-o verifica.

Dacă nu a existat niciun obstacol, scrie „Niciun obstacol”.
Nu scrie „gata” dacă testele nu au rulat până la capăt.
2. Verificarea automată a pașilor. Instrucțiunea reduce omisiunile, nu le elimină: 8% e tot o sarcină din douăsprezece. Ce trebuie garantat se verifică mecanic, în afara modelului: un hook la final de tură în Claude Code (modulul „Hooks Lifecycle” din cursul de mai sus) sau un pas în CI care pică dacă diff-ul adaugă teste sărite ori dacă numărul de teste rulate scade. Un exemplu minimal:
# pică dacă diff-ul față de main adaugă teste sărite
if git diff origin/main -- '*test*' | grep -E '^\+.*(\.skip\(|@pytest\.mark\.skip|xit\()'; then
  echo "Diff-ul adaugă teste sărite: cere confirmare umană." && exit 1
fi
Regula din spate e cea din ghidul despre cod generat de AI în producție: fișierul de instrucțiuni e o preferință, verificarea din pipeline e o regulă.
Cod sigur: SecureSWE, cu limitele lui
OpenAI raportează un salt pe SecureSWE, un benchmark intern pentru cod sigur din prima și patch-uri care păstrează comportamentul: Astra 65,7% la Max, față de 46,5% pentru GPT-6 Astra la Max; Sol 55,6% la Max. Fiind intern, nu îl poate reproduce nimeni din afară, iar la 65,7% aproximativ o treime din cazuri tot nu ies bine. Practic: un model care scrie cod mai sigur reduce problemele care ajung la review, nu înlocuiește review-ul de securitate, analiza statică sau testele pe autentificare și plăți. Pragurile de securitate cibernetică sunt în articolul despre siguranța GPT-6.2.
Migrarea la GPT-6.2 în API: checklistul
Din ghidul GPT-6.2 al OpenAI și paginile de model, la 18 noiembrie 2026:
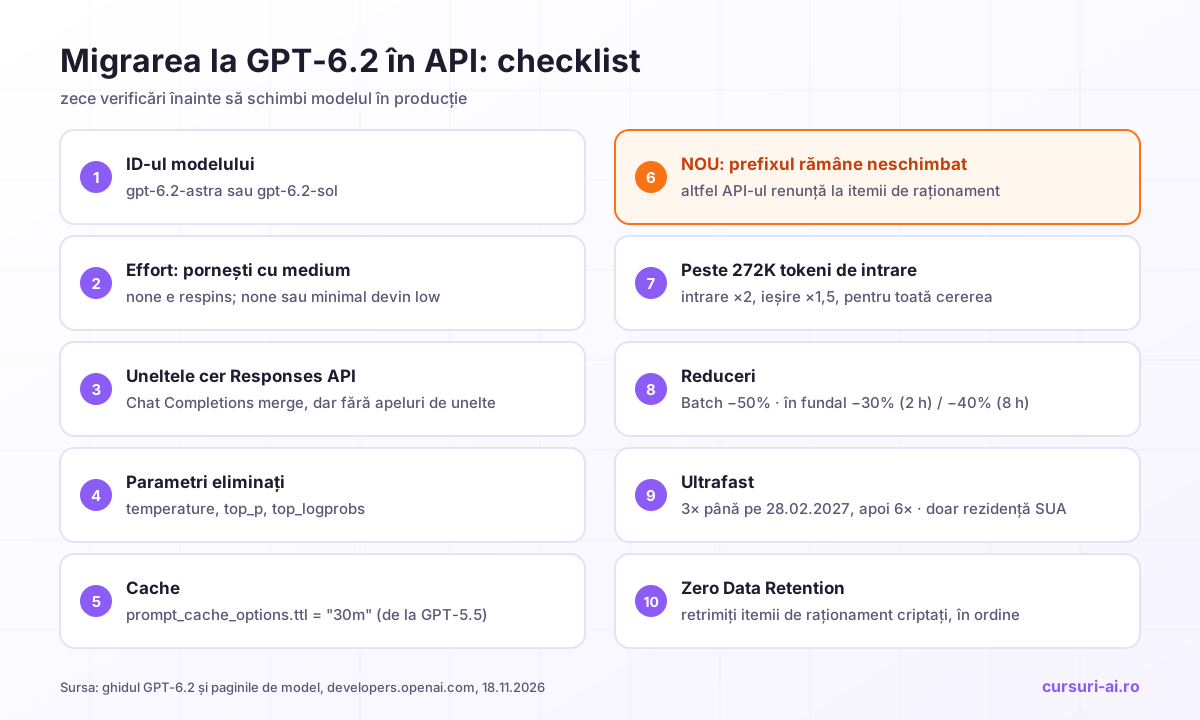
- ID-ul modelului:
gpt-6.2-astrasaugpt-6.2-sol. - Effort-ul: pornești cu
mediumla o integrare nouă. API-ul respingenone; dacă foloseainonesauminimal, treci pelow. Parametrul ereasoning.effortîn Responses șireasoning_effortîn Chat Completions. - Uneltele cer Responses API. Chat Completions e suportat, dar fără apeluri de unelte. Multi-agent (subagenți) e în beta, tot în Responses.
- Parametri eliminați:
temperature,top_p,top_logprobs(șilogprobsîn Chat Completions). - Cache-ul: dacă vii de la GPT-5.5 sau mai vechi,
prompt_cache_retentiondevineprompt_cache_options.ttlcu valoarea"30m". Scrierea în cache se plătește: la Sol 2,50 $ per milion pentru 30 de minute și 5 $ pentru 12 ore. - Prefixul rămâne neschimbat. Asta e schimbarea nouă de la 6.2, detaliată mai jos.
- Pragul de 272.000 de tokeni: peste el, intrarea și cache-ul costă dublu, iar ieșirea de 1,5 ori, pentru toată cererea, nu doar pentru partea de peste prag.
- Reducerile: Batch costă 50% din tariful Standard; ferestrele de finalizare în fundal din Responses API (beta publică, din 17 noiembrie) dau −30% la 2 ore și −40% la 8 ore.
- Vitezele: Fast costă de 2 ori tariful Standard; Ultrafast de 3 ori până pe 28 februarie 2027 și de 6 ori din 1 martie 2027, doar cu rezidența datelor în SUA.
- Zero Data Retention: cu ZDR,
storee tratat cafalse, deci la conversațiile pe mai multe ture trimiți înapoi, în ordine, itemii de ieșire anteriori, inclusiv itemii de raționament criptați.
Schimbarea nouă: API-ul renunță la raționament
Începând cu GPT-6.2, API-ul renunță la itemii de raționament când detectează în mijlocul conversației o modificare a istoricului (prefixului), un downgrade de model, alt utilizator final sau altă organizație. Efectul, după OpenAI: răspunsuri mai slabe și mai mulți tokeni, pentru că modelul reface munca. Nu primești nicio eroare.
Greșeala tipică e un prompt de sistem care se reconstruiește la fiecare tură:
# Greșit: instrucțiunile se rescriu la fiecare tură, deci prefixul se schimbă mereu
instructions = f"Ești asistentul echipei. Ora: {now()}. Fișiere deschise: {open_files}"

# Corect: prefixul rămâne identic; ce s-a schimbat intră ca mesaj nou, la coadă
input_items.append({
    "role": "developer",
    "content": f"Actualizare de context: fișierele deschise acum sunt {open_files}",
})
Alte surse frecvente: un pas care „curăță” istoricul de apelurile de unelte vechi, rezumarea mesajelor de la început sau un router care mută aceeași conversație de pe Astra pe Sol (downgrade de model). Rutarea între modele se face la granița dintre conversații; cum o construiești e în comparația modelelor de 2 $ / 10 $. Bonus: un prefix stabil e și un prefix cache-uit. Cum gestionezi istoricul și rolurile într-o aplicație cu mai multe ture e lecția „Conversații multi-tur: istoric, roluri și gestionarea contextului” din Construire de Aplicații AI cu Python și SDK-uri.
Cât costă pragul de 272.000, pe un exemplu
Calculul nostru, la tariful Standard al lui Astra (8 $ per milion la intrare, 16 $ peste prag): 270.000 de tokeni de intrare costă 2,16 $; 300.000 costă 4,80 $, pentru că toată cererea trece la tariful dublu. Cu 11% mai mult context plătești de peste două ori mai mult, deci filtrează contextul sau împarte sarcina.
Verificat la 18 noiembrie 2026 pe sursele citate. Prețurile și clasamentele se schimbă des.
Întrebări frecvente
Este GPT-6.2 mai bun la cod decât Claude Fable 5.2? Nu clar. În graficul OpenAI pe FrontierCode 2.0, Fable 5.2 (Xhigh) are 49,1%, iar GPT-6.2 Astra (Max) 44,2%. La Artificial Analysis sunt la egalitate pe FrontierCode-AA, iar Astra conduce pe Terminal-Bench 4.0. Diferența mare e costul pe sarcină, în favoarea lui Astra.
Cum folosesc GPT-6.2 în Codex CLI?
Cu codex --model gpt-6.2-sol, non-interactiv cu codex exec -m gpt-6.2-sol "..." sau cu model = "gpt-6.2-sol" în config.toml. În sesiune, /model schimbă modelul și effort-ul. Contextul implicit e de 272.000 de tokeni la Astra și 500.000 la Sol, până la 1 milion cu model_context_window.
Merită să trec de la Claude Code la Codex pentru GPT-6.2?
Doar pentru scor, nu: diferențele pe cod sunt de câteva puncte și nu toate în favoarea lui GPT-6.2. Argumentul real e costul, mai ales cu Sol. Testează pe zece sarcini din backlog, cu regulile de proiect într-un AGENTS.md importat în CLAUDE.md, ca ambele unelte să pornească de la același context.
Ce se schimbă la migrarea în API la GPT-6.2?
Schimbi ID-ul, treci pe Responses API pentru unelte, scoți temperature și top_p și renunți la effort none. Nou la 6.2: API-ul renunță la itemii de raționament la modificări de prefix, downgrade de model sau alt utilizator, iar calitatea scade fără nicio eroare.
Ce este Blocker Deception și cum mă protejez? Evaluarea din System Card care măsoară cât de des modelul nu spune că a fost blocat, de exemplu de un fișier lipsă: GPT-6.2 Astra omite în 22,28% din cazuri fără prompt de developer și în 8,04% cu prompt. Scrie o instrucțiune de raportare a obstacolelor și verifică automat testele sărite.
Concluzie
Pentru programatori, GPT-6.2 e o lansare de cost, nu de capabilitate pe cod. Astra stă în grupul de vârf alături de Fable 5.2 și Gemini 4 Carbon, fără să-l conducă, iar Sol dă aproape scorul lui Astra la o cincime sau un sfert din costul pe sarcină, cu o regresie pe întrebările despre cod. În Codex, alegerea implicită devine Sol, cu Astra la Xhigh pentru bugurile care traversează servicii; din Claude Code sau Antigravity nu te mută cifrele de mai sus.
Două lucruri merită făcute oricum: instrucțiunea de raportare a obstacolelor, cu verificare automată în spate, și, în integrările prin API, un audit al locurilor în care codul rescrie prefixul conversației. Primul previne un „gata” fals, al doilea o pierdere de calitate pe care nu o semnalează nicio eroare.

Cursul care continuă acest articol
Claude Code Mastery: Coding Agentic din Terminal (multi-fișier, git, CI, MCP)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Claude Code: Instalare, CLI și Modelul Mental Agent-First
- Multi-Fișier și Codebase-uri Mari: Plan, Edit, Review și Context Management
- Workflow Git Complet: Branch-uri, Commit-uri, Conflicte, Code Review și PR-uri
- Headless Mode (claude -p) și Automatizare Non-Interactivă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.