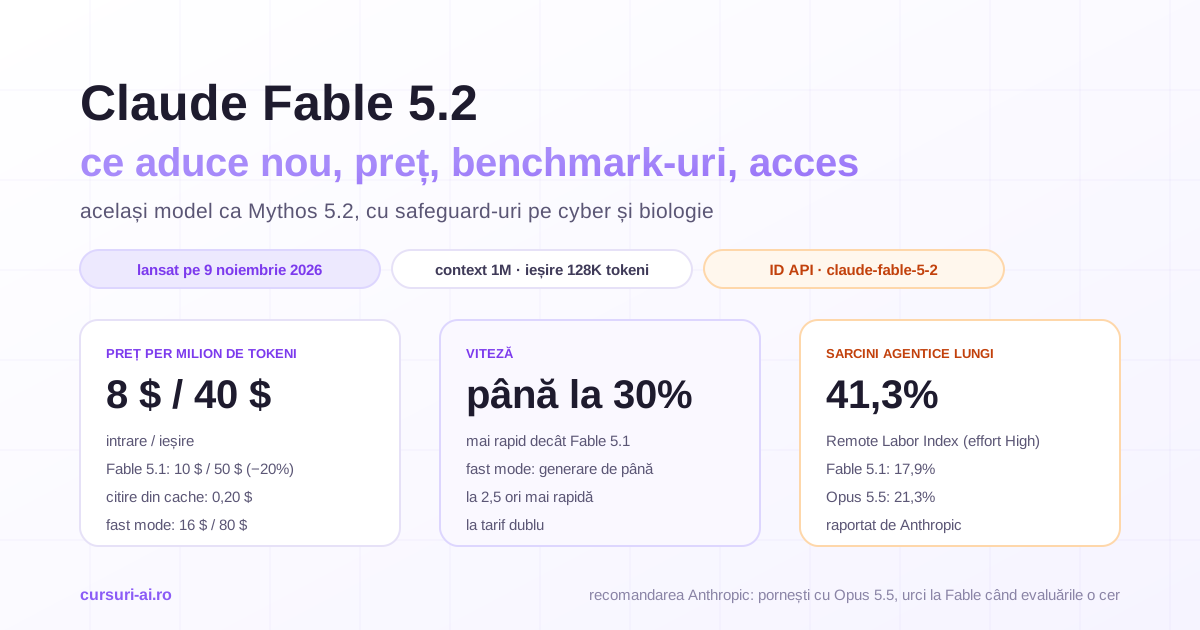
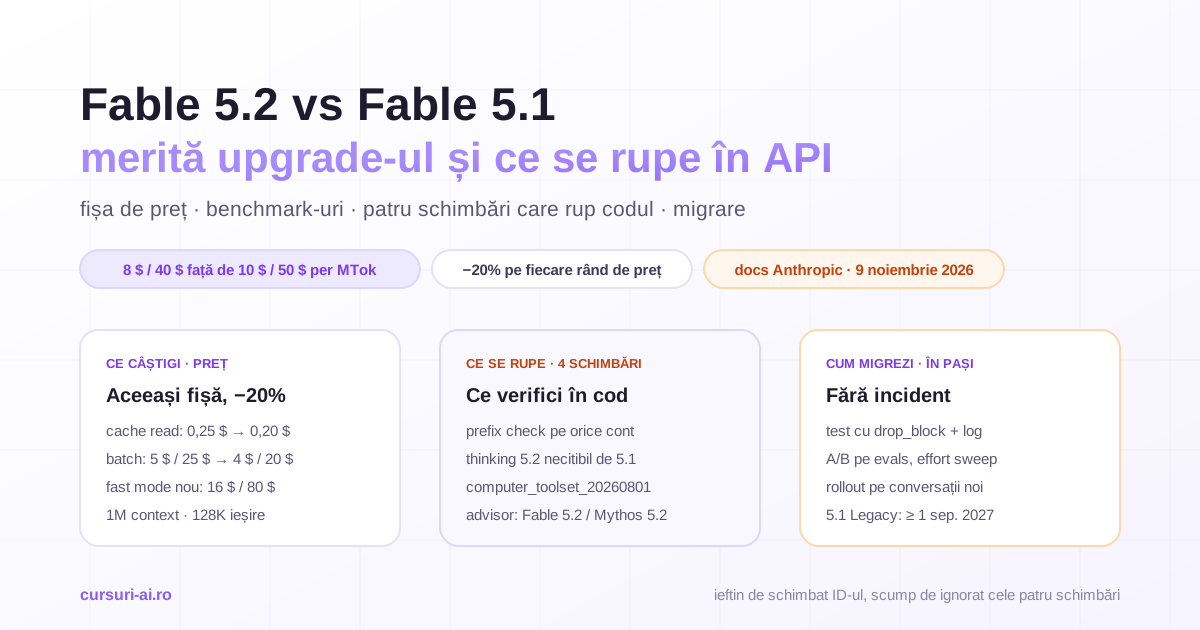
Fable 5.2 vs Opus 5.5 e prima comparație din gama Claude în care prețul per token și costul per sarcină pot da răspunsuri opuse. Fable 5.2 costă de două ori mai mult per token, dar Anthropic publică măsurători în care, la un effort ales corect, atinge scorul lui Opus 5.5 rulat la maxim cu jumătate din costul per sarcină sau mai puțin. Recomandarea oficială rămâne totuși să pornești de la Opus 5.5, iar mai jos găsești cum decizi, pe fiecare rută, ce model folosești și la ce effort.
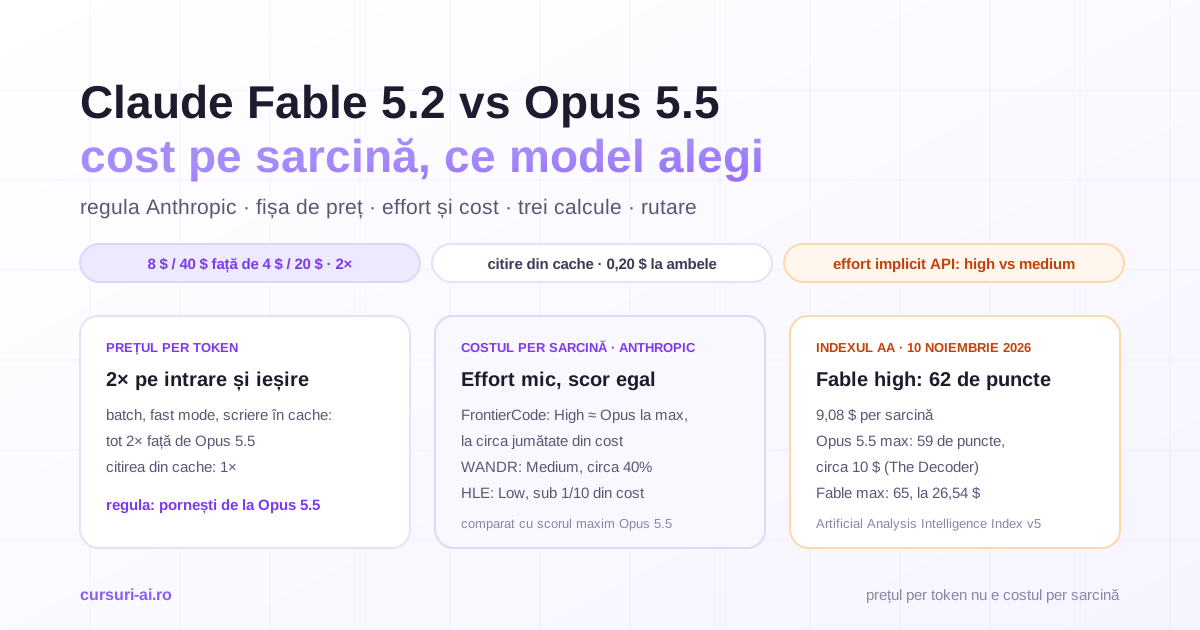
Fable 5.2 vs Opus 5.5: regula oficială și ce s-a schimbat
Pagina de prezentare a modelelor păstrează forma regulii, doar că acum numește noul model: „If you're unsure which model to use, start with Claude Opus 5.5 for most workloads. Use Claude Fable 5.2 for demanding reasoning and long-horizon agentic work, or when your evals on Claude Opus 5.5 at higher effort still fall short.”
Pagina de lansare din 9 noiembrie 2026 o confirmă: „For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver, and then switch to a different model as required”.
Regula e aceeași, datele de sub ea nu. Față de decizia din septembrie, Opus 5.5 vs Fable 5.1, s-au mutat patru lucruri:
- Raportul de preț scade de la 2,5× la 2×. Fable 5.2 costă 8 $ / 40 $ per milion de tokeni (Fable 5.1: 10 $ / 50 $), Opus 5.5 rămâne la 4 $ / 20 $.
- Citirea din cache costă identic: 0,20 $ per milion pe ambele. La Fable 5.1 era 0,25 $.
- Tabelul de benchmark-uri s-a inversat. Opus 5.5 era peste Fable 5.1 pe toate cele nouă rânduri publicate atunci. Acum Anthropic scrie că Fable 5.2 e „a step above Opus 5.5 in almost all the capabilities we evaluated”.
- Latența nu mai e un argument împotriva lui Fable. În tabelul din documentație, ambele au eticheta „Moderate”, iar lansarea anunță ieșire „up to 30% faster” față de Fable 5.1. Fable 5.2 are și fast mode, la 16 $ / 80 $.
Lansarea în ansamblu e în articolul despre Claude Fable 5.2, iar ce se rupe în API la trecerea de pe 5.1, în Fable 5.2 vs Fable 5.1.
În Claude Code, decizia e zilnică: Medium e effort-ul implicit acolo, iar /model și /effort mută costul unei sesiuni mai mult decât orice optimizare de prompt. Ambele comenzi sunt în lecția „Context Management în Codebase-uri Mari: Fereastra de Context, /compact și Strategii de Eficiență” din Claude Code Mastery. Modulul „Subagents și Agent Teams: Orchestrare, Delegare și Paralelizare Controlată” arată cum fixezi un model mai ieftin pe sarcinile delegate.
Claude Fable 5.2 sau Opus 5.5: fișa comparativă
Sursele: pagina de prețuri, tabelul modelelor și „What's new in Claude Fable 5.2”, la 10 noiembrie 2026; dolari per milion de tokeni.
| Criteriu | Claude Fable 5.2 | Claude Opus 5.5 | Raport |
|---|---|---|---|
| Intrare / ieșire | 8 $ / 40 $ | 4 $ / 20 $ | 2× |
| Citire din cache | 0,20 $ | 0,20 $ | 1× |
| Scriere în cache, 5 min / 1 h | 10 $ / 16 $ | 5 $ / 8 $ | 2× |
| Batch API | 4 $ / 20 $ | 2 $ / 10 $ | 2× |
| Fast mode | 16 $ / 80 $ | 8 $ / 40 $ | 2× |
| Effort implicit în API | high |
medium |
— |
| Retenția datelor | 30 de zile obligatoriu (Covered Model) | nu e pe lista Covered Models | — |
| Fallback la blocări | Opus 4.8 (cyber), Opus 5 (biologie) | — | — |
Ambele au context de 1M, ieșire maximă de 128K, thinking adaptiv mereu pornit și aceleași cinci niveluri de effort. Patru rânduri cer atenție:
- Capcana effort-ului implicit. O cerere API fără
output_config.effortrulează Fable 5.2 lahighși Opus 5.5 lamedium. Un test „cu setările implicite” compară două niveluri de effort, nu două modele. În plus, de lahighîn sus Fable 5.2 gândește înainte de aproape orice răspuns, iar un „răspunde direct” în prompt nu-l oprește lamediumși peste. - Cache-ul egalizează. Unde citirea prefixului domină factura, raportul coboară spre 1×; scrierea în cache rămâne la 2×.
- Retenția poate decide singură. Fable 5.2 „requires 30-day data retention and isn't available under zero data retention unless expressly authorized by Anthropic”. Opus 5.5 nu e pe lista Covered Models. Pe o rută cu obligație de zero data retention, Fable iese din discuție înaintea oricărui benchmark, cu excepția autorizărilor exprese și a clienților eligibili pentru Enterprise Frontier Safeguards (beta privat). La Opus 5.5, eligibilitatea ZDR ține de contract.
- Blocările și limitele. Fable 5.2 blochează activitățile cyber cu risc ridicat și majoritatea sarcinilor de biologie de cercetare (răspunde atunci Opus 4.8 sau Opus 5). Anthropic raportează circa 55% mai puține blocări decât la Fable 5.1, dar pe aceste rute măsori rata (detalii de facturare în ghidul despre refuzuri și fallback). Fable 5.2 are o limită de rată proprie, separată de cea a lui Fable 5.1, și nu suportă Priority Tier.
Benchmark-urile: unde Fable 5.2 e peste Opus 5.5 și unde nu
Tabelul păstrează doar coloanele Fable 5.2 și Opus 5.5 din tabelul Anthropic; diferența e calculată de noi. Scorurile sunt rulate și raportate de Anthropic, cu safeguards active, la cel mai mare effort disponibil, cu excepțiile notate. Rândurile de securitate cibernetică și proteine lipsesc: acolo există doar scoruri Mythos 5.2.
| Benchmark | Fable 5.2 | Opus 5.5 | Diferență |
|---|---|---|---|
| FrontierCode 2.0 | 49,1% (xhigh) | 45,5% | +3,6 pp |
| FrontierSWE v2 | 69,9% | 62,3% | +7,6 pp |
| AutomationBench | 51,4% | 42,5% | +8,9 pp |
| Terminal-Bench-Science 0.1 | 74,6% | 58,7% | +15,9 pp |
| WANDR (relaxed score) | 82,1% | 72,3% | +9,8 pp |
| OSWorld 2.1 | 89,3% | 87,2% | +2,1 pp |
| RoboDojo Sim (rulat intern) | 64,9% | 39,4% | +25,5 pp |
| AA-Briefcase v1.1 (rubric) | 66,1% | 61,2% | +4,9 pp |
| AA-Briefcase v1.1 (Elo) | 1785 | 1800 | −15 |
| Remote Labor Index | 41,3% (high) | 21,3% | +20,0 pp |
| Humanity's Last Exam (cu unelte) | 74,2% | 67,7% | +6,5 pp |
| Chartography (fără unelte) | 73,4% | 64,4% | +9,0 pp |
Distanțele sunt inegale: 2–4 puncte pe computer use și FrontierCode, peste 15 pe cercetare științifică agentică, muncă la distanță și robotică. Pe rute ca primele, prețul dublu cumpără puțin.
Unde Opus 5.5 e egal sau peste
- AA-Briefcase pe Elo: Opus 5.5 are 1800, Fable 5.2 are 1785, deși pe rubrică Fable e peste.
- Cercetarea pentru dezvoltarea AI: în optimizarea de kernel-uri pentru acceleratoare și îmbunătățirea arhitecturilor de LLM, Anthropic scrie că Fable 5.2 și Mythos 5.2 „perform at about the level of Opus 5.5”, limitare voită la antrenare, cu fallback transparent pe Opus 5 pentru câteva subiecte.
- Clasamentele pe domenii Artificial Analysis: la 10 noiembrie 2026, Opus 5.5 (Max) era primul în tabelul pe domenii de pe pagina principală AA (finanțe și contabilitate, strategie și operațiuni, juridic, sănătate, inginerie, economie), iar Fable 5.2 nu apărea încă acolo. Comparația independentă pe domenii lipsește deocamdată.
Effort și cost: cifrele care schimbă calculul
Partea nouă a lansării sunt graficele „accuracy vs. cost”, care compară Fable 5.2 la effort mic cu Opus 5.5 la maxim:
| Benchmark | Fable 5.2 la | Comparat cu | Cost per sarcină (Anthropic) |
|---|---|---|---|
| FrontierCode 2.0 | High: 45,3% | Opus 5.5 max: 45,5% | „roughly half the cost per task” |
| WANDR | Medium | scorul maxim Opus 5.5 | „about 40% of the cost per task” |
| Humanity's Last Exam | Low | scorul maxim Opus 5.5 | „less than one-tenth of the cost per task” |
| Chartography | Medium: 66,4% | Opus 5.5 max: 64,4% | „less than one-tenth of the cost per task” |
La scor egal, Fable 5.2 la effort redus costă per sarcină mai puțin decât Opus 5.5 la maxim, deși tokenul e dublu. Cifra FrontierCode e marcată „in early testing”.
Artificial Analysis vede ceva asemănător pe Intelligence Index v5, la 10 noiembrie 2026:
- Fable 5.2 la high: 62 de puncte, la 9,08 $ per sarcină. La xhigh tot 62, dar la 14,83 $; la medium 56 (3,80 $); la low 54 (3,10 $).
- Fable 5.2 la max: 65, primul loc din 74, la 26,54 $ per sarcină.
- Opus 5.5 la max: 59 de puncte. Pentru cost, The Decoder, citând datele AA, dă circa 10 $ per sarcină și 173.000 de tokeni de ieșire, față de 98.000 la Fable 5.2 la high și xhigh.
Deci Fable 5.2 la high scoate un scor mai mare decât Opus 5.5 la max (62 față de 59), la un cost per sarcină puțin mai mic (9,08 $ față de circa 10 $). Ultima treaptă e scumpă: de la high la max, Fable câștigă 3 puncte și costă de aproape trei ori mai mult. Documentația despre effort spune la fel despre max: „runs slower and costs more than at xhigh, often for only a small gain”.
Ideea centrală, cu limitele ei: prețul per token e dublu, dar costul per sarcină poate fi egal sau mai mic la effort ales corect. Limitele: echivalențele sunt față de Opus 5.5 la max (dacă rutele tale trec pragul cu Opus la medium, avantajul poate dispărea), sunt benchmark-uri sau un index agregat, nu sarcina ta, și nu includ structura ta de cache.
Trei calcule de cost pe sarcină
Calcule ilustrative pe tarifele din fișă, cu ipoteze declarate, fără TVA; tokenii reali vin din usage.
Calculul 1: agent de cod, Opus 5.5 la max față de Fable 5.2 la high
Ipoteze: 40 de cereri pe sarcină; prefix din cache de 100.000 de tokeni pe cerere; 3.000 de tokeni scriși în cache-ul de 5 minute pe cerere; ieșire după cifrele The Decoder: 173.000 de tokeni la Opus 5.5 max, 98.000 la Fable 5.2 high.
| Componentă per sarcină | Opus 5.5 (max) | Fable 5.2 (high) |
|---|---|---|
| Citire din cache, 4.000.000 de tokeni | 0,80 $ | 0,80 $ |
| Scriere în cache, 120.000 de tokeni | 0,60 $ | 1,20 $ |
| Ieșire, cu tot cu thinking | 3,46 $ | 3,92 $ |
| Total per sarcină | 4,86 $ | 5,92 $ |
Raport: 1,22×, nu 2×. La același număr de tokeni de ieșire, Fable ar costa 8,92 $ (1,84×). Pragul de egalitate: Fable 5.2 costă cât Opus 5.5 când produce cel mult 71.500 de tokeni de ieșire, adică 41% din consumul lui Opus. Cum ții prefixul stabil și scrierile mici e subiectul lecției „Token Economics ale Contextului: Cost, Latență și Prompt Caching” din Context Engineering și memorie pentru agenți AI.
Calculul 2: 10.000 de documente prin Batch API
Ipoteze: 8.000 de tokeni de intrare pe document, fără cache util; 600 de tokeni de ieșire; aceiași tokeni pe ambele modele.
| Componentă | Opus 5.5 (Batch) | Fable 5.2 (Batch) |
|---|---|---|
| Intrare, 80 de milioane de tokeni | 160 $ | 320 $ |
| Ieșire, 6 milioane de tokeni | 60 $ | 120 $ |
| Total | 220 $ | 440 $ |
Raport: 2×, exact cel de listă. Pe document reușit, cu o rată ipotetică de 95% pe Opus și 98% pe Fable: 0,0232 $ față de 0,0449 $, tot 1,94×.
Calculul 3: chat de suport cu baza de cunoștințe în cache
Ipoteze: prefix de 150.000 de tokeni ținut cald de trafic (scrieri neglijabile); 300 de tokeni noi și 400 de ieșire pe cerere; 40.000 de cereri pe zi.
| Componentă per cerere | Opus 5.5 | Fable 5.2 |
|---|---|---|
| Citire din cache, 150.000 de tokeni | 0,0300 $ | 0,0300 $ |
| Intrare nouă, 300 de tokeni | 0,0012 $ | 0,0024 $ |
| Ieșire, 400 de tokeni | 0,0080 $ | 0,0160 $ |
| Total per cerere / pe zi | 0,0392 $ / 1.568 $ | 0,0484 $ / 1.936 $ |
Raport: 1,23×, pentru că trei sferturi din factura Opus sunt citire din cache, la preț identic. Varianta capcanei: dacă uiți effort-ul și Fable rulează la high, iar thinking-ul ridică ieșirea la 1.200 de tokeni (ipoteză), ajungi la 0,0804 $ pe cerere și 3.216 $ pe zi, adică 2,05×.
Arhitectura de rutare: Opus 5.5 implicit, Fable 5.2 la escaladare
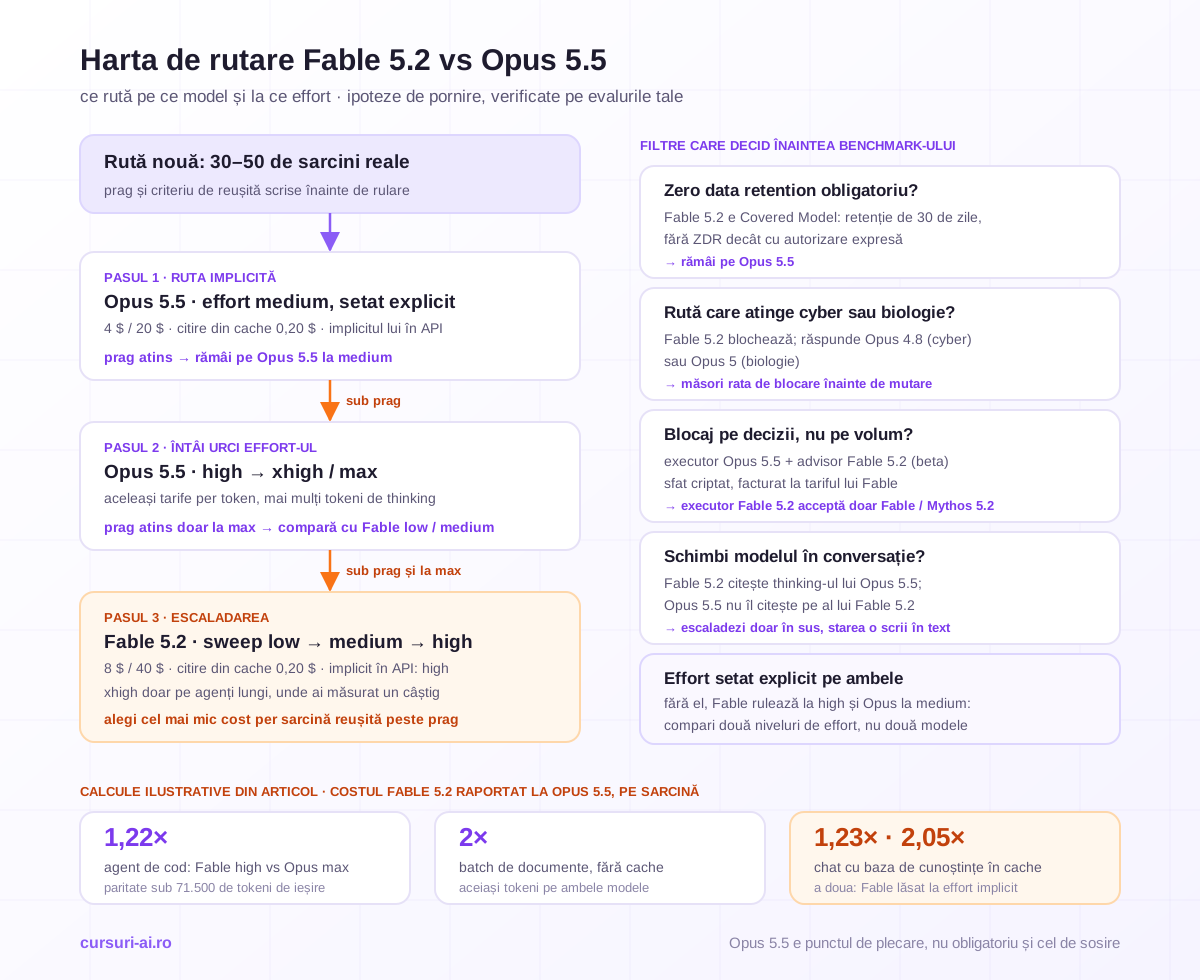
1. Opus 5.5 e ruta implicită, cu effort explicit. Pornești la medium și urci la high, apoi xhigh sau max, doar pe clasele de sarcini care nu ating pragul.
2. Escaladarea la Fable 5.2 are criterii măsurabile.
| Semnal măsurat | Acțiune |
|---|---|
Clasa de sarcini rămâne sub prag pe Opus 5.5 și la max |
Fable 5.2 la high, apoi coborât la medium și low |
Opus 5.5 trece pragul doar la max, cu cost mare per sarcină |
Fable 5.2 la low și medium, unde sunt echivalențele Anthropic |
| Sesiuni de agent care se opresc înainte de final | Fable 5.2 la high, comparat pe cost per sarcină reușită |
| Obligație de zero data retention | rămâi pe Opus 5.5 |
| Rută care atinge cyber sau biologie | măsori întâi rata de blocare și fallback pe Fable 5.2 |
3. Escaladarea în mijlocul conversației merge doar în sus. Pe Claude API și pe Google Cloud (Google managed), Fable 5.2 citește blocurile de thinking produse de Opus 5.5, deci o conversație escaladată își păstrează raționamentul. Opus 5.5 nu le citește pe ale lui Fable 5.2: API-ul le elimină (cererea reușește, blocurile nu se facturează). La fel se întâmplă la fallback-ul pe Opus 4.8 sau Opus 5. Dacă trebuie să cobori, scrii starea în text, pe care îl citește orice model. Capcana e descrisă pe larg, pentru treptele de dedesubt, în Sonnet 5.5 vs Opus 5.5 vs Fable 5.1.
4. Fable 5.2 ca advisor sau orchestrator. Ca advisor, Fable 5.2 e consultat de un model mai ieftin doar în punctele grele. Perechile, verificate în documentația advisor tool:
- Un executor Opus 5.5 acceptă ca advisor Fable 5.2, Mythos 5.2, Fable 5.1, Mythos 5.1, Fable 5, Mythos 5, Opus 5.5 și Opus 5.
- Un executor Fable 5.2 acceptă doar Fable 5.2 sau Mythos 5.2; orice alt advisor, inclusiv Fable 5.1, întoarce 400.
- Sfatul lui Fable 5.2 vine criptat (
advisor_redacted_result), deci nu îl poți loga. Consultările se facturează la tariful advisorului, apar înusage.iterationsși au de obicei 1.400–1.800 de tokeni cu tot cu thinking. Funcția e în beta.
Calcul ilustrativ: o consultare Fable 5.2 pe un transcript de 100.000 de tokeni necache-uiți, cu 1.600 de tokeni de ieșire, costă circa 0,86 $; cu Opus 5.5 ca advisor, circa 0,43 $.
În Claude Code, pagina despre advisor (legată din anunțul de lansare) dă aceleași reguli: cu Opus 5 sau Opus 5.5 ca model principal, advisorul poate fi Fable sau Opus 5 ori mai nou; cu Fable 5.2, doar Fable 5.2. Setarea: /advisor fable, advisorModel sau --advisor (Fable 5.2 cere v2.1.321 sau mai nou). Advisorul merge doar prin API-ul Anthropic, iar pe unele abonamente un advisor Fable se facturează din usage credits.
Ca orchestrator, Fable 5.2 delegă sarcinile simple unor modele mai mici, dar „What's new in Claude Fable 5.2” avertizează: „Subagents can account for a large part of what a session costs.” Rutarea multi-model ca tipar (după complexitate, buget, latență, cu lanțuri de fallback) e tratată în lecția „Orchestrare Multi-Model: Routarea Inteligentă a LLM-urilor” din AI Agents: Arhitectura și Automatizarea Sistemelor Autonome.
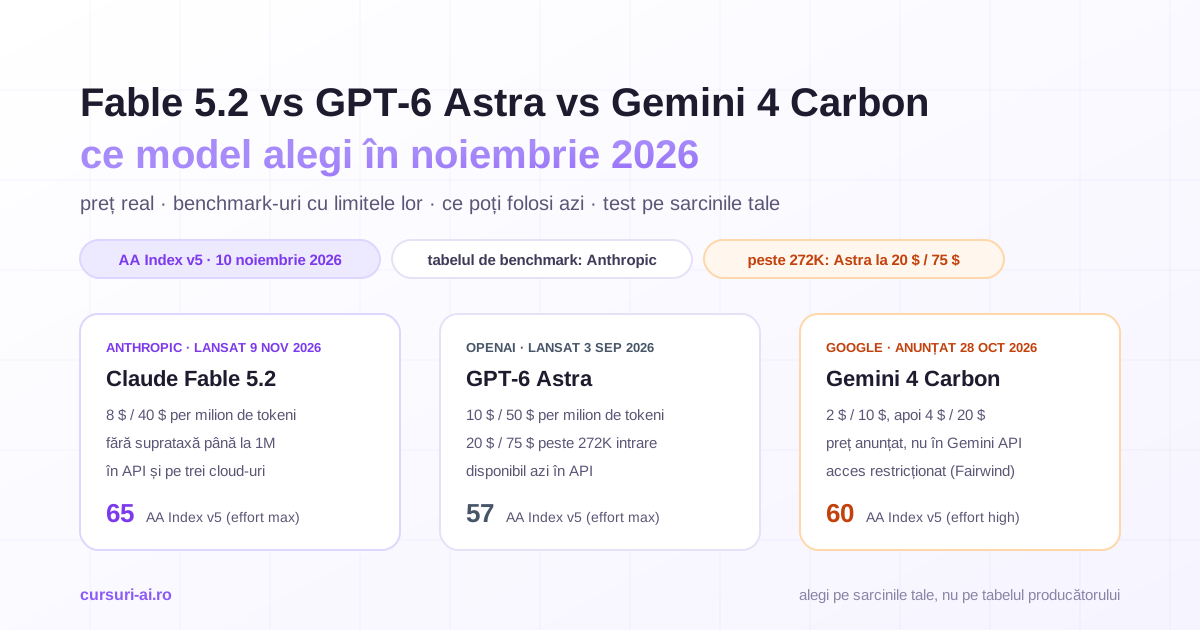
Comparația cu OpenAI și Google e în Fable 5.2 vs GPT-6 Astra vs Gemini 4 Carbon, iar varianta pentru securitate cibernetică, în articolul despre Claude Mythos 5.2.
Protocolul de decizie: trei niveluri de effort pe fiecare model
Pasul 1: setul de sarcini. 30–50 de sarcini reale, grupate pe rute, cu criteriul de reușită scris înainte de rulare, inclusiv cele ratate de modelul actual. Cum construiești setul e explicat în ghidul despre evaluarea modelelor AI în producție.
Pasul 2: Opus 5.5 la medium, high și max, cu promptul și uneltele din producție. Notezi reușita, tokenii din usage și durata.
Pasul 3: Fable 5.2 la low, medium și high. Nu de la max: echivalențele publicate sunt la niveluri mici, iar documentația spune că „most of the gain in capability is already present at high”. Adaugi xhigh doar pe agenții de lungă durată unde ai măsurat un câștig și setezi un max_tokens mare, pentru că thinking-ul intră în limită.
Pasul 4: tabelul. Fiecare celulă are rata de reușită, costul per sarcină reușită (costul total împărțit la sarcinile trecute) și latența mediană.
| Rută | Prag | Opus medium |
Opus high |
Opus max |
Fable low |
Fable medium |
Fable high |
Decizie |
|---|---|---|---|---|---|---|---|---|
| Agent de cod | 85% | … | … | … | … | … | … | … |
| Extracție documente | 95% | … | … | … | … | … | … | … |
Regula se scrie înainte de rulări: „configurația cu cel mai mic cost per sarcină reușită care atinge pragul și respectă constrângerile rutei (retenție, latență, rata de blocare)”. Ea poate alege Fable 5.2 la medium în fața lui Opus 5.5 la max: Opus 5.5 e punctul de plecare, nu obligatoriu și cel de sosire.
Nu schimba effort-ul la nivelul cererii într-o conversație cu cache: îl invalidezi. Effort-ul per mesaj (beta) îl păstrează, pe ambele modele.
Întrebări frecvente
Ce model Claude aleg între Fable 5.2 și Opus 5.5? Anthropic recomandă Opus 5.5 ca punct de plecare și Fable 5.2 pentru raționament dificil, agenți de lungă durată sau când evalurile pe Opus 5.5 la effort mai mare tot pică.
Cât costă Fable 5.2 față de Opus 5.5? De două ori mai mult pe intrare și ieșire (8 $ / 40 $ față de 4 $ / 20 $ per milion de tokeni), pe scrierea în cache, Batch și fast mode. Citirea din cache costă la fel, 0,20 $ per milion. În calculele noastre ilustrative, raportul real a ieșit între 1,22× și 2×.
Ce înseamnă cost pe sarcină Claude? Factura totală a unei sarcini terminate, cu thinking și cache. Un model mai scump per token poate costa mai puțin per sarcină dacă folosește mai puțini tokeni: pe FrontierCode 2.0, Fable 5.2 la high egalează Opus 5.5 la max la circa jumătate din cost, conform Anthropic.
Ce effort Claude folosesc pe Fable 5.2 și pe Opus 5.5?
Pe Opus 5.5 pornești de la medium și urci doar unde evalurile pică. Pe Fable 5.2, documentația recomandă high ca start, coborârea la medium sau low unde calitatea se menține, xhigh pentru sarcinile lungi cele mai grele și max doar pentru măsurarea plafonului.
Pot folosi Fable 5.2 ca advisor pentru Opus 5.5? Da, atât în API (beta), cât și în Claude Code. Invers nu: un executor Fable 5.2 acceptă doar Fable 5.2 sau Mythos 5.2 ca advisor.
Concluzie
În decizia Fable 5.2 vs Opus 5.5, prețul de listă e dublu, citirea din cache identică, iar Fable 5.2 e peste Opus 5.5 pe aproape toate rândurile publicate. S-a schimbat costul pe sarcină: la effort ales corect, Fable poate egala Opus 5.5 rulat la maxim cu cheltuieli egale sau mai mici. Regula rămâne: Opus 5.5 cu effort explicit, întâi urci effort-ul, apoi Fable 5.2 cu propriul sweep, escaladare doar în sus, cu retenția de 30 de zile în calcul. Unde ai nevoie de judecata lui Fable doar în câteva puncte, măsoară perechea Opus 5.5 + advisor Fable 5.2.
Surse
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2: https://www.anthropic.com/claude-fable-and-mythos-5-2
- Anthropic Docs, Models overview: https://platform.claude.com/docs/en/models/overview
- Anthropic Docs, Pricing: https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic Docs, Effort: https://platform.claude.com/docs/en/build-with-claude/effort
- Anthropic Docs, Advisor tool: https://platform.claude.com/docs/en/agents-and-tools/tool-use/advisor-tool
- Artificial Analysis, Claude Fable 5.2: https://artificialanalysis.ai/models/claude-fable-5-2
- The Decoder, despre Fable 5.2 și Mythos 5.2 (citând Artificial Analysis): https://the-decoder.com/claude-fable-5-2-and-mythos-5-2-cement-anthropics-ai-lead-just-before-its-ipo/
Verificat la 10 noiembrie 2026 pe pagina de lansare Anthropic, în documentația Claude Platform și Claude Code și pe Artificial Analysis. Cifrele de benchmark sunt raportate de Anthropic (cu safeguards active, la cel mai mare effort disponibil, cu excepțiile notate) sau de Artificial Analysis și se pot schimba. Calculele de cost sunt ilustrative, pe tarifele publicate și ipoteze declarate, nu măsurători. Conținut educativ, nu consultanță financiară.

Cursul care continuă acest articol
Claude Code Mastery: Coding Agentic din Terminal (multi-fișier, git, CI, MCP)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Claude Code: Instalare, CLI și Modelul Mental Agent-First
- Multi-Fișier și Codebase-uri Mari: Plan, Edit, Review și Context Management
- Workflow Git Complet: Branch-uri, Commit-uri, Conflicte, Code Review și PR-uri
- Headless Mode (claude -p) și Automatizare Non-Interactivă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.