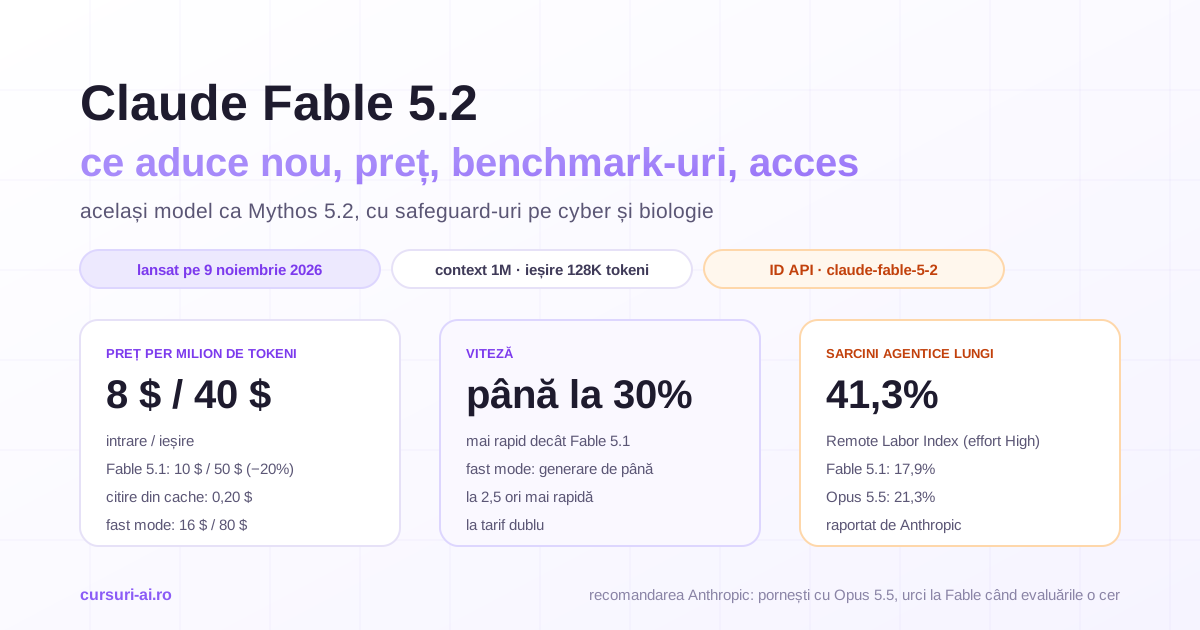
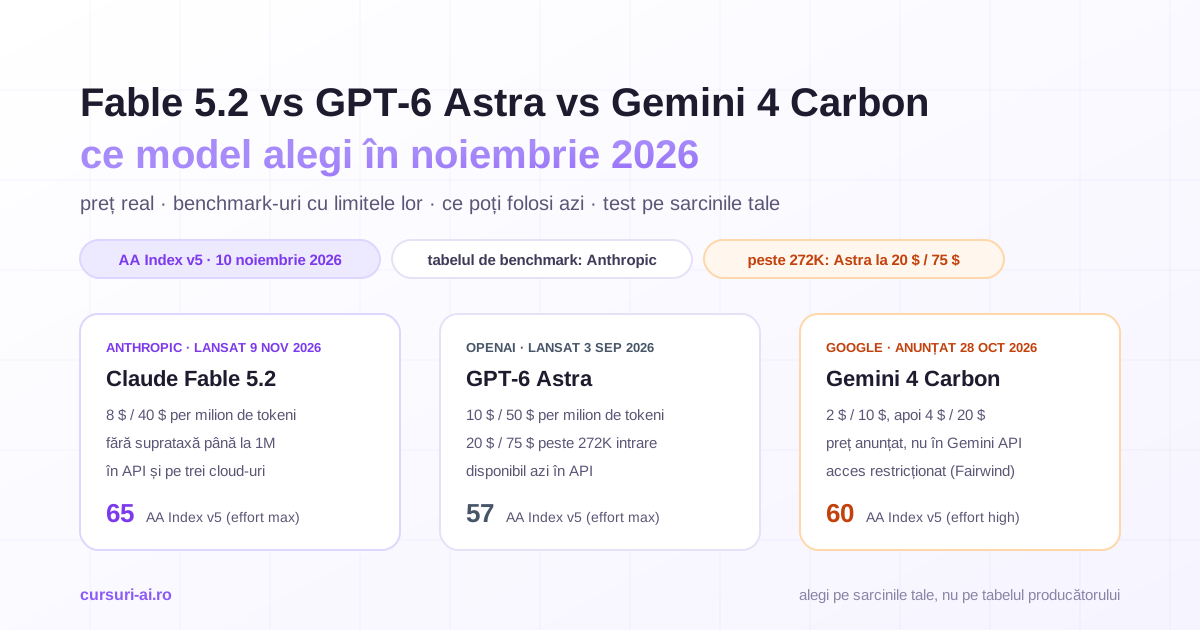
Fable 5.2 vs GPT-6 Astra, cu Gemini 4 Carbon ca al treilea nume din același tabel, e din 9 noiembrie 2026 comparația oricărei echipe care plătește un model de vârf. Pe hârtie, Claude Fable 5.2 câștigă aproape toate rândurile, costă mai puțin per token și conduce indicele independent al Artificial Analysis. În practică, tabelul e publicat de Anthropic, cu niveluri de effort diferite între modele, Carbon nu poate fi apelat încă prin API, iar regula de context lung a OpenAI schimbă socoteala peste 272.000 de tokeni.
Fable 5.2 vs GPT-6 Astra vs Gemini 4 Carbon, pe scurt
| Ce te interesează | Ce arată cifrele publicate | Atenție la |
|---|---|---|
| Cod agentic (FrontierSWE v2) | Fable 5.2 69,9%, GPT-6 Astra 65,5%, Carbon 61,2% | tabel publicat de Anthropic |
| Automatizări de business (AutomationBench) | Carbon 53,9%, Fable 5.2 51,4%, Astra 41,4% | singurul rând unde Fable 5.2 pierde |
| Citirea graficelor (Chartography) | Fable 5.2 73,4%, Carbon 72,5%, Astra 71,0% | 2,4 puncte între primul și ultimul |
| Indice independent (AA Index v5) | Fable 5.2 (max) 65, Carbon (high) 60, Astra (max) 57 | la 10 noiembrie 2026, efforturi diferite |
| Preț de listă, intrare / ieșire | Fable 5.2 8 $ / 40 $, Astra 10 $ / 50 $, Carbon 2 $ / 10 $ anunțat | Astra: 20 $ / 75 $ peste 272K tokeni |
| Disponibil azi în API | Fable 5.2 și GPT-6 Astra | Carbon: acces restricționat |
Lectura scurtă: Fable 5.2 e cel mai puternic model pe care îl poți apela azi, dar nu peste tot și nu la orice effort. Carbon îl întrece pe automatizări de business, iar la medium, implicitul din aplicațiile Claude, Fable 5.2 coboară sub Carbon și sub Astra în indicele Artificial Analysis.
Tabelul de benchmark-uri e al unui producător: Anthropic alege testele, effort-ul fiecărui model și rândurile lăsate cu liniuță. Cum citești un astfel de tabel fără să preiei concluzia producătorului e subiectul lecției „Benchmark-uri 2026: Ce Contează, Ce Nu, și Cum Interpretezi Corect”, din modulul „Fundamente de Evaluare AI” al cursului Comparație Modele AI 2026. Comparațiile precedente rămân valabile: Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6 Astra transcrie tabelul Google din 28 octombrie, iar GPT-6 Astra vs Claude Fable 5.1 compară Astra cu generația anterioară Anthropic.
Ce poți folosi azi
Claude Fable 5.2 (claude-fable-5-2), lansat pe 9 noiembrie, e disponibil general: aplicațiile Claude, Claude Platform, Amazon Bedrock, Google Cloud, Microsoft Foundry. Effort de la low la max, implicit high în API și medium în aplicații și în Claude Code. GPT-6 Astra (gpt-6-astra), lansat pe 3 septembrie, e modelul pe care OpenAI îl recomandă „for complex reasoning and coding”, cu cunoștințe până la 30 aprilie 2026 și reasoning.effort de la low la max. Gemini 4 Carbon, anunțat pe 28 octombrie, nu apare la 10 noiembrie nici în lista de modele, nici pe pagina de prețuri a Gemini API; accesul inițial merge la apărători cibernetici, prin programul Fairwind.
Alternativele apelabile azi de la aceiași furnizori:
- GPT-6.1 Sol (
gpt-6.1-sol), recomandat de OpenAI pentru echilibrul inteligență–cost: 2 $ / 10 $, cache 0,10 $, aceeași regulă de 272K, 55 de puncte în AA Index lamax. - Gemini 4 Argon (
gemini-4-argon), cel mai nou model listat în Gemini API, cu fereastră comună de 1M tokeni și fără suprataxă de context lung: 2 $ / 10 $ (cache 0,10 $) până la 30 noiembrie, apoi 4 $ / 20 $ (cache 0,20 $). Fișa e în ce aduce Gemini 4 Argon.
Pe partea Anthropic, Opus 5.5 rămâne punctul de pornire recomandat oficial; când merită urcat la Fable 5.2 e decizia din Fable 5.2 vs Opus 5.5.
Prețul, rând cu rând
Dolari per milion de tokeni, verificați la 10 noiembrie 2026 pe paginile oficiale; pentru Carbon, anunțul Google din 28 octombrie.
| Poziție | Claude Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|---|---|
| Intrare | 8 $ | 10 $ (20 $ peste 272K) | 2 $ introductiv, apoi 4 $ | 2 $ → 4 $ din 1 decembrie |
| Citire din cache | 0,20 $ | 1 $ (2 $ peste 272K) | cu 95% sub intrare | 0,10 $ → 0,20 $ |
| Scriere în cache | 10 $ (5 min), 16 $ (1 h) | 12,50 $ (1,25× intrarea) | neanunțat | — |
| Ieșire | 40 $ | 50 $ (75 $ peste 272K) | 10 $ introductiv, apoi 20 $ | 10 $ → 20 $ |
| Context / ieșire maximă | 1M / 128K | 1.050.000 (922.000 intrare) / 128.000 | nepublicat | 1M, fereastră comună |
| Context lung | fără suprataxă | peste 272K de intrare: 2× intrarea și cache-ul, 1,5× ieșirea, pe toată cererea | neanunțat | fără suprataxă |
| Batch | 4 $ / 20 $ | 5 $ / 25 $ (50%) | — | 1 $ / 5 $ → 2 $ / 10 $ |
| Flex | — | 50% din tarif | — | ca Batch |
| Fast | 16 $ / 80 $ | 2× (20 $ / 100 $) | — | — |
| În API la 10.11.2026 | da | da | nu | da |
Ce contează mai mult decât raportul de 8 la 10:
- Pragul de 272K se aplică pe toată cererea. Un prompt de 280.000 de tokeni plătește dublu pentru toți tokenii, nu doar pentru cei de peste prag. Fable 5.2 și Argon au un singur tarif pe 1M tokeni.
- Citirea din cache e de cinci ori mai ieftină pe Fable 5.2 (0,20 $ față de 1 $), decisiv în buclele de agent.
- Prețul lui Carbon e un anunț, fără dată de final a perioadei introductive și fără regulă de context lung. Bugetezi la 4 $ / 20 $.
- Argon se dublează pe 1 decembrie, deci un calcul făcut azi pe 2 $ / 10 $ expiră în trei săptămâni.
Cum îți construiești un astfel de tabel pe propria factură e lucrat în lecția „Pricing API Octombrie 2026: Tabelul Complet al Costurilor per Model” din același curs.
Trei calcule ilustrative
Toate presupun același număr de tokeni pe fiecare model, ipoteză falsă în realitate: fiecare model consumă alt număr de tokeni de raționament, facturați ca ieșire. Înlocuiești cifrele cu cele din câmpul usage al rulărilor tale.
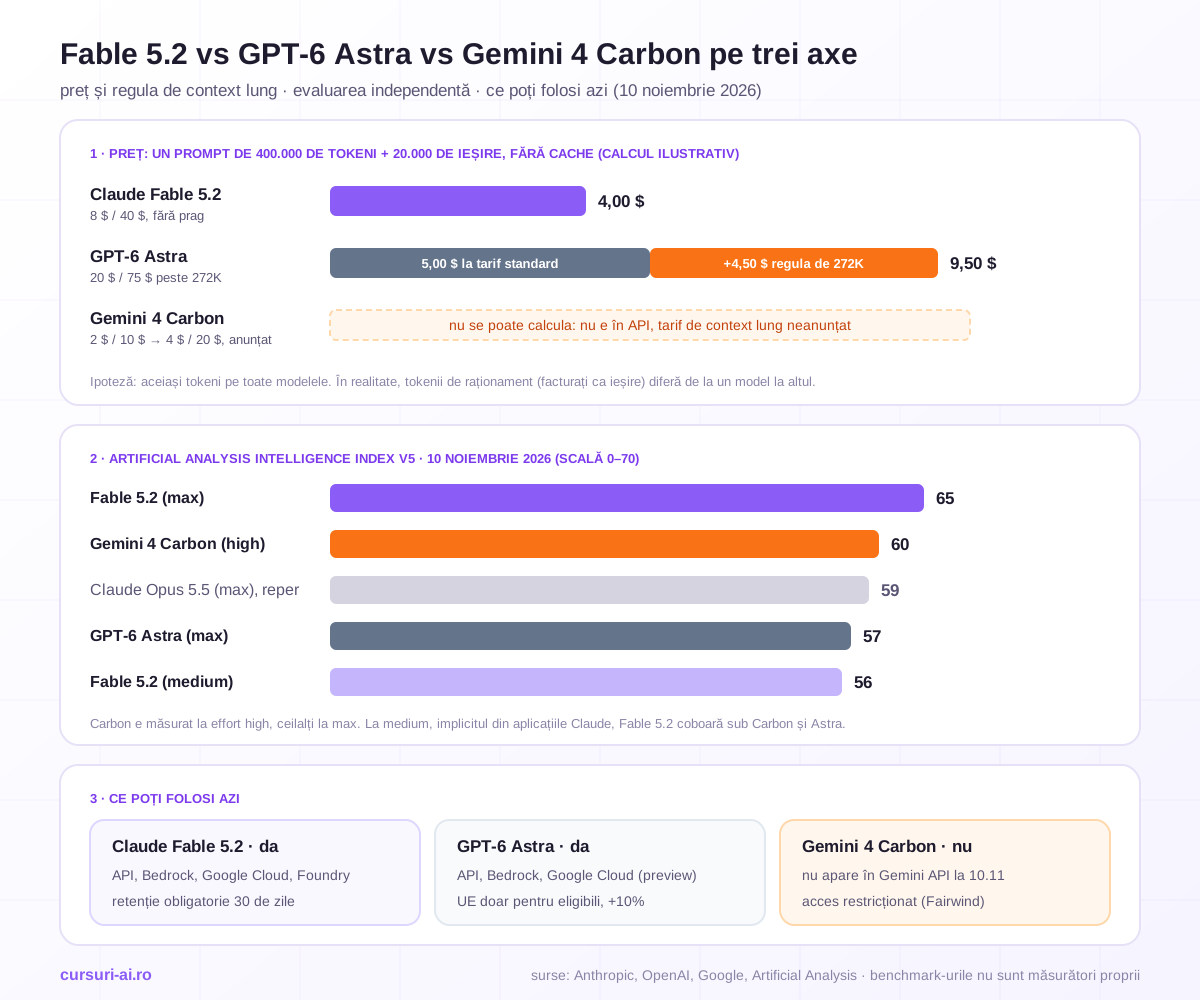
Calculul 1: un prompt de 400.000 de tokeni de intrare și 20.000 de ieșire, fără cache (un contract lung, un depozit de cod mediu).
| Model | Intrare | Ieșire | Total |
|---|---|---|---|
| Claude Fable 5.2 (8 $ / 40 $) | 3,20 $ | 0,80 $ | 4,00 $ |
| GPT-6 Astra, tarif standard (ipotetic) | 4,00 $ | 1,00 $ | 5,00 $ |
| GPT-6 Astra cu tariful de context lung (20 $ / 75 $) | 8,00 $ | 1,50 $ | 9,50 $ |
| GPT-6.1 Sol cu tariful de context lung (4 $ / 15 $) | 1,60 $ | 0,30 $ | 1,90 $ |
| Gemini 4 Argon, până la 30.11 / din 1.12 | 0,80 $ / 1,60 $ | 0,20 $ / 0,40 $ | 1,00 $ / 2,00 $ |
Pe lista de prețuri, Astra e de 1,25 ori mai scump; la 400.000 de tokeni, de 2,4 ori. Regula de context lung adaugă singură 4,50 $ pe cerere. Pentru Carbon nu se poate calcula corect: la prețul de după perioada introductivă ar ieși 2,00 $, dar doar dacă Google nu introduce un tarif de context lung.
Calculul 2: o buclă de agent de 200 de cereri, înainte și după prag. Fiecare cerere recitește un prefix din cache, scrie 3.000 de tokeni noi în cache și produce 2.000 de tokeni.
| Scenariu | Claude Fable 5.2 | GPT-6 Astra |
|---|---|---|
| Prefix de 100.000 de tokeni, per cerere | 0,1300 $ | 0,2375 $ |
| 200 de cereri | 26,00 $ | 47,50 $ (1,8×) |
| Prefix de 300.000 de tokeni, per cerere | 0,1700 $ | 0,8250 $ |
| 200 de cereri | 34,00 $ | 165,00 $ (4,9×) |
La 300.000 de tokeni: Fable 5.2 = 0,06 $ citire + 0,03 $ scriere + 0,08 $ ieșire; Astra, peste prag = 0,60 $ citire (2 $) + 0,075 $ scriere (25 $) + 0,15 $ ieșire (75 $). Peste 272K, Astra schimbă clasa de cost, deci compactarea contextului sub prag e o decizie de arhitectură.
Calculul 3: 10.000 de documente prin Batch, câte 8.000 de tokeni de intrare și 600 de ieșire.
| Model (tarif Batch) | Total |
|---|---|
| Claude Fable 5.2 (4 $ / 20 $) | 440 $ |
| GPT-6 Astra (5 $ / 25 $) | 550 $ |
| GPT-6.1 Sol (1 $ / 5 $) | 110 $ |
| Gemini 4 Argon, până la 30.11 / din 1.12 | 110 $ / 220 $ |
Dacă testul tău arată calitate echivalentă pe extracție, diferența dintre 110 $ și 550 $ nu cumpără nimic.
Benchmark-urile din tabelul Anthropic, doar pentru cei trei
Am păstrat doar rândurile unde Fable 5.2 are scor propriu; tabelul complet, cu Fable 5.1 și Opus 5.5, și restul lansării sunt în ce aduce nou Claude Fable 5.2.
| Benchmark | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| FrontierCode 2.0 (cod agentic) | 49,1% (Xhigh) | 42,8% | 41,1% (Medium) |
| FrontierSWE v2 (cod agentic) | 69,9% | 65,5% | 61,2% |
| AutomationBench (fluxuri de business) | 51,4% | 41,4% | 53,9% |
| Terminal-Bench-Science 0.1 | 74,6% | 68,1% | 64,8% |
| WANDR, scor relaxat (căutare agentică) | 82,1% | — | — |
| OSWorld 2.1, set offline parțial | 89,3% | 79,5% | 81,5% |
| RoboDojo Sim (robotică) | 64,9% | 29,8% | — |
| AA-Briefcase v1.1, rubric / Elo | 66,1% / 1785 | 52,0% / 1569 | 61,8% / 1611 |
| Remote Labor Index | 41,3% (High) | 20,8% | — |
| Humanity's Last Exam, cu unelte | 74,2% | 57,2% | — |
| Chartography, fără unelte | 73,4% | 71,0% | 72,5% |
Rândurile de securitate cibernetică și design de proteine au doar scoruri Mythos 5.2, nu Fable 5.2, și nu intră aici.
Ce spune tabelul și ce nu spune:
- E tabelul Anthropic. Nota de subsol: scorurile Fable 5.2 sunt cu safeguard-urile active, toate la cel mai mare effort disponibil, cu excepțiile notate. Doar la RoboDojo scrie explicit „run internally”; pentru celelalte rânduri, pagina nu precizează dacă cifra unui concurent e rulată de Anthropic sau preluată.
- FrontierCode nu e comparabil direct. Fable 5.2 e la Xhigh, Carbon la Medium. Mai util e textul Anthropic de sub grafic: la High, Fable 5.2 are 45,3%, peste cel mai bun scor Astra (42,8%), „at about the same cost” per sarcină.
- Carbon câștigă AutomationBench (53,9% față de 51,4%), chiar în tabelul Anthropic.
- Chartography e practic egalitate, iar la Medium Fable 5.2 coboară la 66,4%, sub ceilalți doi la maxim.
- Liniuțele nu sunt zero. Carbon nu are scor pe WANDR, RoboDojo, RLI și HLE, Astra pe WANDR. Nu le numeri ca victorii pentru Fable 5.2. Iar rândul de computer use e un subset („offline set, partial”), deci nu îl amesteci cu scoruri OSWorld din tabelele altor producători.
Artificial Analysis Intelligence Index v5: cifra independentă
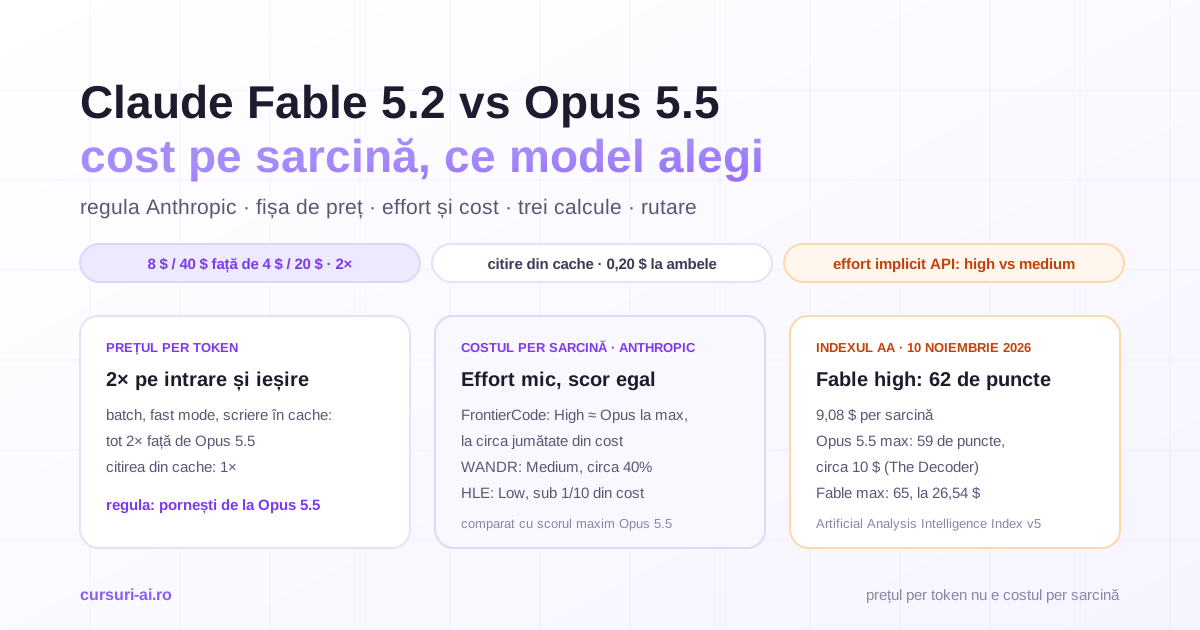
Artificial Analysis rulează aceleași nouă evaluări pe toate modelele și publică și costul per sarcină. La 10 noiembrie 2026 (v5.0.1): Claude Fable 5.2 (max) 65, locul 1 din 74; Gemini 4 Carbon (high) 60, locul 4; Claude Opus 5.5 (max) 59, locul 5, ca reper; GPT-6 Astra (max) 57, locul 8; GPT-6.1 Sol (max) 55, locul 12. Carbon e măsurat la high, ceilalți la max.
Fable 5.2 nu e un singur punct, ci cinci:
| Fable 5.2, effort | Scor AA | Cost per sarcină |
|---|---|---|
| max | 65 | 26,54 $ |
| xhigh | 62 | 14,83 $ |
| high | 62 | 9,08 $ |
| medium | 56 | 3,80 $ |
| low | 54 | 3,10 $ |
Între high și xhigh scorul e identic, iar costul crește cu 63%. max adaugă 3 puncte la de 2,9 ori costul lui high și durează în medie circa 45 de minute pe sarcină. La medium, Fable 5.2 (56) e sub Carbon (60) și sub Astra (57). Cine compară „Fable 5.2” cu „GPT-6 Astra” fără să spună effort-ul compară, de fapt, cinci modele cu unul.
Disponibilitate, retenția datelor și rezidența
| Claude Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon | |
|---|---|---|---|
| API propriu | Claude Platform | OpenAI API (Responses, Chat Completions, Batch) | nu |
| Cloud | Amazon Bedrock, Google Cloud, Microsoft Foundry | Amazon Bedrock; Google Cloud în private preview | — |
| Retenție | 30 de zile obligatoriu; ZDR doar cu autorizare expresă sau prin Enterprise Frontier Safeguards | pagina modelului nu impune o cerință specifică | — |
| Rezidență | inference_geo global sau us (1,1×); fără opțiune UE documentată |
regiunea Europa pentru clienții eligibili, +10%, fără fast mode | — |
| Acces | general | general | restricționat (Fairwind) |
Pentru o firmă din UE, două detalii pot elimina candidați înainte de orice benchmark:
- Fable 5.2 cere retenție de 30 de zile pentru monitorizarea siguranței și nu e disponibil sub zero data retention fără autorizare expresă Anthropic. Excepția, Enterprise Frontier Safeguards, e în beta privat. Dacă politica ta cere ZDR, Fable 5.2 nu e o opțiune implicită.
- Rezidența în Europa la OpenAI nu e automată. Pagina „Data controls in the OpenAI platform” listează GPT-6 Astra și GPT-6.1 Sol pentru procesare în regiunea Europa (SEE și Elveția), dar cere eligibilitate confirmată de vânzări, aprobare pentru controalele de abuse monitoring și un amendament de retenție. Endpoint-urile de rezidență au o suprataxă de 10% pentru modelele lansate începând cu 5 martie 2026, iar fast mode nu merge cu rezidența UE pe Astra.
La Google, rezidența depinde de produs; pentru Argon pe Google Cloud, detaliile sunt în articolul dedicat de mai sus, iar pentru Carbon nu există încă documentație.
Mythos 5.2, Carbon și securitatea
Fable 5.2 are classifiers care blochează testarea de penetrare, generarea de exploit-uri și cercetarea de vulnerabilități pe binare; cererile blocate primesc răspuns de la Opus 4.8. Varianta fără aceste safeguard-uri, Mythos 5.2, e doar pentru organizații verificate, iar Carbon pornește tot cu acces restricționat. Pentru securitate ofensivă legitimă, comparația relevantă e între programele de acces: Claude Mythos 5.2: cine are acces și Gemini 4 Carbon în securitate cibernetică.
Ce alegi pentru fiecare tip de sarcină
| Sarcina | Ce susțin cifrele | Alegerea de azi |
|---|---|---|
| Cod agentic, depozite mari | Fable 5.2 conduce FrontierSWE v2 și FrontierCode; la High e peste Astra la cost comparabil, după Anthropic | Fable 5.2 la high, dacă Opus 5.5 nu ajunge; Astra dacă ești pe stack-ul OpenAI |
| Automatizări de business | Carbon 53,9%, Fable 5.2 la 2,5 puncte, Astra la 12,5 | Fable 5.2 sau Argon pe test; Carbon de pregătit |
| Documente lungi, peste 272K | tabelul Anthropic nu are rând de context lung | decide prețul: Fable 5.2 și Argon fără prag |
| Analiză de grafice | 73,4%, 72,5%, 71,0% | cel mai ieftin model care trece testul tău |
| Volum mare, ieftin | niciunul dintre cei trei | GPT-6.1 Sol sau Argon prin Batch |
Matricea e un punct de plecare pentru test, nu o concluzie. Trei rute pe trei modele în aceeași aplicație cer un strat care izolează aplicația de furnizor: aceeași interfață, rutare pe tip de sarcină, fallback. Arhitectura lui e lecția „AI Gateway: Multi-Provider Routing, Rate Limiting și Fallback Strategies” din modulul „Core Runtime și Orchestrare” al cursului Arhitectura Sistemelor AI la Scară.
Protocolul: cinci sarcini, notare oarbă
Un test de o zi, înaintea unui eval complet:
- Cinci sarcini reale, câte una pe rută (un bug din backlog, o automatizare internă, un contract lung, un raport cu grafice, o extracție), fiecare cu criteriul de reușită scris înainte de rulare.
- Trei rulări pe model, în același harness, cu aceleași unelte și effort setat explicit: implicitul diferă chiar la același model (Fable 5.2:
highîn API,mediumîn aplicații). - Ieșiri anonimizate: un script le redenumește A, B, C, le amestecă și scoate indiciile de model; cheia o ține altcineva decât evaluatorul.
- Notare oarbă pe grilă, 0–3 pe criteriu. Dacă judecătorul e un model, nu folosi unul dintre candidați: judecătorii au preferințe de poziție, lungime și propriul stil, mecanisme tratate în lecția „Bias-urile Judecătorului: Position, Verbosity, Self-Preference și Mitigarea Lor” din AI Evals pentru LLM-uri în Producție.
- Cost per sarcină reușită, din
usage: costul total împărțit la sarcinile trecute.
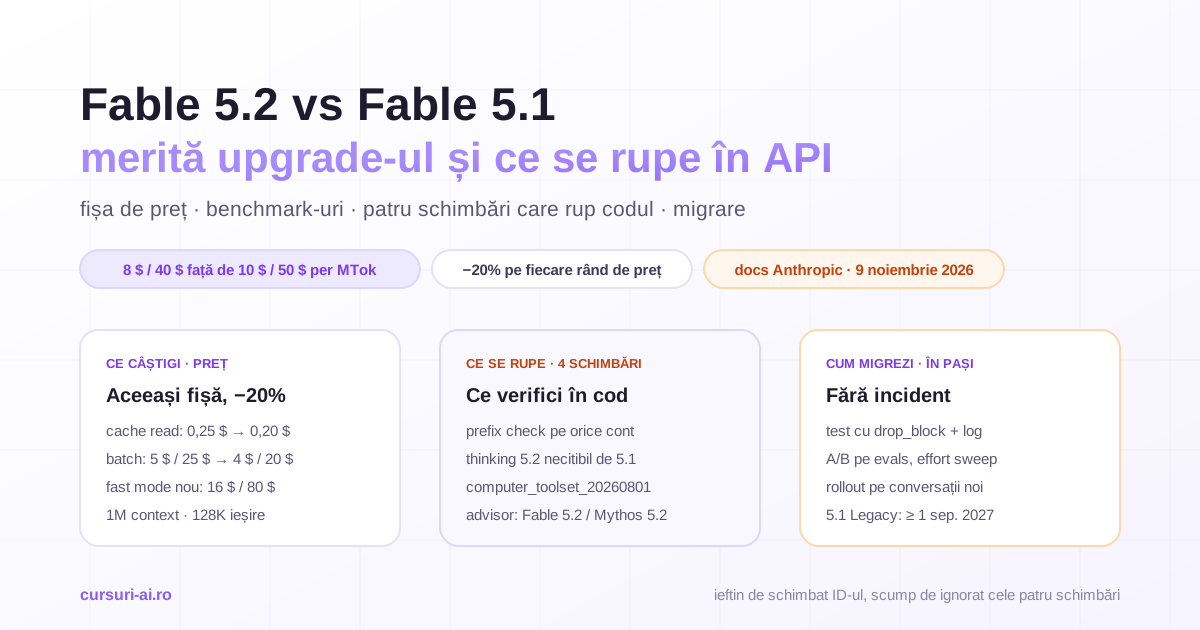
Cincisprezece rulări separă un model care pică sistematic de unul care trece, nu 69,9% de 65,5%; pentru asta ai nevoie de setul complet din cum evaluezi un model AI în producție. Iar dacă ruta rulează azi pe Fable 5.1, trecerea are capcanele ei de API, în Fable 5.2 vs Fable 5.1.
Întrebări frecvente
Este Claude Fable 5.2 mai bun decât GPT-6 Astra?
În tabelul Anthropic, Fable 5.2 e peste Astra pe toate rândurile unde amândouă au scor, iar în Artificial Analysis Intelligence Index v5 are 65 față de 57, ambele la max. La medium, Fable 5.2 are 56, sub Astra la max. Diferența pe sarcinile tale se măsoară, nu se citește din tabel.
Este Fable 5.2 mai bun decât Gemini 4 Carbon? Pe majoritatea rândurilor din tabelul Anthropic, da, dar nu pe AutomationBench (53,9% față de 51,4%). În indicele Artificial Analysis, Fable 5.2 (max) are 65, Carbon (high) 60. Carbon nu poate fi testat azi prin API.
Care e cel mai bun model AI în noiembrie 2026?
În Artificial Analysis Intelligence Index, la 10 noiembrie 2026, Claude Fable 5.2 la max e pe locul 1 din 74. Pe automatizări de business Carbon e înainte, iar pentru volum GPT-6.1 Sol și Argon costă mult mai puțin.
De ce costă GPT-6 Astra mai mult la documente lungi? Peste 272.000 de tokeni de intrare, OpenAI aplică pe toată cererea 2× la intrare și cache și 1,5× la ieșire: 20 $ / 75 $. Un prompt de 400.000 de tokeni cu 20.000 de ieșire costă 9,50 $ pe Astra și 4,00 $ pe Fable 5.2, care nu are suprataxă.
Pot folosi Gemini 4 Carbon azi? Nu: la 10 noiembrie 2026 nu apare în Gemini API, iar accesul merge la apărători cibernetici, prin Fairwind. Alternativa Google de azi e Gemini 4 Argon, cu prețul dublat de la 1 decembrie.
Concluzie
Pe hârtie, Fable 5.2 vs GPT-6 Astra se încheie în favoarea lui Fable 5.2: scoruri mai mari pe aproape tot tabelul Anthropic, primul loc în indicele Artificial Analysis și un preț mai mic, mai ales peste 272K tokeni. Dar tabelul e al Anthropic, Carbon câștigă automatizările de business, la medium Fable 5.2 coboară sub ceilalți doi în indicele independent, iar retenția obligatorie de 30 de zile poate elimina modelul înainte de orice benchmark. Carbon rămâne de urmărit până intră în API, iar pentru volum niciunul dintre cei trei nu e răspunsul. Decizia vine din cinci sarcini proprii, notate orb, cu costul per sarcină reușită, rulate printr-un strat care îți permite să muți o rută pe alt model fără refactor.
Surse
- Anthropic, „Introducing Claude Fable 5.2 and Claude Mythos 5.2” (benchmark-uri, grafice de cost, retenție, disponibilitate): https://www.anthropic.com/claude-fable-and-mythos-5-2
- Anthropic Docs, Pricing (tarife, cache, Batch, fast mode,
inference_geo): https://platform.claude.com/docs/en/about-claude/pricing - OpenAI, GPT-6 Astra (preț, regula de 272K, Batch, Flex, fast, limite, cloud): https://developers.openai.com/api/docs/models/gpt-6-astra
- OpenAI, Data controls in the OpenAI platform (rezidența în Europa, eligibilitate, suprataxa de 10%): https://developers.openai.com/api/docs/guides/your-data
- Google AI Studio, prețurile Gemini API (Argon înainte și după 1 decembrie; Carbon nelistat): https://aistudio.google.com/docs/pricing
- Artificial Analysis, Claude Fable 5.2 (Intelligence Index v5, scor și cost per sarcină pe niveluri de effort): https://artificialanalysis.ai/models/claude-fable-5-2
Verificat la 10 noiembrie 2026 pe pagina de lansare Anthropic, pe documentația Anthropic, OpenAI și Google și pe Artificial Analysis. Cifrele de benchmark sunt raportate de Anthropic (safeguard-uri active, effort maxim disponibil, dacă nu e notat altfel), nu măsurători proprii. Prețul lui Carbon e cel anunțat de Google. Calculele de cost sunt ilustrative, cu ipoteze declarate.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.