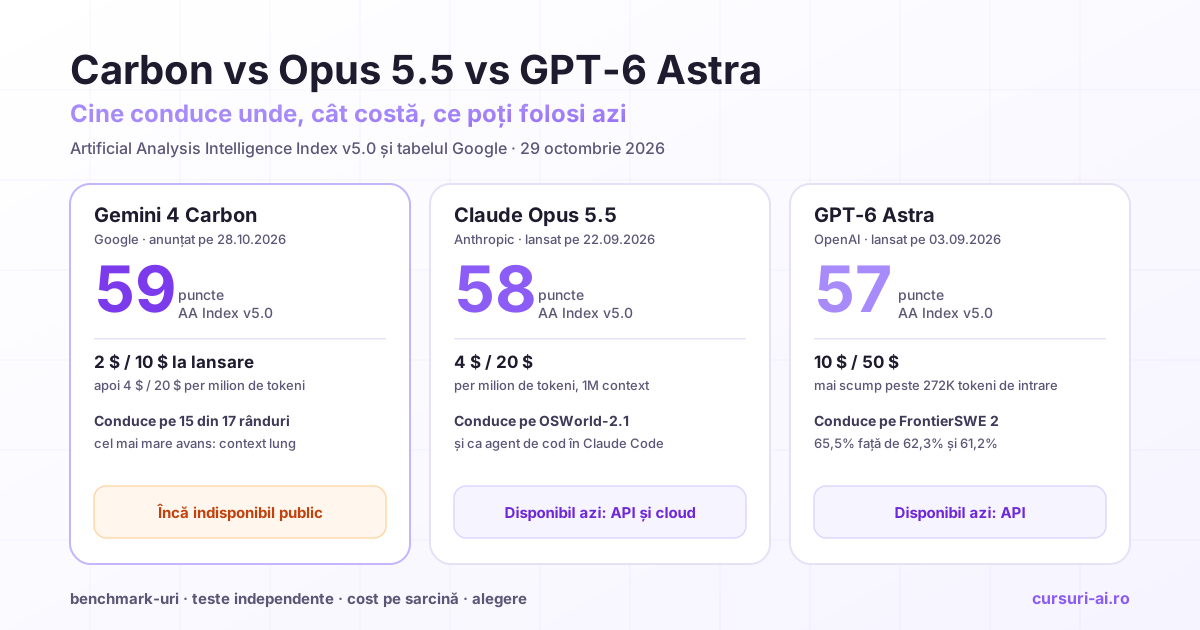
Gemini 4 Carbon, Claude Opus 5.5 și GPT-6 Astra sunt, la 29 octombrie 2026, primele trei modele din Artificial Analysis Intelligence Index v5.0, la câte un punct unul de altul: 59, 58 și 57. Pentru o echipă care alege un model, clasamentul spune puțin. Contează trei întrebări: pe ce sarcini câștigă fiecare, cât costă aceeași sarcină și ce poți folosi azi. La ultima, răspunsul scurt e că Carbon nu e încă disponibil public. Decizia de azi rămâne între Opus 5.5 și GPT-6 Astra, sau variantele lor mai ieftine, iar Carbon e modelul pe care îl pregătești pentru test.
Pe scurt: cine conduce unde
| Ce te interesează | Cine conduce în cifrele publicate | Sursa |
|---|---|---|
| Indice general | Carbon 59, Opus 5.5 58, GPT-6 Astra 57 | Artificial Analysis v5.0 |
| Agent în terminal (Terminal-Bench 4.0) | Carbon 65,2%; Opus 5.5 59,6%; Astra 59,1% | tabelul Google, cifre AA |
| Inginerie software (FrontierSWE 2) | GPT-6 Astra 65,5%; Opus 5.5 62,3%; Carbon 61,2% | tabelul Google |
| Computer use (OSWorld-2.1 offline) | Opus 5.5 87,2%; Carbon 81,5%; Astra 80,9% | tabelul Google |
| Agent de cod ca produs | Claude Code cu Opus 5.5: 62; Carbon în Antigravity CLI: 59 | AA Coding Agent Index, prin VentureBeat |
| Documente foarte lungi (256K–1M tokeni) | Carbon 96,2%; Astra 71,8%; Opus 5.5 66,8% | tabelul Google |
| Automatizări de business (Zapier) | Carbon 53,9%; Opus 5.5 42,5%; Astra 41,4% | tabelul Google |
| Sarcini juridice, financiare, fiscale | Carbon 70,4%, Opus 5.5 70,2%, practic la egalitate | Vals Index v2.2 |
| Preț de listă | Carbon introductiv 2 $ / 10 $; Opus 5.5 4 $ / 20 $; Astra 10 $ / 50 $ | paginile oficiale |
| Disponibil azi | Opus 5.5 și GPT-6 Astra; Carbon nu | paginile oficiale |
Pe scurt: Carbon are cele mai multe rânduri câștigate, dar avansul e mic pe indicele general și pe sarcinile profesionale. Opus 5.5 rămâne în față pe computer use și ca agent de cod în propriul instrument, iar GPT-6 Astra pe ingineria software măsurată de FrontierSWE. Cel mai mare avans al lui Carbon e pe contextul lung.
Diferența dintre a citi un tabel de lansare și a alege un model pentru producție e metodologia: aceleași sarcini, același instrument de rulare, același nivel de gândire pentru toate modelele. Fiecare producător își alege benchmark-urile în care iese bine, iar cifrele competitorilor vin din surse diferite. Cum citești corect un benchmark, cum construiești o evaluare proprie și cum calculezi costul total al unui model sunt subiectele din Comparație Modele AI 2026, cursul care compară familiile Anthropic, OpenAI și Google pe sarcini reale.
Tabelul complet publicat de Google
Google a publicat pe 28 octombrie un tabel cu 17 rânduri. Îl transcriem integral, cu Gemini 4 Argon și Claude Fable 5.1 ca repere. Cu bold e liderul fiecărui rând, așa cum îl marchează Google.
| Benchmark | Carbon | Opus 5.5 | GPT-6 Astra | Argon | Fable 5.1 |
|---|---|---|---|---|---|
| AA Index v5.0 | 59 | 58 | 57 | 50 | 49 |
| Vals Index v2.2 | 70,4% | 70,2% | 65,0% | 69,2% | — |
| SWE-sweep | 9,6% | 3,6% | 9,5% | 4,3% | 2,9% |
| FrontierSWE 2 | 61,2% | 62,3% | 65,5% | 55,0% | 56,3% |
| Terminal-Bench 4.0 (AA) | 65,2% | 59,6% | 59,1% | 57,1% | 52,0% |
| Agents' Last Exam v1.1 | 77,4% | 71,6% | 73,1% | 69,0% | — |
| OSWorld-2.1 (offline) | 81,5% | 87,2% | 80,9% | 74,7% | 76,8% |
| AutomationBench (Zapier) | 53,9% | 42,5% | 41,4% | 51,3% | 31,4% |
| Vending-Bench 2 (sold, $) | 16.484 | 9.235 | 15.515 | 13.718 | 5.422 |
| Chartography | 72,5% | 66,3% | 71,0% | 71,6% | 46,2% |
| Blueprint-Bench 2 | 58,6% | 51,2% | 49,7% | 54,4% | 41,9% |
| GraphWalks (256K–1M) | 96,2% | 66,8% | 71,8% | 84,2% | 65,0% |
| RiemannBench | 80,0% | 69,6% | 72,0% | 76,0% | 65,6% |
| Terminal-Bench-Science 0.1 (AA) | 64,8% | 59,0% | 63,3% | 52,9% | 43,3% |
| CWE-bench | 71,0% | 67,0% | 68,0% | 68,0% | 58,0% |
| ExploitGym | 54,8% | 34,5% | 42,4% | 42,0% | — |
| SEC-bench Pro | 88,2% | — | 85,4% | 83,4% | — |
„—” înseamnă că Google nu a avut un rezultat publicat pentru modelul respectiv. Rândurile de securitate (ultimele trei) sunt tratate pe larg în Gemini 4 Carbon în securitate cibernetică.
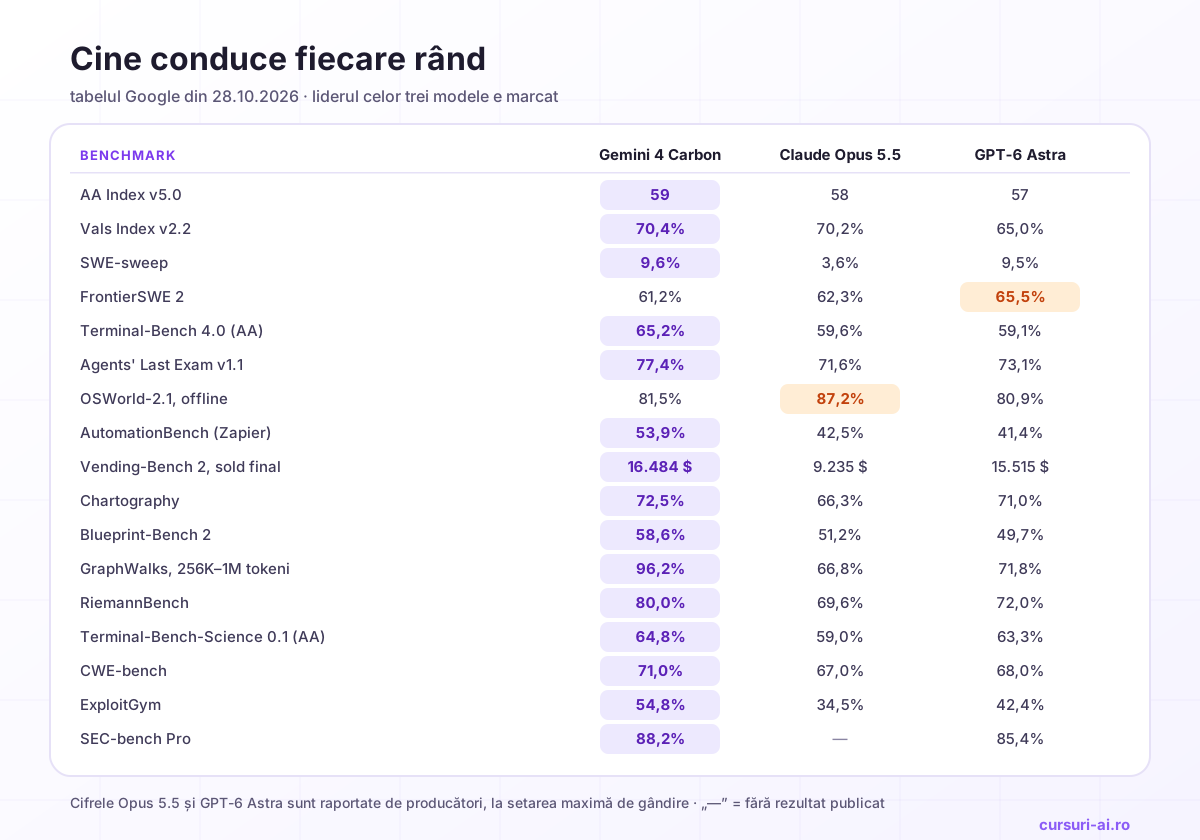
Cum citești corect tabelul
Documentul de metodologie al Google explică de unde vine fiecare cifră. Șase detalii schimbă lectura:
- Cifrele competitorilor sunt cele raportate de producători. Pentru GPT-6 Astra, Opus 5.5 și Fable 5.1, Google preia rezultatele publicate de OpenAI și Anthropic sau din clasamentele publice, la setarea maximă de gândire disponibilă. Când acestea lipsesc, folosește „cel mai bun rezultat disponibil”.
- Carbon rulează la cea mai mare setare de gândire, prin Gemini API. Scorurile Gemini sunt pass@1, o singură încercare, fără vot majoritar. Pe benchmark-urile mici, Google face media mai multor rulări.
- Instrumentul de rulare diferă. Pe CWE-bench, graficul Google arată Carbon rulat în Antigravity, GPT-6 Astra în Codex și Opus 5.5 în Claude Code. Pe OSWorld, scorul lui Carbon e cel mai bun din trei rulări, iar ale celorlalți vin din fișele lor tehnice.
- Limitele de timp diferă. Pe ExploitGym, cele 54,8% ale lui Carbon sunt cu o limită de 10 ore pe sarcină. La limita standard de 6 ore, Carbon are 53,5%, Opus 5.5 are 34,5%, iar GPT-6 Astra are 42,4% fără limită de timp.
- Pe SWE-sweep, scorul lui Carbon e calculat de Google, cu harness-ul open-source mini-swe-agent, iar ceilalți vin din clasamentul public al benchmark-ului. Comparația e orientativă.
- Nu există intervale de încredere. VentureBeat observă că tabelul nu dă marje de eroare. Diferențele de sub un punct, cum e 70,4% față de 70,2% pe Vals, sunt practic egalități.
De ce Claude Fable 5.1 apare sub Opus 5.5
Fable 5.1 e cel mai scump model Anthropic (10 $ / 50 $), dar în tabelul Google e sub Opus 5.5 pe aproape toate rândurile, iar pe indicele AA are 49 față de 58. Nu e o eroare de transcriere: și pe Artificial Analysis, Fable 5.1 (Max) are 49,0, iar Opus 5.5 (Max) 58,4. Anthropic însăși recomandă, în prezentarea modelelor, să pornești cu Opus 5.5 pentru majoritatea sarcinilor și să treci pe Fable 5.1 pentru raționament exigent și muncă agentică lungă sau când evaluările tale pe Opus 5.5, la efort mai mare, tot nu ajung. Când merită diferența de preț e analizat în Claude Opus 5.5 vs Fable 5.1.
Ce spun măsurătorile independente
Tabelul Google e tabelul unui producător. Evaluatorii independenți au publicat cifre la lansare, iar lectura lor e mai nuanțată.
Artificial Analysis Intelligence Index v5.0. Pe pagina indexului: Carbon (High) 59,4, Opus 5.5 (Max) 58,4, GPT-6 Astra (Max) 56,9, GPT-6.1 Sol (Max) 54,5, Fable 5.1 (Max) 49,0. De observat: Carbon e măsurat la setarea High, ceilalți la Max. Versiunea 5 a indicelui e nouă și mai grea, deci scorurile nu se compară cu cele din versiunile anterioare.
Artificial Analysis Coding Agent Index. Aici se măsoară agentul de cod complet, adică model plus instrument. Potrivit VentureBeat, Claude Code cu Opus 5.5 conduce cu 62 de puncte, iar Carbon prin Antigravity CLI are 59, la egalitate cu Claude Code cu Sonnet 5.5. Pentru o echipă care lucrează deja în Claude Code, acesta e reperul mai relevant decât un benchmark rulat în harness-ul producătorului.
AA-Omniscience (cunoștințe factuale). Carbon are cel mai mare scor (54), cu șase puncte peste Opus 5.5 la Max. Răspunde corect la 58% din întrebări, față de 48% la Argon, dar rata de halucinare raportată crește de la 4% la 11%. Metodologia o calculează ca răspunsuri greșite împărțite la răspunsurile greșite, parțial corecte și neatinse. Carbon știe mai mult, dar, când nu știe, răspunde greșit mai des în loc să se abțină.
Vals Index v2.2 (juridic, finanțe, fiscal, cod). Vals AI îl pune pe Carbon pe locul 2 din 29, cu 70,36%. Pe primul loc e Claude Sonnet 5.5, cu 70,85%, un model care nu apare în tabelul Google și costă 2 $ / 10 $. Opus 5.5 e al treilea, cu 70,18%. Carbon conduce pe Legal Research Bench (55,77%, locul 1 din 87). Pentru sarcini juridice și financiare, cele trei modele sunt practic la egalitate, iar Sonnet 5.5 e o alternativă mai ieftină la Opus 5.5.
Vending-Bench 2 (Andon Labs). Simulează administrarea unei afaceri cu automate pe o perioadă lungă. Carbon încheie cu 16.484 $, GPT-6 Astra cu 15.515 $, Opus 5.5 cu 9.235 $. E un test de coerență pe termen lung, nu o măsură a veniturilor reale ale cuiva.
Prețul: cât costă aceeași sarcină pe fiecare model
| Model | Intrare / ieșire (per 1M tokeni) | Intrare din cache | Context lung | Disponibil azi |
|---|---|---|---|---|
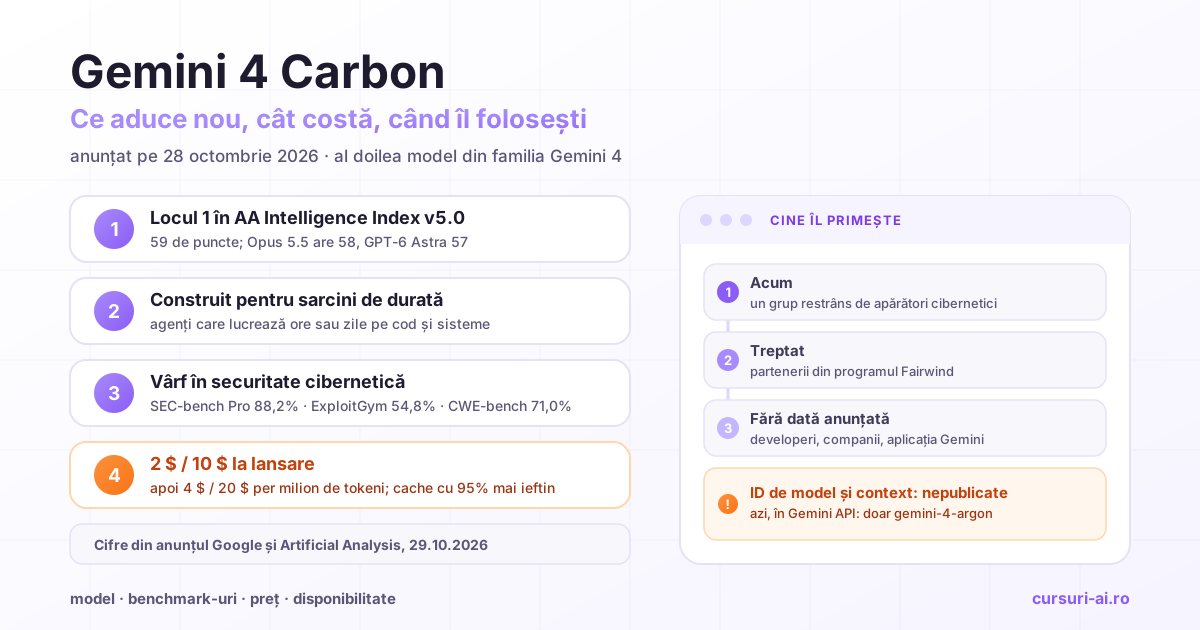
| Gemini 4 Carbon | 2 $ / 10 $ introductiv, apoi 4 $ / 20 $ | −95% (0,10 $ introductiv) | neanunțat | nu |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,20 $ | 1M tokeni la preț standard | da (API, Bedrock, Google Cloud, Foundry) |
| GPT-6 Astra | 10 $ / 50 $ | 1 $ | peste 272K tokeni de intrare: 2× intrarea, 1,5× ieșirea | da (Responses și Chat Completions) |
| GPT-6.1 Sol | 2 $ / 10 $ | 0,10 $ | aceeași regulă de 272K | da |
| Claude Fable 5.1 | 10 $ / 50 $ | 0,25 $ | 1M tokeni la preț standard | da |
Surse: anunțul Google pentru Carbon, pagina de prețuri Anthropic și pagina GPT-6 Astra din documentația OpenAI. Ambele companii taie prețul cu 50% pe procesarea în lot (Batch).
Două calcule pe prețul de listă, pentru o sarcină de agent fără cache:
Sarcina 1: 200.000 de tokeni de intrare și 20.000 de ieșire.
- Carbon, introductiv: 0,40 $ + 0,20 $ = 0,60 $; după perioada introductivă: 1,20 $
- Opus 5.5: 0,80 $ + 0,40 $ = 1,20 $
- GPT-6 Astra: 2,00 $ + 1,00 $ = 3,00 $
- GPT-6.1 Sol: 0,60 $
Sarcina 2: 400.000 de tokeni de intrare și 20.000 de ieșire, adică peste pragul OpenAI de 272.000:
- Opus 5.5: 1,60 $ + 0,40 $ = 2,00 $
- Carbon la prețul ulterior: 2,00 $, dacă Google nu introduce un tarif de context lung
- GPT-6 Astra: 400.000 × 20 $ + 20.000 × 75 $ per milion = 8,00 $ + 1,50 $ = 9,50 $
Prețul per token nu e costul per sarcină. Fiecare model consumă un număr diferit de tokeni de gândire pentru aceeași problemă, iar aceștia se facturează ca ieșire. La Opus 5.5, gândirea nu se poate dezactiva. Un model mai scump per token poate termina sarcina cu mai puțini tokeni sau din mai puține încercări. Singura cifră care contează e cea măsurată pe sarcinile tale. Calcule pe sarcini reale pentru doi dintre concurenți găsești în GPT-6.1 Sol vs Claude Opus 5.5.
Ce alegi azi, pe tip de sarcină
Carbon nu e disponibil, deci alegerea de azi se face între modelele pe care le poți apela. Iată ce susțin cifrele de mai sus:
- Lucrezi în Claude Code sau construiești agenți de cod: Opus 5.5. Conduce indicele independent al agenților de cod și OSWorld. Dacă bugetul e strâns, Sonnet 5.5 are același scor ca Carbon pe Coding Agent Index, la jumătate din prețul lui Opus.
- Inginerie software pe depozite mari, sarcini lungi: GPT-6 Astra conduce FrontierSWE 2 și e la egalitate cu Carbon pe SWE-sweep. Costă de 2,5 ori mai mult decât Opus 5.5 per token, iar peste 272.000 de tokeni de intrare se scumpește pe toată cererea. Cum îl integrezi fără surprize de cost e în GPT-6 Astra în API.
- Documente foarte lungi: aici e cel mai mare avans al lui Carbon (96,2% pe GraphWalks). Dar și Argon, disponibil azi, are 84,2%, peste GPT-6 Astra (71,8%) și Opus 5.5 (66,8%), la 2 $ / 10 $ până la 30 noiembrie. E singurul caz în care tabelul Google recomandă practic un model Google pe care îl poți folosi deja.
- Automatizări de business în stil Zapier: același tablou. Argon are 51,3% pe AutomationBench, peste Opus 5.5 (42,5%) și Astra (41,4%).
- Analiză juridică, financiară, fiscală: cele trei sunt la egalitate pe Vals, iar Sonnet 5.5 e chiar puțin peste. Alege după ecosistem, cost și condițiile de prelucrare a datelor.
- Buget mic, volum mare: GPT-6.1 Sol și Argon, ambele la 2 $ / 10 $ (Argon până la 30 noiembrie).
Cum îți faci propriul test când apare Carbon
Tabelele de lansare îți spun pe ce să testezi, nu ce să alegi. Un protocol minim, aplicabil din ziua în care Carbon intră în API:
- Alege 20–50 de sarcini reale din backlog-ul echipei, cu rezultat verificabil: un test care trece, un câmp extras corect, un răspuns confirmat de un specialist.
- Rulează toate modelele în același instrument, cu aceleași unelte și cu nivelul de gândire notat pentru fiecare. Altfel compari harness-uri, nu modele.
- Măsoară patru lucruri: rata de reușită, tokenii consumați, costul total și numărul de intervenții umane.
- Verifică separat afirmațiile factuale. Rezultatul AA-Omniscience arată că un model mai bun la sarcini poate inventa mai des când nu știe.
- Pune un strat de rutare între aplicație și furnizori, ca să poți muta o categorie de sarcini pe alt model fără să rescrii codul.
Setul de evaluare, judecătorul automat și integrarea în CI sunt subiectul cursului AI Evals pentru LLM-uri în Producție, iar rutarea, fallback-ul și controlul costurilor în aplicații reale sunt tratate în Integrare Avansată LLM în Aplicații de Producție. Pentru o primă trecere prin subiect, vezi și cum evaluezi un model AI în producție.
Întrebări frecvente
Este Gemini 4 Carbon mai bun decât Claude Opus 5.5? Pe cele mai multe rânduri din tabelul Google, da, și cu un punct pe indicele Artificial Analysis (59 față de 58). Opus 5.5 rămâne însă în față pe computer use (OSWorld-2.1 offline: 87,2% față de 81,5%) și ca agent de cod în Claude Code (62 față de 59 pe Coding Agent Index). Pe sarcinile juridice și financiare din Vals Index sunt la egalitate.
Este Gemini 4 Carbon mai bun decât GPT-6 Astra? Pe 16 din 17 rânduri din tabelul Google, Carbon are scorul mai mare, iar pe indicele AA are 59 față de 57. Excepția e FrontierSWE 2, unde GPT-6 Astra conduce cu 65,5% față de 61,2%. Pe SWE-sweep diferența e de o zecime de punct.
Care dintre cele trei modele e cel mai ieftin? Pe prețul de listă, Carbon în perioada introductivă (2 $ / 10 $ per milion de tokeni). După perioada introductivă, Carbon și Opus 5.5 au același preț (4 $ / 20 $), iar GPT-6 Astra costă de 2,5 ori mai mult (10 $ / 50 $), cu suprataxă peste 272.000 de tokeni de intrare. Costul real pe sarcină depinde de câți tokeni consumă fiecare.
Pot folosi azi Gemini 4 Carbon în locul lui Opus 5.5 sau GPT-6 Astra? Nu. Carbon e disponibil doar pentru un grup restrâns de apărători cibernetici și, treptat, pentru partenerii din programul Fairwind. Google nu a anunțat data pentru developeri și companii. Detaliile sunt în ce este Gemini 4 Carbon.
Ce model aleg azi pentru agenți de cod? Dacă lucrezi în Claude Code, Opus 5.5, care conduce indicele independent al agenților de cod, sau Sonnet 5.5, dacă vrei un cost mai mic. Pentru sarcini lungi pe depozite mari, GPT-6 Astra e liderul pe FrontierSWE 2. Testează pe sarcinile tale înainte să decizi: diferențele dintre modele sunt de câteva puncte.
Pot avea încredere în tabelul publicat de Google? Ca punct de plecare, da. Cifrele competitorilor sunt cele raportate de ei înșiși, iar metodologia e publicată. Dar benchmark-urile sunt alese de Google, instrumentele de rulare și limitele de timp diferă de la un model la altul, iar tabelul nu are marje de eroare. Măsurătorile independente de la Artificial Analysis și Vals AI confirmă locul întâi pe indicele general, dar arată și unde Carbon nu conduce.
Concluzie
Gemini 4 Carbon, Claude Opus 5.5 și GPT-6 Astra sunt foarte aproape pe indicele general. Carbon câștigă cele mai multe rânduri din tabelul Google și are un avans mare pe contextul lung și pe securitate. Opus 5.5 rămâne liderul pe computer use și ca agent de cod în Claude Code, iar GPT-6 Astra pe FrontierSWE 2. Testele independente adaugă două nuanțe: Claude Sonnet 5.5 e pe primul loc la Vals, peste toate trei, iar Carbon are o rată de halucinare mai mare decât Argon pe întrebările factuale. La preț, Carbon pornește cel mai jos, apoi ajunge la nivelul lui Opus 5.5, iar Astra rămâne cel mai scump. Cum Carbon nu e încă disponibil, decizia practică de azi se ia pe Opus 5.5, GPT-6 Astra sau variantele lor mai ieftine, iar Argon e o alegere solidă pentru documente lungi. Carbon intră în comparație în ziua în care îl poți rula pe sarcinile tale.
Surse
- Google, „Gemini 4 Carbon: our next frontier model”, 28 octombrie 2026
- Google DeepMind, metodologia evaluării Gemini 4 Carbon (PDF)
- Artificial Analysis Intelligence Index v5.0
- Vals AI, Gemini 4 Carbon pe Vals Index v2.2
- Anthropic, prezentarea modelelor Claude și prețurile API
- OpenAI, GPT-6 Astra în documentația API
- VentureBeat, analiza lansării Gemini 4 Carbon și rezultatele Artificial Analysis, 28 octombrie 2026
Comparație realizată la 29 octombrie 2026 pe surse oficiale (Google, Anthropic, OpenAI) și pe evaluările publicate de Artificial Analysis și Vals AI, citate direct sau prin VentureBeat. Nu sunt măsurători proprii. Gemini 4 Carbon nu e încă disponibil public, iar prețurile și clasamentele se pot schimba.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.