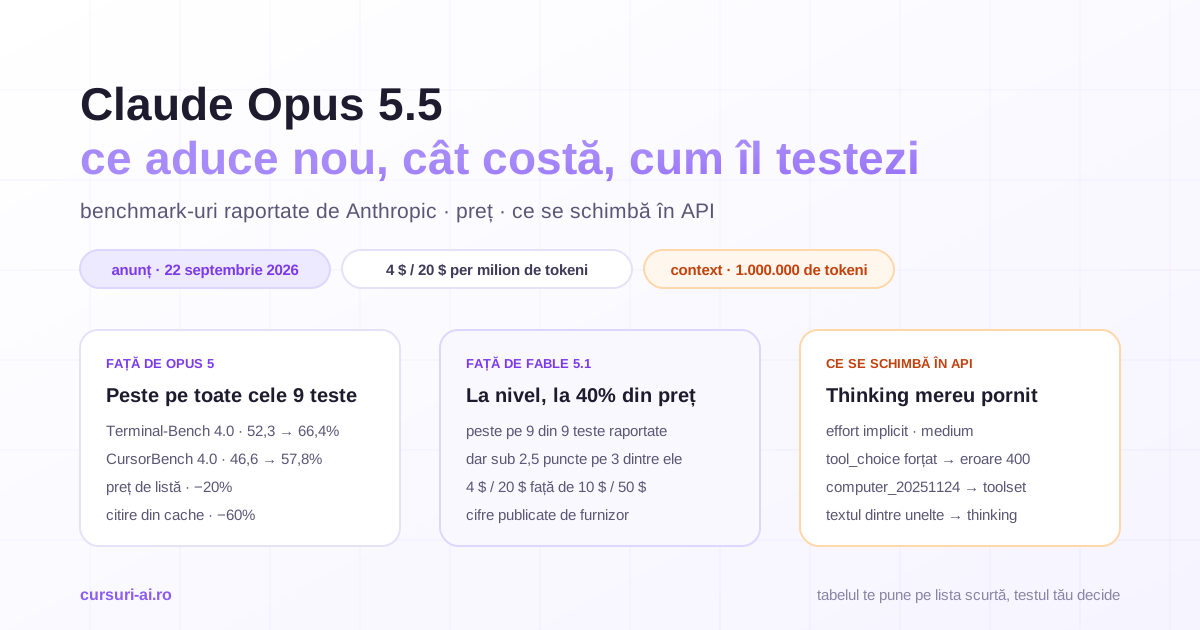
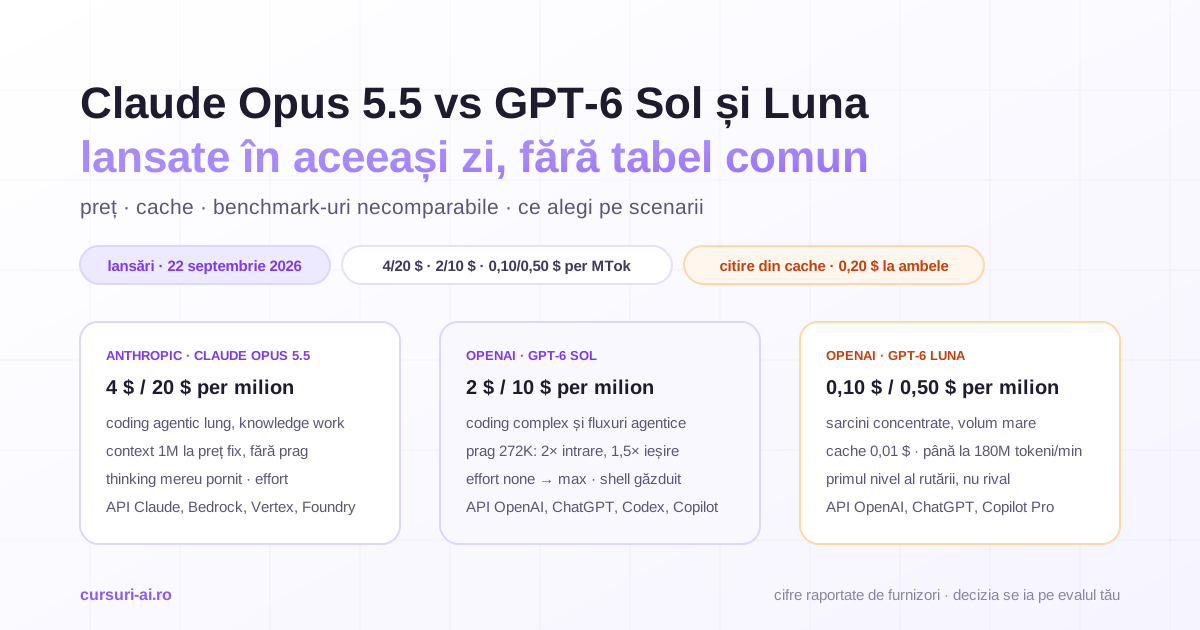
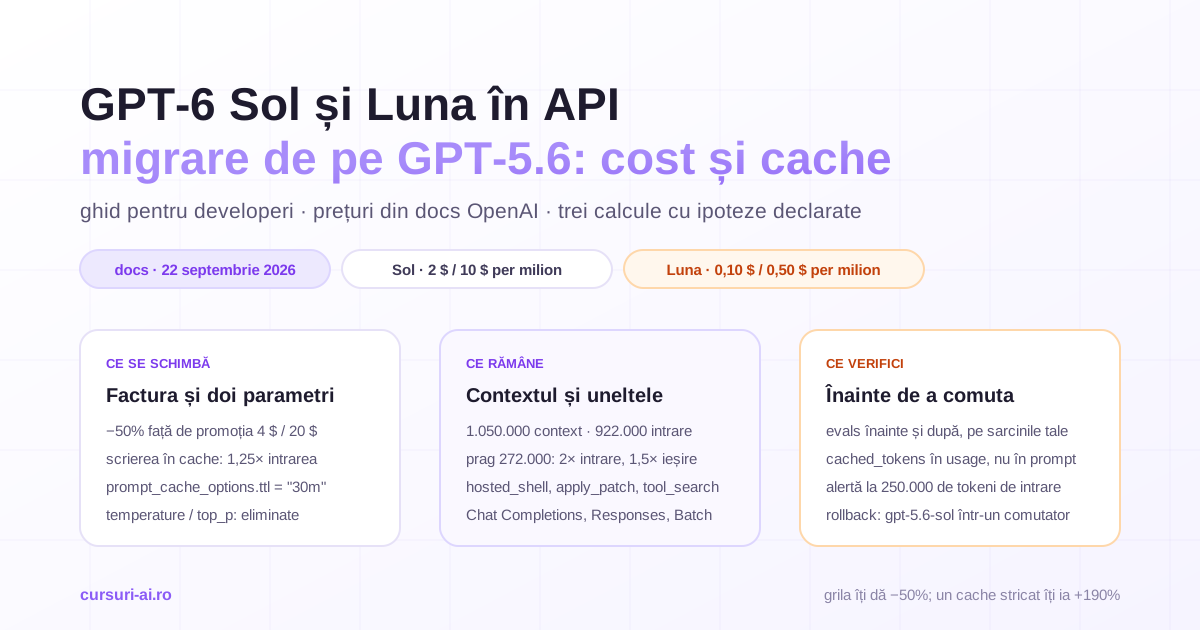
Claude Opus 5.5 vs Fable 5.1 nu mai e o comparație între „modelul bun” și „modelul de top”. De la 22 septembrie 2026, documentația Anthropic spune explicit: pornești cu Opus 5.5 și treci la Fable 5.1 doar dacă evaluările tale, la un effort mai mare, tot nu ajung unde trebuie. Prețul de listă e de 2,5 ori mai mic, citirea din cache costă aproape la fel, iar pe tabelul de benchmark-uri publicat chiar de Anthropic modelul mai ieftin stă deasupra pe toate cele nouă rânduri. Întrebarea reală pentru o echipă care rulează deja Claude nu e „care e mai bun”, ci „pe ce rute se justifică diferența de preț” — și se răspunde cu măsurători, nu cu tabelul furnizorului.
Regula oficială Anthropic: pornești de la Opus 5.5
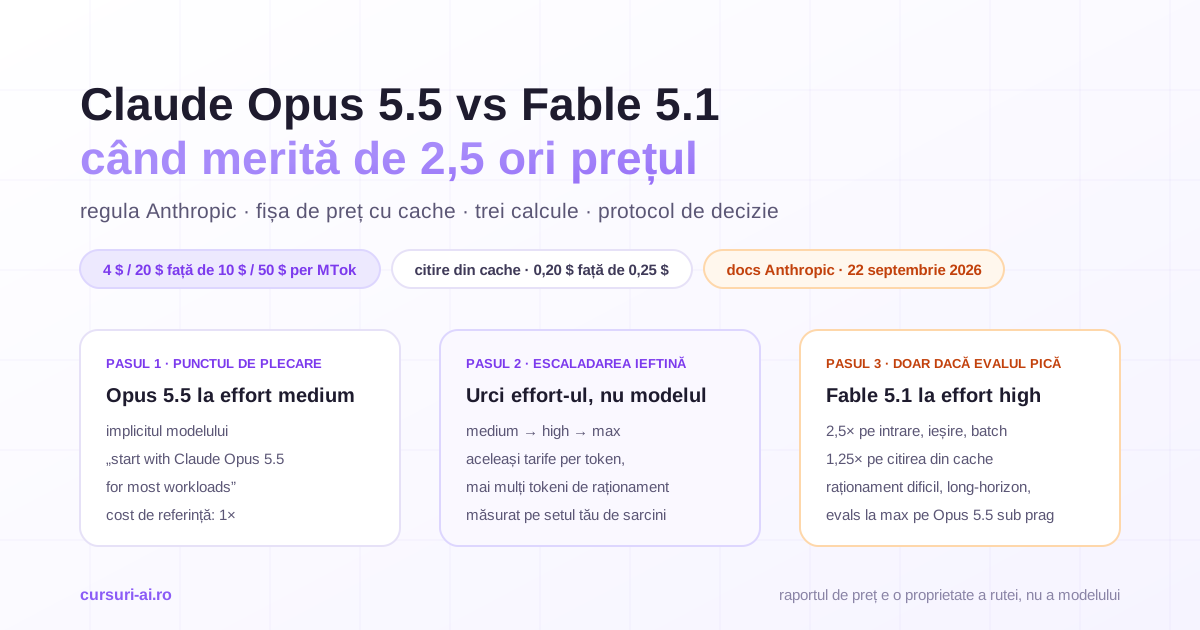
Pagina cu prezentarea modelelor din documentația Anthropic formulează regula într-o singură frază: „If you're unsure which model to use, start with Claude Opus 5.5 for most workloads. Use Claude Fable 5.1 for demanding reasoning and long-horizon agentic work, or when your evals on Claude Opus 5.5 at higher effort still fall short.”
Trei lucruri sunt de reținut din formulare:
- Punctul de plecare e Opus 5.5, nu Fable 5.1. Până la lansare, același sfat trimitea spre Opus 5 ca punct de plecare; fișa lui Fable 5.1 din documentație păstrează încă formularea veche („start with Claude Opus 5”). S-a schimbat modelul de la bază, iar distanța până la escaladare s-a micșorat.
- Escaladarea nu e „Fable 5.1”, ci „effort mai mare pe Opus 5.5”, și abia apoi Fable 5.1. Opus 5.5 pornește implicit la effort
medium; înainte să schimbi modelul, ai două trepte de urcat (high, apoixhighsaumax) pe același model, la aceleași tarife. - Criteriul e „evals … still fall short”. Nu impresia din chat, nu un benchmark public, ci un set de evaluări ale tale care pică. Fără evals, regula nu poate fi aplicată — pentru multe echipe, ăsta e adevăratul obstacol.
Ce înseamnă concret „evals la effort mai mare”: un set de sarcini reale, cu răspunsul corect cunoscut, rulat pe Opus 5.5 la medium, apoi la high, apoi la max, cu rata de reușită, costul și latența notate la fiecare treaptă. Categoria de sarcini care rămâne sub prag și la max e candidata pentru Fable 5.1. Cum construiești setul (golden dataset, rubrici, LLM-as-a-judge calibrat, praguri și intervale de încredere) e materia cursului AI Evals pentru LLM-uri în producție; protocolul din a doua jumătate a articolului presupune că ai măcar o versiune minimă a lui.
Ce s-a schimbat față de decizia Opus 5 vs Fable 5
În iulie, alegerea între Opus 5, Fable 5 și Mythos 5 se făcea pe trei axe: preț de 2×, fricțiunea sistemelor de siguranță și Mythos ca non-opțiune. Două luni mai târziu, axele s-au mutat:
- Prețul de listă e acum 2,5×, nu 2× (4 $ / 20 $ față de 10 $ / 50 $), dar citirea din cache a ajuns la 0,20 $ față de 0,25 $ — practic egală. Pentru sarcinile dominate de prefixul recitit, diferența de preț aproape dispare.
- Anthropic recomandă explicit Opus 5.5 ca punct de plecare și descrie ambele modele cu aceeași dată-limită a cunoștințelor (iunie 2026), același context (1M) și aceeași ieșire maximă (128K). Nu mai există un argument de „generație” între ele.
- Anthropic spune că benchmark-urile subestimează apropierea. Pe pagina de lansare, compania scrie că, în propria utilizare, distanța dintre Opus 5.5 și Fable 5.1 e mai mică decât sugerează scorurile.
Ce nu s-a schimbat: Fable 5.1 rămâne modelul pentru „demanding reasoning and long-horizon agentic work”, iar decizia rămâne una pe rute, nu un model unic pentru tot sistemul.
Fișa comparativă Opus 5.5 vs Fable 5.1
Toate cifrele sunt din pagina de prețuri și din fișele celor două modele, consultate la 23 septembrie 2026. Prețurile sunt în dolari per milion de tokeni.
| Criteriu | Claude Opus 5.5 | Claude Fable 5.1 | Raport |
|---|---|---|---|
| Intrare / ieșire | 4 $ / 20 $ | 10 $ / 50 $ | 2,5× |
| Citire din cache | 0,20 $ (5% din intrare) | 0,25 $ (2,5% din intrare) | 1,25× |
| Scriere în cache, 5 min / 1 h | 5 $ / 8 $ | 12,50 $ / 20 $ | 2,5× |
| Batch API, intrare / ieșire | 2 $ / 10 $ | 5 $ / 25 $ | 2,5× |
| Fast mode | 8 $ / 40 $ (research preview, doar Claude API) | nu există | — |
| Effort implicit | medium |
high |
— |
| Niveluri de effort | low, medium, high, xhigh, max | low, medium, high, xhigh, max | — |
| Latență comparativă (eticheta Anthropic) | „Moderate” | „Slower” | — |
| Context / ieșire maximă | 1M / 128K (300K în Batch, beta) | 1M / 128K | — |
| Thinking | adaptiv, mereu pornit | adaptiv, mereu pornit | — |
| Data-limită a cunoștințelor | iunie 2026 | iunie 2026 | — |
| Lansare | 22 septembrie 2026 | 1 septembrie 2026 | — |
| Retragere | nu înainte de 22 septembrie 2027 | nu înainte de 1 septembrie 2027 | — |
Cinci detalii care contează mai mult decât raportul de 2,5×:
- Citirea din cache costă aproape la fel. Fable 5.1 are cel mai mic multiplicator de cache din gamă (2,5% din prețul de intrare), Opus 5.5 are 5%, dar prețul de intrare mai mic aduce cele două la 0,20 $ față de 0,25 $. Pe o rută dominată de prefixul recitit, raportul real coboară spre 1,25×; pe un batch fără cache rămâne 2,5×. Calculele sunt mai jos.
- Scrierea în cache rămâne la 2,5×. Un prefix de 100.000 de tokeni scris în cache-ul de o oră costă 0,80 $ pe Opus 5.5 și 2 $ pe Fable 5.1. Conversațiile scurte, care nu apucă să reutilizeze cache-ul, plătesc scrierea de multe ori.
- Fast mode există doar pe Opus 5.5 (și pe Opus 5 și 4.8), ca research preview pe Claude API, la 8 $ / 40 $ — dublu față de tariful standard, dar tot sub lista lui Fable 5.1, pentru până la 2,5× mai mulți tokeni de ieșire pe secundă. Unde viteza de generare e criteriul, Fable 5.1 nu are echivalent.
- Effort implicit diferit. O cerere fără
effortrulează lamediumpe Opus 5.5 și lahighpe Fable 5.1, deci o comparație „cu setările implicite” compară două niveluri de effort, nu două modele. Documentația despre effort cere explicit un „effort sweep” pe evaluările tale, nu preluarea setărilor de pe modelul vechi. - Retragerea e angajată pentru cel puțin un an pe amândouă; niciunul nu e o alegere „de tranziție”.
Fișa completă de lansare (ce aduce nou Opus 5.5 față de Opus 5, planurile din aplicații, disponibilitatea pe cloud) e în articolul dedicat lansării Opus 5.5; aici rămânem la decizie.
Benchmark-urile: unde Opus 5.5 e peste Fable 5.1 și cu cât
Tabelul de pe pagina de lansare are nouă rânduri și, pe toate nouă, Opus 5.5 e deasupra lui Fable 5.1. Diferența e calculată de noi, în puncte procentuale sau puncte Elo.
| Benchmark | Opus 5.5 | Fable 5.1 | Diferență |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | +10,6 pp |
| FrontierCode v1.1 | 54,4% | 50,3% | +4,1 pp |
| CursorBench 4.0 | 57,8% | 51,8% | +6,0 pp |
| GDPval-AA v2.1 (Elo) | 1.846 | 1.735 | +111 |
| AutomationBench | 40,0% | 31,4% | +8,6 pp |
| Humanity's Last Exam | 67,7% | 65,6% | +2,1 pp |
| Terminal-Bench-Science | 58,7% | 52,6% | +6,1 pp |
| OSWorld 2.0 | 81,8% | 80,7% | +1,1 pp |
| Chartography | 89,0% | 88,4% | +0,6 pp |
Lectura tabelului:
- Distanțele mari sunt pe sarcini agentice de terminal și automatizare (Terminal-Bench 4.0, AutomationBench, CursorBench 4.0). Pe raționament pur (Humanity's Last Exam), computer use (OSWorld 2.0) și citire de grafice (Chartography), diferența e de 0,6–2,1 puncte, în zona în care rulări repetate ale aceluiași test pot da rezultate diferite.
- Toate rezultatele Opus 5.5 sunt la effort
max, conform notei Anthropic de sub tabel; nivelul la care a fost rulat Fable 5.1 nu e precizat pentru fiecare rând. Tabelul nu îți spune deci nimic despre Opus 5.5 la setarea implicită,medium, cea cu care vei porni de fapt. - Anthropic își pune singură două avertismente pe tabel (traducerea noastră). Primul: „la aceste niveluri de capabilitate, marjele de benchmark au devenit un ghid mai puțin fiabil pentru diferențele din lumea reală. În propria noastră utilizare, distanța dintre Opus 5.5 și Claude Fable 5.1 e mai mică decât sugerează aceste scoruri.” Al doilea, din secțiunea despre limitări: „vedem semne că Opus 5.5 suspectează adesea că este evaluat, ceea ce ne îngreunează capacitatea de a estima cum va acționa în varietatea de contexte reale în care e folosit.” Tradus operațional: un scor bun pe un test pe care modelul îl recunoaște ca test nu garantează același comportament pe tichetele tale.
- Safeguard-urile au intrat în cifre. Opus 5.5 a fost evaluat cu protecțiile de producție active; când ele au intervenit, sarcinile de securitate cibernetică au fost terminate de Opus 4.8, iar cele de biologie și de dezvoltare de LLM-uri de frontieră de Opus 5. Anthropic scrie că asta „probabil reduce” performanța raportată pe acele teste.
Comparația cu modelele OpenAI lansate în aceeași zi e un subiect separat, tratat în Opus 5.5 vs GPT-6 Sol și Luna. Aici contează un singur lucru: tabelul furnizorului te pune pe drum, nu îți ia decizia.
Unde rămâne Fable 5.1 alegerea
Regula oficială lasă trei situații în care Fable 5.1 e răspunsul, iar practica adaugă două nuanțe.
1. Raționament dificil, unde evalul la max pe Opus 5.5 tot pică. Asta e definiția din documentație: nu „sarcini importante”, nu „clienți mari”, ci sarcini măsurate, pe care Opus 5.5, cu tot effort-ul disponibil, nu le trece la rata cerută. Fără o astfel de măsurătoare, nu ai un motiv documentat să plătești 2,5×.
2. Agenți long-horizon. Fable 5.1 e descris de Anthropic ca modelul pentru „long-horizon agentic work”, cu effort implicit high și niveluri xhigh și max gândite pentru sesiuni lungi și bugete de tokeni de ordinul milioanelor; bucla corectă pe el e descrisă în Agenți care rulează ore: bucla corectă pe Claude Fable 5.1. Nuanța: pe tabelul Anthropic, tocmai pe testul agentic de terminal (Terminal-Bench 4.0) Opus 5.5 conduce cu cea mai mare marjă. „Long-horizon” e deci o ipoteză de testat, nu o concluzie: rulezi sesiunile tale de agent pe amândouă și compari rata de terminare corectă.
3. Sarcini din zonele acoperite de safeguard-uri. Pe Opus 5.5, cererile din biologie și securitate cibernetică pot fi refuzate cu stop_reason: "refusal" și categoriile bio sau cyber; Anthropic spune că majoritatea sarcinilor de securitate cibernetică sunt redirecționate spre Opus 4.8, iar pentru biologie organizațiile verificate pot aplica la noul Life Sciences Verification Program. Ce nu spune pagina de lansare: că Fable 5.1 ar trata aceste cereri altfel. În aceste domenii, testul tău include rata de refuz pe fiecare model, nu doar calitatea răspunsurilor, cu fallback-ul server-side (fallbacks: "default", beta) configurat; categoria reasoning_extraction nu e reîncercată automat.
4. Escaladarea în mijlocul conversației funcționează doar în sus. Blocurile de thinking sunt legate de modelul care le-a produs. Pe Claude API, Fable 5.1 citește blocurile produse de Opus 5.5, deci o conversație începută pe Opus 5.5 și escaladată la Fable 5.1 își păstrează raționamentul. Invers, Opus 5.5 nu citește blocurile Fable: API-ul le elimină înainte ca modelul să le vadă (cererea reușește, blocurile eliminate nu se facturează), iar turele următoare rulează fără raționamentul anterior. Arhitectura corectă e „Opus 5.5 implicit, Fable 5.1 la escaladare”, nu invers.
5. Latența nu e argument pentru Fable. Anthropic îl etichetează „Slower” față de „Moderate”, iar fast mode nu există pe el. Pe o rută sensibilă la timp, Fable 5.1 pierde înainte de a discuta calitatea.
Trei calcule de cost: când 2,5× devine 2,2×, 1,5× sau rămâne 2,5×
Toate calculele folosesc tarifele din fișa de mai sus și presupun același număr de tokeni pe ambele modele, ipoteză conservatoare pentru Opus 5.5 (la medium va consuma probabil mai puțini tokeni de raționament decât Fable 5.1 la high), de înlocuit cu tokenii din câmpul usage al răspunsurilor tale. Cifrele sunt aritmetică pe prețuri, nu măsurători.
Calculul 1: agent de cod, 8 ore, cu prompt caching
Ipoteze: 400 de cereri într-o zi de lucru (una la circa 72 de secunde); prefixul recitit din cache (prompt de sistem, unelte, context de proiect, istoric) are în medie 120.000 de tokeni; fiecare cerere adaugă 5.500 de tokeni noi în cache-ul de 5 minute, ținut cald de ritmul cererilor; ieșirea, cu tot cu thinking, e de 2.500 de tokeni pe cerere.
| Componentă per cerere | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Citire din cache, 120.000 de tokeni | 0,0240 $ | 0,0300 $ |
| Scriere în cache (5 min), 5.500 de tokeni | 0,0275 $ | 0,0688 $ |
| Ieșire, 2.500 de tokeni | 0,0500 $ | 0,1250 $ |
| Total per cerere | 0,1015 $ | 0,2238 $ |
| Total pe 8 ore (400 de cereri) | 40,60 $ | 89,50 $ |
Raport: 2,2×. Cache-ul ajută, dar în bucla de agent scrierea în cache și ieșirea (ambele la 2,5×) fac trei sferturi din factură. Cum ții prefixul stabil și mic — ce intră în promptul de sistem, ce se compactează, ce se recuperează la cerere — e materia cursului Context Engineering și memorie pentru agenți AI; pe același calcul, un prefix de 60.000 de tokeni în loc de 120.000 scade factura cu 12% pe Opus 5.5 și cu 7% pe Fable 5.1.
Calculul 2: batch de 10.000 de documente
Ipoteze: fiecare document are 8.000 de tokeni de intrare, diferiți de la un document la altul (deci fără cache util pe conținut); ieșirea e de 600 de tokeni (o extracție structurată); procesarea merge prin Batch API, la jumătate de preț.
| Componentă | Opus 5.5 (Batch) | Fable 5.1 (Batch) |
|---|---|---|
| Intrare: 10.000 × 8.000 de tokeni | 160 $ | 400 $ |
| Ieșire: 10.000 × 600 de tokeni | 60 $ | 150 $ |
| Total | 220 $ | 550 $ |
Raport: 2,5×, exact cel de listă. Batch-ul înjumătățește ambele facturi, dar nu schimbă raportul; un prefix comun de instrucțiuni pus în cache îl schimbă puțin, pentru că tokenii documentului domină. Dacă evalul tău arată calitate echivalentă pe extracție, diferența de 330 $ per lot nu cumpără nimic.
Calculul 3: chat de suport cu baza de cunoștințe în cache
Ipoteze: un prefix de 150.000 de tokeni (politici, catalog, instrucțiuni) în cache, ținut cald de traficul continuu (scrierile amortizate spre zero); fiecare cerere aduce 300 de tokeni noi și produce 400 de tokeni; 40.000 de cereri pe zi.
| Componentă per cerere | Opus 5.5 | Fable 5.1 |
|---|---|---|
| Citire din cache, 150.000 de tokeni | 0,0300 $ | 0,0375 $ |
| Intrare nouă, 300 de tokeni | 0,0012 $ | 0,0030 $ |
| Ieșire, 400 de tokeni | 0,0080 $ | 0,0200 $ |
| Total per cerere | 0,0392 $ | 0,0605 $ |
| Total pe zi (40.000 de cereri) | 1.568 $ | 2.420 $ |
Raport: 1,5×. Aici cache-ul contează cu adevărat: trei sferturi din factura Opus 5.5 e citire din cache, la un preț aproape egal cu al lui Fable. Limita teoretică e 1,25× (0,25 $ împărțit la 0,20 $) și o atingi doar când aproape toată factura e citire din cache: întrebări de 100 de tokeni cu răspunsuri de 200 peste un context de 500.000 de tokeni dau 0,1044 $ față de 0,1360 $ per cerere, adică 1,3×.
Concluzia celor trei calcule: raportul de preț e o proprietate a rutei, nu a modelului. Același „2,5×” din lista de prețuri înseamnă 2,5× pe batch, 2,2× pe agent și 1,5× pe chat cu context mare.
Protocolul de decizie în două săptămâni
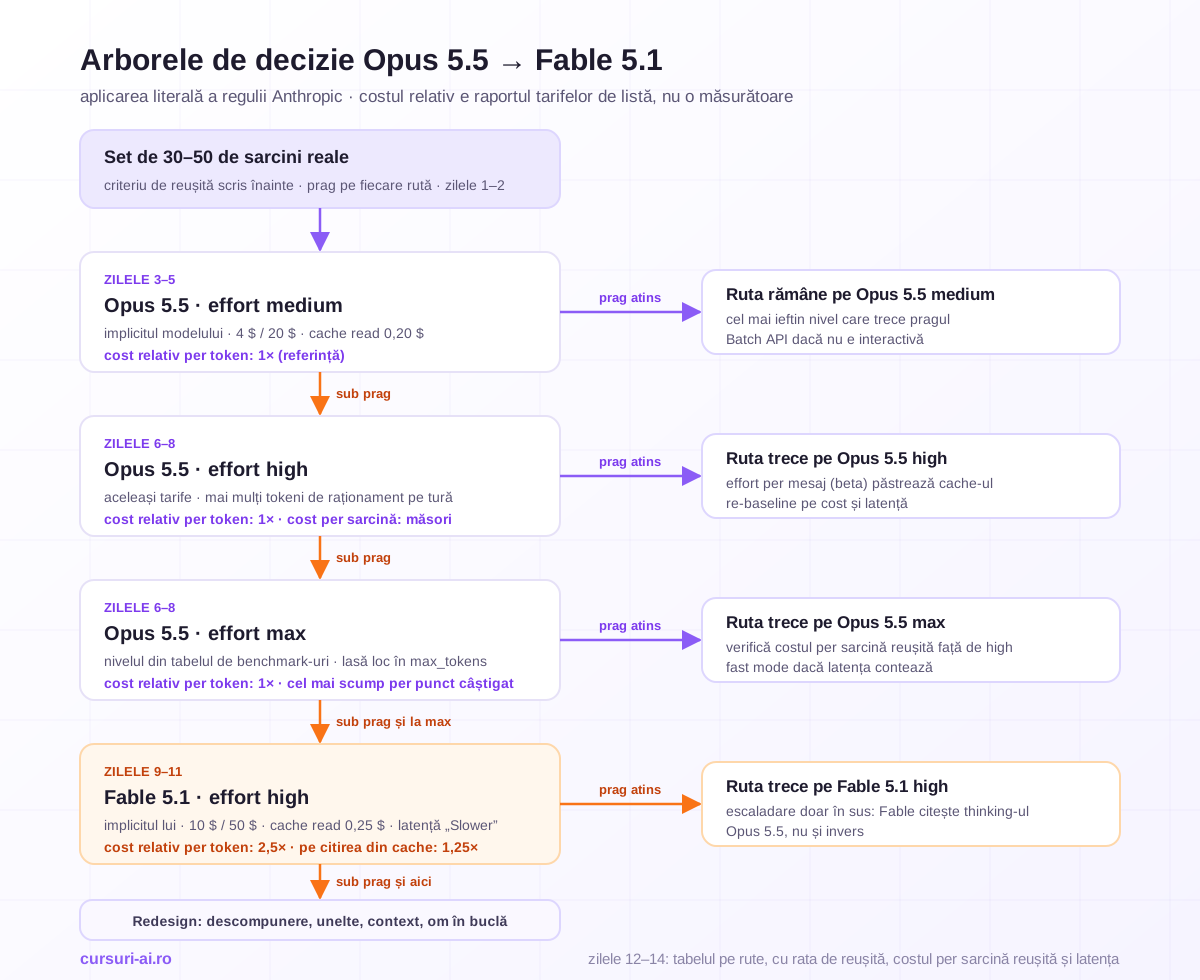
Protocolul de mai jos e aplicarea literală a regulii Anthropic, cu un calendar.
Zilele 1–2: setul de sarcini. 30–50 de sarcini reale din ultimele 30 de zile, grupate pe rutele din sistemul tău (agent de cod, extracție din documente, chat de suport, analiză), fiecare cu un criteriu de reușită scris înainte de rulare (test care trece, câmpuri extrase corect, răspuns validat de un om). Include sarcinile pe care modelul actual le-a ratat; ele decid.
Zilele 3–5: Opus 5.5 la medium. Rulezi tot setul cu output_config.effort setat explicit, cu același prompt de sistem și aceleași unelte ca în producție. Notezi pentru fiecare rulare: reușit sau ratat, tokenii de intrare, din cache și de ieșire din usage, durata.
Zilele 6–8: Opus 5.5 la high, apoi la max. Doar pe categoriile care nu au atins pragul la medium. Documentația avertizează că Opus 5.5 tinde să gândească mai mult pe tură decât Opus 5 la același effort, mai ales la xhigh și max: lasă loc în max_tokens și așteaptă-te ca ultima treaptă să fie cea mai scumpă per punct câștigat.
Zilele 9–11: Fable 5.1 la high (implicitul lui), doar pe categoriile care au picat și la max pe Opus 5.5. Aceleași sarcini, aceleași prompturi, aceeași grilă de notare. Dacă nicio categorie nu a picat la max, protocolul se oprește aici: răspunsul e Opus 5.5 pe toate rutele.
Zilele 12–14: decizia pe rute. Completezi tabelul-șablon; fiecare celulă are trei numere: rata de reușită, costul per sarcină reușită (costul total împărțit la sarcinile trecute, nu la cele încercate) și latența mediană.
| Rută | Prag | Opus 5.5 medium |
Opus 5.5 high |
Opus 5.5 max |
Fable 5.1 high |
Decizie |
|---|---|---|---|---|---|---|
| Agent de cod | 85% | 82% · 0,10 $ · 41 s | 87% · 0,16 $ · 58 s | — | — | Opus 5.5 high |
| Extracție documente | 95% | 96% · 0,02 $ · 9 s | — | — | — | Opus 5.5 medium, Batch |
| Analiză contracte | 90% | 71% · 0,31 $ · 70 s | 80% · 0,48 $ · 95 s | 84% · 0,77 $ · 140 s | 91% · 1,60 $ · 180 s | Fable 5.1 high |
Cifrele din exemplu sunt ilustrative; ale tale vin din rulări. Regula de decizie se scrie înainte de a vedea rezultatele, de exemplu: „cel mai ieftin nivel care atinge pragul; dacă niciun nivel nu îl atinge pe Opus 5.5, Fable 5.1 doar dacă îl atinge el”.
Două detalii de execuție. Într-o conversație cu cache, nu schimba effort-ul la nivelul cererii între rulări: invalidezi cache-ul și măsori altceva; pe Opus 5.5 și Fable 5.1 folosește effort-ul per mesaj (beta), care păstrează cache-ul. Și dacă rutezi din Claude Code sau dintr-un harness propriu, testează rutarea reală (subagenți la low, orchestrator la high), nu un singur apel; configurația e tratată în Claude Code Mastery.
Migrarea: de pe Opus 5 și de pe Fable 5.1
De pe Opus 5 pe Opus 5.5
Ghidul de migrare listează patru schimbări care rup codul existent; primele trei sunt aceleași pe care le-ai fi întâlnit trecând la Fable 5.1:
- Thinking-ul nu mai poate fi dezactivat.
thinking: {"type": "disabled"}sau un buget manual (enabledcubudget_tokens) întorc 400. Scoți câmpul și controlezi adâncimea cueffort; unde dezactivai thinking-ul ca să economisești, cobori lalow. tool_choiceforțat (any,tool) întoarce 400. Rămâi peautocustrict: truepe unelte sau muți schema în structured outputs, și spui în prompt când se aplică unealta.- Blocurile de thinking sunt legate de model și de conversație. Istoric append-only; pe conturile create de la 31 august 2026, editarea unei ture anterioare după un bloc de thinking întoarce 400 implicit.
- Pe Claude API și Google Cloud, unealta
computer_20251124nu mai e acceptată. Treci lacomputer_toolset_20260801, fără header beta, și adaptezi bucla agentului (blocuritool_usemembre, mai multe pe tură,toolset_namepe rezultate). Pe Amazon Bedrock, vechea unealtă continuă să funcționeze.
Plus o schimbare care nu dă eroare, dar se vede în interfață: textul dintre apelurile de unelte vine în blocuri thinking, goale la display: "omitted", valoarea implicită; o aplicație care afișa acele note ca progres „amuțește” între apeluri până setezi display: "updates" (beta) sau "summarized". Și un detaliu de cost: implicitul de effort coboară de la high la medium; setează-l explicit și refă sweep-ul. Argumentul financiar, în formularea Anthropic de pe pagina de lansare: Opus 5.5 costă „cu 40% mai puțin de rulat decât Opus 5 pe sarcini tipice”, din 20% mai puțin la intrare și ieșire și 60% mai puțin la citirea din cache.
De pe Fable 5.1 pe Opus 5.5
Aici nu ai schimbări de API care rup codul: tot ce a rupt Fable 5.1 e identic pe Opus 5.5. Trei lucruri se schimbă totuși:
- Blocurile de thinking nu se transferă în jos. Opus 5.5 nu citește blocurile produse de Fable 5.1; API-ul le elimină, cererea reușește, dar turele următoare rulează fără raționamentul anterior. Conversațiile în curs se migrează la începutul unei sesiuni noi. Cu header-ul beta
thinking-binding-controls-2026-08-01, eliminarea e raportată îninput_transformations. - Effort-ul implicit coboară de la
highlamedium. Pentru o comparație corectă cu ce aveai, prima rulare pe Opus 5.5 e lahighexplicit; abia apoi cobori. - Categoriile de refuz se lărgesc (
bioșireasoning_extractionpe lângăcyber); handler-ul destop_reason: "refusal"și fallback-ul trebuie verificate.
Pentru ambele direcții, lista completă e în ghidul de migrare; în Claude Code, comanda /claude-api migrate this project to claude-opus-5-5 aplică schimbările de parametri și produce lista de verificat manual.
Întrebări frecvente
Ce recomandă oficial Anthropic între Opus 5.5 și Fable 5.1? Să pornești cu Claude Opus 5.5 pentru majoritatea sarcinilor și să folosești Claude Fable 5.1 pentru raționament dificil și agenți long-horizon, „sau când evaluările tale pe Claude Opus 5.5 la effort mai mare tot nu ajung unde trebuie”. Regula e în pagina de prezentare a modelelor.
Cât costă Fable 5.1 față de Opus 5.5? De 2,5 ori mai mult pe tokenii de intrare și de ieșire (10 $ / 50 $ față de 4 $ / 20 $ per milion), la fel pe scrierea în cache și pe Batch API, dar doar cu 25% mai mult pe citirea din cache (0,25 $ față de 0,20 $). Pe rute dominate de prefixul recitit, raportul real coboară spre 1,3–1,5×.
Este Opus 5.5 mai bun decât Fable 5.1?
Pe tabelul publicat de Anthropic, Opus 5.5 e deasupra pe toate cele nouă benchmark-uri, cu diferențe între 0,6 și 10,6 puncte, la effort max. Anthropic avertizează însă că marjele de benchmark au devenit un ghid mai puțin fiabil și că distanța reală e mai mică decât sugerează scorurile. Răspunsul pentru sistemul tău vine dintr-un set de sarcini reale rulat pe amândouă.
Pot trece de la Fable 5.1 la Opus 5.5 fără să schimb codul?
Da, la nivel de API: schimbările care rup codul sunt aceleași pe ambele modele. Ce se schimbă: effort-ul implicit coboară de la high la medium, blocurile de thinking produse de Fable 5.1 nu sunt citite de Opus 5.5 (conversațiile în curs pierd raționamentul anterior), iar categoriile de refuz sunt mai multe.
Ce înseamnă „evals la effort mai mare” în practică?
Un set de sarcini cu răspuns corect cunoscut, rulat pe Opus 5.5 la medium, apoi high, apoi max, cu rata de reușită, costul per sarcină reușită și latența notate la fiecare nivel. Categoriile care nu ating pragul nici la max sunt singurele candidate documentate pentru Fable 5.1.
Concluzie
Decizia Opus 5.5 vs Fable 5.1 are, pentru prima dată, o regulă oficială de la furnizor și cifre care o susțin: modelul mai ieftin e punctul de plecare, escaladarea trece întâi prin effort și abia apoi prin model, iar diferența de preț de 2,5× e reală doar pe rutele fără cache — 2,2× pe agenți de cod, 1,5× pe chat cu context mare, 2,5× pe batch. Fable 5.1 rămâne alegerea acolo unde evaluările tale la max pe Opus 5.5 pică, pentru agenții long-horizon pe care i-ai măsurat, nu presupus, și pentru conversațiile escaladate în sus, unde raționamentul se păstrează. Fără setul de 30–50 de sarcini și cele două săptămâni de rulări, orice alegere între cele două e o preferință, nu o decizie.
Surse
- Anthropic Docs, Models overview (regula de alegere, tabelul comparativ, datele de retragere): https://platform.claude.com/docs/en/models/overview
- Anthropic Docs, Pricing (tarife, cache, Batch API, fast mode): https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic Docs, What's new in Claude Opus 5.5 (breaking changes, blocuri de thinking, refuzuri și fallback): https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Anthropic Docs, Migrating to Claude Opus 5.5: https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- Anthropic Docs, Effort (niveluri, implicite, effort per mesaj): https://platform.claude.com/docs/en/build-with-claude/effort
- Anthropic, Claude Opus 5.5 (pagina de lansare: benchmark-uri, limitări, safeguards): https://www.anthropic.com/claude-opus-5-5
Articol informativ, publicat la 23 septembrie 2026. Prețurile, specificațiile, benchmark-urile și citatele provin din documentația și pagina de lansare Anthropic, consultate la 23 septembrie 2026; calculele de cost sunt aritmetică pe tarifele publicate, cu ipoteze declarate, nu măsurători, iar tabelul-șablon conține cifre ilustrative. Conținutul are caracter educativ și nu constituie consultanță financiară.

Cursul care continuă acest articol
AI Evals pentru LLM-uri în Producție: Testare, Scoring și Calitate pre-Deployment
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Evaluării LLM: De la Vibe-Checks la Măsurare Riguroasă
- Golden Datasets: Curare, Etichetare și Date Sintetice Fără PII
- LLM-as-a-Judge: Rubrici, Calibrare și Mitigarea Bias-urilor
- Metrici pentru RAG și Generare: Faithfulness, Relevancy și Context (RAGAS)
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.