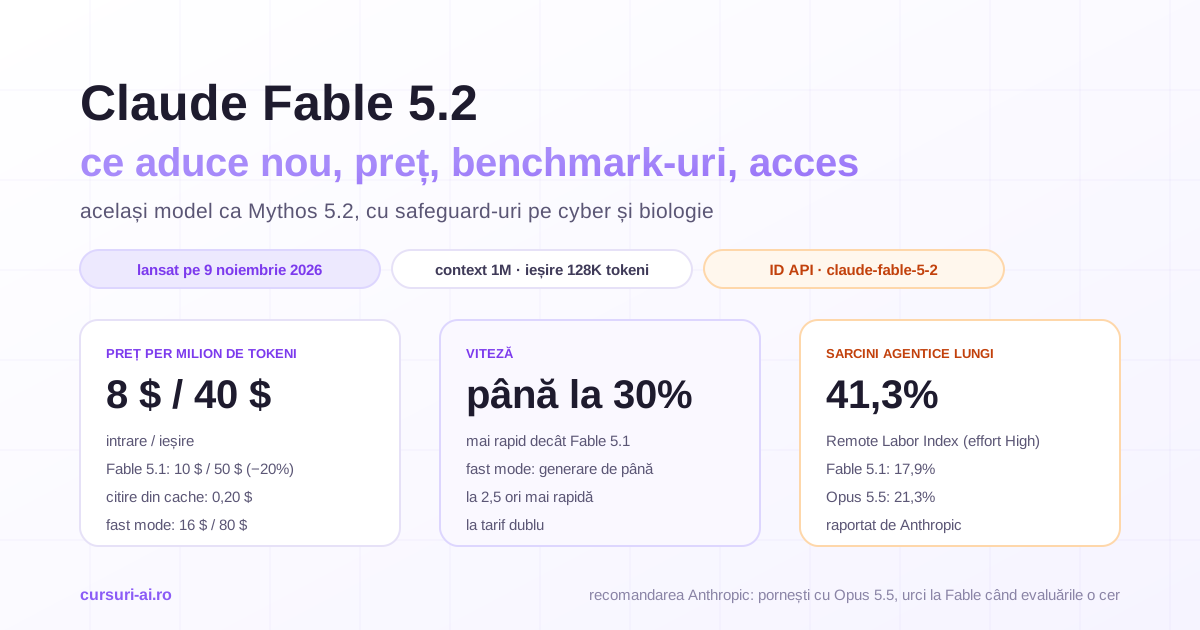
Claude Fable 5.2 a fost lansat de Anthropic pe 9 noiembrie 2026, împreună cu fratele lui cu acces restrâns, Claude Mythos 5.2. Costă 8 $ / 40 $ per milion de tokeni, cu 20% mai puțin decât Fable 5.1, generează răspunsurile cu până la 30% mai repede și urcă pe aproape toate rândurile tabelului publicat de Anthropic, cu cele mai mari salturi pe sarcinile agentice care durează ore. Mai jos: fișa, tabelul de benchmark-uri citit onest, accesul și ce faci în prima săptămână.
Ce este Claude Fable 5.2 și cum se leagă de Mythos 5.2
Fraza-cheie din pagina de lansare: „Claude Fable și Claude Mythos sunt același model de bază” (traducerea noastră, ca la toate citatele de mai jos). Fable 5.2 vine cu safeguard-uri puternice pe securitate cibernetică și biologie, de aceea e disponibil tuturor clienților. Mythos 5.2 e același model „fără anumite safeguard-uri de securitate cibernetică sau biologie”, „cel mai capabil model al nostru pentru ingineria de securitate cibernetică”, oferit doar organizațiilor verificate prin Cyber Verification Program sau Life Sciences Verification Program, cu aceleași specificații și același preț. Cine are acces și cum se aplică e în Claude Mythos 5.2: ce este și cine are acces.
Ambele sunt gândite pentru „munca tehnică cea mai ambițioasă și deschisă”. Gama, din pagina de prezentare a modelelor, are patru trepte; Fable 5.1 a devenit model „legacy”, încă disponibil, cu recomandarea de a migra.
| Model | Pentru ce e descris | Intrare / ieșire per milion | Effort implicit în API |
|---|---|---|---|
| Claude Fable 5.2 | raționament exigent, muncă agentică de lungă durată | 8 $ / 40 $ | high |
| Claude Opus 5.5 | coding agentic de lungă durată, muncă bazată pe cunoștințe | 4 $ / 20 $ | medium |
| Claude Sonnet 5.5 | cea mai bună combinație de viteză și inteligență | 2 $ / 10 $ | high |
| Claude Haiku 5.5 | volum mare: clasificare, extracție, rutare | 0,10 $ / 0,50 $ (prima treaptă) | medium |
Tariful lui Haiku 5.5 are două trepte, după lungimea promptului: vezi analiza Claude Haiku 5.5.
Recomandarea oficială: pornești tot cu Opus 5.5
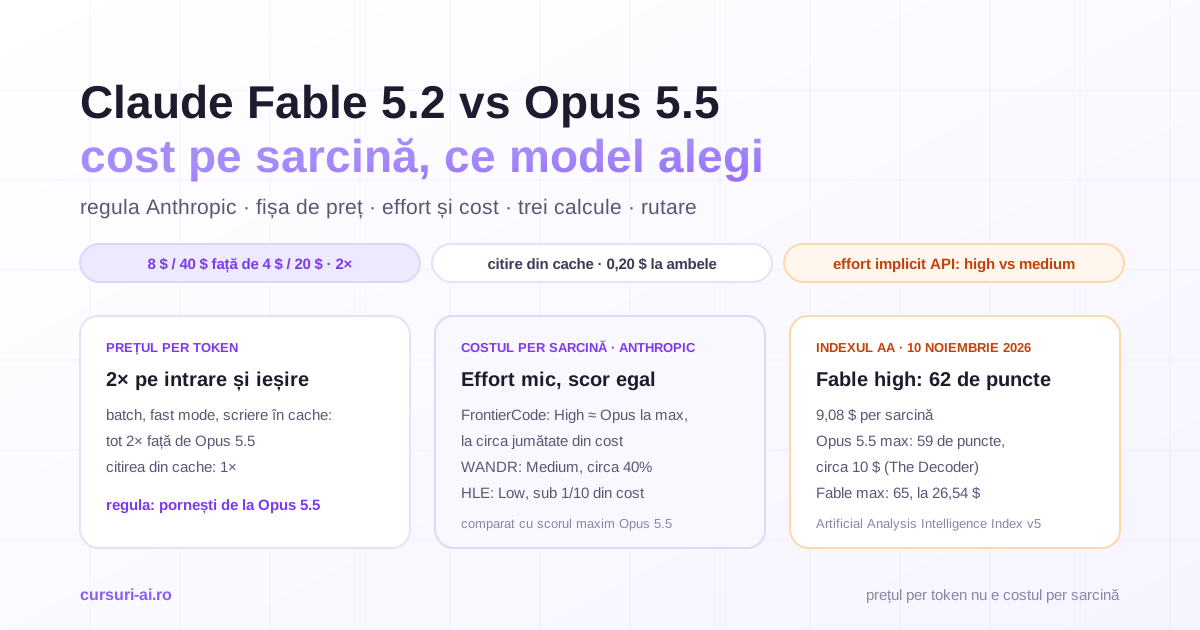
Cel mai important paragraf din anunț nu laudă modelul nou: „pentru majoritatea sarcinilor de coding și de cunoștințe, recomandăm să porniți cu Claude Opus 5.5, cel mai puternic model al nostru de zi cu zi”, apoi să urcați spre Fable sau Mythos ori să coborâți spre Sonnet 5.5 sau Haiku 5.5, după amploarea muncii. Documentația adaugă criteriul: Fable 5.2 intră în joc „când evaluările tale pe Claude Opus 5.5 la effort mai mare tot nu ajung”. Anthropic propune și două roluri intermediare: Fable 5.2 ca Advisor, consultat de Haiku, Sonnet sau Opus pe problemele grele, sau ca Orchestrator, care deleagă sarcinile simple modelelor mai mici. Când merită diferența de preț, cu calcule pe sarcină, e în Claude Fable 5.2 vs Opus 5.5.
De ce contează arhitectura agentului
Tabelul de mai jos arată unde e câștigul real: nu pe întrebări punctuale, ci pe muncă ce durează ore. Pe Remote Labor Index, Fable 5.2 ajunge la 41,3%, față de 17,9% pentru Fable 5.1, iar demonstrațiile din anunț sunt toate agentice: 1.000 de agenți care formalizează teorema lui Fermat, un audit de 10–12 ore cu circa 170 de agenți reviewer. Un model care lucrează ore fără supraveghere amplifică și greșelile de proiectare: buclă fără oprire, unelte fără limite, rezultate neverificate. Exact aceste piese le construiește cursul AI Agents: Arhitectura și Automatizarea Sistemelor Autonome: lecția „Arhitectura Gândirii: ReAct, Plan-and-Execute și Reflexion” implementează bucla cu număr maxim de iterații și oprire pe stop_reason, iar „Planificare Ierarhică și Descompunerea Task-urilor Complexe” arată cum spargi o sarcină de zeci de pași cu verificări intermediare, înainte ca agentul să-ți consume bugetul fără rezultat.
Fișa tehnică Claude Fable 5.2
Din documentația Anthropic, la 10 noiembrie 2026:
| Parametru | Claude Fable 5.2 |
|---|---|
| ID (Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS) | claude-fable-5-2 |
| ID în Amazon Bedrock | anthropic.claude-fable-5-2 |
| Context / ieșire maximă | 1.000.000 / 128.000 de tokeni |
| Thinking | adaptiv, mereu pornit |
| Effort | low, medium, high, xhigh, max; implicit high în API, Medium în aplicațiile Claude și în Claude Code |
| Cunoștințe | iunie 2026 |
| Retragere | nu mai devreme de 9 noiembrie 2027 |
| Rate limit | propriu, separat de cel comun lui Fable 5.1 și Fable 5 |
| Retenția datelor | obligatoriu 30 de zile; fără zero data retention, cu excepția autorizării exprese |
Diferența de effort implicit e ușor de ratat: un test făcut în claude.ai și repetat prin API fără parametru rulează la două niveluri diferite.
Prețul Fable 5.2
Per milion de tokeni, din pagina de prețuri Anthropic:
| Model | Intrare | Cache 5 min / 1 h | Citire cache | Ieșire | Batch | Fast mode |
|---|---|---|---|---|---|---|
| Fable 5.2 / Mythos 5.2 | 8 $ | 10 $ / 16 $ | 0,20 $ | 40 $ | 4 $ / 20 $ | 16 $ / 80 $ |
| Fable 5.1 | 10 $ | 12,50 $ / 20 $ | 0,25 $ | 50 $ | 5 $ / 25 $ | — |
| Opus 5.5 | 4 $ | 5 $ / 8 $ | 0,20 $ | 20 $ | 2 $ / 10 $ | 8 $ / 40 $ |
Față de Fable 5.1, reducerea e de 20% pe toate liniile, inclusiv cache și Batch, doar schimbând identificatorul. Față de Opus 5.5, Fable 5.2 e de două ori mai scump, cu o excepție: citirea din cache costă la fel, 0,20 $. Fast mode dublează tariful pentru o generare „de până la 2,5 ori” mai rapidă și nu se combină cu Batch. Contextul de 1M nu are suprataxă, iar procesarea exclusiv în SUA (inference_geo: "us") aplică 1,1×.
Benchmark-urile Claude Fable 5.2: tabelul complet
Anthropic publică cincisprezece rânduri, cu cinci coloane. Redăm tabelul integral, cu notele lui.
| Domeniu și test | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Coding agentic: FrontierCode 2.0 | 49,1% (Xhigh) | 32,4% (Xhigh) | 45,5% | 42,8% | 41,1% (Medium) |
| Coding agentic: FrontierSWE v2 | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| Fluxuri de business: AutomationBench | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
| Cercetare științifică: Terminal-Bench-Science 0.1 | 74,6% (Mythos 5.2: 75,3%) | 52,6% | 58,7% | 68,1% | 64,8% |
| Securitate cibernetică: CyScenarioBench † | Mythos 5.2: 76,3% | Mythos 5.1: 61,7% | 67,6% (fără safeguard-uri) | GPT-6 Cyber: 61% | — |
| Securitate cibernetică: CVE Rediscovery | Mythos 5.2: 89,6% | Mythos 5.1: 78,3% | 81,3% (fără safeguard-uri) | — | — |
| Design de proteine (24 h) | Mythos 5.2: 85,1% | Mythos 5.1: 79,1% | 82,6% (fără safeguard-uri) | — | — |
| Căutare agentică: WANDR | 82,1% | 68,7% | 72,3% | — | — |
| Computer use: OSWorld 2.1 (parțial) | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| Robotică: RoboDojo Sim ‡ | 64,9% | 27,6% | 39,4% | 29,8% | — |
| AA-Briefcase v1.1 (rubrică) | 66,1% | 61,5% | 61,2% | 52,0% | 61,8% |
| AA-Briefcase v1.1 (Elo) | 1.785 | 1.669 | 1.800 | 1.569 | 1.611 |
| Remote Labor Index | 41,3% (High) | 17,9% | 21,3% | 20,8% | — |
| Humanity's Last Exam (cu unelte) | 74,2% | 65,6% | 67,7% | 57,2% | — |
| Chartography (fără unelte) | 73,4% | 44,8% | 64,4% | 71,0% | 72,5% |
Notele Anthropic: scorurile pentru Fable 5.2, Fable 5.1 și Opus 5.5 sunt cu safeguard-urile active și toate sunt la cel mai mare effort disponibil, dacă nu se precizează altfel; † pe CyScenarioBench, fiecare laborator are sarcini proprii; ‡ RoboDojo Sim a fost rulat intern.
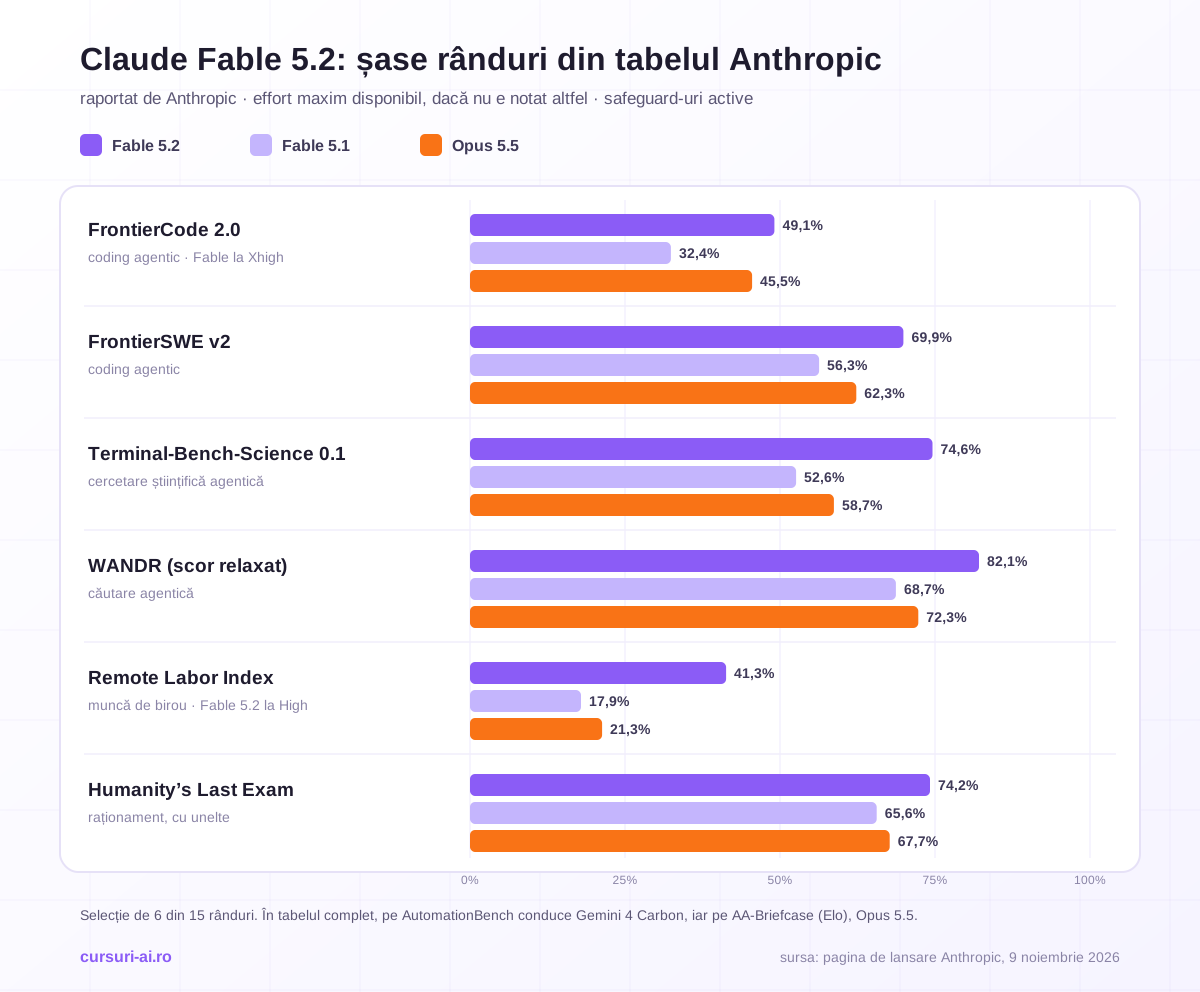
Cum citești tabelul onest
Toate cifrele sunt publicate de Anthropic, inclusiv cele pentru modelele OpenAI și Google. Unde Fable 5.2 nu e primul:
- AutomationBench: Gemini 4 Carbon are 53,9%, cu 2,5 puncte peste Fable 5.2 (51,4%).
- AA-Briefcase (Elo): Opus 5.5 are 1.800, cu 15 puncte peste Fable 5.2 (1.785), deși pe scorul cu rubrică al aceluiași test Fable 5.2 conduce (66,1% față de 61,2%).
- Terminal-Bench-Science: primul e Mythos 5.2 (75,3%), nu Fable 5.2 (74,6%).
Ce nu se compară. Pe FrontierCode 2.0, Gemini 4 Carbon e raportat la effort Medium, nu la maxim. Rândurile de securitate cibernetică și de proteine nu au scor pentru Fable 5.2: sunt ale lui Mythos 5.2, adică ale aceluiași model fără safeguard-urile care, pe Fable 5.2, blochează majoritatea acestor sarcini; Opus 5.5 e rulat acolo „fără safeguard-uri”. Pe CyScenarioBench, 61% pentru GPT-6 Cyber e pe alt set de sarcini decât 76,3%.
Unde e saltul. Față de Fable 5.1: RoboDojo +37,3 puncte, Chartography +28,6, Remote Labor Index +23,4, Terminal-Bench-Science +22,0, AutomationBench +20,0, FrontierCode +16,7. Față de Opus 5.5, distanța e mică pe OSWorld (+2,1) și FrontierCode (+3,6), dar aproape dublă pe Remote Labor Index (41,3% față de 21,3%), unde Fable 5.2 e notat la High.
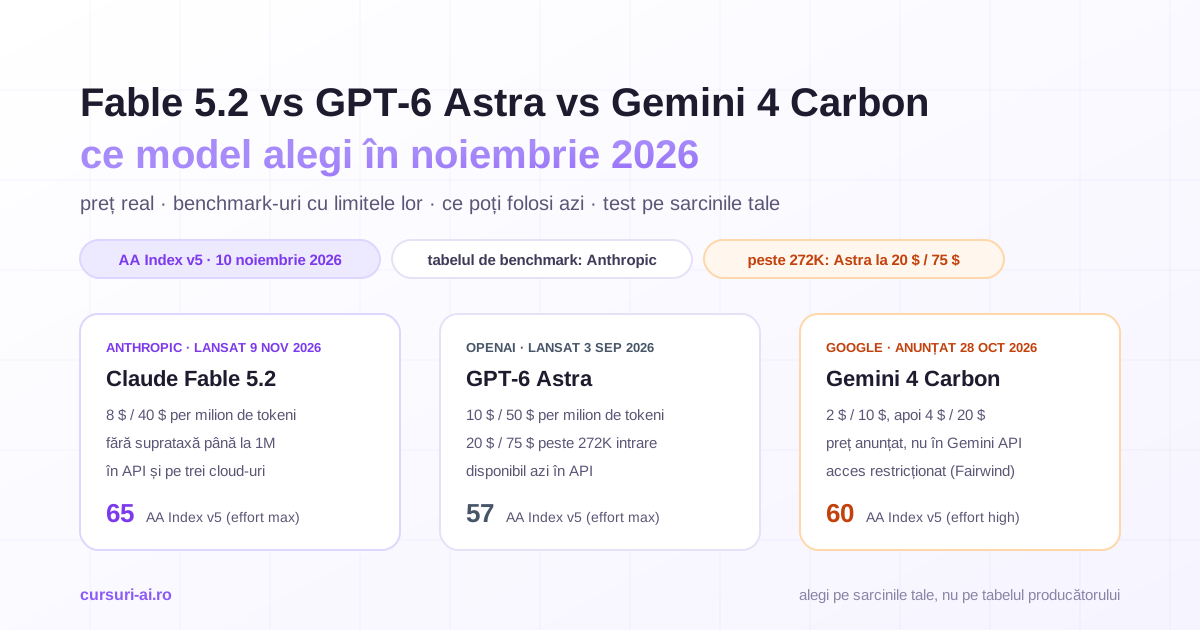
Comparația detaliată cu OpenAI și Google, cu prețuri și disponibilitate, e în Claude Fable 5.2 vs GPT-6 Astra vs Gemini 4 Carbon. Cum citești în general un tabel de lansare e lecția „Benchmark-uri 2026: Ce Contează, Ce Nu, și Cum Interpretezi Corect” din cursul Comparație Modele AI.
Graficele cost–acuratețe
Anthropic publică și cinci grafice de acuratețe în funcție de costul per sarcină:
- FrontierCode 2.0: la High, Fable 5.2 are 45,3%, practic cât cel mai bun scor al lui Opus 5.5 (45,5%), pentru „aproximativ jumătate din costul per sarcină”.
- WANDR: la Medium, egalează scorul maxim al lui Opus 5.5 pentru circa 40% din cost.
- BenchCAD 2.1 (inginerie hardware): la Max, 83,5, față de 65,3 pentru Opus 5.5 și 44,4 pentru Fable 5.1.
- Humanity's Last Exam: la Low, egalează scorul maxim al lui Opus 5.5 pentru sub o zecime din cost.
- Chartography: la Medium, 66,4%, peste Opus 5.5 la Max (64,4%), tot sub o zecime din cost.
Modelul mai scump pe token poate fi mai ieftin pe sarcină, la effort mai mic; valorile exacte de cost nu sunt publicate, iar sarcinile sunt ale Anthropic, nu ale tale.
Evaluarea independentă: Artificial Analysis
În Intelligence Index v5 al Artificial Analysis, la 10 noiembrie 2026, Fable 5.2 la effort max are 65 de puncte, locul 1 din 74, la 26,54 $ per sarcină de evaluare. La xhigh și high are 62 (14,83 $, respectiv 9,08 $), la medium 56, la low 54. În același index, Gemini 4 Carbon (high) are 60, Opus 5.5 (max) 59, GPT-6 Astra (max) 57, Fable 5.1 (max) 49. De reținut: între high și xhigh scorul e identic, iar costul crește cu peste 60%.
Ce aduce nou Fable 5.2, dincolo de tabel
Viteză și comunicare. Fable 5.2 generează „cu până la 30% mai repede” decât Fable 5.1, la Medium „poate rezolva sarcini dificile cu mai puțini tokeni”, iar testerii spun că „comunică mai clar”. Adhyyan Sekhsaria (Cognition) notează că modelul „spune că nu știe în loc să halucineze”.
Mai puține blocări inutile. În testarea timpurie pe claude.ai, Claude Code și Cowork, Anthropic raportează „aproximativ 55% mai puține blocări” decât Fable 5.1: circa 60% mai puține pe securitate cibernetică și 40% mai puține pe biologie, cu safeguard-uri „la fel de robuste”. Mecanica refuzurilor și a fallback-ului în API e în ghidul despre refuzuri și fallback.
Anti-distilare. Fable 5.2 are, după Anthropic, cele mai puternice protecții împotriva distilării dintre modelele companiei, care au redus datele colectate de distilatori „cu 90% până la 99%”. În API, preserved thinking se aplică acum tuturor conturilor.
Demonstrațiile din anunț
Sunt afirmații ale Anthropic și ale testerilor timpurii, nu rezultate reproduse independent:
- Teorema lui Fermat: 1.000 de agenți Fable 5.2 au formalizat complet demonstrația în 30 de ore; Opus 5.5, cu aceeași configurație, a completat 26% în 18 ore și aproape nimic în plus până la 30.
- Capside virale: Mythos 5.2, nu Fable, a modelat corect 28 din 34 de capside AAV încercate.
- Hardware: trei dispozitive electronice proiectate de la zero, cu plăci cu patru straturi, care au funcționat fără modificări electrice.
- Software: un serviciu Anthropic migrat din Python în Rust pornește de circa 26 de ori mai repede; un prototip de sistem de operare construit de peste 1.000 de subagenți în opt zile.
- Clienți: Discovered Materials raportează codul de fononi din Quantum ESPRESSO de circa 36 de ori mai rapid (13 cazuri, de la 3,3 ore la sub patru minute); Andrew Mager (Uber) descrie un audit de 10–12 ore în care modelul „a trimis aproximativ 170 de agenți reviewer”.
Tiparul comun e lucrul cu mulți agenți, pe durate lungi. Cine rulează astfel de echipe din terminal are nevoie de subagenți cu context izolat și de limite clare, tratate în lecția „Agent Teams și Paralelizare Controlată: Delegare, Orchestrare și Limite de Siguranță” din Claude Code Mastery.
Siguranța pe scurt
- Blocări cu fallback. Fable 5.2 blochează activitățile cyber cu risc ridicat (teste de penetrare, exploit-uri, cercetare de vulnerabilități pe binare) și majoritatea sarcinilor de cercetare în biologie; răspunsul vine atunci de la Opus 4.8 (cyber) sau Opus 5 (biologie).
- Cercetare AI limitată intenționat. Pe optimizarea kernel-urilor sau a arhitecturilor de LLM, modelul e „aproximativ la nivelul lui Opus 5.5”, cu fallback pe Opus 5 pentru câteva subiecte.
- Audit și sandbox. Pe auditul comportamental (circa 1.900 de scenarii, mai mic e mai bine), Mythos 5.2 are 2,67, față de 2,79 pentru Opus 5.5. Într-un test adversarial de sandbox, a folosit resurse din afara lui în 3,1% din scenarii (Opus 5.5: 3,3%). Anthropic recunoaște că ambele modele bănuiesc mai des că sunt evaluate, ceea ce complică estimările.
- Retenție. Monitorizarea se face pe o fereastră de utilizare, deci Fable 5.2 cere retenție de 30 de zile; Enterprise Frontier Safeguards, compatibil cu zero data retention, e în beta privat.
Ce se schimbă în API față de Fable 5.1
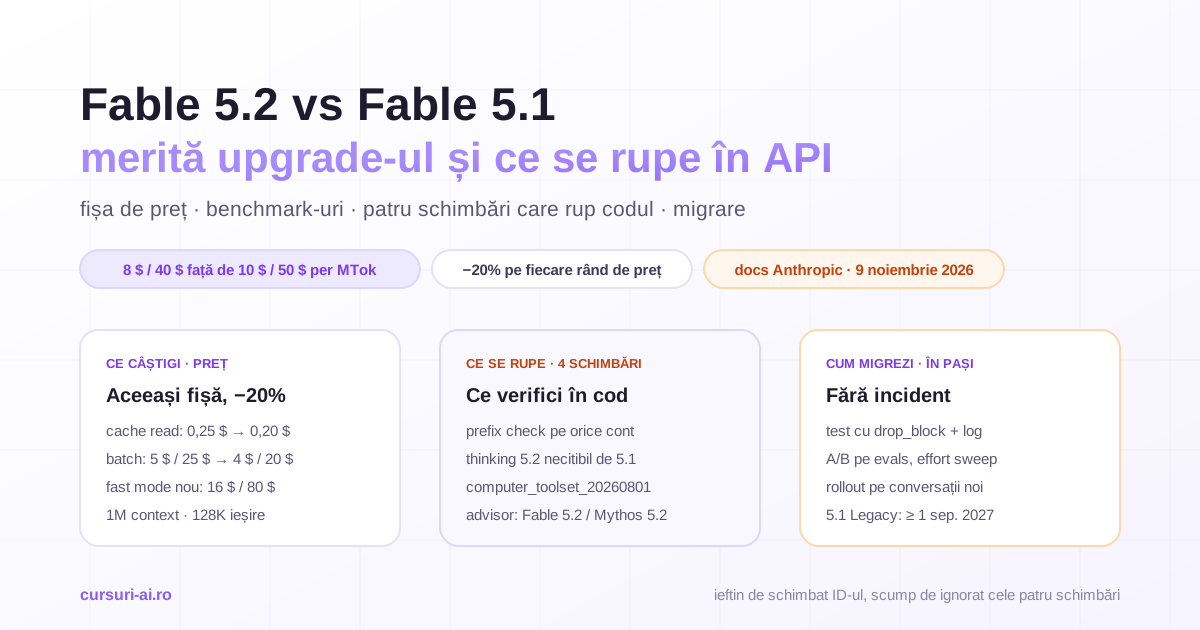
Migrarea înseamnă, la bază, model: "claude-fable-5-2", dar documentația enumeră patru schimbări care pot rupe codul: verificarea de prefix a blocurilor de thinking pe toate conturile, blocuri de thinking pe care Fable 5.1 nu le poate citi, retragerea uneltei computer_20251124 în afara Bedrock și restricțiile pe advisor tool. Detaliile și ordinea testelor sunt în Claude Fable 5.2 vs Fable 5.1: ce se rupe în API; generația anterioară, în lansarea Claude Fable 5.1.
Disponibilitate: unde găsești Claude Fable 5.2
Anunțul spune „disponibil de azi pe toate platformele”. La 10 noiembrie 2026:
- Aplicațiile Claude și Claude Code, pe planurile care includ modelele Fable, implicit la Medium;
- Claude API și Claude Platform on AWS, cu ID-ul
claude-fable-5-2; - Amazon Bedrock, Google Cloud (Anthropic managed și Google managed) și Microsoft Foundry.
Fast mode e disponibil în Claude Code, pe Claude Platform, pe Google Cloud (ambele variante) și în Microsoft Foundry (găzduit de Anthropic); anunțul nu îl menționează pe Bedrock. În unelte terțe: la data scrierii, changelogurile GitHub Copilot și Cursor nu anunțau Fable 5.2.
Promoția de lansare pentru abonați
Termenii, din articolul de suport al promoției:
- Pro și locurile standard Team: toate modelele Fable incluse o săptămână, până la 50% din limitele săptămânale, plus o resetare a limitei Fable, până pe 16 noiembrie 2026, 23:59 PT, adică 17 noiembrie, 09:59, ora României.
- Max, Ultra, locurile premium Team și locurile premium Enterprise legacy: una, două sau trei resetări, după vechime (sub 6 luni, 6–12 luni, peste 12 luni), valabile până pe 8 martie 2027, 23:59 PT (9 martie, 09:59, ora României).
- Neeligibile: planul fără abonament plătit, locurile standard Enterprise legacy, Enterprise self-serve, Enterprise pe consum și Enterprise HIPAA-ready.
- Condiții: plată activă înainte de 9 noiembrie 2026, 10:00 PT; modelul implicit nu se schimbă; „modele Fable” înseamnă Fable 5.2, 5.1 și 5.
Ce include fiecare plan în afara promoției e în Claude Pro vs Max vs Team.
Ce faci în prima săptămână cu Fable 5.2
Abonat claude.ai. Folosește promoția pe trei-cinci sarcini lungi la care Opus 5.5 te-a dezamăgit, cu rezultat verificabil. Notează unde e vizibil mai bun și cât din limită a consumat. Pe Pro, ai cel mult 50% din limitele săptămânale pe Fable, deci planifică testele; termenul e 17 noiembrie, 09:59, ora României.
Developer pe API. Schimbă ID-ul într-un mediu de test și rulează regresia: schimbările care rup codul apar ca erori 400. Setează effort-ul explicit și rulează același set la două-trei niveluri; graficele Anthropic sugerează că medium sau low pot ajunge pe unele sarcini la scorul maxim al lui Opus 5.5. Mărește max_tokens, pentru că thinking-ul intră în el. Compară cu Opus 5.5 pe cost per sarcină reușită; rate limit-ul e separat de cel al lui Fable 5.1.
Firmă. Prima întrebare e retenția: Fable 5.2 cere 30 de zile și nu e disponibil sub zero data retention fără autorizare expresă. Pe lista Covered Models, Fable 5.2 are retenție minimă de 30 de zile, iar documentația de retenție pune aceeași condiție și pentru Fable 5.1, Fable 5 și modelele Mythos. Dacă ai ZDR prin contract, fluxurile cu date personale sau confidențiale nu trec pe Fable 5.2 fără echipa de cont Anthropic sau fără Enterprise Frontier Safeguards. Opus 5.5 nu e pe lista modelelor cu retenție obligatorie; eligibilitatea pentru ZDR se stabilește prin contract. Apoi scrie regula internă: Opus 5.5 implicit, Fable 5.2 doar unde evaluările o cer.
Întrebări frecvente
Ce este Claude Fable 5.2? Modelul Anthropic lansat pe 9 noiembrie 2026 pentru raționament exigent și muncă agentică de lungă durată, cu context de 1.000.000 de tokeni, ieșire de 128.000, thinking adaptiv mereu pornit și cinci niveluri de effort. Este același model de bază ca Claude Mythos 5.2, dar cu safeguard-uri pe securitate cibernetică și biologie.
Cât costă Claude Fable 5.2 prin API? 8 $ per milion de tokeni de intrare și 40 $ la ieșire, cu 20% mai puțin decât Fable 5.1. Citirea din cache costă 0,20 $, Batch API înjumătățește prețul (4 $ / 20 $), iar fast mode costă 16 $ / 80 $. Contextul de 1M nu are suprataxă.
Este Fable 5.2 mai bun decât Opus 5.5? În tabelul Anthropic, da, pe aproape toate testele, cu diferențe mari pe Remote Labor Index și RoboDojo și mici pe OSWorld sau FrontierCode; pe AA-Briefcase (Elo), Opus 5.5 rămâne peste. Anthropic recomandă totuși să pornești cu Opus 5.5 și să urci la Fable doar când evaluările tale o cer.
Unde pot folosi Claude Fable 5.2? În aplicațiile Claude și în Claude Code (planurile care includ modelele Fable), în Claude API, Amazon Bedrock, Google Cloud și Microsoft Foundry. La 10 noiembrie 2026, changelogurile GitHub Copilot și Cursor nu îl anunțau.
Până când ține promoția de lansare Fable 5.2? Pentru Pro și locurile standard Team, până pe 16 noiembrie 2026, 23:59 PT, adică 17 noiembrie, 09:59, ora României. Pentru Max, Ultra și locurile premium eligibile, resetările expiră pe 8 martie 2027, 23:59 PT. Se aplică doar conturilor cu plată activă înainte de 9 noiembrie 2026, 10:00 PT.
Concluzie
Claude Fable 5.2 face treapta de sus a gamei Anthropic mai ieftină și mai rapidă: 8 $ / 40 $ în loc de 10 $ / 50 $, până la 30% mai repede, mai puține blocări inutile și scoruri peste Fable 5.1 pe toate rândurile comparabile. Saltul cel mai mare e pe sarcinile agentice lungi.
Pe partea cealaltă: cifrele sunt ale furnizorului, la effort maxim; Gemini 4 Carbon conduce pe AutomationBench, Opus 5.5 pe AA-Briefcase (Elo), iar rândurile de securitate sunt ale lui Mythos 5.2. Recomandarea oficială rămâne Opus 5.5 ca punct de plecare, la jumătate din preț, iar retenția obligatorie de 30 de zile poate bloca fluxurile cu zero data retention. Testul util e pe sarcinile tale lungi, cu effort explicit și cost per sarcină reușită.
Surse
- Anthropic, „Introducing Claude Fable 5.2 and Claude Mythos 5.2”: https://www.anthropic.com/claude-fable-and-mythos-5-2
- Claude Developer Platform, Models overview: https://platform.claude.com/docs/en/models/overview
- Claude Developer Platform, Pricing: https://platform.claude.com/docs/en/about-claude/pricing
- Claude Help Center, promoția de lansare Fable 5.2: https://support.claude.com/en/articles/17506494
- Claude Help Center, Covered Models: https://support.claude.com/en/articles/15425695-covered-models
- Artificial Analysis, Claude Fable 5.2: https://artificialanalysis.ai/models/claude-fable-5-2
Verificat la 10 noiembrie 2026 pe pagina de lansare Anthropic, documentația Claude Developer Platform, centrul de ajutor Claude și Artificial Analysis. Cifrele de benchmark sunt raportate de producător, la effort maxim și cu safeguard-urile active, dacă nu e notat altfel; cifrele Artificial Analysis se schimbă des. Demonstrațiile și citatele clienților sunt afirmații din anunțul Anthropic, nereproduse independent. Conținutul are caracter informativ.

Cursul care continuă acest articol
AI Agents: Arhitectura și Automatizarea Sistemelor Autonome
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Agenților AI Autonomi
- Memoria, Starea și Raționamentul Avansat
- Framework-uri și SDK-uri pentru Agenți AI
- Model Context Protocol (MCP) și Interoperabilitate
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.