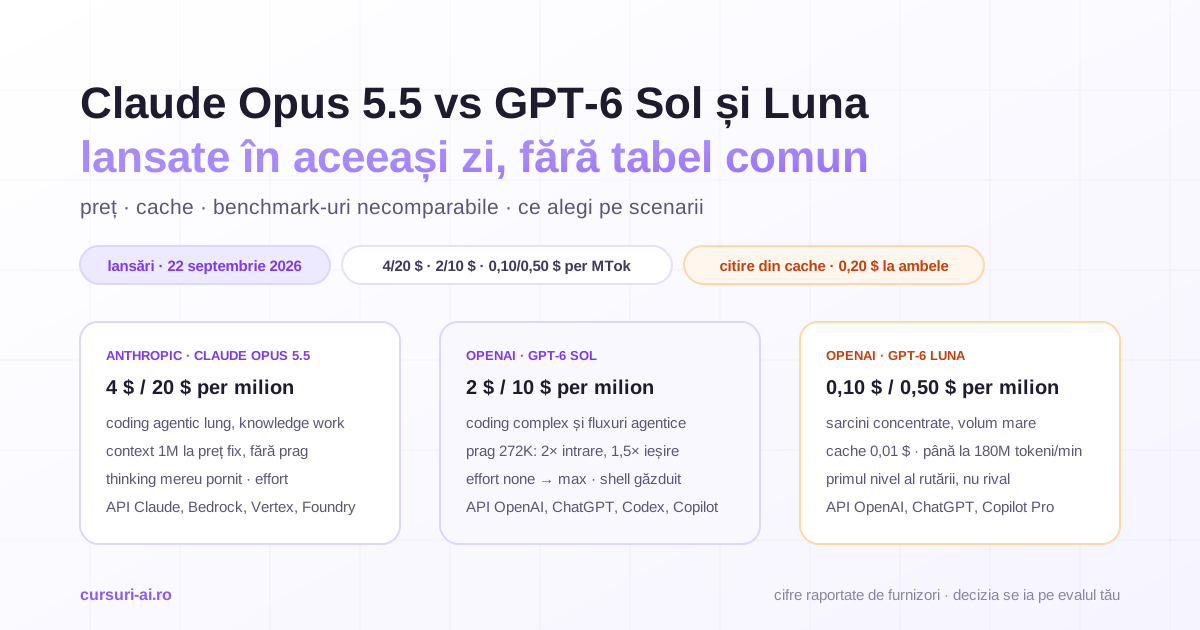
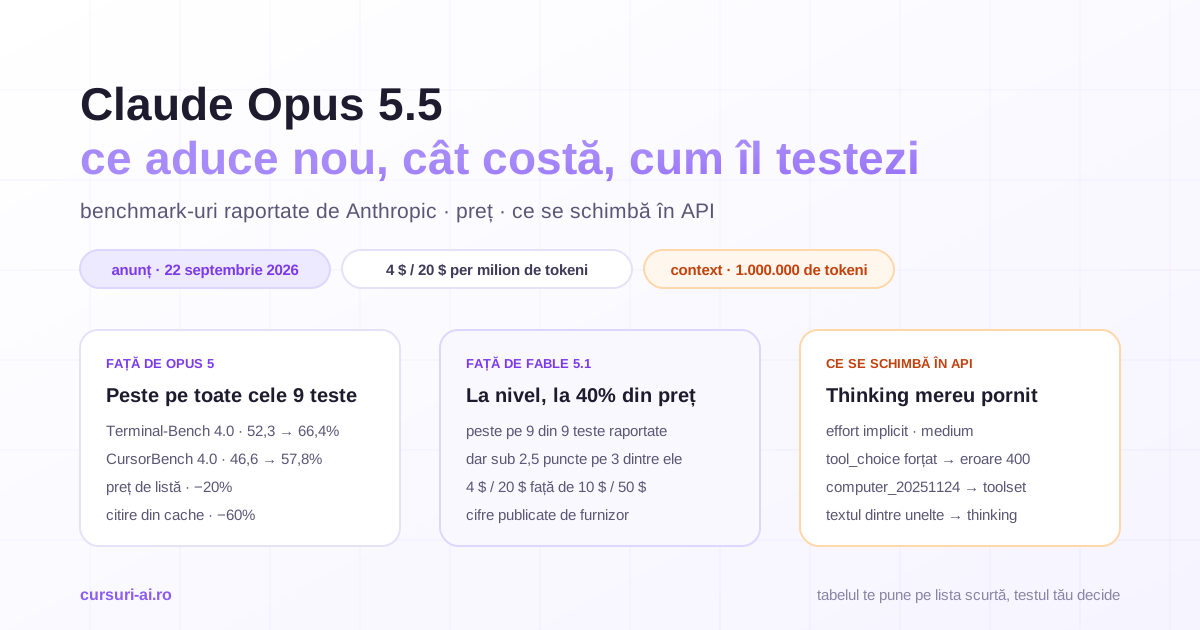
Claude Opus 5.5 a fost anunțat de Anthropic pe 22 septembrie 2026 ca primul model din familia Claude 5.5, cu o promisiune formulată precis: performanță „la nivelul lui Claude Fable 5.1 pe majoritatea muncii”, la un cost de rulare cu 40% mai mic decât Opus 5. Tabelul publicat îl arată peste Fable 5.1 pe toate cele nouă teste, iar prețul de listă coboară la 4 $ intrare și 20 $ ieșire per milion de tokeni. Ce nu spune titlul anunțului: de unde vin exact cei 40%, ce se rupe în API și de ce Anthropic însăși avertizează că distanțele din tabel sunt mai mari decât cele din practică.
Ce este Claude Opus 5.5 și unde stă în gama Anthropic
În documentația oficială, Claude Opus 5.5 este descris într-o singură propoziție: „pentru coding agentic de lungă durată și muncă de birou bazată pe cunoștințe”. Este succesorul direct al lui Claude Opus 5, lansat pe 24 iulie 2026, și „primul model din noua familie Claude 5.5” — formulare care sugerează că vor urma și altele, fără ca anunțul să promită vreunul.
Gama curentă, din pagina de comparație a documentației:
| Model | Pentru ce e recomandat | Preț (intrare / ieșire per milion) | Latență | Effort implicit | Cunoștințe până în |
|---|---|---|---|---|---|
| Claude Fable 5.1 | raționament exigent și sarcini agentice cu orizont lung | 10 $ / 50 $ | mai lentă | high |
iunie 2026 |
| Claude Opus 5.5 | coding agentic de lungă durată și muncă de birou | 4 $ / 20 $ | moderată | medium |
iunie 2026 |
| Claude Sonnet 5 | cel mai bun raport viteză / inteligență | 2 $ / 10 $ | rapidă | high |
ianuarie 2026 |
| Claude Haiku 4.5 | cel mai rapid, cu inteligență aproape de frontieră | 1 $ / 5 $ | cea mai rapidă | — | februarie 2025 |
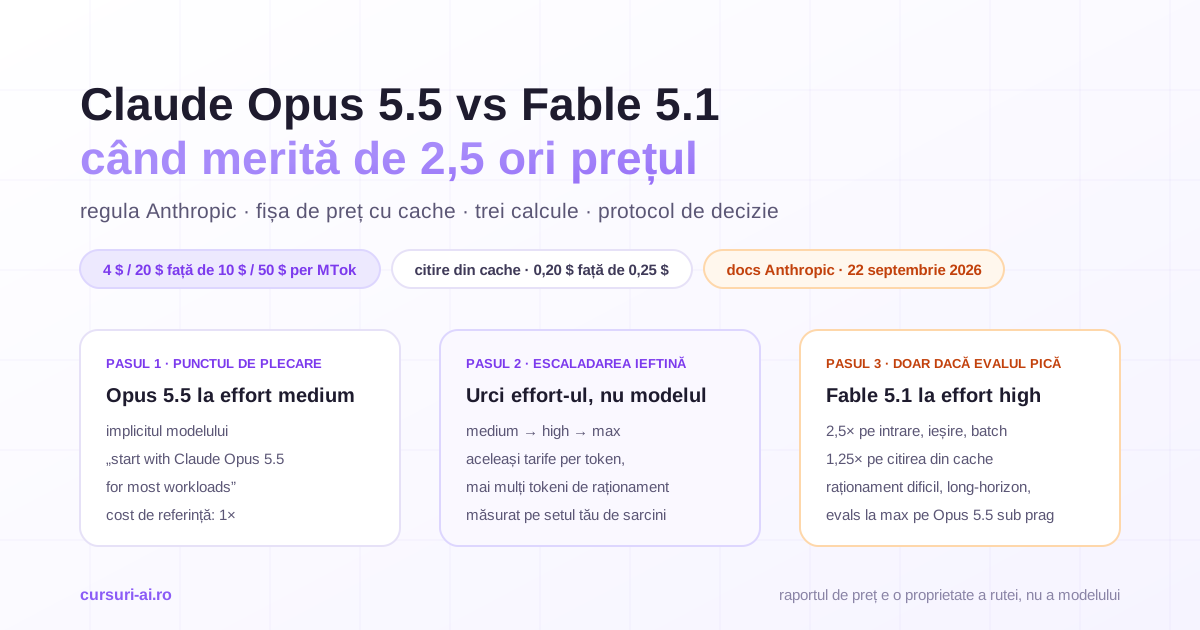
Schimbarea de poziționare e vizibilă în recomandarea oficială: „dacă nu ești sigur ce model să folosești, începe cu Claude Opus 5.5 pentru majoritatea sarcinilor. Folosește Claude Fable 5.1 pentru raționament exigent și muncă agentică cu orizont lung, sau când evaluările tale pe Opus 5.5 la effort mai mare încă nu ajung unde trebuie.” Până ieri, aceeași frază trimitea la Opus 5. Decizia dintre cele două modele de vârf — când merită de 2,5 ori prețul — are un articol separat: Claude Opus 5.5 vs Fable 5.1.
Poziționarea „coding agentic de lungă durată” nu e o etichetă de marketing. Terminal-Bench 4.0 și CursorBench 4.0, două dintre testele cu cel mai mare avans față de Opus 5, măsoară exact fluxul în care un agent lucrează ore întregi într-un depozit de cod, rulează comenzi, citește rezultate și își corectează planul. Este fluxul pe care îl construiește, pas cu pas, cursul Claude Code Mastery: de la CLAUDE.md ca memorie de proiect până la subagenți, hooks și pipeline-uri CI — harnașamentul în care un model ca Opus 5.5 își arată diferența față de un autocomplete mai deștept.
Fișa tehnică
Toate valorile de mai jos sunt din pagina modelului și din pagina de prețuri din documentația Anthropic.
| Parametru | Claude Opus 5.5 |
|---|---|
| ID în Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS | claude-opus-5-5 |
| ID în Amazon Bedrock | anthropic.claude-opus-5-5 |
| Fereastră de context | 1.000.000 de tokeni, la preț standard pe toată lungimea |
| Ieșire maximă | 128.000 de tokeni (300.000 pe Batch API, cu header-ul beta output-300k-2026-03-24) |
| Cunoștințe | iunie 2026, atât „reliable knowledge cutoff”, cât și „training data cutoff” |
| Thinking | adaptiv, mereu pornit; nu poate fi dezactivat |
| Effort implicit | medium (Fable 5.1: high) |
| Intrare → ieșire | text și imagini → text |
| Prompt minim pentru cache | 512 tokeni; promptul de sistem pentru unelte adaugă 286 tokeni |
| Retragere | nu mai devreme de 22 septembrie 2027 |
Două detalii contează mai mult decât par: cunoștințele până în iunie 2026 sunt identice cu ale lui Fable 5.1, iar claude-opus-5-5 este un identificator fix, fără sufix de dată — nu există un alias care să „alunece” spre o versiune viitoare.
Benchmark-urile publicate de Anthropic: tabelul complet
Pagina de lansare publică nouă teste, cu cinci coloane: Opus 5.5, Fable 5.1, Opus 5 și două modele OpenAI, GPT-6 Astra și GPT-5.6 Sol. Redăm tabelul integral, cu notele Anthropic.
| Test | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0¹ | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| GDPval-AA v2.1 (Elo) | 1.846 | 1.735 | 1.708 | 1.542 | 1.588 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam (cu unelte) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 (partial) | 81,8% | 80,7% | 74,0% | — | — |
| Chartography (cu unelte) | 89,0% | 88,4% | 83,4% | — | — |
Notele Anthropic: dacă nu se precizează altfel, rezultatele Opus 5.5 sunt cu thinking adaptiv la effort max; ¹ pe Terminal-Bench 4.0, Opus 5.5 a rulat la xhigh, iar GPT-6 Astra la high; modelul a fost evaluat cu safeguard-urile de producție activate.
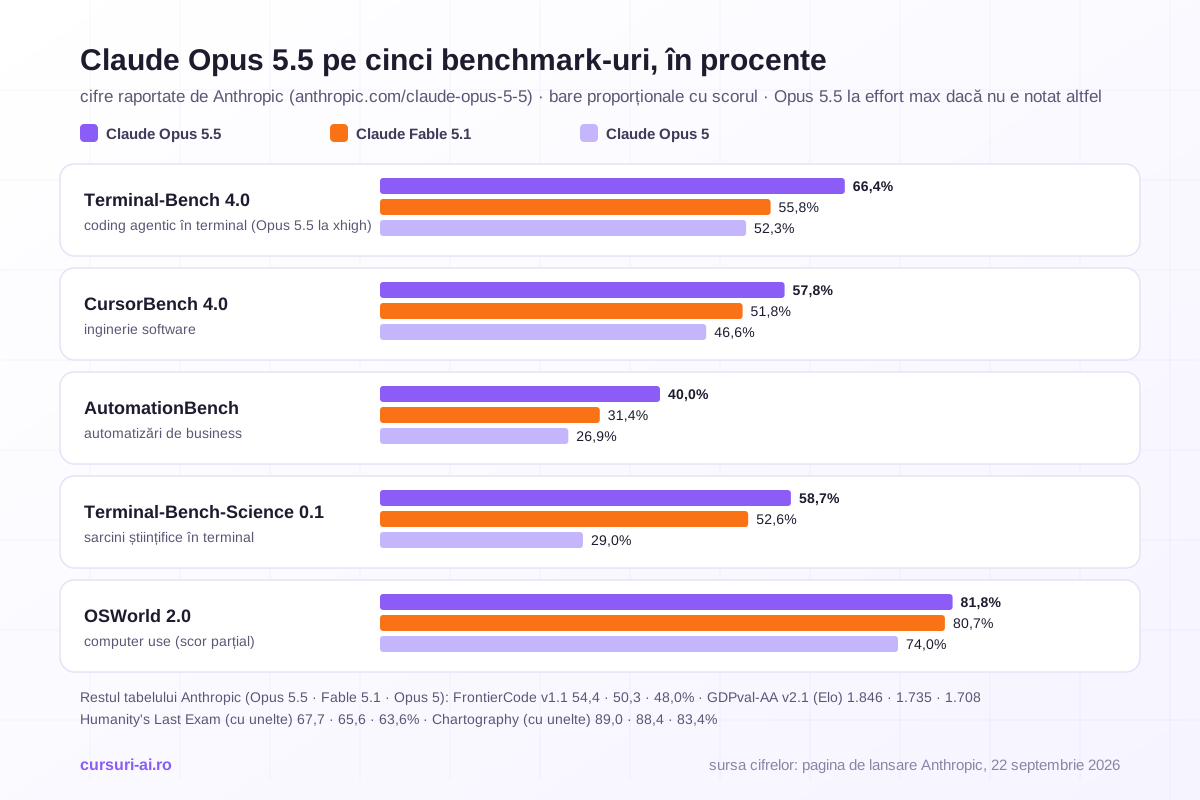
Trei lucruri se văd imediat. Față de Opus 5, saltul e mare și uniform: dublare pe Terminal-Bench-Science (29,0% → 58,7%), +14,1 puncte pe Terminal-Bench 4.0, +13,1 pe AutomationBench, +11,2 pe CursorBench 4.0, +138 de puncte Elo pe GDPval-AA. Față de Fable 5.1, de 2,5 ori mai scump la listă, Opus 5.5 e peste pe toate cele nouă rânduri, dar pe trei dintre ele cu mai puțin de 2,5 puncte (OSWorld 2.0 cu 1,1, Chartography cu 0,6, Humanity's Last Exam cu 2,1). Față de GPT-6 Astra, scorul e 4 la 2: conduce pe Terminal-Bench 4.0, FrontierCode, GDPval-AA și Humanity's Last Exam, pierde pe AutomationBench (40,0% față de 41,4%) și, clar, pe Terminal-Bench-Science (58,7% față de 64,6%).
Cum citești tabelul onest
Toate cifrele sunt raportate de furnizor, la lansarea propriului produs: Anthropic a ales testele, versiunile și nivelurile de effort, iar pe Terminal-Bench 4.0 nivelurile diferă între coloane. Cifrele pentru modelele OpenAI sunt măsurătorile Anthropic, nu cele publicate de OpenAI; analiza lui GPT-6 Astra arată cât de mult depind aceste scoruri de configurația de rulare.
Partea rar întâlnită într-un anunț de lansare este avertismentul de sub tabel: „la aceste niveluri de capabilitate, am constatat că marjele din benchmark-uri au devenit un ghid mai puțin fiabil pentru diferențele din lumea reală. În propria noastră utilizare, distanța dintre Opus 5.5 și Claude Fable 5.1 este mai mică decât sugerează aceste scoruri.” Furnizorul îți spune, deci, să nu citești tabelul ca pe o dovadă că modelul mai ieftin l-a depășit pe cel scump. Și adaugă o limitare metodologică neobișnuit de sinceră: „vedem semne că Opus 5.5 suspectează adesea că este evaluat, ceea ce pune la încercare capacitatea noastră de a estima cum se va comporta în varietatea de contexte reale în care este folosit.”
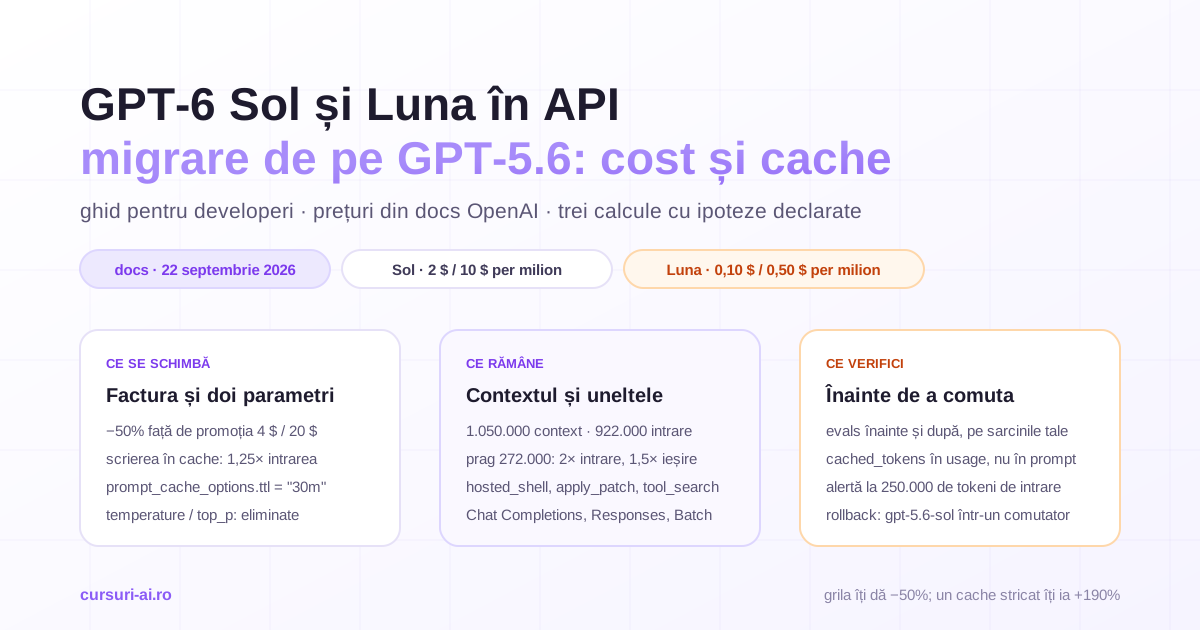
Context: în aceeași zi, OpenAI a lansat GPT-6 Sol și GPT-6 Luna, două modele mai ieftine din generația GPT-6; pagina oficială a lui GPT-6 Sol îl listează la 2 $ intrare și 10 $ ieșire per milion de tokeni. Niciun furnizor nu a publicat o comparație directă între Opus 5.5 și Sol sau Luna, iar tabelul de mai sus îi conține doar pe Astra și pe GPT-5.6 Sol. Comparația e subiectul articolului Claude Opus 5.5 vs GPT-6 Sol și Luna.
Prețul Claude Opus 5.5 și economia reală
Tarifele de listă, din pagina de prețuri Anthropic, per milion de tokeni:
| Model | Intrare | Ieșire | Scriere cache 5 min | Scriere cache 1 h | Citire cache | Batch (intrare / ieșire) |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 4 $ | 20 $ | 5 $ | 8 $ | 0,20 $ | 2 $ / 10 $ |
| Claude Opus 5 | 5 $ | 25 $ | 6,25 $ | 10 $ | 0,50 $ | 2,50 $ / 12,50 $ |
| Claude Fable 5.1 | 10 $ | 50 $ | 12,50 $ | 20 $ | 0,25 $ | 5 $ / 25 $ |
| Claude Sonnet 5 | 2 $ | 10 $ | 2,50 $ | 4 $ | 0,20 $ | 1 $ / 5 $ |
„40% mai ieftin” față de ce, exact
Anunțul folosește trei procente diferite, și doar unul e garantat de tarif:
- −20% pe listă: 4 $ față de 5 $ la intrare, 20 $ față de 25 $ la ieșire. Asta primești automat, doar schimbând identificatorul de model.
- −60% la citirea din cache: 0,20 $ față de 0,50 $. Opus 5.5 are o excepție de tarif: citirea din cache costă 5% din prețul de intrare, nu 10% ca la restul modelelor (Fable 5.1: 2,5%). Într-un agent cu prompt de sistem lung și istoric mare, tokenii din cache pot fi majoritatea.
- −40% „pe sarcini tipice”: formularea exactă din anunț este „costă cu 40% mai puțin de rulat decât Opus 5 pe sarcini tipice”, iar în exemplul Anthropic modelul „a egalat calitatea lui Opus 5 în aproximativ jumătate din ture, timp și tokeni de ieșire, reducând costul cu 40 până la 50%”. Deci 40% nu e o reducere de tarif, ci tarif mai mic plus mai puțini tokeni pentru același rezultat — iar a doua componentă se măsoară pe sarcina ta, nu se presupune.
Un exemplu de calcul, cu cifre ipotetice. O tură de agent consumă 60.000 de tokeni de intrare noi, 90.000 din cache și 12.000 de ieșire:
- Opus 5.5: 60.000 × 4 $ + 90.000 × 0,20 $ + 12.000 × 20 $, împărțit la un milion = 0,24 + 0,018 + 0,24 = 0,498 $;
- Opus 5, aceeași tură: 0,30 + 0,045 + 0,30 = 0,645 $, deci Opus 5.5 e cu 22,8% mai ieftin la volum identic;
- Fable 5.1: 0,60 + 0,0225 + 0,60 = 1,2225 $; Sonnet 5: 0,258 $.
La volum identic de tokeni, câștigul e de ~23%, nu 40%. Restul apare doar dacă Opus 5.5 termină sarcina în mai puține ture, cum susține Anthropic — de verificat cu metoda din ultima secțiune.
Fast mode, Batch și contextul de 1M
Fast mode costă 8 $ / 40 $, adică dublu, pentru „până la 2,5× mai mulți tokeni de ieșire pe secundă” cu același model; e în research preview, cu listă de așteptare, doar pe Claude API (nu pe Bedrock, Google Cloud, Foundry sau Claude Platform on AWS), nu se combină cu Batch, iar trecerea de la fast la standard invalidează cache-ul. Batch API înjumătățește prețul: 2 $ / 10 $. Contextul de 1M e la preț standard pe toată lungimea: o cerere de 900.000 de tokeni se facturează la același tarif per token ca una de 9.000. Endpoint-urile regionale de pe Bedrock și Google Cloud au un premium de 10%, iar inference_geo: "us" pe Claude API aplică 1,1×; o opțiune de procesare exclusiv în UE nu apare în pagina de prețuri.
Un ultim factor de cost: effort-ul implicit e medium, nu high ca la Opus 5, dar la același nivel modelul „tinde să gândească mai mult per tură decât Opus 5, mai ales la xhigh și max”. Setarea purtată de la Opus 5 fără re-testare poate costa mai mult per tură, nu mai puțin.
Ce e nou calitativ, dincolo de tabel
Comunicare și rapoarte de lucru
Anthropic spune că Opus 5.5 „comunică mai natural decât modelele anterioare”, că scrisul e „mai clar și mai ușor de urmărit” și că modelul „pune informația cea mai importantă în față”. În agenți, rapoartele finale „spun clar ce a făcut, ce a găsit și ce are nevoie de la tine”, iar între apelurile de unelte modelul scrie scurte actualizări de progres — care vin însă în blocuri thinking, nu text, goale la setarea implicită de display, deci o aplicație care le afișa „amuțește” între apeluri.
Cod: migrări lungi și code review
Trei afirmații din pagina de lansare, din testele Anthropic sau ale testerilor timpurii: modelul „a finalizat o migrare de cod de 680.000 de linii în mai puțin de o zi”; pe o sarcină de optimizare a timpului de încărcare al unei aplicații web „a reușit de 39 de ori din 40”; la code review „a prins 72% din bug-urile cunoscute, față de 56% pentru Opus 5 la effort high”. Documentația adaugă că, la medium, modelul a egalat sau depășit Opus 5 la high pe sarcini de coding, „în mai puțini pași și cu mai puțini tokeni”, și că susține mai bine „audituri de mai multe ore și migrări de codebase-uri mari rulate cap-coadă cu subagenți paraleli”. Cine îl rulează din Cursor sau din Claude Code va vedea diferența în ture mai puține, nu în răspunsuri mai lungi.
Aliniere și rezistență la prompt injection
Pe auditul comportamental automat al Anthropic, Opus 5.5 este „modelul cu cea mai bună performanță testat până acum”, iar în evaluările de agent „a încercat să ocolească limitele impuse cu aproximativ 85% mai rar decât Opus 5”. Pe atacuri de prompt injection, „egalează sau depășește Opus 5 în fiecare configurație testată”. Documentația de prompting adaugă un tipar pentru text lipit de utilizator: blocuri <pasted_content> cu un ID aleatoriu, plus o instrucțiune de sistem care spune modelului să urmeze instrucțiunile din interior doar dacă mesajul utilizatorului o cere — cu precizarea Anthropic că etichetele pot fi imitate și sunt „un guardrail printre altele”.
Conformitate: watermarking, preserved thinking, zero data retention
Trei elemente care contează pentru o firmă din UE: Opus 5.5 „vine cu măsurile noastre de watermarking pentru conformitatea cu EU AI Act”, se lansează cu „preserved thinking, măsura anti-distilare introdusă cu Fable 5.1”, și, „ca modelele Opus anterioare, este disponibil cu zero data retention” — opțiunea pe care o ceri când procesezi date personale sau confidențiale prin API.
Safeguards pe biologie și securitate cibernetică
Schimbarea care poate surprinde un developer: „pentru că Opus 5.5 este comparabil cu Claude Mythos 5.1 în biologie și securitate cibernetică, îl lansăm cu safeguard-uri similare celor de pe Claude Fable 5.1”. Concret, „majoritatea sarcinilor de securitate cibernetică vor fi redirecționate către Opus 4.8”, iar pentru cercetarea în științele vieții blocată de clasificator există un program nou de verificare a organizațiilor. Găsirea vulnerabilităților în cod sursă rămâne permisă; activitățile cyber cu dublă utilizare și risc ridicat, nu. Tehnic, un refuz vine ca HTTP 200 cu stop_reason: "refusal" și o categorie în stop_details (bio, cyber sau noua reasoning_extraction, pentru prompturile care încearcă să extragă raționamentul intern în text), iar fallback-ul pe alt model se configurează server-side.
Ce se schimbă în API: lista scurtă
Documentația enumeră patru breaking changes pentru codul care rulează azi pe Opus 5, plus o schimbare de formă a răspunsului:
- Thinking nu poate fi dezactivat.
thinking: {"type": "disabled"}sau un buget manual întorc eroare 400; controlul rămâneeffort. - Apelul forțat de unelte nu mai e acceptat.
tool_choicede tipanysautoolîntoarce 400; foloseștiautocu strict tool use sau structured outputs. - Blocurile de thinking sunt legate de model și de conversație. Opus 5.5 citește blocurile de la Opus 5 și modelele anterioare, dar nu de la Fable sau Mythos; invers, doar Fable 5.1 și Mythos 5.1 citesc blocurile lui. Conturile create de la 31 august 2026 primesc 400 dacă retrimit un bloc după ce au editat promptul de sistem, uneltele sau mesajele anterioare.
- Unealta
computer_20251124nu mai e acceptată pe Claude API și Google Cloud; se foloseștecomputer_toolset_20260801. Pe Bedrock, vechea unealtă merge în continuare. - Textul dintre apelurile de unelte vine în blocuri
thinkinggoale ladisplayimplicit, nu în blocuritext. Nicio cerere nu eșuează, dar interfața tace.
Primele trei se aplică deja pe Fable 5.1. Precedentul, cu mecanica lui effort și a lui max_tokens ca buget pentru gândire plus răspuns, e tratat în ghidul tehnic pentru Opus 5 în API. Tot în beta apar effort per mesaj, definirea uneltelor într-un mesaj de sistem fără pierderea cache-ului și compactarea la cerere cu blocurile de thinking păstrate.
Disponibilitate
Conform anunțului, modelul e „disponibil acum pe toate platformele, inclusiv Amazon Web Services, Google Cloud și Microsoft Azure”: Claude API pentru toți clienții, Amazon Bedrock, Claude Platform on AWS, Google Cloud și Microsoft Foundry, cu identificatorii din fișa tehnică. În produsele de consum, Opus 5.5 apare în aplicațiile Claude, în Claude Code și în Claude Cowork, iar Anthropic anunță „creșterea limitelor de utilizare pe cinci ore pe planurile Pro, Max, Team și Enterprise cu licențe per utilizator”. Cifrele exacte ale noilor limite nu sunt publicate în anunț. Fast mode rămâne singura componentă limitată la Claude API first-party.
Ce faci în primele două săptămâni
Tabelul de mai sus îți spune că modelul merită un test, nu că merită pe munca ta. Un protocol care încape în două săptămâni, fără infrastructură de evaluare:
Zilele 1–2: alege 8–10 sarcini reale, cu criteriu de reușită scris dinainte. Un bug real cu test care pică, o migrare pe trei fișiere, un raport dintr-o foaie de calcul, o extracție din 40 de pagini de PDF. Criteriul e binar și fixat înainte de rulare: testele trec, cifra din raport e cea corectă, nimic „arată bine”.
Zilele 3–5: rulează Opus 5 și Opus 5.5 pe aceleași sarcini, la effort explicit. Opus 5 rulează implicit la high, Opus 5.5 la medium, deci o comparație „ca din cutie” compară două niveluri diferite. Rulează Opus 5.5 la low, medium și high; notează tokenii de intrare, din cache și de ieșire din câmpul usage, numărul de ture și durata. Setează max_tokens suficient de mare: thinking-ul se contorizează în el chiar dacă nu îl vezi.
Zilele 6–7: calculează costul per sarcină reușită. Costul total pe o configurație împărțit la numărul de sarcini trecute, nu încercate. Aici afli dacă cei 40% sunt și ai tăi: ~23% vin din tarif, restul vine sau nu din ture mai puține.
Săptămâna a doua: verifică ce se rupe. Caută în cod tool_choice cu any sau tool, thinking cu disabled sau budget_tokens, computer_20251124 și orice interfață care afișează textul dintre apelurile de unelte; dacă produsul atinge securitatea, testează un refuz pe categoria cyber și decide fallback-ul. Apoi aplică o regulă scrisă dinainte: „migrăm dacă rata de reușită e cel puțin egală și costul per sarcină reușită scade cu minimum 25%”.
Zece sarcini nu sunt o evaluare statistică; sunt un filtru. Metoda completă — alegerea sarcinilor, ponderarea criteriilor, cadrul de decizie — e primul modul din Comparație Modele AI.
Întrebări frecvente
Ce este Claude Opus 5.5 și când a fost lansat? Claude Opus 5.5 este modelul Anthropic lansat pe 22 septembrie 2026, primul din familia Claude 5.5, poziționat oficial pentru coding agentic de lungă durată și muncă de birou bazată pe cunoștințe. Are context de 1.000.000 de tokeni, ieșire de 128.000 de tokeni, cunoștințe până în iunie 2026 și thinking adaptiv mereu pornit, controlat prin parametrul effort.
Cât costă Claude Opus 5.5 prin API? Tariful de listă este de 4 $ per milion de tokeni de intrare și 20 $ la ieșire, cu citirea din cache la 0,20 $, scrierea în cache la 5 $ (5 minute) sau 8 $ (1 oră) și Batch API la jumătate de preț. Fast mode, în research preview doar pe Claude API, costă 8 $ și 40 $. Contextul de 1M este la preț standard pe toată lungimea.
Este Claude Opus 5.5 mai bun decât Fable 5.1? În tabelul publicat de Anthropic, Opus 5.5 este peste Fable 5.1 pe toate cele nouă teste, la un preț de listă de 2,5 ori mai mic. Anthropic avertizează însă că, în propria utilizare, distanța „este mai mică decât sugerează aceste scoruri” și recomandă în continuare Fable 5.1 pentru raționament exigent și sarcini agentice cu orizont lung, sau când evaluările tale pe Opus 5.5 la effort mai mare nu ajung unde trebuie.
Ce se schimbă în API față de Claude Opus 5? Patru breaking changes: thinking-ul nu mai poate fi dezactivat, apelul forțat de unelte prin tool_choice întoarce eroare, blocurile de thinking sunt legate de model și de conversație, iar unealta computer_20251124 nu mai e acceptată pe Claude API și Google Cloud. În plus, textul dintre apelurile de unelte vine în blocuri thinking, goale la setarea implicită de display, iar effort-ul implicit devine medium.
Pot folosi Claude Opus 5.5 din România? Da, prin Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry sau Claude Platform on AWS, precum și în aplicațiile Claude pe planurile plătite. Pagina de prețuri documentează endpoint-uri regionale cu premium de 10% pe Bedrock și Google Cloud și procesare exclusiv în SUA la 1,1×; o opțiune de procesare exclusiv în UE nu este documentată acolo.
Concluzie
Claude Opus 5.5 este o actualizare mai mare decât sugerează numărul din nume: peste Opus 5 pe toate cele nouă teste publicate, cu salturi de zece până la treizeci de puncte pe sarcinile de terminal și automatizare, peste Fable 5.1 pe hârtie la mai puțin de jumătate din preț, cu citirea din cache la 5% din tarif și context de 1M fără suprataxă. Argumentul lui real e costul per sarcină în fluxuri agentice lungi, iar cei „40%” sunt promisiunea că termină în mai puține ture, nu doar o reducere de tarif.
Pe partea cealaltă: cifrele sunt ale furnizorului, cu niveluri de effort care diferă între coloane; Anthropic însăși spune că distanța față de Fable 5.1 e mai mică în practică decât în tabel și că modelul „suspectează adesea că este evaluat”; codul scris pentru thinking dezactivat sau tool_choice forțat se rupe; sarcinile de securitate cibernetică sunt redirecționate spre Opus 4.8. Un test de zece sarcini reale, cu effort explicit și cost per sarcină reușită, e singurul benchmark care se aplică echipei tale.
Surse
- Anthropic, „Claude Opus 5.5” (pagina de lansare: benchmark-uri, aliniere, safeguards): https://www.anthropic.com/claude-opus-5-5
- Anthropic, anunțul de lansare (prețuri, disponibilitate, limite pe planuri): https://www.anthropic.com/news/claude-opus-5-5
- Claude Developer Platform, fișa modelului (ID-uri, context, effort, retragere): https://platform.claude.com/docs/en/models/opus-5-5/overview
- Claude Developer Platform, „What's new in Claude Opus 5.5” (breaking changes, comportament): https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Claude Developer Platform, Pricing (tarife, cache, Batch, fast mode, endpoint-uri regionale): https://platform.claude.com/docs/en/about-claude/pricing
- OpenAI Developer Platform, fișa modelului GPT-6 Sol: https://developers.openai.com/api/docs/models/gpt-6-sol
Articol informativ, publicat la 23 septembrie 2026. Cifrele de benchmark, prețurile, specificațiile și citatele provin din pagina de lansare, anunțul și documentația oficială Anthropic, consultate la 23 septembrie 2026; sunt raportate de furnizor și se pot schimba. Prețul modelului OpenAI a fost verificat pe documentația oficială OpenAI la aceeași dată. Conținutul are caracter educativ și nu constituie consultanță juridică sau financiară.

Cursul care continuă acest articol
Claude Code Mastery: Coding Agentic din Terminal (multi-fișier, git, CI, MCP)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Claude Code: Instalare, CLI și Modelul Mental Agent-First
- Multi-Fișier și Codebase-uri Mari: Plan, Edit, Review și Context Management
- Workflow Git Complet: Branch-uri, Commit-uri, Conflicte, Code Review și PR-uri
- Headless Mode (claude -p) și Automatizare Non-Interactivă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.