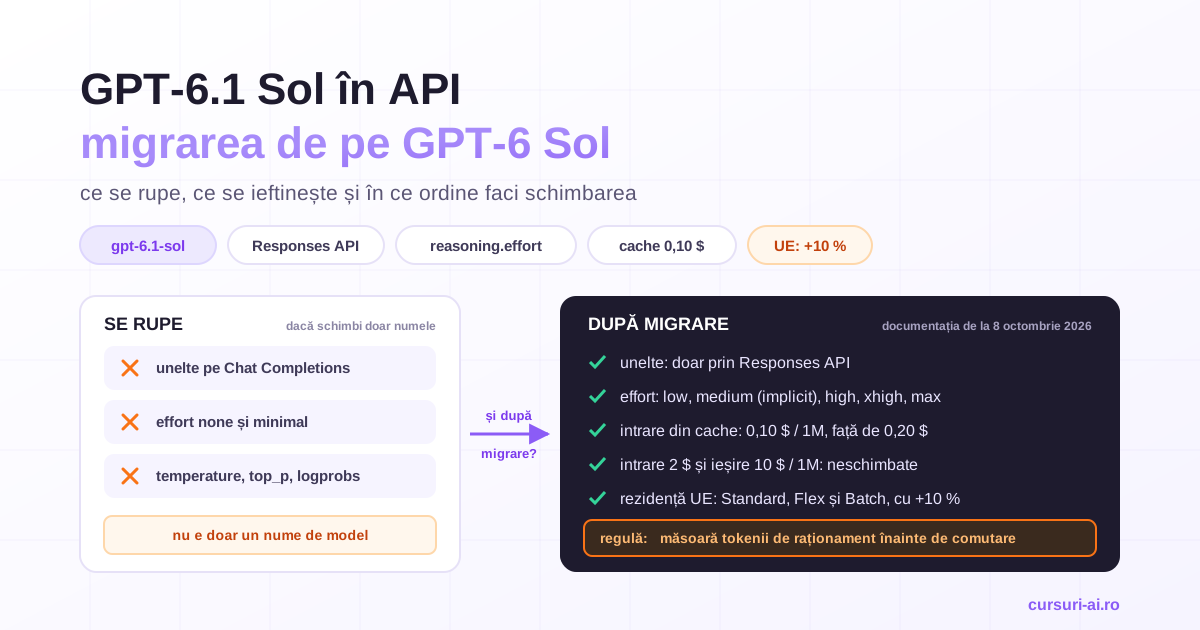
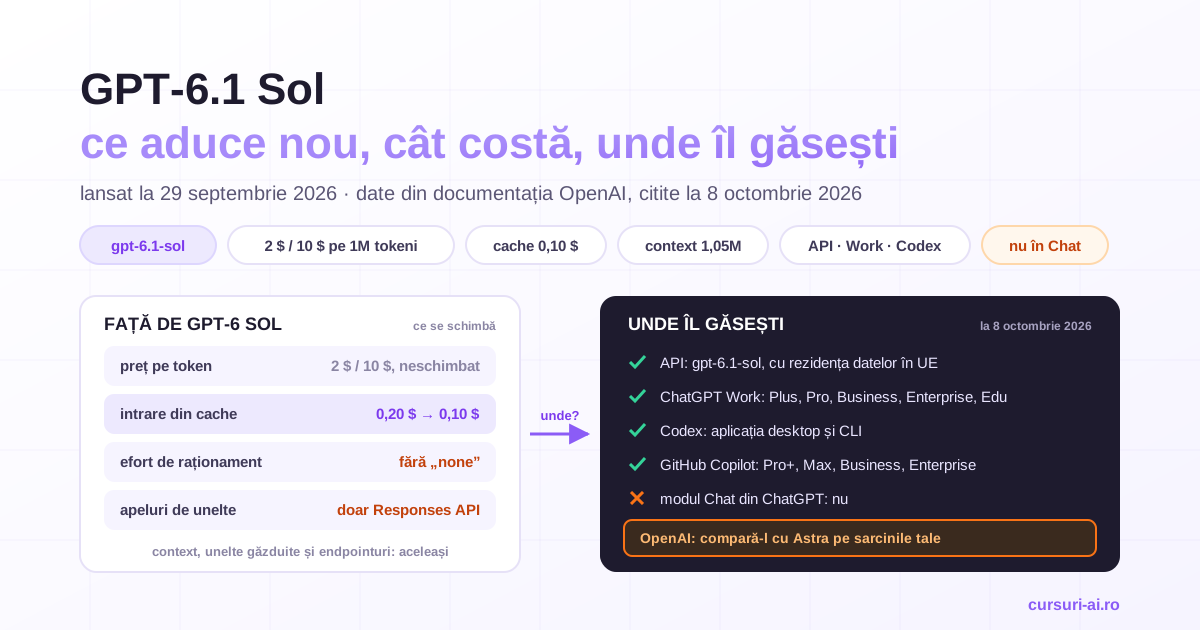
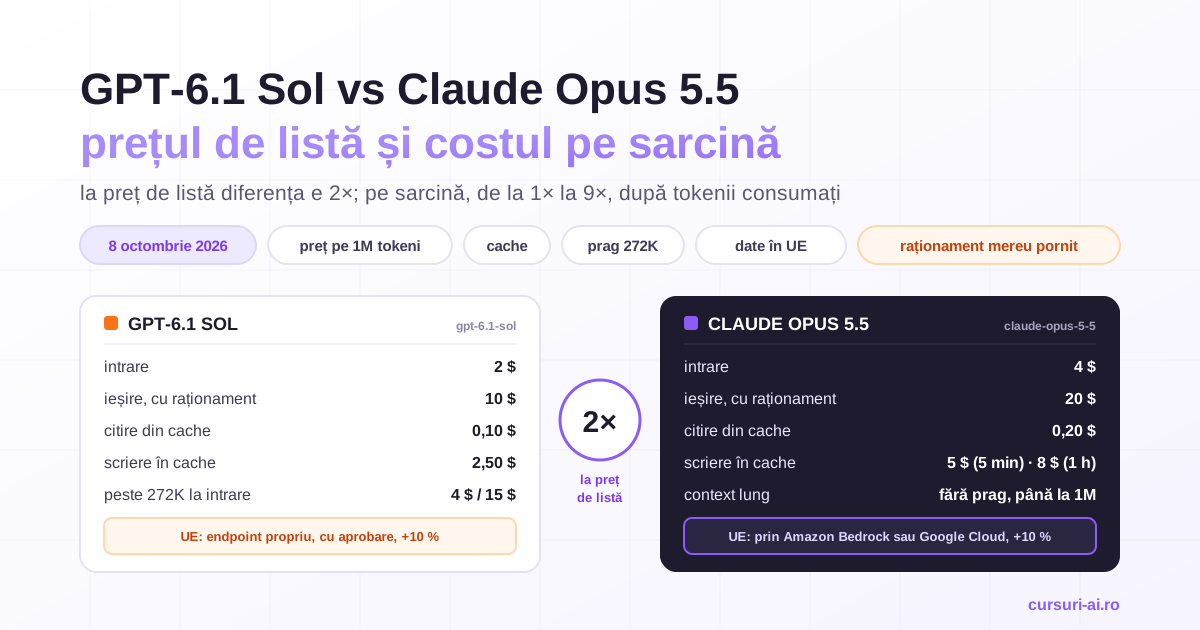
GPT-6.1 Sol vs Claude Opus 5.5 este, la 8 octombrie 2026, alegerea de model implicit pentru cod, agenți și muncă profesională, iar la preț de listă Opus 5.5 costă exact dublu: 4 $ și 20 $ față de 2 $ și 10 $ pe milionul de tokeni. Pe o sarcină reală, raportul GPT-6.1 Sol vs Claude Opus 5.5 nu rămâne 2×: la același consum de tokeni coboară spre 1× peste 272.000 de tokeni de intrare și urcă la 2,7× când cache-ul expiră, iar în măsurătorile independente ale Artificial Analysis, unde Opus 5.5 consumă mai mulți tokeni și obține scoruri mai mari, ajunge la 6–9×. Întrebarea este dacă plusul de scor acoperă costul pe sarcinile tale.
| Pe scurt | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Intrare / ieșire, pe 1M tokeni | 2 $ / 10 $ | 4 $ / 20 $ |
| Citire din cache | 0,10 $ | 0,20 $ |
| Context lung | peste 272.000 de tokeni de intrare se scumpește toată cererea | același tarif până la 1M |
Artificial Analysis, efort medium: indice · cost pe sarcină |
47,8 · 0,21 $ | 51,2 · 1,34 $ |
GPT-6.1 Sol vs Claude Opus 5.5: de ce comparația are sens acum
OpenAI a lansat GPT-6.1 Sol la 29 septembrie 2026, la o săptămână după Claude Opus 5.5. Fișa modelului îl descrie prin „near-Astra performance at a lower cost”, iar anunțul vorbește despre o cincime din prețul lui GPT-6 Astra. Anthropic scrie în pagina de lansare că Opus 5.5 „performs at the level of Claude Fable 5.1 on most work”. Astra și Fable 5.1 costă amândouă 10 $ și 50 $ (GPT-6 Astra vs Claude Fable 5.1). Ambii furnizori spun același lucru despre modelul lor de mijloc: aproape de vârf, la o cincime din preț la OpenAI și la două cincimi la Anthropic.
Ce nu reluăm aici: ce este GPT-6.1 Sol se află în analiza lansării, mutarea codului în ghidul de migrare în API, iar fișa modelului Anthropic în articolul despre Opus 5.5. Claude Opus 5.5 vs GPT-6 Sol și Luna acoperă modelele lansate la 22 septembrie; acesta, perechea de după 29 septembrie. Echivalentul de preț al lui 6.1 Sol la Anthropic este Claude Sonnet 5.5, tot la 2 $ și 10 $ (Sonnet 5.5 vs GPT-6 Sol); aici întrebarea este dacă dublul se justifică.
Evaluările publice, inclusiv cele independente de mai jos, măsoară sarcinile evaluatorului, la efortul ales de el. Pentru ale tale îți trebuie un set de test cu rezultate de referință, o regulă de notare și o comparație repetabilă între două modele. Construcția lor este materia cursului AI Evals pentru LLM-uri în Producție: golden dataset, rubrici și model-judecător calibrat, comparare de modele cu Promptfoo și o lecție despre poarta de evaluare la schimbarea modelului, inclusiv între furnizori. Cursul nu conține un verdict între GPT-6.1 Sol și Opus 5.5; arată cum îl obții.
Fișa comparativă, rând cu rând
Valori citite la 8 octombrie 2026 din fișa gpt-6.1-sol și din documentația Anthropic pentru claude-opus-5-5 (prețuri, ce e nou în Opus 5.5), în dolari pe un milion de tokeni. Batch reduce prețul cu 50 % la ambii.
| Criteriu | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Intrare | 2 $ | 4 $ |
| Ieșire, inclusiv raționament | 10 $ | 20 $ |
| Citire din cache | 0,10 $ | 0,20 $ |
| Scriere în cache | 2,50 $ | 5 $ (5 minute) sau 8 $ (o oră) |
| Prag de context lung | peste 272.000 de tokeni de intrare: 4 $ intrare, 0,20 $ și 5 $ la cache, 15 $ ieșire, pe toată cererea | fără prag |
| Fereastră de context | 1.050.000, din care cel mult 922.000 la intrare | 1.000.000 |
| Ieșire maximă | 128.000 | 128.000 |
| Niveluri de raționament | low, medium (implicit), high, xhigh, max; fără none și minimal |
aceleași cinci, medium implicit; thinking-ul nu se poate dezactiva |
| Tool calling | doar prin Responses API | Messages API; tool_choice doar auto și none |
| Procesare în UE | da, pe eu.api.openai.com, cu aprobare, +10 % |
nu pe API-ul Claude; pe Amazon Bedrock și Google Cloud |
| În afara API-ului | ChatGPT Work și Codex, pe planurile plătite de la Plus în sus; nu în Chat | aplicațiile Claude și Claude Code; Amazon Bedrock, Google Cloud, Microsoft Foundry |
Sub prag, raportul este 2× pe fiecare linie, inclusiv la cache. Cu GPT-6 Sol nu este așa: citirea din cache costă 0,20 $ la ambii. GPT-6.1 Sol a coborât-o la 0,10 $ și a refăcut raportul. Peste prag, tarifele de intrare devin identice, iar diferența rămâne doar la ieșire.
Care e mai ieftin: lista de prețuri și cele două mecanisme de cache
Multiplicatorii sunt aceiași, 1,25× la scriere și 0,05× la citire, dar mecanismele diferă. Sursele: ghidul de prompt caching al OpenAI și pagina de prețuri a Anthropic.
| Mecanism | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|
| Pornire | activ implicit, cu punct de întrerupere pus automat la finalul ultimului mesaj eligibil | la cerere, prin câmpul cache_control |
| Prefix minim | 1.024 de tokeni | 512 tokeni |
| Durată | cel puțin 30 de minute de la ultima folosire; singura valoare acceptată | 5 minute, reînnoite la fiecare folosire; opțional o oră, cu scriere la 2× |
| Limita de tokeni pe minut | tokenii din cache se numără | citirile din cache nu se scad |
input_tokens din usage |
include tokenii citiți și scriși în cache | îi exclude |
La 6.1 Sol, potrivit ghidului, în modul implicit tot ce e nou până la ultimul mesaj eligibil se scrie în cache la 2,50 $, nu la 2 $; pentru conținutul care nu va fi refolosit, documentația recomandă prompt_cache_options.mode: "explicit". La Opus 5.5, fără cache_control nu se scrie și nu se citește nimic.
Costul pe sarcină în trei scenarii
Scenariile țin tokenii egali la ambele modele, ca să izoleze efectul prețului și al cache-ului. Aritmetica este verificată cu un script, iar rezultatele sunt valabile doar la aceste ipoteze.
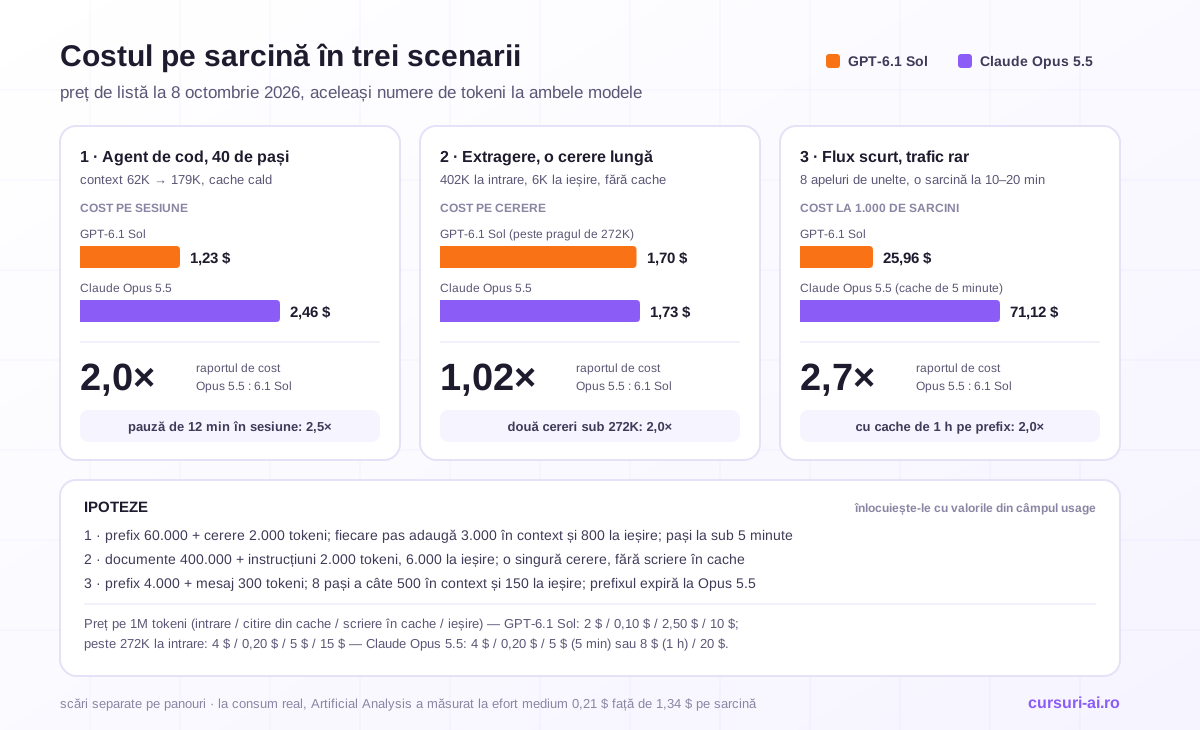
nou, citit, scris = tokeni de intrare: fără cache, citiți din cache, scriși în cache
GPT-6.1 Sol = (nou × 2 + citit × 0,10 + scris × 2,50 + ieșire × 10) / 1.000.000
              peste 272.000 la intrare: × 2 la intrare și cache, × 1,5 la ieșire
Opus 5.5    = (nou × 4 + citit × 0,20 + scris × 5 sau 8 + ieșire × 20) / 1.000.000
1. Agent de cod cu context reutilizat: raportul rămâne 2×
O sesiune de 40 de pași: prefix stabil de 60.000 de tokeni, cerere de 2.000, fiecare pas adaugă 3.000 de tokeni în context și produce 800 la ieșire. Pașii se succed la mai puțin de 5 minute, iar cea mai mare cerere are 179.000 de tokeni.
| Scris în cache | Citit din cache | Ieșire | Total | |
|---|---|---|---|---|
| Tokeni | 179.000 | 4.641.000 | 32.000 | |
| GPT-6.1 Sol | 0,4475 $ | 0,4641 $ | 0,32 $ | 1,23 $ |
| Claude Opus 5.5 | 0,895 $ | 0,9282 $ | 0,64 $ | 2,46 $ |
O pauză de 12 minute la jumătatea sesiunii, când contextul are 119.000 de tokeni, nu schimbă nimic la 6.1 Sol. La Opus 5.5, cu cache-ul de 5 minute, acei tokeni se rescriu la 5 $ în loc să fie citiți la 0,20 $: total 3,03 $, raport 2,5×.
2. Extragere dintr-un dosar lung: raportul coboară la 1,02×
O cerere cu 400.000 de tokeni de documente, 2.000 de instrucțiuni și 6.000 la ieșire, fără scriere în cache.
- GPT-6.1 Sol, peste prag: 402.000 × 4 $ + 6.000 × 15 $ = 1,70 $
- Claude Opus 5.5: 402.000 × 4 $ + 6.000 × 20 $ = 1,73 $
Citind documentația, în modul implicit de cache cererea către 6.1 Sol s-ar factura integral la tariful de scriere, 5 $ peste prag: 2,10 $, mai mult decât la Opus 5.5. Verifică cache_write_tokens în usage înainte să te bazezi pe cifră. Împărțit în două cereri de câte 202.000 de tokeni, dosarul costă 0,87 $ față de 1,74 $, din nou 2×, dar documentele nu mai sunt văzute împreună.
3. Flux scurt cu multe apeluri de unelte: de la 2× la 2,7×
Un agent de triere: prefix de 4.000 de tokeni, mesaj de 300, opt apeluri de model pe sarcină, fiecare pas adaugă 500 de tokeni și produce 150 la ieșire. Pe sarcină rezultă 44.600 de tokeni citiți din cache, 3.800 scriși și 1.200 la ieșire.
| La 1.000 de sarcini | GPT-6.1 Sol | Claude Opus 5.5 | Raport |
|---|---|---|---|
| Trafic continuu | 25,96 $ | 51,92 $ | 2,0× |
| O sarcină la 10–20 de minute | 25,96 $ | 71,12 $ | 2,7× |
La trafic rar, prefixul expiră la Anthropic între sarcini și se rescrie la 5 $; un punct de întrerupere cu ttl: "1h" pe prefix readuce raportul la 2×.
Ce nu prind scenariile: consumul real de tokeni
În măsurătorile Artificial Analysis din secțiunea următoare, tokenii nu sunt egali. La efort medium, Opus 5.5 a produs 26.000 de tokeni de ieșire pe sarcină față de 8.000, iar sarcina a costat 1,34 $ față de 0,21 $. Diferența de consum cântărește mai mult decât orice linie din lista de prețuri.
Benchmark-uri: o evaluare independentă le rulează pe amândouă
Artificial Analysis rulează ambele modele pe aceleași zece evaluări, la toate nivelurile de efort, și publică un indice agregat (Intelligence Index v4.3.2) împreună cu costul mediu pe sarcină. Opus 5.5 apare în configurația „Default Fallback”. Valori citite la 8 octombrie 2026:
| Efort | GPT-6.1 Sol: indice · cost pe sarcină | Opus 5.5: indice · cost pe sarcină |
|---|---|---|
low |
42,1 | 42,3 |
medium |
47,8 · 0,21 $ | 51,2 · 1,34 $ |
high |
50,2 · 0,32 $ | 53,6 · 1,82 $ |
xhigh |
51,0 · 0,39 $ | 56,0 · 3,46 $ |
max |
51,8 · 0,72 $ | 57,6 · 5,98 $ |
- Scor. La
lowmodelele sunt la egalitate; de lamediumîn sus, Opus 5.5 are între 3,3 și 5,8 puncte în plus. Lamaxconduce pe opt din cele zece evaluări, între care Terminal-Bench 4.0 și GDPval-AA; 6.1 Sol conduce pe GDP.pdf (31 % față de 26 %), iar CritPt e la egalitate. - Cost. La același nivel de efort, sarcina costă la Opus 5.5 de 5,7 până la 8,8 ori mai mult, nu de două ori: la
maxa produs 119.000 de tokeni de ieșire pe sarcină, față de 38.000. - Scor egal. Opus 5.5 la
medium(51,2 la 1,34 $) stă lângă 6.1 Sol laxhigh(51,0 la 0,39 $) și lamax(51,8 la 0,72 $). Peste 52, dintre cele două ajunge doar Opus 5.5.
Al doilea evaluator terț, Surge AI, le are pe amândouă pe clasamentul GDP.xlsx (surgehq.ai/benchmarks/gdp-xlsx): 30,3 % pentru Opus 5.5 și 22 % pentru 6.1 Sol, la efort maxim, fără cost afișat.
Cifrele furnizorilor se citesc cu mai multă rezervă. Anunțul OpenAI, citit într-o copie arhivată, pune Opus 5.5 pe trei grafice, cu mențiunea că evaluările concurenței „were taken from publicly available reports”. Textul citează AutomationBench la medium, unde 6.1 Sol are 31,7 % față de 29,5 %; pe același grafic, la max, Opus 5.5 are 42,5 % față de 36,1 %. Tabelul Anthropic din 22 septembrie nu putea include 6.1 Sol, iar același test iese diferit după cine îl rulează: pe Terminal-Bench 4.0, Opus 5.5 are 66,4 % la Anthropic și 60 % la Artificial Analysis.
Care e mai bun pentru cod: GPT-6.1 Sol sau Claude Opus 5.5?
Pe singurul test de cod rulat de același evaluator pe ambele, Terminal-Bench 4.0 la Artificial Analysis, Opus 5.5 conduce: 53 % față de 48 % la medium și 60 % față de 56 % la max. Testele furnizorilor nu se suprapun: OpenAI raportează 6.1 Sol pe DeepSWE v1.1, Anthropic raportează Opus 5.5 pe CursorBench și FrontierCode. Patru-cinci puncte pe un benchmark nu spun dacă diferența apare pe depozitul tău și dacă acoperă costul; asta se testează, pe 10–20 de sarcini proprii.
Contează și unealta. GPT-6.1 Sol rulează în Codex, descris în ghidul practic Codex, iar Opus 5.5 în Claude Code. Acolo, randamentul depinde de felul în care conduci agentul: context ținut sub control, subagenți, hooks, mod headless în CI. Acestea sunt modulele cursului Claude Code Mastery, care este despre Claude Code, nu despre Codex. Uneltele de cod, puse alături, sunt în Claude Code vs Cursor vs GitHub Copilot.
Diferențele de API care costă timp de inginerie
- Interfața pentru unelte. O integrare cu funcții pe Chat Completions se rescrie pe Responses API pentru 6.1 Sol. Opus 5.5 respinge cu eroare 400 forțarea uneltei (
tool_choicede tipanysautool); pentru JSON valid pe schemă rămân strict tool use și structured outputs. - Raționamentul nu se oprește, iar
temperaturedispare. Codul care dezactiva raționamentul coboară efortul lalow. Ghidul GPT-6 cere scoatereatemperatureșitop_pdin cerere; Opus 5.5 respinge orice valoare diferită de cea implicită și nu acceptă prefill. - Starea nu se mută. La Opus 5.5, blocurile de thinking sunt legate de model și de conversație. O sarcină mutată la jumătate pe celălalt furnizor pierde raționamentul și rescrie tot contextul în cache.
Date procesate în UE
- GPT-6.1 Sol suportă rezidența datelor în SUA și în UE, prin
eu.api.openai.com. Condițiile dindevelopers.openai.com/api/docs/guides/your-data: eligibilitate stabilită cu echipa de vânzări, aprobare pentru controalele de monitorizare a abuzului, un amendament de retenție și un adaos de 10 %. Fast mode nu este disponibil cu rezidență UE. - Claude Opus 5.5 nu are opțiune UE pe API-ul Claude:
inference_geoacceptă doarglobalșius(platform.claude.com/docs/en/manage-claude/data-residency). Procesarea în UE se obține pe Amazon Bedrock (endpoint regional sau profil de inferență EU) ori pe Google Cloud (endpointul multi-regiuneeu), cu 10 % peste endpointul global, potrivit documentației Anthropic; pe ambele lipsesc o parte dintre uneltele de pe server și endpointul Message Batches.
Acestea sunt fapte de documentație, nu o analiză juridică; ce date poți trimite unui furnizor este în ghidul despre datele clienților și GDPR.
Ce alegi: șase situații concrete
- Agent de cod, sesiuni sub prag. GPT-6.1 Sol pornește cu jumătate din prețul pe token și cu un cache care rezistă la pauze; Opus 5.5 are patru-cinci puncte în plus pe Terminal-Bench 4.0.
- Documente lungi într-o singură cerere. Peste prag, prețul pe token nu mai desparte modelele. Pe GDP.pdf conduce 6.1 Sol, pe GDP.xlsx conduce Opus 5.5; alegi după documentele tale.
- Flux scurt, volum mare, multe unelte. GPT-6.1 Sol are avantajul de preț și de consum.
- Nivel suficient, cost minim. Dacă îți ajunge nivelul lui Opus 5.5 la
medium, 6.1 Sol laxhighîl atinge cu circa o treime din costul pe sarcină. - Sarcini puține și grele. Peste indicele 52 ajunge doar Opus 5.5, de la
highîn sus, cu 1,82–5,98 $ pe sarcină. Dacă nu ajunge, vezi Opus 5.5 vs Fable 5.1. - Le folosești pe amândouă, cu rutare. 6.1 Sol ca implicit pentru volum, Opus 5.5 pentru sarcinile pe care evaluarea ta arată că le rezolvă mai bine. Rutezi la granița dintre sarcini, fiindcă nici cache-ul, nici raționamentul nu trec de la un furnizor la altul. Arhitectura (gateway, reguli de rutare, fallback între furnizori) și criteriile de alegere sunt tratate în cursul Comparație Modele AI 2026.
Protocol de test pe sarcinile tale
- Alege 20–30 de sarcini reale, cu rezultatul corect cunoscut. Include cinci pe care modelul actual le-a greșit.
- Scrie criteriul de reușit sau ratat înainte de prima rulare.
- Îngheață instrucțiunile, uneltele și fișierele. Setează efortul explicit și rulează fiecare model la
mediumși lahigh; nivelurile cu același nume nu sunt echivalente între furnizori. - Rulează fiecare sarcină de trei ori și păstrează
usagecomplet. - Calculează costul pe sarcină reușită: costul total împărțit la numărul de reușite.
- Scrie regula de decizie dinainte, de exemplu „rămânem pe modelul mai ieftin dacă rata de reușită este la cel mult trei puncte distanță”.
Cum treci de la acest protocol la o evaluare cu set de cazuri și notare automată este în cum evaluezi un model AI înainte de producție.
Întrebări frecvente
GPT-6.1 Sol sau Claude Opus 5.5: care este mai bun?
În evaluarea independentă Artificial Analysis, Opus 5.5 are indicele mai mare de la efort medium în sus (57,6 față de 51,8 la max) și conduce pe opt din zece teste. GPT-6.1 Sol conduce pe GDP.pdf și costă de 6–9 ori mai puțin pe sarcină.
Care este mai ieftin, GPT-6.1 Sol sau Claude Opus 5.5?
GPT-6.1 Sol. La preț de listă costă jumătate pe fiecare linie: 2 $ intrare, 10 $ ieșire, 0,10 $ citire din cache. Pe sarcină, Artificial Analysis a măsurat 0,21 $ față de 1,34 $ la efort medium, fiindcă Opus 5.5 consumă mai mulți tokeni.
GPT 6.1 vs Opus 5.5 la coding: care este mai bun pentru cod?
Pe Terminal-Bench 4.0 rulat de Artificial Analysis, Opus 5.5 are 60 % față de 56 % la efort max și 53 % față de 48 % la medium. Pentru depozitul tău decide un test propriu.
Se pot folosi GPT-6.1 Sol și Claude Opus 5.5 în același produs?
Da, cu rutare pe tip de sarcină. Costul este operațional: două seturi de instrucțiuni, două mecanisme de cache și două formate de usage.
Pot procesa datele în UE cu GPT-6.1 Sol și cu Claude Opus 5.5? Cu GPT-6.1 Sol, da, pe endpointul european al API-ului OpenAI, cu aprobare și un adaos de 10 %. Cu Opus 5.5, nu pe API-ul Claude; procesarea în UE se face prin Amazon Bedrock sau Google Cloud.
Concluzie
Între GPT-6.1 Sol și Claude Opus 5.5, lista de prețuri spune 2×. La același consum de tokeni, raportul coboară spre 1× peste 272.000 de tokeni de intrare și urcă la 2,7× când cache-ul de 5 minute expiră. La consumul măsurat de Artificial Analysis, Opus 5.5 costă de 6–9 ori mai mult pe sarcină și obține un indice cu 3–6 puncte mai mare de la medium în sus. Alegi între un model care ajunge mai sus și unul care ajunge aproape, mult mai ieftin; care dintre ele îți trebuie arată doar testul pe sarcinile tale.
Surse
Surse citite la 8 octombrie 2026.
- OpenAI: fișa modelului GPT-6.1 Sol
- OpenAI: Prompt caching
- OpenAI: Introducing GPT-6.1 Sol
- Anthropic: Pricing
- Anthropic: What's new in Claude Opus 5.5
- Anthropic: Claude Opus 5.5, pagina de lansare
- Artificial Analysis: GPT-6.1 Sol vs Claude Opus 5.5
Articol redactat la 8 octombrie 2026. Scorurile provin de la Artificial Analysis, Surge AI și de la furnizori. Calculele de cost folosesc volume de tokeni ipotetice, declarate în text. Cursuri-AI.ro este furnizor de cursuri plătite, deci parte interesată.

Cursul care continuă acest articol
AI Evals pentru LLM-uri în Producție: Testare, Scoring și Calitate pre-Deployment
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Evaluării LLM: De la Vibe-Checks la Măsurare Riguroasă
- Golden Datasets: Curare, Etichetare și Date Sintetice Fără PII
- LLM-as-a-Judge: Rubrici, Calibrare și Mitigarea Bias-urilor
- Metrici pentru RAG și Generare: Faithfulness, Relevancy și Context (RAGAS)
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.