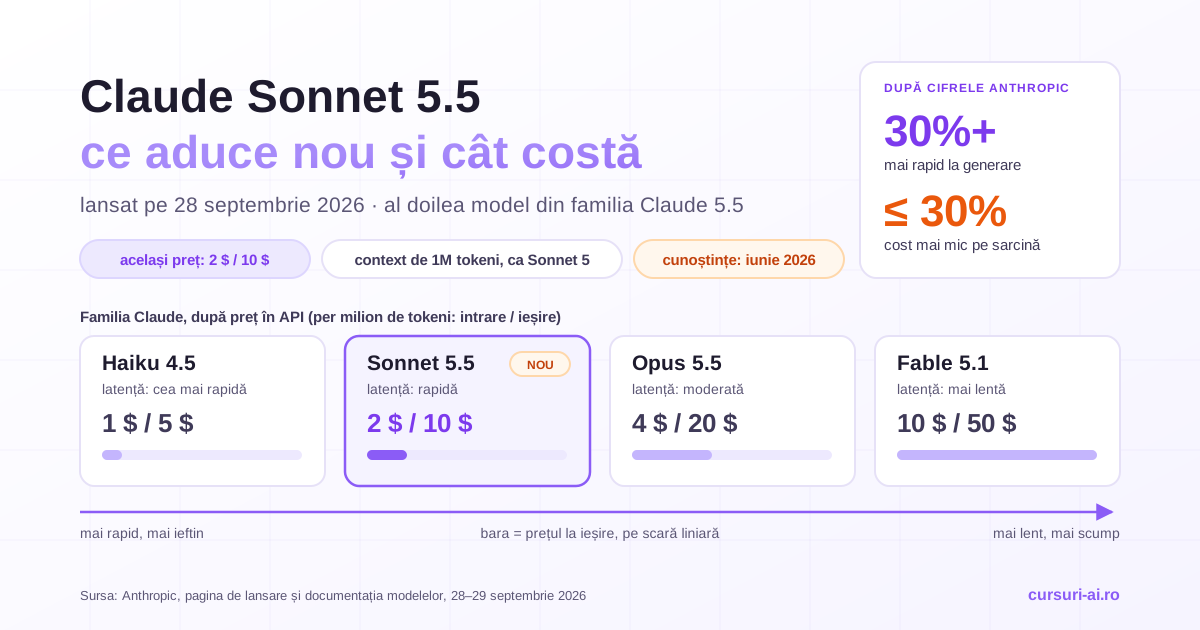
Claude Sonnet 5.5 vs ChatGPT a devenit, pe 28 septembrie 2026, o comparație la același preț: Anthropic a lansat Sonnet 5.5 la 2 $ intrare și 10 $ ieșire per milion de tokeni, exact prețul de listă al lui GPT-6 Sol, și a pus o coloană GPT-6 Sol direct în tabelul de benchmark-uri al lansării. Prețul identic ascunde trei diferențe care decid alegerea: cine a măsurat fiecare cifră, câți tokeni consumă fiecare model pentru aceeași sarcină și ce model primești efectiv în aplicația pe care o plătești. Le luăm pe rând, cu sursa lângă fiecare număr, pentru doi cititori: cel care alege între abonamentele Claude și ChatGPT și developerul care alege între două API-uri.
Claude Sonnet 5.5 vs ChatGPT: ce comparăm, concret, la 29 septembrie 2026
Două precizări înainte de orice tabel.
Prima: „ChatGPT” nu e un model. În API, perechea lui Sonnet 5.5 la același preț e gpt-6-sol. În aplicația ChatGPT, însă, GPT-6 Sol nu rulează în conversațiile obișnuite: documentația OpenAI spune explicit că GPT-6 Sol și GPT-6 Luna sunt disponibile în ChatGPT Work și Codex și nu sunt disponibile în Chat, unde planurile plătite folosesc GPT-5.6 Sol. „Sonnet 5.5 vs ChatGPT” înseamnă deci un lucru pentru un developer și altul pentru cine deschide chatul de pe telefon.
A doua: acum o săptămână, comparația dintre Opus 5.5 și GPT-6 Sol nu se putea face din surse oficiale, pentru că niciun furnizor nu pusese modelul celuilalt în tabel; contextul acela e în Claude Opus 5.5 vs GPT-6 Sol și Luna. Acum, pagina de lansare Sonnet 5.5 are o coloană GPT-6 Sol. Asta nu o face neutră: e tabelul unui furnizor, cu rânduri pe care un evaluator terț a rulat ambele modele și rânduri pe care nu. A citi un asemenea tabel pe coloana „cine a măsurat, la ce efort” e deprinderea centrală din Comparație Modele AI 2026, unde benchmark-urile și metodologia de evaluare au lecții separate; aici o aplicăm pe un singur caz.
Ce nu intră aici: alte modele, planurile pentru echipe (sunt comparate în ChatGPT Business vs Claude Team vs Copilot) comparația generală dintre cele două companii, alegerea între modelele Anthropic (în Sonnet 5.5 vs Opus 5.5 vs Fable 5.1) și fișa de lansare a lui Sonnet 5.5 (în Claude Sonnet 5.5: ce este, ce aduce nou și cât costă).
Fișa tehnică: același preț de listă, rând cu rând
Valorile sunt în dolari per milion de tokeni, la 29 septembrie 2026, din grila de prețuri Anthropic, din fișa GPT-6 Sol și din documentele indicate în ultima coloană (toate sunt în lista de surse).
| Specificație | Claude Sonnet 5.5 | GPT-6 Sol | Sursa |
|---|---|---|---|
| ID în API | claude-sonnet-5-5 |
gpt-6-sol |
Anthropic Models overview; fișa OpenAI |
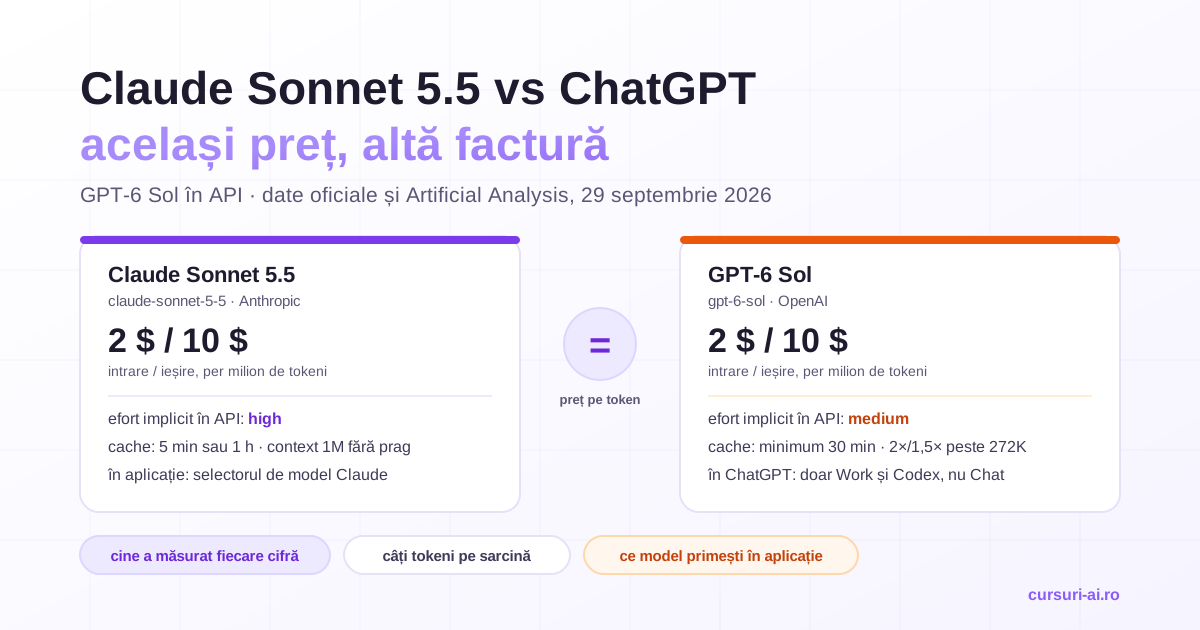
| Intrare / ieșire | 2 $ / 10 $ | 2 $ / 10 $ | grila Anthropic; fișa OpenAI |
| Citire din cache | 0,20 $ (0,1× intrarea) | 0,20 $ (0,1× intrarea) | idem |
| Scriere în cache | 2,50 $ pentru 5 minute, 4 $ pentru o oră | 2,50 $, prefix eligibil minimum 30 de minute | grila Anthropic; ghidul OpenAI de prompt caching |
| Prompt minim pentru cache | 512 tokeni | 1.024 tokeni | What's new Sonnet 5.5; ghidul OpenAI |
| Batch | 1 $ / 5 $ (−50%) | 1 $ / 5 $ (−50%; la fel Flex) | grila Anthropic; pagina de prețuri OpenAI |
| Context | 1.000.000 de tokeni, același tarif pe tot contextul | 1.050.000 de tokeni, maximum 922.000 la intrare | Models overview; fișa OpenAI |
| Peste 272.000 de tokeni de intrare | fără suprataxă | 4 $ / 15 $ pentru toată cererea (2× intrare și cache, 1,5× ieșire) | grila Anthropic; pagina de prețuri OpenAI |
| Ieșire maximă | 128.000 (300.000 în Batch, cu header beta) | 128.000 | Models overview; fișa OpenAI |
| Cunoștințe până în | iunie 2026 | 20 aprilie 2026 | idem |
| Efort implicit în API | high |
medium |
Models overview; fișa OpenAI |
| Niveluri de efort | low, medium, high, xhigh, max; gândirea inițială se oprește cu between_tools (până la high) |
none, low, medium, high, xhigh, max |
What's new Sonnet 5.5; fișa OpenAI |
| Procesare în UE prin API-ul direct | nu: inference_geo acceptă global și us; endpointuri regionale pe Amazon Bedrock și Google Cloud (+10%) |
da, doar cu procesare Standard (+10%) | Anthropic Data residency; OpenAI „Your data” |
La nivel de preț pe token, cele două modele sunt identice pe primele șase rânduri. Diferențele reale încep de la rândul „peste 272.000” și continuă în locurile pe care nicio grilă nu le arată.
Același preț, altă factură: unde apare diferența
1. Câți tokeni scrie fiecare model pentru aceeași sarcină
Singura sursă independentă care a rulat ambele modele în același harness, pe fiecare nivel de efort, e Artificial Analysis. La 29 septembrie 2026, pe Intelligence Index v4.3.2 (zece evaluări, printre care GDPval-AA, AA-Briefcase, AutomationBench-AA și Terminal-Bench 4.0), paginile de comparație pe fiecare nivel arată:
| Efort (același la ambele) | Index Sonnet 5.5 | Index GPT-6 Sol | Cost pe sarcină Sonnet 5.5 | Cost pe sarcină GPT-6 Sol | Raport de cost |
|---|---|---|---|---|---|
| low | 36 | 34 | 0,41 $ | 0,13 $ | 3,2× |
| medium | 41 | 40 | 0,59 $ | 0,25 $ | 2,4× |
| high | 47 | 43 | 1,08 $ | 0,38 $ | 2,8× |
| xhigh | 52 | 44 | 2,74 $ | 0,52 $ | 5,3× |
| max | 56 | 48 | 7,60 $ | 1,05 $ | 7,2× |
Sonnet 5.5 e rulat de Artificial Analysis cu adaptive thinking și fallback-ul implicit; costul pe sarcină e media ponderată pe sarcinile indexului, la prețurile de listă. Raportul din ultima coloană e calculul nostru pe cifrele lor.
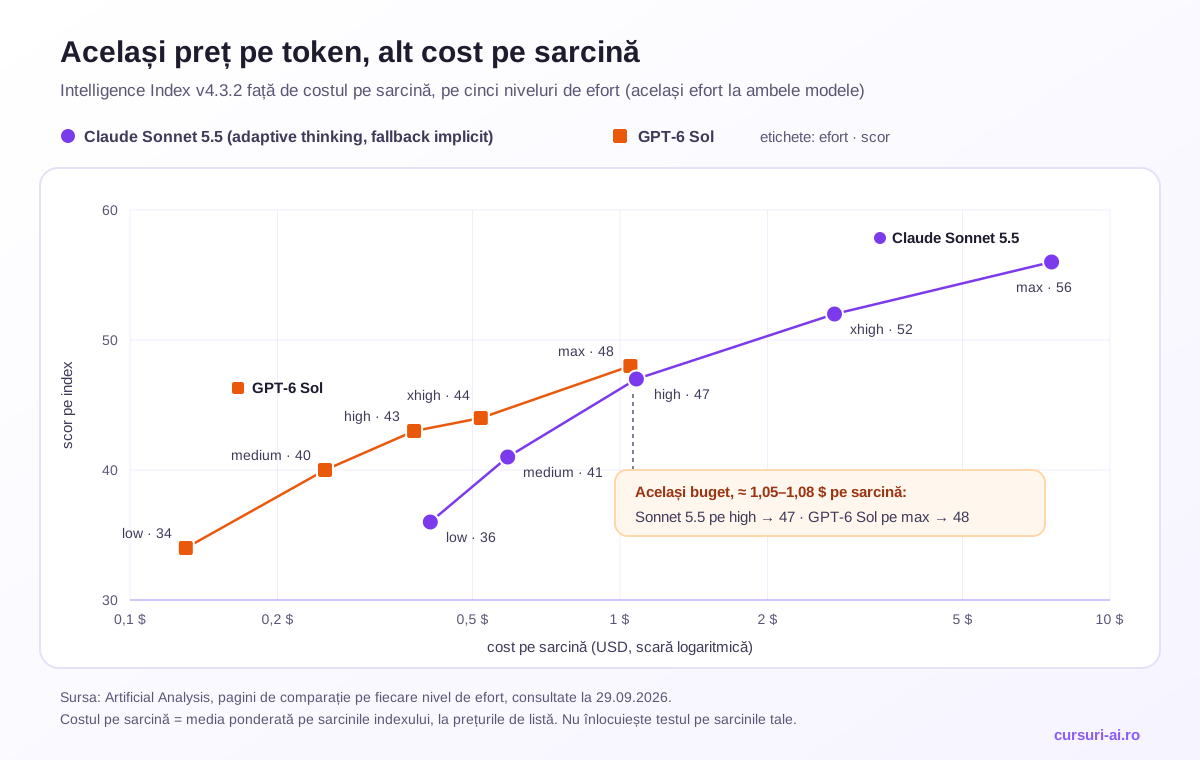
Trei lucruri reies din tabel:
- La low și medium, indexul e practic egal (36 față de 34, 41 față de 40), iar GPT-6 Sol costă de 2,4–3,2 ori mai puțin pe sarcină.
- De la high în sus, Sonnet 5.5 se desprinde pe index, dar costul crește mai repede decât scorul. La max, Artificial Analysis măsoară 193.000 de tokeni de ieșire pe sarcină pentru Sonnet 5.5 și 31.000 pentru GPT-6 Sol. Sonnet 5.5 generează mai repede (137 față de 78 de tokeni pe secundă), dar termină mai târziu: 382 de secunde față de 191 pentru un răspuns cap-coadă.
- La buget aproape egal pe sarcină, Sonnet 5.5 pe high (1,08 $) și GPT-6 Sol pe max (1,05 $) ajung la 47, respectiv 48 de puncte. „Același preț” înseamnă, în practică, „nivel de efort diferit la același buget”.
Indexul e o medie pe zece teste care nu seamănă neapărat cu sarcinile tale. Folosește-l pentru ordinul de mărime, nu pentru decizie.
2. Setările implicite diferă
Sonnet 5.5 pornește în API pe efort high, GPT-6 Sol pe medium. Dacă le compari „din cutie”, compari două niveluri diferite: pe tabelul de mai sus, 1,08 $ față de 0,25 $ pe sarcină, de 4,3 ori. Documentația Anthropic avertizează că nivelurile au fost recalibrate față de Sonnet 5 și recomandă high ca punct de plecare general, medium pentru coding agentic bine specificat (cu trecere la high pentru sarcini mai grele) și medium sau low pentru chat; ghidul de modele ChatGPT recomandă să începi cu Medium pentru Sol. În aplicațiile Claude și în Claude Code, implicitul pentru Sonnet 5.5 e Medium, potrivit paginii de lansare.
3. Contextul lung
Presupunem o cerere cu 400.000 de tokeni de intrare noi și 10.000 de ieșire, fără cache. Sonnet 5.5: 0,80 $ + 0,10 $ = 0,90 $. GPT-6 Sol, peste pragul de 272.000: 1,60 $ + 0,15 $ = 1,75 $. La 270.000 de tokeni de intrare, costul e identic (0,64 $); la 300.000, Sonnet 5.5 costă 0,70 $, iar GPT-6 Sol 1,35 $, pentru că suprataxa se aplică întregii cereri, nu doar tokenilor de peste prag. Dacă fluxul tău trimite des contracte întregi, depozite de cod sau dosare de sute de pagini, rândul acesta contează mai mult decât toate benchmark-urile.
4. Cache-ul: aceleași tarife, alt comportament
La OpenAI, prompt caching-ul e activ implicit, cu prefix minim de 1.024 de tokeni, iar un prefix rămâne eligibil pentru reutilizare cel puțin 30 de minute după ultima scriere sau citire. La Anthropic, cache-ul se activează cu câmpul cache_control (modul automat cere un singur câmp la nivelul cererii) sau cu breakpoint-uri explicite, are minimum 512 tokeni pe Sonnet 5.5 și durează 5 minute (scriere la 1,25× intrarea) sau o oră (scriere la 2×), cu reîmprospătare la fiecare citire.
Presupunem un prefix de 100.000 de tokeni (instrucțiuni plus documente) retrimis de 10 ori:
| Scenariu | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Cache activ, cereri la câteva secunde distanță | 0,25 $ + 9 × 0,02 $ = 0,43 $ | 0,43 $ |
Fără cache_control în cererile către Claude |
10 × 0,20 $ = 2,00 $ | 0,43 $ (caching implicit) |
| Pauze de 10 minute între cereri, cache de 5 minute | 10 × 0,25 $ = 2,50 $ | 0,43 $ (prefix eligibil 30 de minute) |
| Pauze de 10 minute, cache de o oră la Claude | 0,40 $ + 9 × 0,02 $ = 0,58 $ | 0,43 $ |
Al treilea rând e capcana clasică a aplicațiilor în care un om citește fiecare răspuns înainte să scrie următorul: cache-ul de 5 minute expiră, fiecare cerere îl rescrie, iar factura iese mai mare decât fără cache.
5. Tokenizerul
Același text nu produce același număr de tokeni la cei doi furnizori, iar niciunul nu publică un raport între tokenizere. Anthropic precizează că Sonnet 5.5 folosește același tokenizer ca Sonnet 5 și că un milion de tokeni înseamnă aproximativ 555.000 de cuvinte pe tokenizerul actual, fără să indice limba. Măsori pe textele tale, în română: POST /v1/messages/count_tokens la Anthropic (o estimare, spune documentația) și POST /v1/responses/input_tokens la OpenAI. Diferența intră direct în cost, pentru că prețul e pe token. Cum citești câmpul usage, cum bugetezi tokenii și cum tratezi erorile cu ambele SDK-uri e materia primelor module din Construire de Aplicații AI cu Python și SDK-uri.
Ce se schimbă în cod, pe scurt
- Sonnet 5.5:
thinking: {"type": "disabled"}întoarce 400, se foloseștebetween_tools, acceptat doar lalow,mediumșihigh;tool_choicede tipanysautoolîntoarce 400, deci rămâi peautocu strict tool use sau structured outputs; blocurile de thinking sunt legate de model și de conversație, deci istoricul se ține append-only; refuzurile vin ca HTTP 200 custop_reason: "refusal", iar fallback-ul pe server (beta) reia pe Sonnet 5 doar categoriilecyberșifrontier_llm. - GPT-6 Sol: uneltele cu raționament cer Responses API, pentru că în Chat Completions function calling merge doar cu
reasoning_effort: "none"; când efortul nu enone, scoțitemperature,top_pșitop_logprobs; efortul se schimbă în mijlocul conversației cu un itemconfiguration_update, fără să strici cache-ul.
Benchmark-urile: ce a pus Anthropic în tabel și cine a măsurat fiecare cifră
GPT-6 Sol apare pe patru rânduri ale paginii de lansare, iar System Card-ul Sonnet 5.5 mai adaugă unul. Configurația standard declarată de Anthropic pentru modelele Claude e adaptive thinking la efort max, media a cinci rulări, dacă nu se precizează altfel. Cifrele concurenței sunt preluate „din system card-urile sau clasamentele publicate”.
| Test (ce măsoară) | Sonnet 5.5 | GPT-6 Sol | Cine a rulat · efort | Note ale sursei |
|---|---|---|---|---|
| GDPval-AA v2.1, Elo (sarcini profesionale din 44 de ocupații) | 1844 | 1487 | Artificial Analysis, ambele modele; max la ambele (la Sol, după eticheta Artificial Analysis) | Sonnet 5.5 rulat pe o versiune pre-lansare cu un bug la structured outputs, reparat; OpenAI a reparat recent un bug de înțelegere a imaginilor la Sol |
| AA-Briefcase v1.1, Elo (proiecte lungi, mii de fișiere sursă) | 1811 | 1483 | Artificial Analysis; max la ambele | aceleași două note |
| FrontierCode 1.1 Main (modificări de cod gata de merge) | 46,2% la Max · 52,1% la Xhigh | 49,3% | Cognition, pentru toate modelele; Sonnet în Claude Code, Sol în Codex CLI; efortul scorului Sol nu e precizat în text | la Max, Sonnet 5.5 a rulat mai des un skill de code review cu subagenți; în două cazuri examinate de Cognition, asta a dus la timeout sau la editări în afara sarcinii |
| Chartography, fără unelte (grafice specializate) | 61,6% | 53,6% | Sonnet: Anthropic, intern, max, 5 rulări; Sol: clasamentul public Surge AI | testarea internă sugerează că scorul Sol nu a fost afectat de bugul de imagine |
| AutomationBench 1.0.6 (fluxuri de business între aplicații) | 44,7% | 32,0% | Sonnet: Zapier, max, cu fallback implicit; Sol: efort și sursă exactă neprecizate | doar în System Card, nu pe pagina de lansare |
Terminal-Bench 4.0, CursorBench 4.0, Humanity's Last Exam și OSWorld 2.1 au liniuță la GPT-6 Sol. Anthropic notează că nici OpenAI, nici clasamentul public nu au publicat Terminal-Bench 4.0 pentru Sol și folosește GPT-5.6 Sol ca reper pe grafice. O liniuță înseamnă „nemăsurat”, nu „pierdut”.
Cum le citești:
- GDPval-AA și AA-Briefcase sunt comparația cea mai solidă, pentru că un evaluator terț a rulat ambele modele în același harness, la același efort. Diferența la max (357, respectiv 328 de puncte Elo) e mare. Dar tot Artificial Analysis arată că, la max, Sonnet 5.5 costă de 7,2 ori mai mult pe sarcină, iar pe GDPval-AA, la low și medium, GPT-6 Sol e ușor peste (1176 față de 1168, 1320 față de 1292). Pe AA-Briefcase, Sonnet 5.5 rămâne peste la toate cele cinci niveluri.
- FrontierCode are două cifre pentru Sonnet 5.5. GPT-6 Sol (49,3%) e peste Sonnet 5.5 la Max (46,2%) și sub Sonnet 5.5 la Xhigh (52,1%). Anthropic scrie că Sonnet 5.5 la High, efortul implicit din API, egalează cel mai bun scor al GPT-6 Sol „pentru aproximativ o cincime din costul pe sarcină”. E afirmația Anthropic: System Card-ul precizează că fișierele Cognition nu conțin cost pentru Sonnet 5.5, motiv pentru care graficul de acolo folosește tokeni de ieșire, nu dolari. În plus, fiecare model a rulat în unealta propriului furnizor, deci se măsoară modelul împreună cu harness-ul.
- Chartography compară doi evaluatori. Anthropic declară că implementarea sa respectă sarcinile și intervalele din depozitul oficial și folosește același grader ca clasamentul Surge AI. Diferența de 8 puncte e un indiciu, nu un verdict.
Un exemplu care arată de ce contează coloana „cine a rulat”: Terminal-Bench 4.0 apare pentru GPT-6 Sol într-o singură sursă, indexul Artificial Analysis, care măsoară, la max, 64% pentru Sonnet 5.5 și 44% pentru GPT-6 Sol. Pe același test, Anthropic raportează pentru Sonnet 5.5 70,6%, în propriul setup.
Ce raportează OpenAI pentru GPT-6 Sol
Cifrele de mai jos vin din anunțul OpenAI „Introducing GPT-6 Sol and Luna” și nu se amestecă cu tabelul de mai sus; coloana din dreapta spune dacă există o cifră Sonnet 5.5 comparabilă. Lansarea OpenAI, cu toate testele și cu nuanțele prețului, e analizată în GPT-6 Sol și Luna: noile modele OpenAI.
| Test | GPT-6 Sol (OpenAI) | Sonnet 5.5 (Anthropic, System Card) | Comparabil? |
|---|---|---|---|
| AutomationBench 1.0.6 | 33,2% la xhigh, 0,27 $ pe sarcină | 44,7% la max, rulat de Zapier | parțial: aceeași versiune, alți operatori; tabelul Anthropic îi atribuie lui Sol 32,0% |
| DeepSWE v1.1 | 68,8% la max | 71,0%, media a cinci rulări, configurația standard | parțial: harness-uri diferite |
| OSWorld | 60,5% (2.0 offline, versiunea 2026.08.08, partial reward, xhigh) | 80,1% (2.1, partial) | nu: versiuni diferite ale testului |
| Agents' Last Exam | 56,4% la max | — | nu există cifră pentru Sonnet 5.5 |
În aplicații: ce model primești efectiv pe fiecare plan
Prețurile sunt cele afișate în USD la 29 septembrie 2026 pe pagina de prețuri Claude și pe pagina de prețuri din documentația ChatGPT; pagina Claude precizează că nu includ taxele aplicabile, deci suma finală o vezi la checkout. „Nu e confirmat oficial” înseamnă că n-am găsit o pagină a furnizorului care să o spună.
| Plan | Preț afișat | Ce folosește conversația obișnuită | Unde găsești modelul comparat aici |
|---|---|---|---|
| Claude, planul de bază, fără abonament | 0 $ | familia Sonnet (pagina nu numește versiunea); fără Opus | Sonnet 5.5 pe acest plan: neconfirmat oficial; verifici în selectorul de model |
| Claude Pro | 20 $/lună la plata lunară; 17 $/lună la plata anuală (200 $) | Sonnet și Opus; Fable prin credite de utilizare | Sonnet 5.5 pe acest plan: neconfirmat oficial pe o pagină de plan |
| Claude Max | de la 100 $/lună | Sonnet și Opus; Fable în limita a 50% din limitele săptămânale | idem |
| ChatGPT, planul de bază, fără abonament | 0 $ | GPT-5.6 Luna | GPT-6 Sol: nu; GPT-6 Luna în aplicația desktop, în funcție de rollout |
| ChatGPT Go | 8 $/lună | GPT-5.6 Luna | GPT-6 Sol: nu |
| ChatGPT Plus | 20 $/lună | GPT-5.6 Sol (Instant, Medium, High; fără Extra High) | GPT-6 Sol doar în ChatGPT Work și Codex |
| ChatGPT Pro | de la 100 $/lună | GPT-5.6 Sol pe toate nivelurile, plus GPT-6 Pro (pe GPT-6 Astra) | GPT-6 Sol în Work și Codex, cu utilizare extinsă |
Ce înseamnă concret:
- Pe Claude, Anthropic a anunțat Sonnet 5.5 în notele de versiune ale aplicațiilor pe 28 septembrie, dar nu publică o listă a planurilor pe care apare; pagina de prețuri numește doar familiile de modele. În selectorul de model, Sonnet 5.5 are efort reglabil de la Low la Max, cu Medium implicit în aplicații. Potrivit centrului de ajutor Claude, gândirea nu se poate opri în aplicație pe Sonnet 5.5, iar cererile de securitate ofensivă cu risc ridicat (generare de exploit-uri, teste de penetrare) pot trece automat pe Sonnet 5, cu un anunț vizibil; revii la Sonnet 5.5 din selector.
- Pe ChatGPT, comparația model contra model se face în Work (documente, foi de calcul, prezentări, rapoarte) sau în Codex (cod), nu în chat. Un test „Claude vs ChatGPT” făcut în chatul Plus compară Sonnet 5.5 cu GPT-5.6 Sol, alt model decât cel din tabelele de mai sus.
- La 20 $ pe lună, ambele pagini de prețuri menționează limite de utilizare, dar niciuna nu le exprimă în unități comparabile. Nu le putem pune față în față și nu le estimăm.
Ce alegi pentru fiecare tip de muncă
Matricea pornește strict de la cifrele publicate. Niciun rând nu are un câștigător absolut; are un punct de plecare pentru testul tău.
| Tip de muncă | Ce spun cifrele publicate | Cine a măsurat | Punct de plecare |
|---|---|---|---|
| Scriere (e-mailuri, rapoarte, texte în română) | nicio cifră comparabilă; ambii furnizori descriu un stil mai clar decât la generația anterioară | afirmații ale furnizorilor | test orb pe 5–10 texte proprii |
| Coding agentic | FrontierCode: Sol 49,3%, Sonnet 5.5 între 46,2% (Max) și 52,1% (Xhigh); Terminal-Bench 4.0 la max: 64% față de 44%; costul pe sarcină e mai mic la Sol pe fiecare nivel de efort | Cognition; Artificial Analysis | Sonnet 5.5 la medium dacă lucrezi în Claude Code, GPT-6 Sol la medium dacă lucrezi în Codex; compari pe 10 PR-uri reale |
| Documente, foi de calcul, livrabile lungi | la max: GDPval-AA 1844 față de 1487, AA-Briefcase 1811 față de 1483; la low și medium, GDPval-AA apropiat, cu Sol ușor peste | Artificial Analysis | Sonnet 5.5 la high; în ChatGPT, testul se face în Work |
| Analiză de grafice | Chartography fără unelte: 61,6% față de 53,6% | evaluatori diferiți | avantaj publicat pentru Sonnet 5.5; verifici pe graficele tale |
| Lucru pe calculator (computer use) | 80,1% pe OSWorld 2.1 față de 60,5% pe OSWorld 2.0 offline | versiuni diferite ale testului | nicio comparație validă; doar test propriu |
| Volum mare, cost minim | la low și medium, index 36–41 față de 34–40, cost pe sarcină de 2,4–3,2 ori mai mic la Sol | Artificial Analysis | GPT-6 Sol la low sau none |
Dacă un singur rând descrie 80% din munca ta, alegerea se simplifică. Dacă sunt trei, rutarea pe sarcini (un model pentru livrabilele lungi, altul pentru volum) e o opțiune legitimă, iar în API se face cu o regulă simplă de rutare în cod.
Protocolul de test cap la cap, pe 5 sarcini proprii
Tabelele de mai sus îți spun ce să testezi, nu ce vei obține. Checklistul următor încape într-o după-amiază:
- Alege 5 sarcini reale, câte una din rândurile matricei care contează pentru tine, fiecare cu un criteriu de reușită scris înainte (de exemplu: „tabelul are toate cele 12 luni, iar totalurile se potrivesc cu balanța”, „testele trec fără modificări în afara fișierului cerut”).
- Același prompt, aceleași fișiere, aceleași unelte. În API, fixezi efortul explicit la ambele modele (
mediumșimedium, apoihighșihigh). În aplicații: Claude pe Sonnet 5.5 cu efort Medium, ChatGPT în Work pe GPT-6 Sol, nu în chat. - Același buget. Pui un plafon de tokeni de ieșire sau de timp pe sarcină și notezi din
usagetokenii de intrare, din cache și de ieșire; raționamentul e ieșire plătită la ambii furnizori. - Notare oarbă. Un coleg primește rezultatele etichetate A și B, în ordine aleatorie, și le notează pe o grilă de 1–5 pe fiecare criteriu înainte să afle modelul. La cod, decid testele automate, nu impresia.
- Trei rulări pe sarcină, pentru varianță. Calculezi costul per sarcină reușită și decizi după o regulă scrisă dinainte, de exemplu: „schimbăm modelul doar dacă nota medie crește cu cel puțin 0,5 și costul per sarcină reușită nu crește cu mai mult de 50%”.
Presupunem sarcini cu 30.000 de tokeni de intrare și 8.000 de ieșire: la același preț, o rulare costă 0,14 $ la ambele modele. Dacă unul dintre ele scrie 24.000 de tokeni de ieșire pentru aceeași sarcină, costul lui urcă la 0,30 $. Testul complet (5 sarcini × 3 rulări × 2 modele = 30 de rulări) costă, la aceste ipoteze, 6,60 $. Grila, notarea oarbă și intervalele de încredere pentru seturi mai mari sunt tratate în AI Evals pentru LLM-uri în Producție.
Date și confidențialitate, pe scurt
- Abonamentele individuale. Anthropic folosește conversațiile din Claude (planul de bază, Pro, Max) pentru antrenarea modelelor doar dacă alegi asta în setări, cu excepția celor semnalate pentru revizuire de siguranță, potrivit Anthropic Privacy Center. OpenAI poate folosi conținutul din ChatGPT și Codex pe planurile individuale; te retragi din Settings, Data controls, opțiunea „Improve the model for everyone”, potrivit centrului de ajutor OpenAI.
- Planurile comerciale și API-urile. Implicit, fără antrenare pe datele tale: la Anthropic pentru Claude for Work (Team, Enterprise) și API, la OpenAI pentru ChatGPT Business, Enterprise, Edu și API.
- GDPR. Dacă trimiți date personale ale clienților sau ale angajaților, furnizorul devine persoană împuternicită, iar art. 28 alin. (3) din Regulamentul (UE) 2016/679 cere un contract sau alt act juridic care stabilește obiectul, durata, natura și scopul prelucrării. Ambii furnizori au un acord de prelucrare a datelor (DPA) atașat termenilor comerciali: la Anthropic, parte din Commercial Terms; la OpenAI, parte din Services Agreement, încheiat cu OpenAI Ireland Ltd. pentru clienții din SEE și Elveția. Concluzia practică: datele clienților merg pe un plan comercial sau pe API, nu pe un abonament individual.
- Unde rulează inferența. OpenAI oferă rezidență UE pentru GPT-6 Sol doar cu procesare Standard, la +10%. API-ul direct Anthropic are rutare globală (implicită) sau doar în SUA (1,1×); endpointurile regionale sunt pe Amazon Bedrock și Google Cloud, cu +10%, iar disponibilitatea unei regiuni UE pentru Sonnet 5.5 o verifici la furnizorul cloud.
Secțiunea e informativă și nu ține loc de consultanță juridică; pentru prelucrări concrete de date personale, decizia aparține responsabilului cu protecția datelor sau juristului firmei.
Întrebări frecvente
Este Claude Sonnet 5.5 mai bun decât ChatGPT? Depinde ce înseamnă „ChatGPT” și la ce efort. În API, pe evaluările Artificial Analysis rulate la același efort, Sonnet 5.5 are indexul mai mare de la high în sus (56 față de 48 la max), dar costă de 2,8–7,2 ori mai mult pe sarcină pe aceste niveluri; la low și medium, cele două sunt aproape egale pe index, iar GPT-6 Sol e mai ieftin. În chatul ChatGPT nu rulează GPT-6 Sol, ci GPT-5.6 Sol, deci cifrele din tabele nu se aplică direct.
Cât costă Claude Sonnet 5.5 față de GPT-6 Sol în API? Același preț de listă: 2 $ intrare, 10 $ ieșire, 0,20 $ citire din cache și 2,50 $ scriere în cache (pentru 5 minute la Anthropic), iar în Batch 1 $ și 5 $. Diferența de tarif apare peste 272.000 de tokeni de intrare, unde GPT-6 Sol trece la 4 $ și 15 $ pentru toată cererea, în timp ce Sonnet 5.5 rămâne la tariful standard până la un milion de tokeni. Costul pe sarcină diferă mai ales prin numărul de tokeni generați.
Primesc GPT-6 Sol în ChatGPT Plus? Da, dar doar în ChatGPT Work și Codex. Documentația OpenAI spune că GPT-6 Sol și GPT-6 Luna nu sunt disponibile în Chat; în conversațiile obișnuite, Plus folosește GPT-5.6 Sol. Planul de bază fără abonament și Go nu au GPT-6 Sol.
De ce lipsesc cifrele GPT-6 Sol pe unele rânduri din tabelul Anthropic? Pentru că nu au fost publicate: Anthropic notează că pentru Terminal-Bench 4.0 și CursorBench 4.0 nu există scor public GPT-6 Sol și folosește GPT-5.6 Sol ca reper pe grafice. Liniuța înseamnă „nemăsurat”. Rândurile cu cifre au evaluatori diferiți: Artificial Analysis pentru GDPval-AA și AA-Briefcase, Cognition pentru FrontierCode, Anthropic și Surge AI pentru Chartography.
Pot folosi Claude Sonnet 5.5 sau GPT-6 Sol cu datele clienților? Da, pe un plan comercial sau prin API, cu acordul de prelucrare a datelor pe care ambii furnizori îl atașează termenilor comerciali, cum cere art. 28 GDPR, nu pe un abonament individual. Dacă ai nevoie de procesare în UE, OpenAI oferă rezidență UE pentru GPT-6 Sol cu procesare Standard; la Anthropic, API-ul direct rutează global sau în SUA, iar endpointurile regionale sunt pe Amazon Bedrock și Google Cloud.
Concluzie
Claude Sonnet 5.5 și GPT-6 Sol au același preț pe token la intrare, la ieșire, la citirea din cache și în Batch. Diferența de factură vine din altă parte: din câți tokeni scrie fiecare model la un anumit efort, din setările implicite diferite (high contra medium), din suprataxa OpenAI peste 272.000 de tokeni și din felul în care se comportă cache-ul. Pe benchmark-uri, rândurile rulate de un evaluator terț pe ambele modele (GDPval-AA și AA-Briefcase) dau un avantaj clar lui Sonnet 5.5 la efort maxim, plătit cu un cost pe sarcină de câteva ori mai mare; la eforturi mici, cele două sunt aproape egale, iar Sol e mai ieftin. În aplicații, comparația corectă e Claude contra ChatGPT Work sau Codex, pentru că GPT-6 Sol nu rulează în chatul ChatGPT. Singura cifră care decide pentru tine iese din protocolul pe cinci sarcini proprii, cu notare oarbă și costul per sarcină reușită în ultima coloană.
Surse
- Anthropic, „Introducing Claude Sonnet 5.5” (tabelul de benchmark-uri, notele de subsol, efortul implicit în aplicații și în API): https://www.anthropic.com/claude-sonnet-5-5
- Anthropic, Claude Sonnet 5.5 System Card (configurația standard, FrontierCode, Terminal-Bench 4.0, DeepSWE, Chartography, GDPval-AA, AA-Briefcase, AutomationBench): https://www.anthropic.com/claude-sonnet-5-5-system-card
- Anthropic Docs, Pricing (tarife, cache, Batch, context lung): https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic Docs, Models overview și What's new in Claude Sonnet 5.5: https://platform.claude.com/docs/en/models/overview și https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Anthropic Docs, Data residency: https://platform.claude.com/docs/en/manage-claude/data-residency
- Claude, Plans & Pricing: https://claude.com/pricing
- Claude Help Center, „Change the model, effort, and thinking settings” și „Why Claude switched models in your conversation with Sonnet 5.5”: https://support.claude.com/en/articles/8664678-change-the-model-effort-and-thinking-settings și https://support.claude.com/en/articles/17161993-why-claude-switched-models-in-your-conversation-with-sonnet-5-5
- Anthropic Privacy Center, „Is my data used for model training?” (consumatori și produse comerciale): https://privacy.claude.com/en/articles/10023580-is-my-data-used-for-model-training și https://privacy.claude.com/en/articles/7996868-is-my-data-used-for-model-training
- Anthropic, Data Processing Addendum: https://www.anthropic.com/legal/data-processing-addendum
- OpenAI Docs, GPT-6 Sol (preț, context, efort, endpointuri): https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI Docs, Pricing, Prompt caching, Using GPT-6 și Data controls: https://developers.openai.com/api/docs/pricing, https://developers.openai.com/api/docs/guides/prompt-caching, https://developers.openai.com/api/docs/guides/latest-model/gpt-6-astra și https://developers.openai.com/api/docs/guides/your-data
- OpenAI, „Introducing GPT-6 Sol and Luna” (cifrele raportate de OpenAI și disponibilitatea): https://openai.com/index/introducing-gpt-6-sol-and-luna/
- ChatGPT Docs, Models și Pricing: https://learn.chatgpt.com/docs/models și https://learn.chatgpt.com/docs/pricing
- OpenAI Help Center, „GPT-5.6 and GPT-6 Pro in ChatGPT”, „ChatGPT Work and Codex” și „How your data is used to improve model performance”: https://help.openai.com/en/articles/20001354-gpt-56-and-gpt-6-pro-in-chatgpt, https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex și https://help.openai.com/en/articles/5722486-how-your-data-is-used-to-improve-model-performance
- OpenAI, Data Processing Addendum: https://openai.com/policies/data-processing-addendum/
- Artificial Analysis, Claude Sonnet 5.5 vs GPT-6 Sol (Intelligence Index v4.3.2, cost și tokeni pe sarcină; pagini separate pentru fiecare nivel de efort): https://artificialanalysis.ai/models/comparisons/claude-sonnet-5-5-vs-gpt-6-sol
- Regulamentul (UE) 2016/679 (GDPR), art. 28: https://eur-lex.europa.eu/legal-content/RO/TXT/?uri=CELEX:32016R0679
Articol informativ, publicat la 29 septembrie 2026. Prețurile, specificațiile, planurile și scorurile provin din paginile oficiale ale Anthropic și OpenAI și din măsurătorile Artificial Analysis, consultate la aceeași dată; se pot schimba fără notificare. Scorurile de benchmark sunt raportate de furnizori sau de evaluatori terți, cu metodologiile lor, și sunt atribuite în text. Calculele de cost folosesc volume de tokeni ipotetice, declarate. Mărcile Claude, Anthropic, ChatGPT și OpenAI aparțin deținătorilor lor și sunt folosite doar pentru identificare. Conținutul nu constituie consultanță juridică.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.