Claude Sonnet 5.5 este noul model de mijloc al Anthropic, lansat pe 28 septembrie 2026 ca al doilea din familia Claude 5.5, după Opus 5.5. Prețul per token rămâne cel al lui Sonnet 5, dar Anthropic spune că modelul generează răspunsurile cu peste 30% mai repede și că, în testele proprii, costă cu până la 30% mai puțin pe sarcină, pentru că ajunge la același rezultat cu mai puțini tokeni. Mai jos găsești, pe înțelesul oricui, ce e nou, cât costă, unde îl folosești, ce s-a schimbat la siguranță și cum îl testezi pe munca ta într-o jumătate de oră.
Ce este Claude Sonnet 5.5, pe scurt
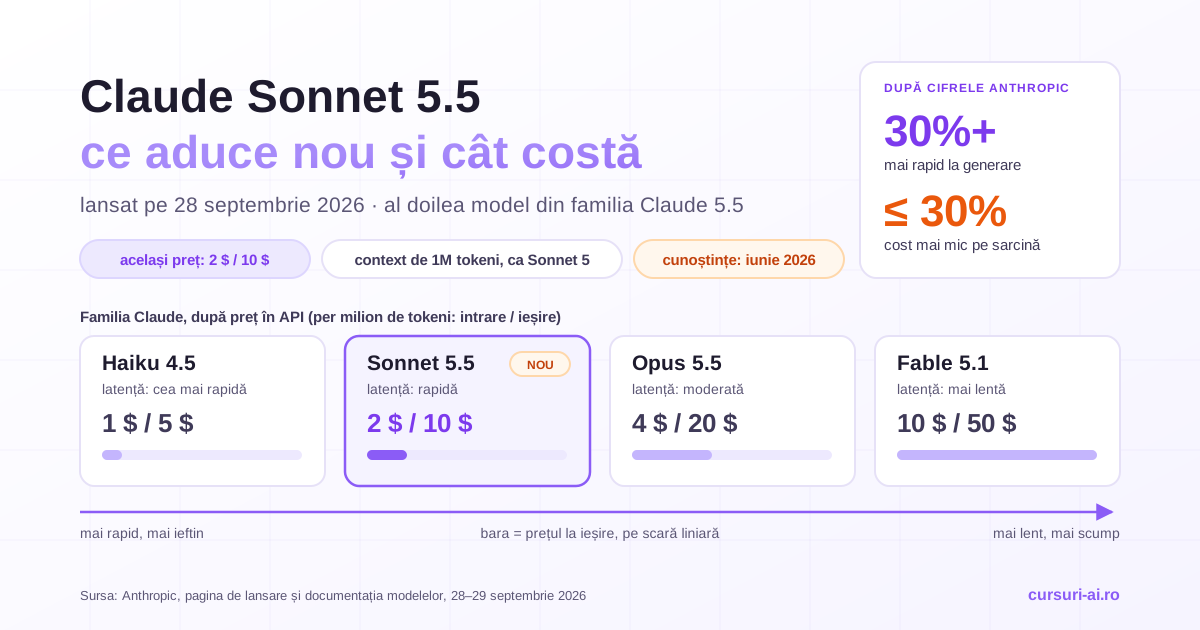
Claude e familia de modele a Anthropic, iar Haiku, Sonnet, Opus și Fable sunt principalele ei trepte, de la cel mai rapid și mai ieftin la cel mai lent și mai scump. În aplicația Claude, modelul se alege din meniul de lângă butonul de trimitere. Documentația descrie Sonnet 5.5 drept „cea mai bună combinație de viteză și inteligență”, iar pagina de lansare îl prezintă ca pe „un complement mai rapid și mai ieftin” al lui Opus 5.5: Opus e construit pentru muncă complexă, care cere judecată atentă, iar Sonnet 5.5 e „cel mai puternic la sarcini zilnice bine delimitate, la repararea bug-urilor și la crearea de documente, prezentări și foi de calcul finisate”.
Fișa tehnică, din pagina modelului și din anunțul de lansare:
- Lansare: 28 septembrie 2026; identificatorul din API este
claude-sonnet-5-5. - Context: 1.000.000 de tokeni, adică volumul de text pe care modelul îl poate citi într-o singură cerere. Răspuns maxim: 128.000 de tokeni.
- Cunoștințe: până în iunie 2026. Sonnet 5 se oprea în ianuarie 2026.
- Gândire: adaptivă, pornită implicit. Modelul decide cât „gândește” înainte să răspundă, iar tu controlezi adâncimea prin nivelul de effort: low, medium, high, xhigh sau max.
- Effort implicit: Medium în aplicațiile Claude și în Claude Code, High pe platforma pentru developeri.
- Retragere: nu mai devreme de 28 septembrie 2027.
Un token este o bucată de text, adesea o silabă sau un cuvânt scurt, și e unitatea în care se măsoară atât ce citește modelul, cât și ce scrie. Contează din două motive: prin API plătești per token, iar în aplicații tokenii consumați îți epuizează mai repede limitele de utilizare. Cum arată asta în cod, de la un apel cu effort setat explicit la citirea câmpului usage din răspuns și la un buget de tokeni pe aplicație, e tratat pas cu pas în cursul Construire de Aplicații AI cu Python și SDK-uri.
Locul lui în familia Claude 5.5
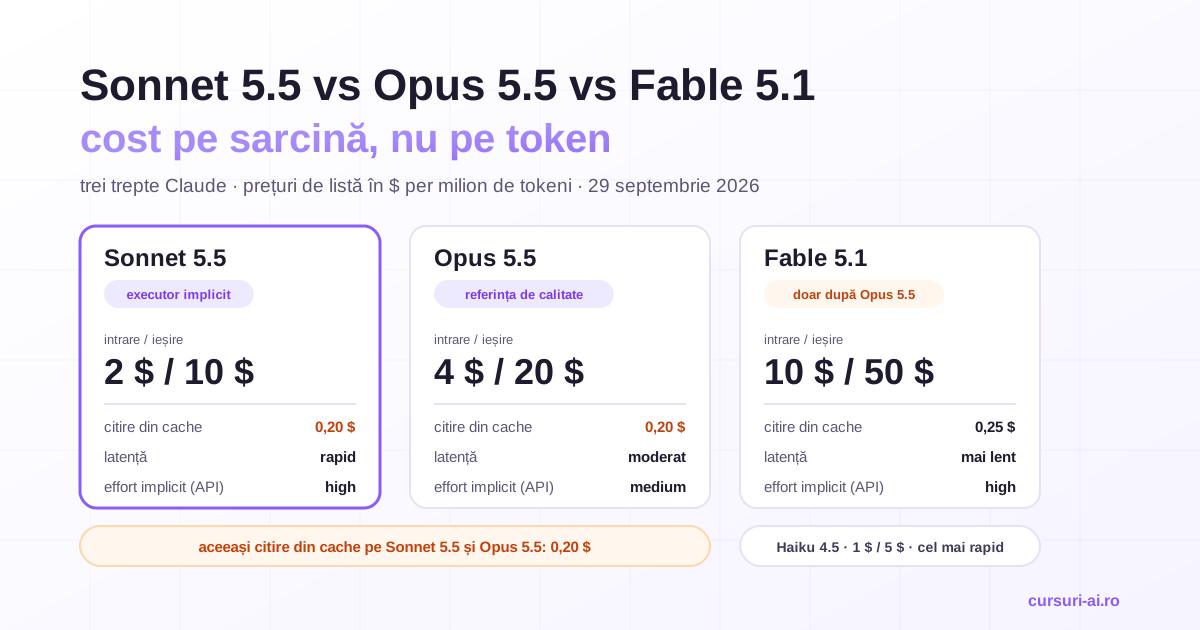
Tabelul comparativ din documentația Anthropic pune alături cele patru modele curente:
| Model | Descrierea oficială | Preț per milion de tokeni (intrare / ieșire) | Latență | Context | Răspuns maxim | Cunoștințe |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | raționament exigent și muncă agentică de lungă durată | 10 $ / 50 $ | mai lentă | 1M | 128K | iunie 2026 |
| Claude Opus 5.5 | coding agentic de lungă durată și muncă bazată pe cunoștințe | 4 $ / 20 $ | moderată | 1M | 128K | iunie 2026 |
| Claude Sonnet 5.5 | cea mai bună combinație de viteză și inteligență | 2 $ / 10 $ | rapidă | 1M | 128K | iunie 2026 |
| Claude Haiku 4.5 | cel mai rapid model, cu inteligență aproape de frontieră | 1 $ / 5 $ | cea mai rapidă | 200K | 64K | februarie 2025 |
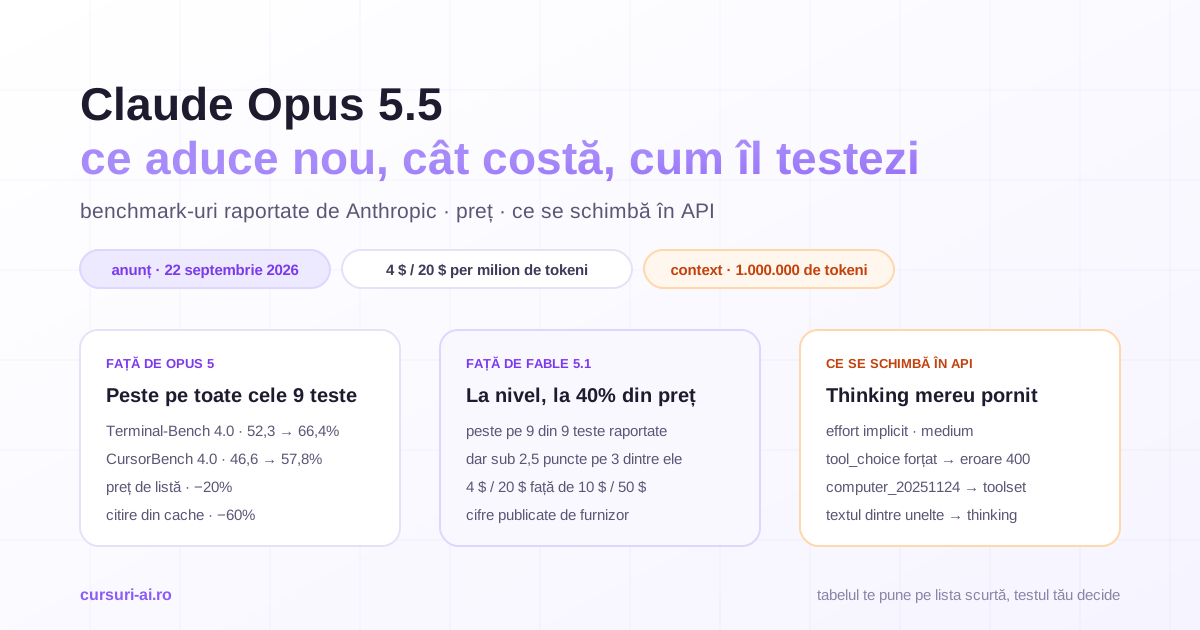
Recomandarea oficială de pornire nu este Sonnet: „dacă nu ești sigur ce model să folosești, începe cu Claude Opus 5.5 pentru majoritatea sarcinilor”, iar Fable 5.1 rămâne pentru raționament exigent sau pentru cazurile în care Opus 5.5 nu ajunge nici la effort mare. Sonnet 5.5 intră în joc când viteza și costul per sarcină contează mai mult decât ultimul procent de calitate. Ce a adus Opus 5.5 e explicat în analiza lansării Claude Opus 5.5, iar alegerea dintre cele două modele de vârf, în Claude Opus 5.5 vs Fable 5.1. La baza familiei, Anthropic anunță un Claude Haiku 5.5 „în săptămânile următoare”; până atunci, Haiku 4.5 rămâne activ, iar pagina de retrageri precizează că nu va fi retras mai devreme de 15 octombrie 2026.
Ce aduce nou față de Sonnet 5
Predecesorul, Claude Sonnet 5, a fost lansat pe 30 iunie 2026; trei luni mai târziu, Anthropic numește Sonnet 5.5 „un upgrade clar”. Toate cifrele de mai jos sunt raportate de Anthropic la lansare, nu sunt măsurători independente.
Viteză: peste 30% mai rapid la generare
Formularea exactă este că Sonnet 5.5 „generează răspunsurile cu peste 30% mai repede decât Sonnet 5”, ceea ce îl face „cel mai rapid model Sonnet de până acum”. E vorba de viteza cu care scrie răspunsul. Timpul total până la rezultat depinde și de cât gândește modelul înainte, deci de nivelul de effort pe care îl alegi.
Cost pe sarcină: același tarif, mai puțini tokeni
Prețul per token nu s-a schimbat. Economia promisă vine din altă parte: modelul „are nevoie, de regulă, de mult mai puțini tokeni pentru aceeași muncă”, iar „în testele noastre, costă cu până la 30% mai puțin pe sarcină decât predecesorul”. Pe mai multe teste, spune Anthropic, Sonnet 5.5 la effort Low sau Medium depășește cel mai bun scor al lui Sonnet 5 pentru aproximativ o zecime din costul per sarcină. „Până la” înseamnă plafon, nu medie. Pe factura ta, reducerea depinde de cât din cost vine din textul generat, cum arată exemplul de calcul din secțiunea despre preț.
Coding agentic
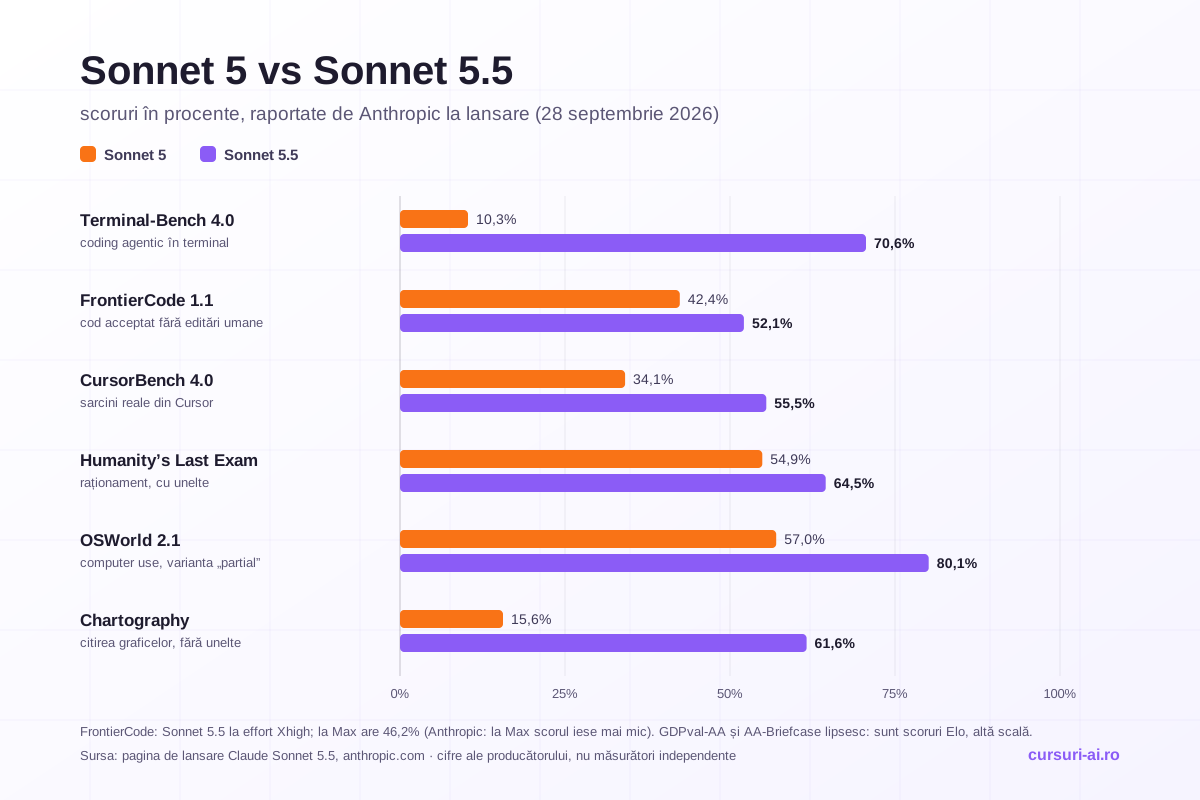
„Coding agentic” înseamnă că modelul nu doar sugerează cod, ci lucrează singur într-un proiect: citește fișiere, rulează comenzi, vede erorile și le corectează. Aici e cel mai mare salt. Pe Terminal-Bench 4.0, care măsoară cât de bine duce la capăt sarcini profesionale în mai mulți pași, într-un terminal, scorul urcă de la 10,3% la 70,6%. Pe CursorBench 4.0, construit din sarcini ambigue, pe mai multe fișiere, luate din sesiuni reale în editorul Cursor, urcă de la 34,1% la 55,5%, la aproximativ două puncte de Opus 5.5. Pe FrontierCode, care verifică dacă modificarea de cod ar fi acceptată fără editări umane, Anthropic spune că la effort High Sonnet 5.5 are cu 10 puncte peste Sonnet 5 la aceeași setare, pentru aproximativ o cincisprezecime din costul per sarcină.
Testerii timpurii citați de Anthropic au remarcat cât de repede înțelege modelul un proiect de cod și faptul că grupează apelurile de unelte mai des decât Sonnet 5, deci termină în mai puțini pași. Dacă scrii cod cu un agent din terminal, fluxul acesta, de la memoria de proiect la subagenți și integrarea în CI, e subiectul cursului Claude Code Mastery.
Documente, foi de calcul și prezentări
Pentru cine nu scrie cod, schimbarea relevantă e la munca de birou. Pe GDPval-AA, un test cu sarcini reale din 44 de ocupații și nouă industrii mari, Sonnet 5.5 are 1.844 de puncte Elo, față de 1.449 la Sonnet 5, și doar cu două puncte sub Opus 5.5. Pe AA-Briefcase, un test nou de muncă de birou pe termen lung, scorul crește de la 1.359 la 1.811.
Anthropic descrie și un test intern: pornind de la materialele trimestriale ale unei companii listate, transcrierile conferințelor cu investitorii și un șablon de prezentare, modelul a făcut o analiză operațională de 10 slide-uri, iar doi experți au considerat primul draft gata de trimis așa cum era. E un singur test, al producătorului: un indiciu, nu o garanție. Pe Chartography, citirea graficelor fără unelte ajutătoare, scorul trece de la 15,6% la 61,6%.
Computer use și sarcini lungi
„Computer use” înseamnă că modelul folosește un calculator aproape ca un om: vede capturi de ecran, mută cursorul, tastează. Pe OSWorld 2.1, scorul crește de la 57,0% la 80,1%. Anthropic adaugă un detaliu care spune ceva despre răbdarea pe sarcini lungi: Sonnet 5.5 este primul model Sonnet care termină jocul Pokémon Red lucrând doar din capturi de ecran.
Tabelul oficial: Sonnet 5 vs Sonnet 5.5
| Test (ce măsoară) · sursa: pagina de lansare Anthropic, 28 septembrie 2026 | Sonnet 5 | Sonnet 5.5 | Diferența |
|---|---|---|---|
| Terminal-Bench 4.0 (coding agentic în terminal) | 10,3% | 70,6% | +60,3 pp |
| FrontierCode 1.1, setul principal (cod care ar fi acceptat)¹ | 42,4% | 52,1% la Xhigh · 46,2% la Max | +9,7 pp · +3,8 pp |
| CursorBench 4.0 (sarcini din sesiuni reale în Cursor) | 34,1% | 55,5% | +21,4 pp |
| GDPval-AA v2.1 (muncă reală din 44 de ocupații, Elo)² | 1.449 | 1.844 | +395 |
| AA-Briefcase v1.1 (muncă de birou pe termen lung, Elo)² | 1.359 | 1.811 | +452 |
| Humanity's Last Exam (raționament multidisciplinar, cu unelte) | 54,9% | 64,5% | +9,6 pp |
| OSWorld 2.1 (computer use, varianta notată „partial”) | 57,0% | 80,1% | +23,1 pp |
| Chartography (citirea graficelor, fără unelte) | 15,6% | 61,6% | +46,0 pp |
Cum citești tabelul, pe scurt:
- Toate cifrele sunt ale producătorului, publicate la lansarea propriului model; testele și setările le-a ales Anthropic. „pp” înseamnă puncte procentuale.
- ¹ FrontierCode are două scoruri pentru Sonnet 5.5. La effort Xhigh, 52,1%; la Max, cel mai înalt nivel, doar 46,2%. Anthropic explică de ce: la Max, modelul a rulat mai des o verificare de cod împărțită între mulți subagenți, iar în două cazuri analizate asta a dus la depășirea timpului sau la modificări în afara sarcinii, pe care testul le penalizează, deci la un scor mai mic. Lecția practică: effort-ul maxim nu e automat cel mai bun.
- ² GDPval-AA și AA-Briefcase au fost rulate de Artificial Analysis, o firmă de evaluare independentă, pe o versiune de dinainte de lansare care avea o eroare la răspunsurile structurate, reparată între timp. Anthropic estimează că efectul, dacă există, e mic și subestimează modelul. Scorurile Elo sunt clasamente relative, deci diferența de puncte nu se citește ca procent.
- Opus 5.5 rămâne deasupra. Pe aceeași pagină, Opus 5.5 are scoruri mai mari pe toate rândurile în afară de Terminal-Bench 4.0, iar Anthropic scrie că, în testele proprii și ale testerilor externi, Opus 5.5 rămâne „clar mai puternic la munca complexă, deschisă, care cere judecată susținută”.
Cât costă Claude Sonnet 5.5
În aplicațiile Claude
Dacă folosești Claude în browser, pe telefon sau pe desktop, nu plătești per token, ci planul tău. Tokenii contează totuși: ghidul oficial de setări explică faptul că un effort mai mare aduce răspunsuri mai temeinice, dar acestea „durează mai mult și folosesc mai mulți tokeni, deci vei atinge mai repede limitele de utilizare”. Pentru întrebări simple și redactare obișnuită, setările implicite sunt suficiente.
Prin API
Tarifele de listă, din pagina de prețuri Anthropic, per milion de tokeni:
| Tip de token | Sonnet 5.5 | Sonnet 5 |
|---|---|---|
| Intrare (ce trimiți modelului) | 2 $ | 2 $ |
| Ieșire (ce scrie modelul, inclusiv gândirea) | 10 $ | 10 $ |
| Scriere în cache, valabilă 5 minute | 2,50 $ | 2,50 $ |
| Scriere în cache, valabilă 1 oră | 4 $ | 4 $ |
| Citire din cache | 0,20 $ | 0,20 $ |
| Batch API (intrare / ieșire) | 1 $ / 5 $ | 1 $ / 5 $ |
Patru lucruri merită știute înainte de primul calcul:
- Gândirea se plătește ca ieșire. Documentația despre gândirea adaptivă precizează că tokenii folosiți la gândire se facturează ca tokeni de ieșire, chiar dacă nu vezi tot textul lor. Un effort mai mare înseamnă, de regulă, o factură mai mare.
- Cache-ul păstrează temporar partea repetată a cererii (instrucțiunile, un document de referință), care e apoi recitită la 10% din prețul de intrare. La Sonnet 5.5, pragul minim pentru cache coboară la 512 tokeni, de la 1.024 la Sonnet 5.
- Batch API procesează cererile asincron, pentru lucrări care pot aștepta, cu 50% reducere la intrare și la ieșire.
- Contextul de 1M se facturează la același tarif per token pe toată lungimea: o cerere foarte lungă nu are suprataxă, dar costă proporțional cu lungimea ei.
Un exemplu de cost lunar, pe ipoteze declarate
Presupunem un asistent intern care citește tichetele de suport ale unei firme și propune un răspuns, apelat prin API:
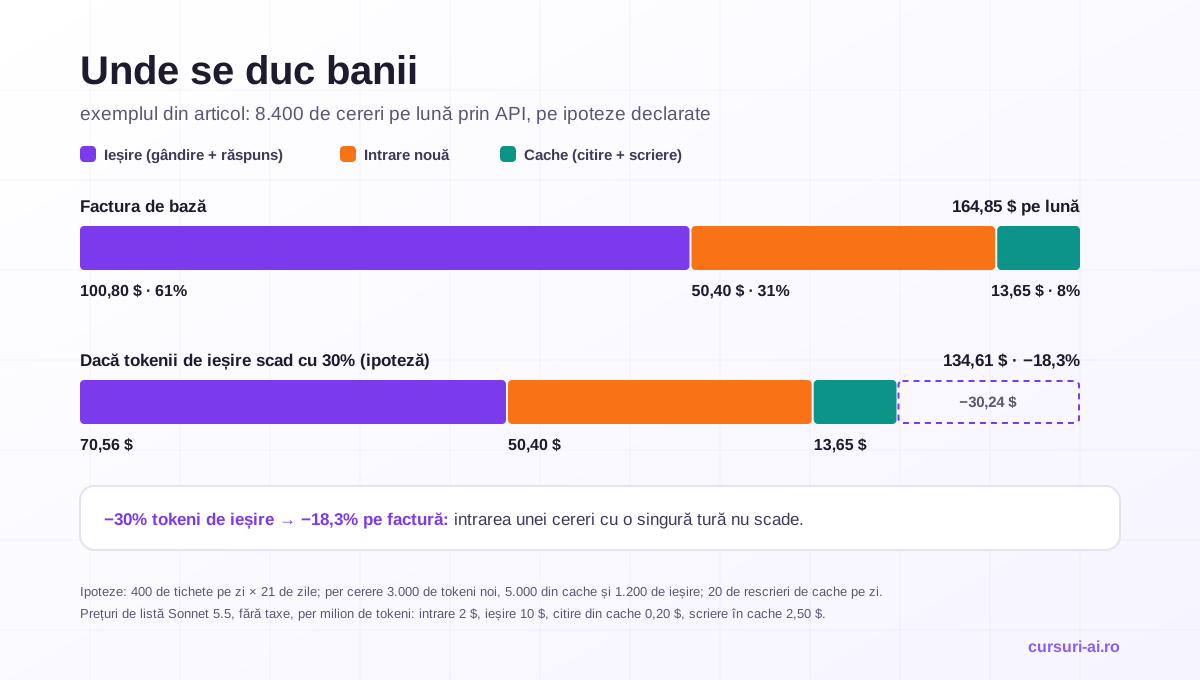
- 400 de tichete pe zi lucrătoare și 21 de zile lucrătoare pe lună, adică 8.400 de cereri;
- per cerere: 3.000 de tokeni noi de intrare (tichetul și istoricul clientului), 5.000 de tokeni de instrucțiuni și extrase din baza de cunoștințe, reciți din cache, și 1.200 de tokeni de ieșire (gândire plus răspuns);
- 20 de rescrieri ale cache-ului pe zi, după pauzele mai lungi de 5 minute, a câte 5.000 de tokeni.
| Componentă | Volum lunar | Tarif per milion | Cost |
|---|---|---|---|
| Intrare nouă | 25,2 milioane de tokeni | 2 $ | 50,40 $ |
| Citire din cache | 42 milioane de tokeni | 0,20 $ | 8,40 $ |
| Scriere în cache (5 minute) | 2,1 milioane de tokeni | 2,50 $ | 5,25 $ |
| Ieșire | 10,08 milioane de tokeni | 10 $ | 100,80 $ |
| Total pe lună | 164,85 $ |
Adică aproximativ 2 cenți pe tichet (0,0196 $). Tarifele fiind identice, tabelul descrie și costul pe Sonnet 5 la aceleași volume. Trei concluzii ies din calcul:
- Cache-ul contează. Fără el, cei 5.000 de tokeni repetați s-ar plăti la preț întreg: 235,20 $ pe lună, adică 70,35 $ în plus; altfel spus, cache-ul scade factura cu aproximativ 30%.
- Ieșirea înseamnă 61% din factură, deși are cei mai puțini tokeni, pentru că e de cinci ori mai scumpă per token decât intrarea. De aici vine economia promisă de Anthropic: mai puțini tokeni generați pentru același rezultat.
- „Până la 30%” pe sarcină nu înseamnă 30% pe factura ta. Să zicem că 164,85 $ e factura de azi pe Sonnet 5 și că Sonnet 5.5 generează, pe aceleași tichete, cu 30% mai puțini tokeni de ieșire (ipoteză, nu măsurătoare). Ieșirea scade de la 100,80 $ la 70,56 $, iar factura la 134,61 $: cu 18,3% mai puțin, nu cu 30%, pentru că intrarea unei cereri cu o singură tură rămâne aceeași. În sarcinile agentice cu multe ture, unde mai puțini pași înseamnă și mai puțin context recitit, câștigul poate fi mai mare. Singurul mod de a afla e să măsori.
Unde îl găsești
În aplicațiile Claude. Pagina oficială a modelelor Sonnet de pe anthropic.com spune că „oricine” poate conversa cu Claude folosind Sonnet 5.5 pe Claude.ai, pe web, iOS și Android. Articolul de ajutor Anthropic despre schimbarea automată a modelului enumeră toate produsele în care funcționează Sonnet 5.5: Claude pe web, aplicațiile mobile și desktop, Claude Cowork, Claude Code, Claude Design, Claude for Microsoft 365, Claude Tag și Claude Science. Modelul și nivelul de effort se aleg din meniul de lângă butonul de trimitere. Pe Sonnet 5.5, gândirea nu poate fi oprită din aplicații.
Prin API. Pentru toți clienții Claude API, cu identificatorul claude-sonnet-5-5.
Pe platformele cloud. Amazon Bedrock (anthropic.claude-sonnet-5-5), Claude Platform on AWS, Google Cloud și Microsoft Foundry (toate trei cu claude-sonnet-5-5). Pe Bedrock și Google Cloud facturează furnizorul de cloud, cu prețurile lui; pe Claude Platform on AWS și în Microsoft Foundry, plata trece prin marketplace-ul furnizorului, la tarifele standard Anthropic.
În alte unelte. GitHub a anunțat în aceeași zi că Sonnet 5.5 este disponibil în GitHub Copilot pentru planurile Pro, Pro+, Max, Business și Enterprise, cu lansare graduală.
Pentru firmele care lucrează cu date sensibile, Anthropic precizează că Sonnet 5.5, ca și Opus 5.5 și Sonnet 5, este disponibil cu zero data retention.
Ce s-a schimbat la siguranță
Pe scurt: pentru majoritatea utilizatorilor, nimic vizibil. Pentru câteva categorii înguste de cereri, da.
- Comportament. Pe auditul comportamental automat al Anthropic, cu aproximativ 1.850 de scenarii, Sonnet 5.5 e egal sau mai bun decât Sonnet 5 la majoritatea măsurătorilor de aliniere, rezistență la abuz și onestitate. Opus 5.5 rămâne ușor mai bun pe ansamblu.
- Securitate cibernetică. Capabilitățile cyber au crescut destul încât Sonnet 5.5 e primul Sonnet lansat cu protecții și treceri automate pe alt model (fallback), de tipul celor de pe modelele de vârf. Cererile ofensive cu risc mai mare, cum ar fi generarea de exploit-uri, scanarea de vulnerabilități în fișiere binare sau testele de penetrare, sunt rulate vizibil pe Sonnet 5. Scanarea codului sursă pentru vulnerabilități și dezvoltarea obișnuită rămân pe Sonnet 5.5.
- Biologie. Aceleași protecții ca la Sonnet 5: cererile care ar putea ajuta la vătămări biologice grave sunt blocate direct, fără trecere pe alt model.
- Dezvoltarea modelelor AI de vârf. Un set restrâns de cereri, de exemplu dezvoltarea de kerneluri pentru anumite acceleratoare de machine learning, trece pe Sonnet 5. Munca obișnuită de AI și ML nu ar trebui să fie afectată.
- Extragerea raționamentului. E primul Sonnet cu clasificatori care blochează cererile de a reproduce cuvânt cu cuvânt gândirea internă a modelului. Poți în continuare să îi ceri să-și explice raționamentul sau să întrebi „de ce ai făcut asta?”.
În practică, când o cerere e mutată, aplicația afișează un anunț, răspunsul e etichetat cu modelul care a răspuns, iar selectorul rămâne pe Sonnet 5 până la finalul conversației; poți reveni oricând sau poți opri comutarea automată din Settings > Capabilities. Verificările citesc tot ce citește modelul, inclusiv memoria, conectorii, rezultatele căutării și fișierele, deci o schimbare poate fi declanșată de un conținut pe care nu l-ai tastat tu. Prin API, trecerea pe alt model nu e automată: dezvoltatorul o activează explicit.
Pentru ce e bun și pentru ce alegi altceva
Sonnet 5.5 e alegerea potrivită pentru:
- sarcini zilnice bine delimitate: un e-mail dificil, un rezumat, o analiză pe un fișier, o întrebare pe un document lung;
- documente, prezentări și foi de calcul pe care vrei să le editezi cât mai puțin; pagina modelelor Sonnet spune că urmează șabloanele de slide-uri și că scrisul lui e „mai clar și mai direct”;
- dezvoltare de zi cu zi: funcționalități noi, bug-uri, code review; aceeași pagină notează că modelul înțelege repede un proiect, își delimitează modificările înainte să înceapă și le ține suficient de mici încât să poată fi verificate;
- volum mare, unde viteza și costul per sarcină contează;
- iterație rapidă, când revii des asupra aceluiași lucru.
Alegi alt model când:
- munca e complexă, deschisă și cere multă judecată: o arhitectură, o strategie, o analiză cu multe necunoscute. Recomandarea oficială e să pornești de la Opus 5.5, iar ghidul de prompting pentru Sonnet 5.5 spune explicit că, pentru cea mai grea muncă de lungă durată, „un model Opus e alegerea mai bună”;
- raționamentul e foarte exigent sau Opus 5.5 nu ajunge nici la effort mare: Fable 5.1;
- ai volume foarte mari de sarcini simple, precum clasificări sau extrageri scurte, și fiecare cent contează: Haiku 4.5 costă jumătate, iar Haiku 5.5 e anunțat;
- faci securitate ofensivă legitimă: cererile vor fi oricum mutate pe Sonnet 5, iar Anthropic anunță un program extins de verificare pentru specialiștii în apărare cibernetică.
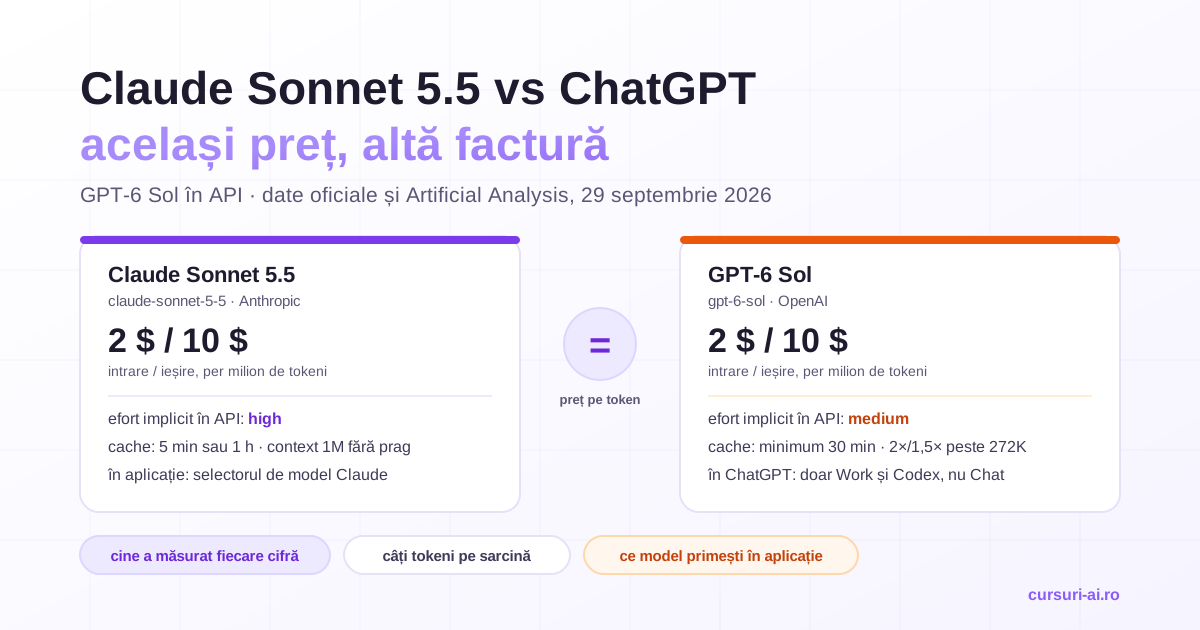
Alegerea detaliată dintre Sonnet 5.5, Opus 5.5 și Fable 5.1, cu costul pe sarcină și rutarea între ele, e în Sonnet 5.5 vs Opus 5.5 vs Fable 5.1: ce model alegi. Comparația cu GPT-6 Sol, modelul OpenAI cu același preț de listă, e în Claude Sonnet 5.5 vs ChatGPT.
Pentru developeri: cele cinci schimbări care rup codul
Dacă ai o aplicație care rulează pe Sonnet 5, schimbarea identificatorului nu ajunge. Pagina „What's new in Claude Sonnet 5.5” enumeră cinci schimbări care produc erori:
thinking: {"type": "disabled"}întoarce eroarea 400. Pentru a opri gândirea de dinaintea răspunsului trimiți{"type": "between_tools"}, acceptat doar la effort low, medium și high. Anunțul de lansare o scoate special în evidență: dacă rulezi Sonnet cu gândirea oprită, faci trecerea înainte de schimbarea modelului.- Apelul forțat de unelte nu mai e acceptat.
tool_choicecuanysautoolîntoarce 400. Rămâi peauto, custrict: truepentru date de intrare valide, sau treci pe structured outputs, și spui în prompt când trebuie folosită unealta. Ambele mecanisme, tool use și structured outputs, au module dedicate în cursul de aplicații AI cu Python și SDK-uri. - Blocurile de gândire sunt legate de model și de conversație. Sonnet 5.5 citește blocurile de la Sonnet 5, Opus 4.8, Haiku 4.5 și modelele mai vechi, dar nu de la Opus 5, Opus 5.5, Fable sau Mythos, iar niciun alt model nu le citește pe ale lui. Pe conturile create începând cu 31 august 2026, retrimiterea unui bloc după ce ai editat istoricul (promptul de sistem, uneltele, un mesaj anterior) dă 400, deci conversațiile se țin „append-only”.
- Unealta
computer_20251124e respinsă pe Claude API și Google Cloud; computer use merge doar princomputer_toolset_20260801. Pe Amazon Bedrock, vechea unealtă e acceptată în continuare. - Advisor tool: Opus 4.8, Opus 4.7 și Sonnet 5 nu mai sunt acceptați ca advisor pentru un executor Sonnet 5.5.
Alte trei schimbări nu produc erori, dar modifică ce vezi: textul scris între apelurile de unelte vine în blocuri de gândire, goale la setarea implicită, deci o interfață care îl afișa „amuțește”; nivelurile de effort sunt recalibrate, deci setarea de pe Sonnet 5 nu se transferă automat; refuzurile vin ca HTTP 200, cu stop_reason: "refusal" și o categorie în stop_details. Fișa modelului mai amintește că valorile nestandard pentru temperature, top_p sau top_k întorc 400. Pașii, cu cod înainte și după pentru fiecare caz, sunt în ghidul oficial de migrare. În Claude Code, comanda /claude-api migrate îți cere întâi să confirmi ce fișiere atinge, apoi schimbă identificatorul și parametrii care nu mai sunt acceptați și îți lasă o listă de verificat manual.
Cum îl încerci cu cap: testul de 30 de minute
Benchmark-urile îți spun că modelul merită un test, nu că merită pe munca ta. Pentru un test personal ai nevoie doar de sarcini reale și de un criteriu scris dinainte. Cinci sarcini potrivite:
| Sarcina de test | Ce verifici |
|---|---|
| Un e-mail dificil către un client, cu tot contextul lipit în mesaj | tonul, dacă a păstrat faptele, câte corecturi ai făcut |
| Un rezumat de o pagină dintr-un PDF de 30–40 de pagini, cu trimiteri la pagină | dacă fiecare afirmație se regăsește la pagina indicată |
| Curățarea unui export CSV și un tabel cu totaluri | dacă totalurile se potrivesc cu un calcul făcut de tine |
| O prezentare de 5 slide-uri pe șablonul firmei, dintr-un document existent | cât ai de modificat până o poți trimite |
| Pentru developeri: un bug mic, cu un test care pică, într-un proiect real | dacă testul trece și dacă modificarea rămâne în limitele cerute |
Checklistul, pe minute:
- Minutele 0–5: alegi 3–5 sarcini din săptămâna curentă și scrii pentru fiecare criteriul de reușită: da sau nu, nu „arată bine”.
- Minutele 5–20: rulezi fiecare sarcină, cu același prompt și aceleași fișiere, pe Sonnet 5.5 și pe modelul de azi, în conversații noi, la effort-ul implicit; dacă rezultatul nu e bun, repeți la High.
- Notezi timpul până la rezultat și numărul de corecturi.
- Minutele 20–30: verifici fiecare cifră și fiecare nume față de sursă. Ghidul de prompting al Anthropic notează că modelul răspunde uneori din cunoștințele de antrenament când o căutare ar prinde detalii schimbate, cum ar fi ce e permis, obligatoriu sau taxat.
- La cod, rulezi testele și cauți teste, documentație sau fișiere necerute: același ghid spune că modelul are această tendință, mai ales la effort mare.
- Prin API, notezi din
usagetokenii de intrare, din cache și de ieșire și calculezi costul per sarcină reușită, nu per încercare. - Decizi pe sarcini, nu pe model: Sonnet 5.5 unde a ieșit cel puțin la fel de bine și mai repede, modelul mai mare pentru restul.
Cinci sarcini sunt un filtru, nu o evaluare statistică. Metoda completă pentru o echipă, de la alegerea sarcinilor la ponderarea criteriilor și decizia de migrare, e parte din cursul Comparație Modele AI.
Întrebări frecvente
Ce este Claude Sonnet 5.5? Claude Sonnet 5.5 este modelul Anthropic lansat pe 28 septembrie 2026, al doilea din familia Claude 5.5, descris oficial drept „cea mai bună combinație de viteză și inteligență”. Are context de 1.000.000 de tokeni, cunoștințe până în iunie 2026 și gândire adaptivă, controlată prin nivelul de effort, și e gândit ca un complement mai rapid și mai ieftin al lui Opus 5.5, pentru sarcini zilnice bine delimitate.
Cât costă Claude Sonnet 5.5? Prin API, 2 $ per milion de tokeni de intrare și 10 $ per milion de tokeni de ieșire, exact ca Sonnet 5; citirea din cache costă 0,20 $, iar Batch API înjumătățește tarifele. Gândirea se plătește ca ieșire. În aplicațiile Claude plătești planul, nu tokenii, dar un effort mai mare consumă mai repede limitele de utilizare.
Care e diferența dintre Claude Sonnet 5.5 și Sonnet 5? Prețul e același; diferența e în viteză, eficiență și rezultate. Anthropic raportează generare cu peste 30% mai rapidă, cost pe sarcină cu până la 30% mai mic și scoruri mai mari pe toate testele publicate, cu cel mai mare salt la coding agentic (Terminal-Bench 4.0: de la 10,3% la 70,6%) și la citirea graficelor. Cunoștințele ajung până în iunie 2026, față de ianuarie 2026. În API apar cinci schimbări care rup codul existent.
Trebuie să trec imediat de pe Sonnet 5 pe Sonnet 5.5? Nu. Sonnet 5 rămâne activ, marcat în documentație ca model „legacy”, cu retragere nu mai devreme de 30 iunie 2027. Ghidul de prompting spune că prompturile scrise pentru Sonnet 5 ar trebui să funcționeze bine fără modificări, dar codul care oprește gândirea cu „disabled” sau forțează apelul unei unelte trebuie schimbat înainte. Testezi pe câteva sarcini reale, apoi migrezi.
De ce a răspuns Sonnet 5 deși am ales Sonnet 5.5? Pentru că o verificare de siguranță a mutat cererea pe Sonnet 5. Se întâmplă la un set restrâns de cereri de securitate cibernetică ofensivă și de dezvoltare a modelelor AI de vârf, iar verificarea citește și fișierele, memoria, conectorii și rezultatele căutării, nu doar mesajul tău. Aplicația afișează un anunț și etichetează răspunsul; poți reveni la Sonnet 5.5 din selector sau poți opri comutarea automată din Settings > Capabilities.
Concluzie
Claude Sonnet 5.5 nu schimbă prețul, schimbă ce primești pentru el: după cifrele Anthropic, scrie cu peste 30% mai repede decât Sonnet 5, ajunge la rezultat cu mai puțini tokeni și urcă pe toate testele publicate, cel mai mult la coding agentic, computer use și citirea graficelor. Pentru un utilizator obișnuit, e un model rapid pentru e-mailuri, rezumate, documente, prezentări și foi de calcul; pentru o echipă care plătește API-ul, e un cost pe sarcină care poate scădea, dar nu cu 30% din oficiu, pentru că într-o cerere cu o singură tură economia vine doar din tokenii generați.
Limitele: cifrele sunt ale producătorului, Opus 5.5 rămâne punctul de pornire recomandat oficial pentru munca complexă și deschisă, câteva categorii de cereri trec pe Sonnet 5, iar codul scris pentru Sonnet 5 are cinci puncte în care se rupe. O jumătate de oră de test pe sarcinile tale, cu criteriul scris dinainte, îți spune mai mult decât orice tabel.
Surse
- Anthropic, „Introducing Claude Sonnet 5.5” (pagina de lansare: benchmark-uri și notele lor, cost, viteză, siguranță, disponibilitate): https://www.anthropic.com/claude-sonnet-5-5
- Anthropic, pagina Claude Sonnet (disponibilitatea în Claude.ai, cazuri de utilizare): https://www.anthropic.com/claude/sonnet
- Claude Platform Docs, „Models overview” (tabelul comparativ, recomandarea de pornire, identificatorii pe platforme): https://platform.claude.com/docs/en/models/overview
- Claude Platform Docs, fișa Claude Sonnet 5.5 (specificații, retragere, parametri respinși): https://platform.claude.com/docs/en/models/sonnet-5-5/overview
- Claude Platform Docs, fișa Claude Sonnet 5 (cunoștințe, statut, retragere): https://platform.claude.com/docs/en/models/sonnet-5/overview
- Claude Platform Docs, „What's new in Claude Sonnet 5.5” (cele cinci schimbări, cache minim, disponibilitate): https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Platform Docs, „Migrating to Claude Sonnet 5.5” (ghidul de migrare): https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- Claude Platform Docs, „Prompting Claude Sonnet 5.5”: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-sonnet-5-5
- Claude Platform Docs, Pricing (tarife, cache, Batch, platforme cloud, context lung): https://platform.claude.com/docs/en/about-claude/pricing
- Claude Platform Docs, „Adaptive thinking” (facturarea gândirii ca ieșire): https://platform.claude.com/docs/en/build-with-claude/adaptive-thinking
- Claude Platform Docs, „Model deprecations” (datele de retragere): https://platform.claude.com/docs/en/about-claude/model-deprecations
- Claude Help Center, „Why Claude switched models in your conversation with Sonnet 5.5”: https://support.claude.com/en/articles/17161993-why-claude-switched-models-in-your-conversation-with-sonnet-5-5
- Claude Help Center, „Change the model, effort, and thinking settings”: https://support.claude.com/en/articles/8664678-change-the-model-effort-and-thinking-settings
- GitHub Changelog, „Claude Sonnet 5.5 in GitHub Copilot” (28 septembrie 2026): https://github.blog/changelog/2026-09-28-claude-sonnet-5-5-in-github-copilot/
Articol informativ, publicat la 29 septembrie 2026. Cifrele de benchmark, prețurile, specificațiile și citatele provin din pagina de lansare, din documentația și din centrul de ajutor Anthropic, consultate la 29 septembrie 2026; sunt raportate de furnizor și se pot schimba. Exemplul de cost folosește ipoteze declarate, nu datele unei firme reale, și prețuri de listă în dolari, fără taxe.

Cursul care continuă acest articol
Construire de Aplicații AI cu Python și SDK-uri (OpenAI, Anthropic): de la API la Produs
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente: de la API de LLM la mediul tău Python
- Primul apel: chat completions, mesaje și parametri
- Streaming și UX: răspunsuri în timp real
- Function calling / tool use: conectează modelul la codul tău
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.