Sonnet 5.5 vs Opus 5.5 pare, la prima vedere, o decizie de preț: de la 28 septembrie 2026, Claude Sonnet 5.5 costă 2 $ / 10 $ per milion de tokeni, jumătate din tariful lui Opus 5.5, și trece înaintea lui pe Terminal-Bench 4.0 în tabelul publicat de Anthropic. Numai că citirea din cache costă 0,20 $ pe amândouă, scorurile lui Sonnet 5.5 sunt raportate la effort max, iar valoarea implicită de effort pe API diferă (high față de medium). Întrebarea utilă nu e „care model e mai bun”, ci cât costă o sarcină rezolvată pe fiecare rută și după ce criteriu escaladezi spre Opus 5.5 sau Fable 5.1.
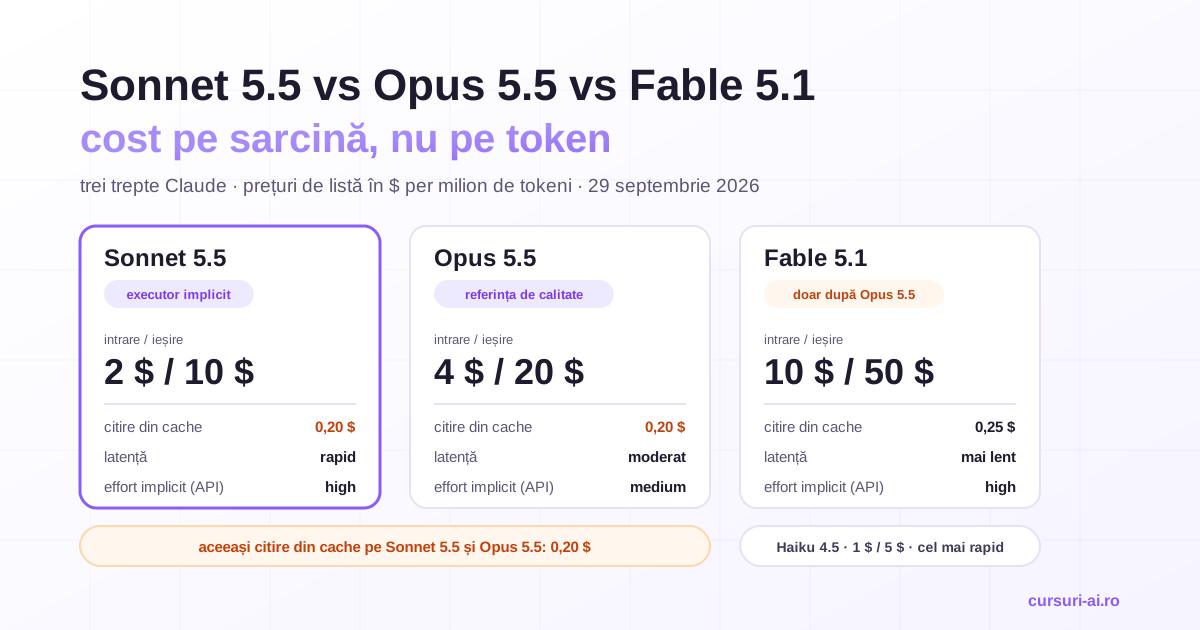
Scara Anthropic după lansarea lui Sonnet 5.5
Prezentarea modelelor din documentația Anthropic descrie patru trepte: Haiku 4.5, cel mai rapid; Sonnet 5.5, „cea mai bună combinație de viteză și inteligență”; Opus 5.5, pentru agentic coding de lungă durată și knowledge work; Fable 5.1, pentru raționament dificil și muncă agentică long-horizon. Regula de alegere a rămas aceeași după lansare: dacă nu știi ce model să folosești, pornești cu Opus 5.5, iar Fable 5.1 intră când evaluările tale pe Opus 5.5, la effort mai mare, tot nu ajung la prag.
Pagina de lansare a lui Sonnet 5.5 îl prezintă ca pe un complement mai rapid și mai ieftin al lui Opus 5.5, cel mai bun la sarcini bine delimitate, bug-uri și documente, și precizează că Opus 5.5 rămâne „clar mai puternic” la munca complexă și deschisă, care cere judecată susținută. Tradus în arhitectură: Opus 5.5 rămâne referința de calitate, iar Sonnet 5.5 devine executorul implicit pe rutele unde evaluările arată că ține pasul. E varianta „capability-first” din ghidul Anthropic de alegere a modelului: implementezi pe Opus 5.5, apoi cobori effort-ul sau modelul unde măsurătorile permit. Routerul care face asta în producție (reguli, clasificator, try-cheap-first, fallback, metrici de rutare) e tratat pe larg în Integrare Avansată LLM în Aplicații de Producție. Decizia de la treapta de sus are articolul ei, Claude Opus 5.5 vs Fable 5.1: când merită de 2,5 ori prețul; aici adăugăm treapta de dedesubt.
Dacă ai nevoie întâi de fișa de lansare pe scurt, o găsești în Claude Sonnet 5.5: ce este, ce aduce nou și cât costă. Comparația cu GPT-6 Sol, la același preț, e în Claude Sonnet 5.5 vs ChatGPT.
Tabelul celor trei trepte (plus Haiku 4.5)
Cifre din prezentarea modelelor și de pe pagina de prețuri, la 29 septembrie 2026, în dolari per milion de tokeni.
| Criteriu | Haiku 4.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| Intrare / ieșire | 1 $ / 5 $ | 2 $ / 10 $ | 4 $ / 20 $ | 10 $ / 50 $ |
| Citire din cache | 0,10 $ | 0,20 $ | 0,20 $ | 0,25 $ |
| Scriere în cache, 5 min / 1 h | 1,25 $ / 2 $ | 2,50 $ / 4 $ | 5 $ / 8 $ | 12,50 $ / 20 $ |
| Batch API, intrare / ieșire | 0,50 $ / 2,50 $ | 1 $ / 5 $ | 2 $ / 10 $ | 5 $ / 25 $ |
| Latență comparativă (eticheta Anthropic) | cel mai rapid | rapid | moderat | mai lent |
| Effort implicit pe API | fără parametru effort | high |
medium |
high |
| Thinking | extended, manual | adaptiv; cel inițial se poate opri | adaptiv, mereu pornit | adaptiv, mereu pornit |
| Context / ieșire maximă | 200K / 64K | 1M / 128K | 1M / 128K | 1M / 128K |
| Ieșire în Batch, cu header beta | — | până la 300K | până la 300K | — |
| Prompt minim pentru cache | 4.096 tokeni | 512 tokeni | 512 tokeni | 512 tokeni |
| Fast mode | nu | nu | 8 $ / 40 $, research preview | nu |
| Retragere, nu mai devreme de | 15 octombrie 2026 | 28 septembrie 2027 | 22 septembrie 2027 | 1 septembrie 2027 |
Patru lucruri din tabel schimbă calculul mai mult decât raportul de 2× din prima linie:
- Jumătate de preț, dar nu pe citirea din cache. Opus 5.5 are multiplicatorul redus de 5% din prețul de intrare, Sonnet 5.5 pe cel standard de 10%, deci 0,20 $ pe amândouă. Ghidul Anthropic de optimizare a costului notează că, în rulările măsurate de companie, citirile din cache sunt în mod curent cea mai mare componentă a costului pe sarcină.
- Implicitul de effort diferă. Fără
effort, Sonnet 5.5 rulează lahigh, Opus 5.5 lamedium; în Claude Code și în aplicațiile Claude, Sonnet 5.5 pornește la Medium. Documentația recomandă pe Sonnet 5.5mediumpentru agentic coding bine specificat,highpentru sarcini mai grele șimediumorilowpentru chat. - Dintre cele trei trepte, doar Sonnet 5.5 poate renunța la thinking-ul inițial, cu
thinking: {"type": "between_tools"}(lalow,medium,high);"disabled"întoarce 400. Pe Opus 5.5 și Fable 5.1, thinking-ul e mereu pornit. - Haiku 4.5 e o treaptă cu termen scurt: retragere „nu mai devreme de 15 octombrie 2026”, iar pagina de lansare a lui Sonnet 5.5 anunță Haiku 5.5 „în săptămânile următoare”. Are 200K de context, nu pune în cache prompturi sub 4.096 tokeni și folosește tokenizer-ul anterior: potrivit ghidului de migrare, același text produce pe Sonnet 5.5 cu aproximativ 30% mai mulți tokeni.
Benchmark-urile: unde Sonnet 5.5 depășește Opus 5.5 și unde rămâne în urmă
Tabelul de pe pagina de lansare are opt rânduri. System card-ul Sonnet 5.5 adaugă effort-ul fiecărei rulări, erorile standard și, pe mai multe teste, pe Fable 5.1 în aceeași configurație. Coloana Fable 5.1 conține doar cifre publicate de Anthropic pentru aceeași versiune a testului. Diferența Sonnet 5.5 minus Opus 5.5 e calculată de noi, în puncte procentuale (pp) sau Elo; SC înseamnă system card, iar „lansare”, pagina de lansare Sonnet 5.5.
| Benchmark | Sonnet 5.5 | Opus 5.5 | Diferență | Fable 5.1 | Sursă + effort |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 66,4% | +4,2 pp | 55,8% | lansare, SC §8.5; Sonnet și Fable max, Opus xhigh (64,8% la max); eroare standard ±2,5 / ±2,6 |
| Terminal-Bench-Science 0.1 | 59,9% | 58,7% | +1,2 pp | 52,6% | SC §8.6; max; eroare standard ±4,7 / ±4,8 |
| AutomationBench (Zapier) | 44,7% | 42,5% | +2,2 pp | — | SC §8.14.6; max; Opus reluat cu fallback (40,0% fără) |
| CursorBench 4.0 | 55,5% | 57,8% | −2,3 pp | 51,8% | lansare, SC §8.8 (Cursor); max; Sonnet: 53,1% xhigh, 47,8% high, 39,2% medium |
| FrontierCode v1.1 (Main) | 46,2% / 52,1% | 54,4% | −8,2 / −2,3 pp | 50,3% | lansare, SC §8.4 (Cognition); Sonnet max / xhigh; Fable: pagina Opus 5.5, effort nespecificat |
| SWE-Bench Pro | 81,3% | 89,9% | −8,6 pp | — | SC, tabelul 8.1.A; max |
| ProgramBench (context lung) | 79,7% | 91,2% | −11,5 pp | — | SC §8.10.1; până la 1M de tokeni; effort nespecificat |
| OSWorld 2.1, parțial / strict | 80,1% / 43,5% | 81,8% / 48,7% | −1,7 / −5,2 pp | 80,7% / — | SC §8.13.3; max; Fable: pagina Opus 5.5 |
| Humanity's Last Exam, cu / fără unelte | 64,5% / 56,9% | 67,7% / 64,4% | −3,2 / −7,5 pp | 65,6% / — | SC, tabelul 8.1.A; max; Fable: pagina Opus 5.5 |
| Chartography, fără / cu unelte | 61,6% / 90,2% | 64,4% / 89,0% | −2,8 / +1,2 pp | 44,8% / 88,4% | SC §8.13.1; max |
| GDPval-AA v2.1 (Elo) | 1.844 | 1.846 | −2 | 1.735 | SC §8.14.3 (Artificial Analysis); max; versiune pre-lansare |
| AA-Briefcase v1.1 (Elo) | 1.811 | 1.822 | −11 | 1.678 | SC §8.14.4 (Artificial Analysis); max; versiune pre-lansare |
Notele de metodologie schimbă lectura a patru rânduri:
- Terminal-Bench 4.0: Opus 5.5 e raportat la
xhigh, nivelul cu scorul lui cel mai mare. Cele 4,2 puncte înseamnă circa 1,2 erori standard combinate (calculul nostru), deci un avantaj de confirmat pe sarcinile tale. - FrontierCode: Sonnet 5.5 scade de la 52,1% la
xhighla 46,2% lamax. Anthropic explică: lamax, modelul rula mai des skill-ul de code review din Claude Code, care împarte review-ul pe mulți subagenți; în două cazuri examinate de Cognition, asta a dus la timeout sau la editări în afara sarcinii, pe care testul le penalizează. Effort-ul maxim nu e automat cel mai bun. - GDPval-AA și AA-Briefcase au rulat pe o versiune pre-lansare a lui Sonnet 5.5, cu un bug la structured outputs reparat între timp; Anthropic estimează un efect mic, care, dacă există, subestimează scorul.
- CursorBench la setările implicite: Sonnet 5.5 la
highare 47,8%, Opus 5.5 lamediumare 52,5%, potrivit paginii de lansare a lui Opus 5.5 (fișa lui completă e în articolul despre lansarea Opus 5.5). La setările cu care pornești de fapt, Opus 5.5 conduce cu 4,7 puncte.
Pentru rutare, tabelul spune trei lucruri. Sonnet 5.5 ține pasul sau conduce pe sarcini agentice în terminal, pe fluxuri de business cu unelte și pe munca de birou, dar rămâne clar în urmă pe context lung (−11,5), pe modificări mari în repository-uri reale (−8,6), pe raționament fără unelte (−7,5) și pe reușita strictă în computer use (−5,2). Consecvența crește pe scară: pe Toolathlon-Verified (system card §8.14.5), toate trei au 77,8% la Pass@1, dar Pass³, reușita în toate cele trei încercări, urcă de la 68,5% la 72,2% și 73,1%, iar Sonnet 5.5 face în medie 31,6 ture pe traiectorie, față de 26,9 (Opus 5.5) și 23,7 (Fable 5.1). Și, cum scrie chiar Anthropic, Sonnet 5.5 îl completează cel mai bine pe Opus 5.5 la effort mic, unde costă mai puțin pe sarcină; la setări mari poate avea performanțe comparabile, la un cost similar. O rută care cere Sonnet 5.5 la xhigh sau max ca să egaleze Opus 5.5 nu mai economisește nimic.
Unde intră Fable 5.1 în scară
Pe testele pentru care system card-ul publică toate trei modelele în aceeași configurație (Terminal-Bench 4.0, Terminal-Bench-Science, FrontierSWE v2, ArXivMath, Chartography, BenchCAD, GDPval-AA, AA-Briefcase), Fable 5.1 are scoruri mai mici decât Sonnet 5.5; excepția e consecvența pe Toolathlon (Pass³ 73,1% față de 68,5%). Pe rândurile unde cifra lui Fable 5.1 vine de pe pagina Opus 5.5 (Humanity's Last Exam cu unelte, OSWorld parțial, FrontierCode față de Sonnet la max), Fable 5.1 e peste, cu 0,6–4,1 puncte, dar fără o configurație comună publicată.
Asta nu scoate Fable 5.1 din scară: Anthropic avertizează, pe pagina Opus 5.5, că la aceste niveluri marjele de benchmark au devenit un ghid mai puțin fiabil, iar regula oficială îl plasează după Opus 5.5, nu după Sonnet 5.5. Pașii sunt Sonnet 5.5, Opus 5.5 cu effort crescut, apoi Fable 5.1, de cinci ori mai scump decât Sonnet 5.5 pe intrare și ieșire. Bucla corectă pentru un agent care rulează ore pe Fable 5.1 e în Agenți care rulează ore: bucla corectă pe Claude Fable 5.1.
Costul pe sarcină, nu pe token: trei calcule
Ghidul de optimizare cere compararea modelelor pe cost per sarcină rezolvată, nu per token, și testarea pe cea mai grea zecime a sarcinilor: o sarcină ratată își facturează tokenii, apoi reîncercarea. Exemplul lui e pe predecesor: pe un subset SWE-bench Pro, Fable 5.1 la low a rezolvat 88,6% din sarcini la 0,54 $ per sarcină rezolvată, față de 77,4% la 0,84 $ pentru Sonnet 5, deși costa per token de cinci ori mai mult. Pagina nu are încă date pentru Sonnet 5.5, așa că mai jos calculăm cu tarifele de listă și cu ipoteze declarate, de înlocuit cu valorile tale din usage.
Calculul 1: un bug rezolvat de un agent de cod
Presupunem un bug bine delimitat, cu teste. Opus 5.5 la medium face 25 de ture; Sonnet 5.5 la medium face 30, ipoteză apropiată de diferența de ture din Toolathlon; Fable 5.1 la high face 25, ipoteză favorabilă lui. Pe tură: 60.000 de tokeni recitiți din cache, 3.000 de tokeni noi scriși în cache-ul de 5 minute, 1.200 de tokeni de ieșire cu tot cu thinking. Ratele de reușită sunt ipotetice.
| Componentă per încercare | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| Citire din cache | 0,360 $ | 0,300 $ | 0,375 $ |
| Scriere în cache (5 min) | 0,225 $ | 0,375 $ | 0,938 $ |
| Ieșire | 0,360 $ | 0,600 $ | 1,500 $ |
| Total per încercare | 0,945 $ | 1,275 $ | 2,813 $ |
| Rată de reușită (ipoteză) | 78% | 86% | 87% |
| Cost per bug rezolvat | 1,21 $ | 1,48 $ | 3,23 $ |
Per încercare, Sonnet 5.5 e cu 26% mai ieftin, nu cu 50%: citirea din cache are același preț și, cu turele în plus, ajunge la 38% din factura lui. Per bug rezolvat, avantajul scade la 18%. Pragul de rentabilitate: dacă Sonnet 5.5 rezolvă sub 64% din bug-uri acolo unde Opus 5.5 rezolvă 86%, Opus 5.5 devine mai ieftin per bug rezolvat, iar timpul de review al încercărilor ratate, neinclus aici, ridică pragul.
Calculul 2: 500 de rapoarte lunare din documente, prin Batch
Presupunem 500 de rapoarte pe lună, fiecare din 150.000 de tokeni de documente noi, fără conținut refolosit, procesate prin Batch API. Ieșirea cu thinking: 10.000 de tokeni pe Opus 5.5 la medium, 14.000 pe Sonnet 5.5 la high, implicitul lui, și 14.000 pe Fable 5.1 la high.
| Componentă per raport | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| Intrare, 150.000 de tokeni | 0,15 $ | 0,30 $ | 0,75 $ |
| Ieșire | 0,07 $ | 0,10 $ | 0,35 $ |
| Total per raport | 0,22 $ | 0,40 $ | 1,10 $ |
| Total lunar | 110 $ | 200 $ | 550 $ |
Aici reducerea e aproape întreagă (Sonnet 5.5 costă 55% din Opus 5.5), pentru că domină intrarea necache-uită. Politica de escaladare contează mai mult decât alegerea unică: totul pe Sonnet 5.5, iar rapoartele respinse la verificare (presupunem 10%) refăcute pe Opus 5.5, costă 110 $ + 50 × 0,40 $ = 130 $, cu 35% sub „totul pe Opus 5.5”, și rămâne mai ieftin până la o rată de respingere de 45%. Condiția, aceeași ca în ghidul Anthropic pentru reluarea eșecurilor: un semnal de eșec de încredere.
Calculul 3: asistent de suport cu baza de cunoștințe în cache
Presupunem un prefix de 80.000 de tokeni ținut cald de trafic (scrieri amortizate spre zero), 300 de tokeni noi și un răspuns de 500 de tokeni pe cerere, 20.000 de cereri pe zi. Pe Haiku 4.5, același text are cu aproximativ 23% mai puțini tokeni, pentru că Sonnet 5.5 produce cu circa 30% mai mulți.
| Componentă per cerere | Haiku 4.5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Citire din cache | 0,0062 $ | 0,0160 $ | 0,0160 $ |
| Intrare nouă | 0,0002 $ | 0,0006 $ | 0,0012 $ |
| Ieșire | 0,0019 $ | 0,0050 $ | 0,0100 $ |
| Total per cerere | 0,0083 $ | 0,0216 $ | 0,0272 $ |
| Total pe zi | 166 $ | 432 $ | 544 $ |
Sonnet 5.5 e cu doar 21% mai ieftin decât Opus 5.5: 74% din factura lui e citire din cache, la același preț. Aici, argumentele pentru Sonnet 5.5 sunt latența și pârghiile de viteză (between_tools, effort low), iar pârghia de cost e dimensiunea prefixului. Haiku 4.5 costă 38% din Sonnet 5.5, cu termenul de retragere de mai sus. Pe cele trei rute, „jumătate de preț” a fost adevărat doar unde domină tokenii necache-uiți.
Arhitectura cu rutare: Sonnet 5.5 implicit, escaladare pe criterii măsurabile
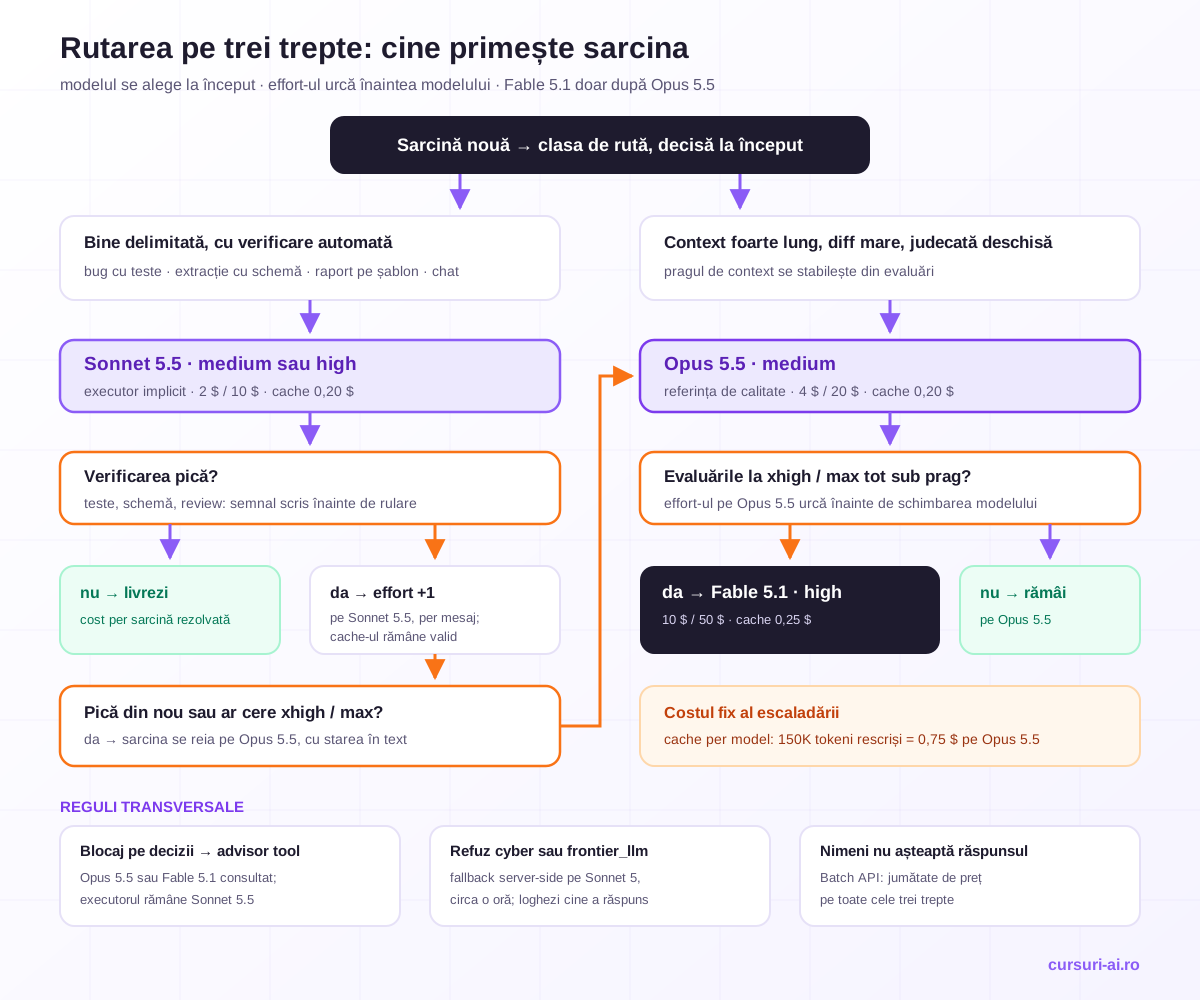
Patru reguli separă un router care economisește de unul care doar mută costul. Implementarea lor în cod (clasificatorul de rută, scorul de complexitate, try-cheap-first, metricile de acuratețe) urmează tiparele din modulul de orchestrare multi-model al cursului Integrare Avansată LLM în Aplicații de Producție.
1. Modelul se alege la începutul sarcinii, pe clasa de rută. Sarcinile bine delimitate, cu verificare automată (bug cu teste, extracție cu schemă, raport pe șablon, chat pe bază de cunoștințe), pornesc pe Sonnet 5.5. Contextul foarte lung, modificările mari în repository și deciziile de arhitectură pornesc pe Opus 5.5 la medium: acolo sunt cele mai mari diferențe din tabel. Pragul de context îl fixezi din evaluări.
2. Prima escaladare e effort-ul, pe același model. Sonnet 5.5 acceptă effort per mesaj (beta, header mid-conversation-output-config-2026-07-01), care păstrează cache-ul; schimbarea effort-ului la nivelul cererii îl invalidează. Cu between_tools, effort-ul nu se poate schimba pe parcurs.
3. A doua escaladare e modelul, cu un cost fix. Documentația Anthropic despre fallback credit o spune direct: cache-urile de prompt sunt per model. Un prefix de 150.000 de tokeni mutat de pe Sonnet 5.5 pe Opus 5.5 se scrie din nou în cache: 0,75 $, cât 25 de citiri ale lui pe Sonnet 5.5 (0,03 $ fiecare); pe Fable 5.1, 1,875 $.
4. Criteriile se scriu înainte de rulare.
| Semnal măsurabil | Acțiune |
|---|---|
| Verificarea pică (teste, schemă, review) | reîncercare pe Sonnet 5.5 cu effort mai mare |
Pică din nou sau ruta ar cere xhigh / max pe Sonnet 5.5 |
sarcina se reia pe Opus 5.5 medium, cu starea scrisă explicit |
| Contextul depășește pragul stabilit din evaluări | rutare directă pe Opus 5.5 |
| Executorul se blochează pe decizii, nu pe volum | advisor tool |
Refuz cyber sau frontier_llm |
fallback pe Sonnet 5 (dacă e configurat), marcat în log |
Opus 5.5 la xhigh / max tot sub prag |
Fable 5.1 la high |
| Nimeni nu așteaptă răspunsul | Batch API, la jumătate de preț |
Advisor tool: judecata lui Opus 5.5 fără să schimbi executorul
Advisor tool (beta, header advisor-tool-2026-03-01) lasă un executor mai ieftin să consulte, în aceeași cerere, un model mai capabil, care citește tot transcriptul și trimite un plan sau o corecție. Conform paginii What's new in Claude Sonnet 5.5, un executor Sonnet 5.5 acceptă ca advisor Opus 5.5, Opus 5, Fable 5.1, Fable 5, Mythos 5.1, Mythos 5 (ultimele două, cu disponibilitate limitată) sau Sonnet 5.5. Opus 4.8, Opus 4.7 și Sonnet 5, acceptați lângă un executor Sonnet 5, întorc 400. Toți advisorii acceptați returnează sfatul criptat (advisor_redacted_result), deci textul lui nu poate fi citit sau logat.
Din documentația advisor tool: thinking-ul advisorului e eliminat și doar sfatul ajunge la executor, deci conversația rămâne pe Sonnet 5.5, fără capcana din secțiunea următoare; consultările se facturează la tariful advisorului și apar doar în usage.iterations; un sfat are de obicei 1.400–1.800 de tokeni cu tot cu thinking; funcția merge pe Claude API și Claude Platform on AWS, nu pe Amazon Bedrock, Google Cloud sau Microsoft Foundry. Calculat de noi: o consultare a lui Opus 5.5 pe un transcript necache-uit de 100.000 de tokeni, cu 1.600 de tokeni de ieșire, costă circa 0,43 $; pe Fable 5.1, circa 1,08 $.
Ghidul de optimizare pune două condiții: o diferență reală de capabilitate și o rată reală de consultare, pentru că un executor la effort mic poate înceta să observe că s-a blocat. Reperul de bătut e modelul advisor rulat singur la low. Arhitectura inversă, un orchestrator mare cu workeri ieftini, a economisit bani, în măsurătorile aceluiași ghid, doar pe munca de rutină cu o coadă de sarcini foarte scumpe și pe volume care nu încap într-o fereastră de context. În Claude Code, delegarea către subagenți e tratată în Claude Code Mastery.
Capcana blocurilor de thinking la rutarea în mijlocul conversației
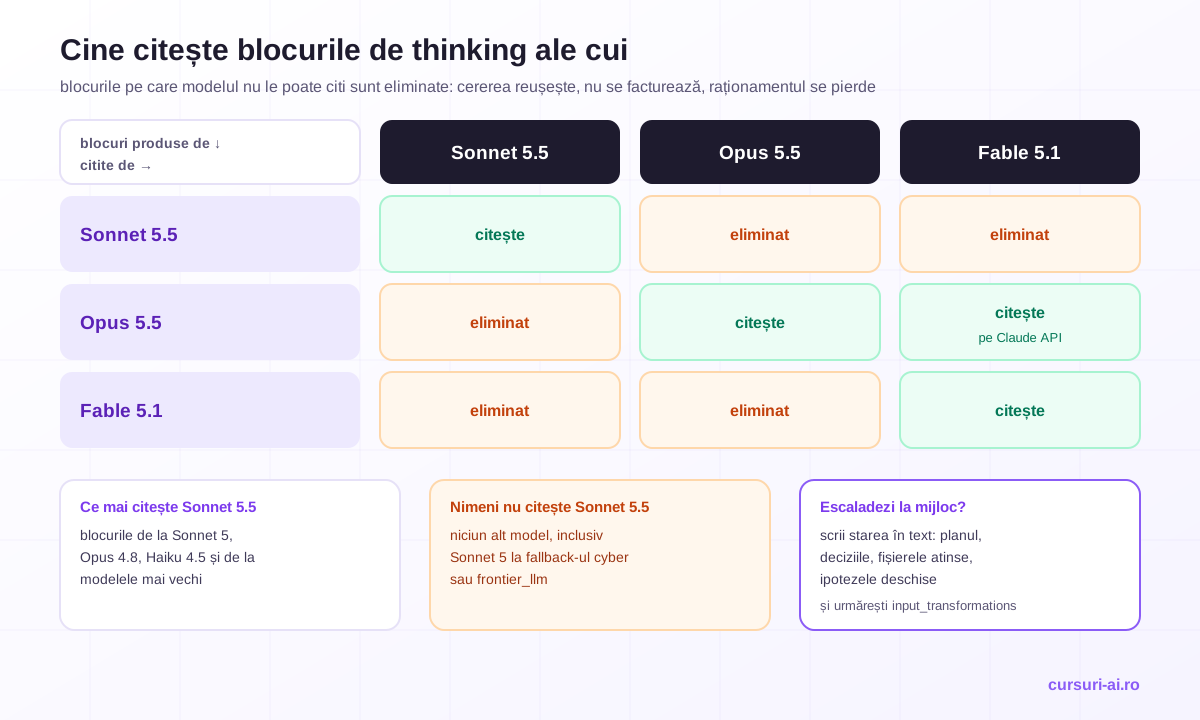
Conform paginii What's new, Sonnet 5.5 citește blocurile de la Sonnet 5, Opus 4.8, Haiku 4.5 și modelele mai vechi, dar nu pe cele de la Opus 5, Opus 5.5, Fable sau Mythos, iar niciun alt model nu citește blocurile lui Sonnet 5.5. O conversație mutată de pe Opus 5.5 pe Fable 5.1 își păstrează raționamentul pe Claude API; între Sonnet 5.5 și Opus 5.5, legătura e ruptă în ambele sensuri.
- Escaladare Sonnet 5.5 → Opus 5.5 la tura 20: Opus 5.5 continuă fără raționamentul acumulat. API-ul elimină blocurile pe care modelul nu le poate citi, cererea reușește, blocurile eliminate nu se facturează, iar eliminarea e tăcută fără header-ul beta
thinking-binding-controls-2026-08-01, care o raportează îninput_transformations. - Revenire pe Sonnet 5.5 sau fallback pe Sonnet 5: modelul care preia nu citește raționamentul celui de dinainte.
- Blocuri legate de cont: cele ale lui Sonnet 5.5 funcționează doar în contul care le-a produs sau într-unul legat de el.
- Istoric editat: pe conturile create începând cu 31 august 2026, retrimiterea unui bloc Sonnet 5.5 după o modificare a promptului de sistem, a uneltelor sau a unui mesaj anterior întoarce 400. Routerele care taie sau rescriu istoricul se rup; instrucțiunile noi se trimit ca mesaje de sistem în mijlocul conversației.
Soluția: decizi modelul la începutul sarcinii; când escaladezi totuși, scrii starea în text (planul, deciziile, fișierele atinse, ipotezele deschise), pentru că textul e citit de orice model; și trimiți mereu istoricul complet, lăsând API-ul să elimine ce nu poate citi modelul curent, cum recomandă documentația despre preserved thinking. Pentru ajutor punctual, advisorul nu rupe nimic.
Fallback-ul de siguranță: cererile de securitate cad pe Sonnet 5
Capabilitățile cyber ale lui Sonnet 5.5 sunt comparabile cu ale lui Opus 5, așa că, potrivit paginii de lansare, e primul Sonnet cu safeguard-uri cyber și fallback-uri de tipul celor de pe modelele de vârf: repararea bug-urilor obișnuite nu e afectată, dar sarcinile de securitate cu risc mai mare cad vizibil pe Sonnet 5. Mecanica, din What's new și din documentația despre refuzuri:
- Un refuz vine ca HTTP 200 cu
stop_reason: "refusal"șistop_detailsîntr-una din cinci categorii:cyber,bio,frontier_llm,reasoning_extraction,general_harms. - Fallback-ul server-side (
fallbacks: "default", headerserver-side-fallback-2026-07-01, beta, doar pe Claude API, nu și în Batch) reîncearcă pe Sonnet 5 doarcyberșifrontier_llm; celelalte trei rămân în grija aplicației. - După un fallback, cererile următoare din aceeași conversație merg direct la modelul de fallback timp de aproximativ o oră (sticky routing).
- Un refuz dinaintea oricărei ieșiri se facturează la
bio,frontier_llmșireasoning_extractionși intră oricum în rate limit.
Două consecințe pentru rutare. Treapta de fallback diferă după modelul principal: la Opus 5.5, pagina lui de lansare spune că majoritatea sarcinilor de securitate cibernetică sunt redirecționate spre Opus 4.8, pe când la Sonnet 5.5 ajung la Sonnet 5. Iar o evaluare a lui Sonnet 5.5 pe o rută cu mult cod de securitate măsoară parțial Sonnet 5, dacă nu loghezi modelul care a răspuns și categoria refuzului.
Protocolul scurt de testare pe sarcinile tale
- Setul: 40–60 de sarcini din loguri, ponderate ca traficul real, fiecare cu verificarea scrisă dinainte (teste, schemă, rubrică), inclusiv cea mai grea zecime.
- Rulările: Sonnet 5.5 la
mediumșihigh, Opus 5.5 lamedium, fiecare nivel în sesiune separată, cu effort explicit; Sonnet 5.5 laxhighdoar pe categoriile care pică lahigh. - Ce notezi: reușit sau ratat; cele cinci câmpuri de tokeni din
usage(intrare necache-uită, scriere în cache de 5 minute și de o oră, citire din cache, ieșire), fiecare la tariful lui; latența; refuzurile, cu categoria și modelul care a răspuns. - Decizia: cost per sarcină rezolvată pe rută și pragul de rentabilitate din calculul 1, după o regulă scrisă înainte de rezultate, de exemplu: cel mai ieftin model și nivel care atinge pragul; dacă Sonnet 5.5 îl atinge doar la
xhigh, ruta rămâne pe Opus 5.5. - Producția: configurația câștigătoare rulează întâi în umbră, pe o felie de trafic; setul rămâne în CI și se reia la fiecare model nou, începând cu Haiku 5.5.
Golden dataset-ul, rubricile, judecătorul LLM calibrat și intervalele de încredere care separă o diferență reală de zgomot sunt materia cursului AI Evals pentru LLM-uri în producție.
Checklist de migrare și rutare
- ID
claude-sonnet-5-5(pe Amazon Bedrock,anthropic.claude-sonnet-5-5). -
thinking: {"type": "disabled"}înlocuit cubetween_tools, doar până lahigh. -
tool_choiceanysautoolînlocuit cuautoplusstrict: truepe unelte. - Effort explicit pe fiecare rută, după un sweep nou;
max_tokensla 128.000 cu streaming pentru agentic coding, cum recomandă documentația despre effort. - Istoric append-only; routerul decide modelul la începutul sarcinii, iar escaladarea la mijloc trimite starea în text;
input_transformationsurmărit în log. - Advisor: doar perechi acceptate,
max_usessetat, consultările numărate dinusage.iterations. - Refuzuri: handler pentru
stop_reason: "refusal", fallback configurat, modelul care a răspuns salvat; tratare separată în Batch. - Computer use pe Claude API și Google Cloud mutat pe
computer_toolset_20260801. - Interfețele care afișau textul dintre apelurile de unelte au
displaysetat: textul vine acum în blocurithinking. - Bugetul de escaladare include o scriere completă a prefixului în cache-ul noului model.
- Rutele pe Haiku 4.5 au un plan de migrare.
Întrebări frecvente
Este Claude Sonnet 5.5 mai bun decât Opus 5.5?
Nu în general. Sonnet 5.5 conduce pe Terminal-Bench 4.0 (70,6% față de 66,4%) și e la 2 puncte Elo pe GDPval-AA, dar rămâne clar în urmă pe context lung, SWE-Bench Pro și raționament fără unelte, cu toate scorurile la effort max. Anthropic scrie că Opus 5.5 rămâne clar mai puternic la munca complexă și deschisă.
Cât costă Sonnet 5.5 față de Opus 5.5 pe o sarcină? Pe token, jumătate (2 $ / 10 $ față de 4 $ / 20 $ per milion), dar citirea din cache costă 0,20 $ pe amândouă. În calculele noastre ipotetice, reducerea a fost de 45% pe un batch de documente, 18% per bug rezolvat și 21% pe un chat cu bază de cunoștințe în cache.
Pot schimba modelul între Sonnet 5.5 și Opus 5.5 în mijlocul conversației? Poți, dar pierzi raționamentul: niciunul nu citește blocurile de thinking ale celuilalt, iar prefixul se scrie din nou în cache-ul noului model. Alegi modelul la începutul sarcinii, iar când escaladezi, trimiți starea în text.
Ce advisor pot folosi cu un executor Sonnet 5.5? Opus 5.5, Opus 5, Fable 5.1, Fable 5, Mythos 5.1, Mythos 5 sau Sonnet 5.5; Opus 4.8, Opus 4.7 și Sonnet 5 întorc eroare 400. Sfatul vine criptat, iar funcția e în beta, pe Claude API și Claude Platform on AWS.
Când are sens Fable 5.1 dacă am trecut pe Sonnet 5.5? Doar după Opus 5.5: regula oficială îl rezervă pentru raționament dificil, muncă agentică long-horizon sau evaluări pe Opus 5.5 care pică și la effort mai mare. Pe testele publicate în aceeași configurație, Fable 5.1 are scoruri sub Sonnet 5.5, deci saltul direct nu are un argument documentat.
Concluzie
Sonnet 5.5 schimbă economia gamei Anthropic fără să schimbe regula de sus: Opus 5.5 rămâne referința de calitate, iar Sonnet 5.5 devine executorul implicit unde evaluările tale arată că ține pasul la medium sau high. Benchmark-urile îl pun înaintea lui Opus 5.5 pe sarcini agentice în terminal, dar cu scorurile la max și cu decalaje reale pe context lung și pe modificări mari de cod. „Jumătate de preț” rezistă doar unde domină tokenii necache-uiți; cu cache, reducerea coboară la 18–26% în calculele noastre. Arhitectura care rezultă: rutare pe clasa de sarcină la început, escaladare întâi prin effort, apoi prin model, cu starea transmisă în text, advisor pentru blocajele de decizie și Fable 5.1 doar după Opus 5.5. Fallback-ul pe Sonnet 5 și blocurile de thinking pierdute la schimbarea modelului sunt detaliile care, nemăsurate, strică și evaluarea, și factura.
Surse
- Anthropic, Introducing Claude Sonnet 5.5 (28 septembrie 2026): https://www.anthropic.com/claude-sonnet-5-5
- Anthropic, Claude Sonnet 5.5 System Card (tabelul 8.1.A, secțiunile 8.4–8.14): https://www.anthropic.com/claude-sonnet-5-5-system-card
- Anthropic, Introducing Claude Opus 5.5 (22 septembrie 2026): https://www.anthropic.com/claude-opus-5-5
- Anthropic Docs, Models overview: https://platform.claude.com/docs/en/models/overview
- Anthropic Docs, Pricing: https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic Docs, What's new in Claude Sonnet 5.5: https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Anthropic Docs, Migrating to Claude Sonnet 5.5: https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- Anthropic Docs, Choosing the right model: https://platform.claude.com/docs/en/about-claude/models/choosing-a-model
- Anthropic Docs, Optimizing for cost and intelligence: https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
- Anthropic Docs, Advisor tool: https://platform.claude.com/docs/en/agents-and-tools/tool-use/advisor-tool
- Anthropic Docs, Effort: https://platform.claude.com/docs/en/build-with-claude/effort
- Anthropic Docs, Preserved thinking: https://platform.claude.com/docs/en/build-with-claude/preserved-thinking
- Anthropic Docs, Refusals and fallback: https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- Anthropic Docs, Fallback credit: https://platform.claude.com/docs/en/build-with-claude/fallback-credit
- Anthropic Docs, Prompt caching: https://platform.claude.com/docs/en/build-with-claude/prompt-caching
Articol informativ, publicat la 29 septembrie 2026. Prețurile, specificațiile, benchmark-urile și citatele provin din documentația Anthropic, din paginile de lansare ale lui Sonnet 5.5 și Opus 5.5 și din system card-ul Sonnet 5.5, consultate la aceeași dată; diferențele de scor sunt calculate de noi. Calculele de cost folosesc tarifele de listă și ipoteze declarate, nu măsurători. Conținutul are caracter educativ și nu constituie consultanță financiară.

Cursul care continuă acest articol
Integrare Avansată LLM în Aplicații de Producție
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Integrării LLM în 2026
- Streaming și Error Handling
- Function Calling și Tool Use
- Model Context Protocol (MCP)
+ încă 5 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.