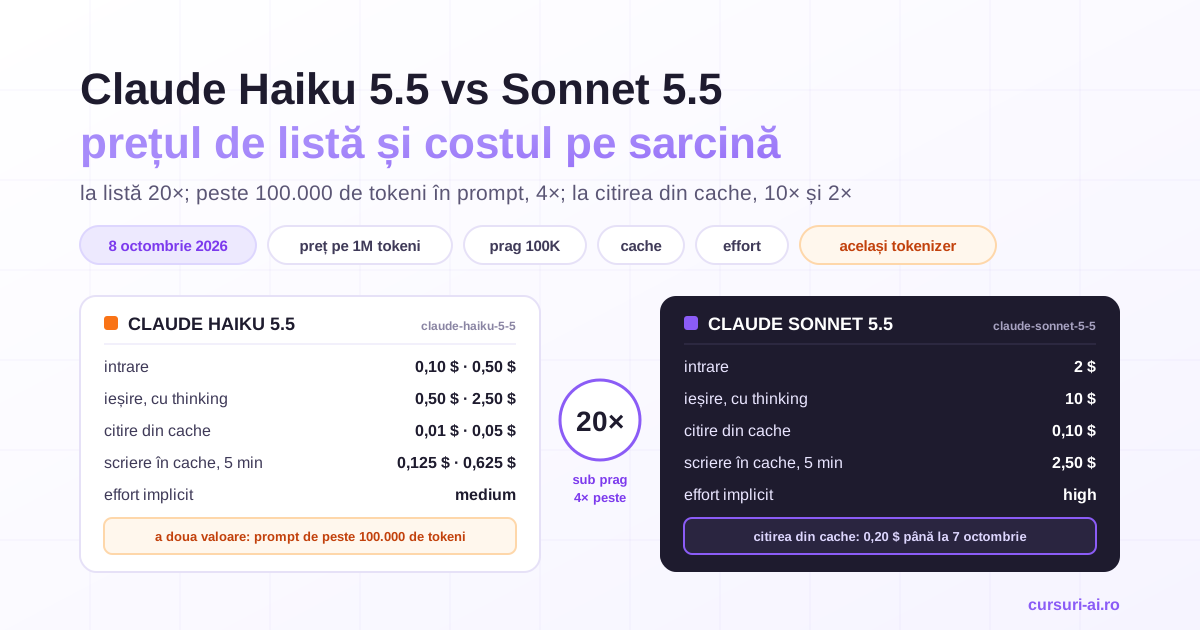
Claude Haiku 5.5 vs Sonnet 5.5 este, la 8 octombrie 2026, întrebarea oricui rulează totul pe Sonnet: la preț de listă, Haiku 5.5 costă de 20 de ori mai puțin, 0,10 $ și 0,50 $ față de 2 $ și 10 $ pe milionul de tokeni. Raportul Claude Haiku 5.5 vs Sonnet 5.5 nu rămâne însă 20×: peste 100.000 de tokeni în prompt coboară la 4×, la citirile din cache la 10× și la 2×, iar pe sarcinile lungi de cod din graficul Anthropic cele două costă la fel pe încercare la effort medium. Haiku 5.5 ajunge unde sarcina e scurtă, de volum și verificabilă; pe cod agentic complex și pe fluxuri lungi cu unelte, cifrele publicate arată că nu ajunge.
| Pe scurt | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Intrare / ieșire, pe 1M tokeni | 0,10 $ / 0,50 $; peste 100.000 de tokeni în prompt, 0,50 $ / 2,50 $ | 2 $ / 10 $ |
| Citire din cache | 0,01 $; peste prag, 0,05 $ | 0,10 $ (0,20 $ până la 7 octombrie) |
| Terminal-Bench 4.0, măsurat de Anthropic | 39,2 % | 70,6 % |
Claude Haiku 5.5 vs Sonnet 5.5: de ce comparația are sens acum
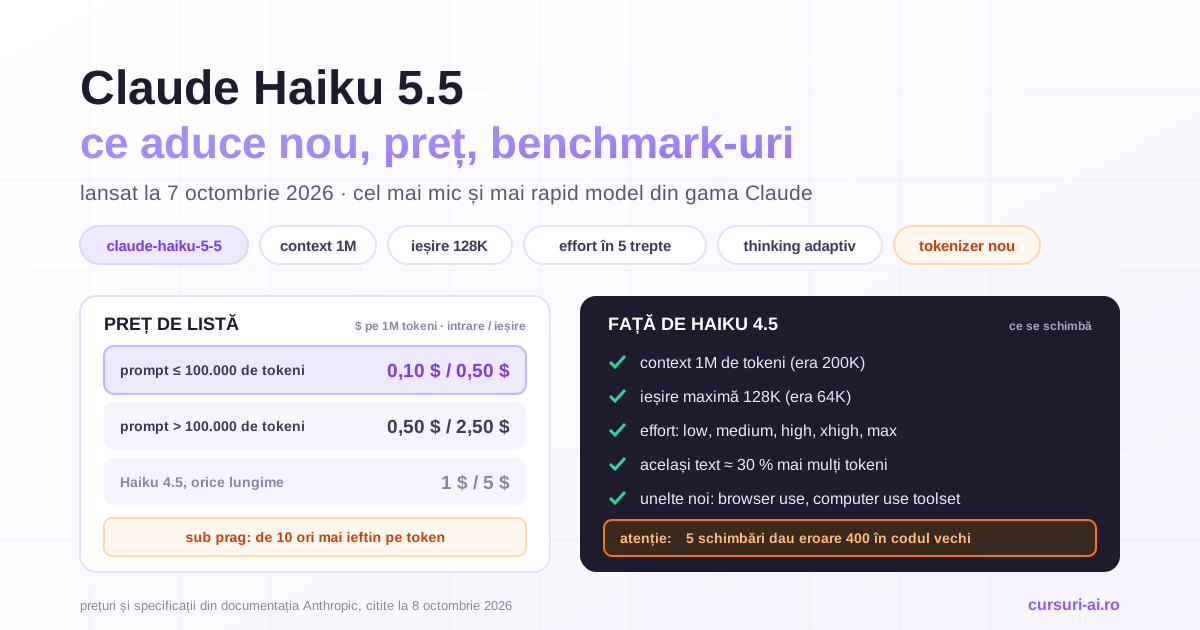
Anthropic a lansat Claude Haiku 5.5 la 7 octombrie 2026, la nouă zile după Sonnet 5.5, pentru „high-volume, latency-sensitive tasks such as classification, extraction, and routing”. Pagina de lansare a adus și o veste pentru cei rămași pe Sonnet: citirea din cache la Sonnet 5.5 costă acum 0,10 $ pe milionul de tokeni, jumătate din prețul de până atunci. Întrebarea de aici: ce poți coborî de pe Sonnet 5.5 fără o pierdere măsurabilă.
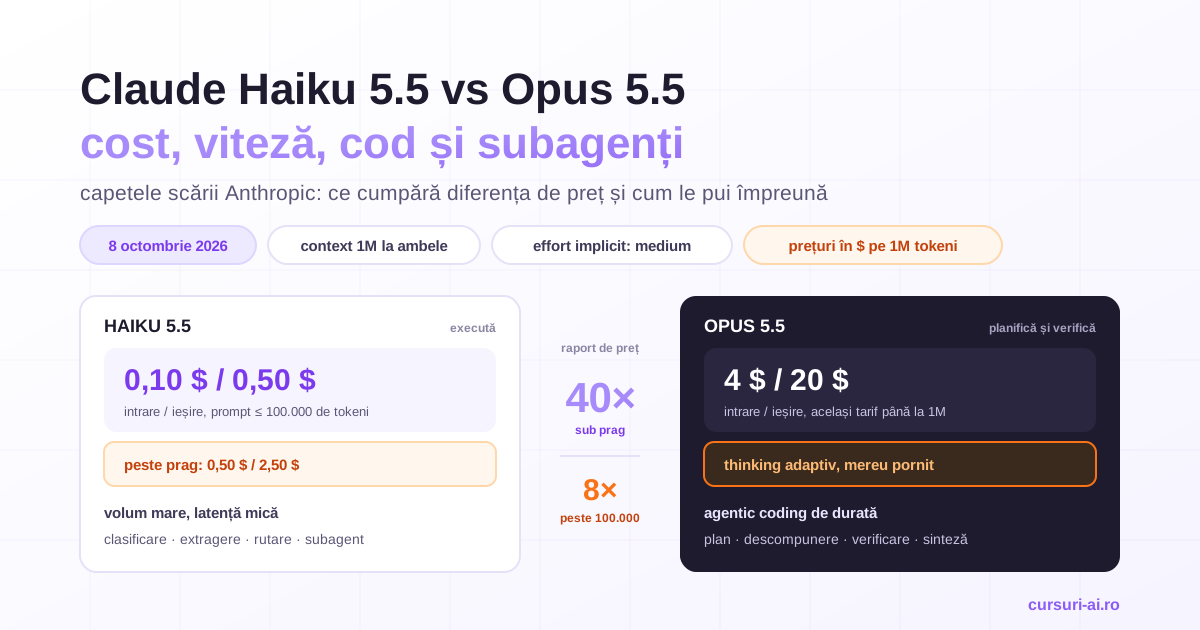
Ce nu reluăm: lansarea este în analiza Haiku 5.5; modelul mare care conduce subagenți Haiku, în Haiku 5.5 vs Opus 5.5; tot ce e de la Sonnet în sus, inclusiv advisor tool, în Sonnet 5.5 vs Opus 5.5 și Fable 5.1; fișa lui Sonnet, în articolul de lansare.
Alegerea treptei se reface la fiecare lansare: în aceeași zi a apărut un model și s-a schimbat un preț. Rămâne metoda: evaluare de la benchmark la producție, cost real după cache și Batch, rutare pe complexitate, cost și latență, lanțuri de fallback. Ea este materia cursului Comparație Modele AI 2026. Cursul a fost scris înainte de Haiku 5.5 și de Sonnet 5.5: treapta mică din exemplele lui este Haiku 4.5, la 1 $ și 5 $, iar cea mijlocie Sonnet 5.
Fișa comparativă, rând cu rând
Valori citite la 8 octombrie 2026 din pagina de prețuri și din paginile celor două modele, în dolari pe un milion de tokeni. La Haiku 5.5, a doua valoare e pentru prompturi de peste 100.000 de tokeni.
| Criteriu | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| Intrare | 0,10 $ · 0,50 $ | 2 $ |
| Ieșire, inclusiv thinking | 0,50 $ · 2,50 $ | 10 $ |
| Citire din cache | 0,01 $ · 0,05 $ | 0,10 $ |
| Scriere în cache, 5 minute | 0,125 $ · 0,625 $ | 2,50 $ |
| Batch, intrare / ieșire | 0,05 $ / 0,25 $ · 0,25 $ / 1,25 $ | 1 $ / 5 $ |
| Context · ieșire maximă | 1M · 128.000 | la fel |
| Thinking | adaptiv; se poate opri (disabled) până la high |
adaptiv; minimul e between_tools; disabled întoarce 400 |
| Effort implicit | medium |
high |
| Latență, eticheta Anthropic | „Fastest” | „Fast” |
tool_choice forțat |
acceptat, fără thinking | eroare 400 |
| Computer use, browser use | pe Claude API și Google Cloud | la fel |
| Limite de rată, treapta Start | 1.000 de cereri și 2M tokeni de intrare pe minut | aceleași, numărate separat |
| Platforme | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS | aceleași |
La o mutare în jos contează două lucruri. Effort-ul implicit diferă: același cod, cu alt nume de model, rulează la alt nivel dacă nu îl setezi explicit. Iar un refuz (stop_reason: "refusal") rămâne pe Haiku 5.5 în grija clientului; Sonnet 5.5 are, în beta, fallback pe server spre Sonnet 5.
Haiku vs Sonnet la cost: raportul de preț nu e o singură cifră
| Linia de preț | Raport sub 100.000 de tokeni | Raport peste |
|---|---|---|
| Intrare, ieșire, scriere în cache, Batch | 20× | 4× |
| Citire din cache | 10× | 2× |
- Pragul. La Haiku 5.5, potrivit paginii de prețuri, „a prompt of over 100,000 tokens pays higher prices”: fiecare linie, inclusiv ieșirea, se înmulțește cu 5, pe cerere. Sonnet 5.5 are același tarif pe tot contextul. Pagina de lansare spune că circa 90 % din cererile către Haiku 4.5 erau sub prag.
- Ce numără pragul. Paginile citite nu spun explicit dacă tokenii citiți din cache intră în lungimea promptului. Calculele de mai jos îi numără, ca ipoteză prudentă.
- Citirea din cache. De la 7 octombrie, Sonnet 5.5 plătește 0,05× din prețul de intrare, ca Opus 5.5; Haiku 5.5, multiplicatorul standard de 0,1×. Raportul e 10×; cu o zi înainte era 20×.
- Tokenizerul este același. Documentația spune că Haiku 5.5 folosește „the same newer tokenizer as Claude 4.7 and later models”, deci și al lui Sonnet 5.5: același text are același număr de tokeni de intrare, iar comparația nu cere conversie.
Costul pe sarcină în trei scenarii
Scenariile țin tokenii egali la ambele modele, ca să izoleze prețul, pragul și cache-ul; în practică, ieșirea diferă, fiindcă thinking-ul se facturează ca ieșire și depinde de model și de effort. Aritmetica este verificată cu un script; rezultatele sunt valabile doar la aceste ipoteze.
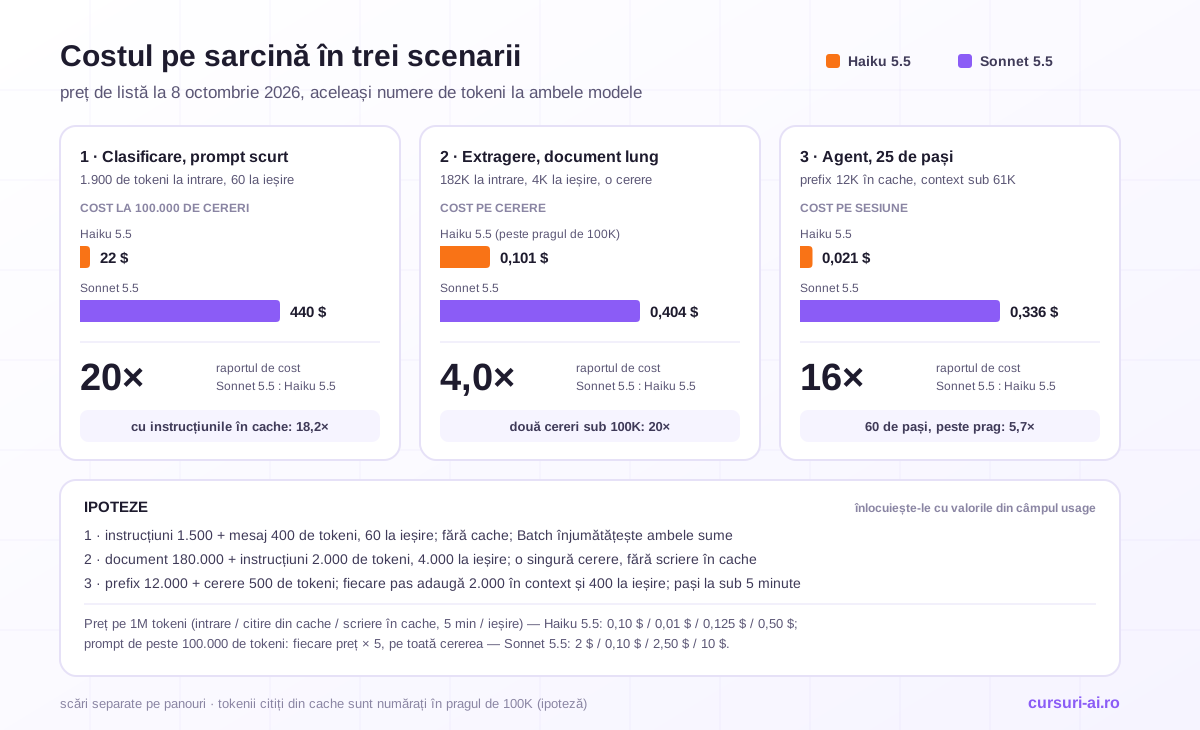
1. Clasificare de volum cu prompt scurt: 18–20×
100.000 de tichete, fiecare cu 1.500 de tokeni de instrucțiuni, 400 de mesaj și 60 la ieșire.
| La 100.000 de cereri | Haiku 5.5 | Sonnet 5.5 | Raport |
|---|---|---|---|
| Fără cache | 22 $ | 440 $ | 20× |
| Cu instrucțiunile citite din cache | 8,50 $ | 155 $ | 18,2× |
Batch înjumătățește ambele sume. Tipurile de sarcini candidate pentru un model din clasa de 0,10 $ sunt în articolul despre GPT-6 Luna.
2. Document de peste 100.000 de tokeni: 4×
Un dosar de 180.000 de tokeni, 2.000 de instrucțiuni și 4.000 la ieșire, într-o singură cerere, fără cache.
- Haiku 5.5, peste prag: 182.000 × 0,50 $ + 4.000 × 2,50 $ = 0,101 $
- Sonnet 5.5: 182.000 × 2 $ + 4.000 × 10 $ = 0,404 $
Împărțit în două cereri de câte 92.000 de tokeni, cu 2.500 la ieșire fiecare, dosarul costă 0,021 $ față de 0,418 $ (20×), dar nu mai e citit întreg. Cu dosarul în cache și 50 de întrebări de 500 de tokeni, cu 800 la ieșire, raportul ajunge la 2,7× (0,67 $ față de 1,80 $).
3. Agent cu unelte și prefix în cache: 16×, apoi 5,7×
O sesiune de 25 de pași: prefix de 12.000 de tokeni, cerere de 500, fiecare pas adaugă 2.000 de tokeni în context și produce 400 la ieșire, la mai puțin de 5 minute de pasul anterior. Rezultă 852.000 de tokeni citiți din cache, 60.500 scriși și 10.000 la ieșire: 0,021 $ pe Haiku și 0,336 $ pe Sonnet. Raportul e 16×, fiindcă citirile din cache stau la 10×. Cu prețul de citire dinainte de 7 octombrie, sesiunea costa 0,42 $ pe Sonnet: o scădere de 20 %, cât anunță Anthropic pentru munca agentică.
Dusă la 60 de pași, sesiunea ajunge la 130.500 de tokeni în context. De la pasul 45, fiecare cerere a lui Haiku trece de prag: 0,17 $ față de 0,98 $, raport 5,7×; fără prag ar fi costat 0,07 $. Pe Haiku 5.5, ținerea contextului sub 100.000 de tokeni este prima optimizare de cost.
Benchmark-uri: tabelul Anthropic și măsurătoarea independentă
Tabelul din pagina de lansare, măsurătoarea furnizorului
Redăm coloanele celor două modele. Potrivit system card-ului, rezultatele sunt la effort max, cu excepția marcată; GDPval-AA și AA-Briefcase sunt rulate de Artificial Analysis, FrontierCode de Cognition.
| Evaluare | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| GDPval-AA v2.1 | 1.620 Elo | 1.840 Elo |
| AA-Briefcase v1.1 | 1.578 Elo | 1.824 Elo |
| OSWorld 2.1, subsetul offline | 72,4 % | 83,9 % |
| Humanity's Last Exam, fără unelte | 45,9 % | 56,9 % |
| Humanity's Last Exam, cu unelte | 57,4 % | 64,5 % |
| Terminal-Bench 4.0 | 39,2 % | 70,6 % |
| FrontierCode 1.1 (Main) | 46,4 % | 52,1 % la xhigh; 46,2 % la max |
| Chartography, fără unelte | 46,4 % | 61,6 % |
System card-ul adaugă SWE-Bench Pro, 64,8 % față de 81,3 %, și, în sens invers, ProgramBench, pe context de până la 1M tokeni, 82,0 % față de 79,7 %.
Graficele aceleiași pagini dau scorul și costul pe încercare la fiecare nivel de effort. La capătul de sus al lui Haiku, răspunsul depinde de sarcină:
| Evaluare | Haiku 5.5 la max |
Sonnet 5.5 la high |
|---|---|---|
| OSWorld 2.1 (offline) | 72,4 % · 0,61 $ | 73,2 % · 1,38 $ |
| GDPval-AA v2.1 | 1.620 · 0,87 $ | 1.551 · 0,62 $ |
| Humanity's Last Exam, fără unelte | 45,9 % · 0,21 $ | 47,9 % · 0,08 $ |
| Terminal-Bench 4.0 | 39,2 % · 2,64 $ | 43,0 % · 1,46 $ |
Pe computer use, Haiku ajunge aproape la același scor cu 44 % din cost. Pe raționament fără unelte și pe cod în terminal, Sonnet la high e mai sus și mai ieftin; pe Terminal-Bench 4.0, la medium, cele două costă la fel pe încercare, 0,68 $, cu 20,3 % față de 28,8 %. Anthropic scrie: „Sonnet 5.5 and Opus 5.5 remain better choices for complex agentic coding tasks like those measured by Terminal-Bench 4.0.” Pagina nu descrie cum e calculat costul din grafice; system card-ul notează că, la Humanity's Last Exam, costul lui Sonnet presupune cache perfect.
Artificial Analysis: indice și cost pe sarcină, pe niveluri de effort
Artificial Analysis rulează ambele modele pe aceleași zece evaluări (Intelligence Index v4.3.2), la cele cinci niveluri; Sonnet 5.5 apare în configurația „Default Fallback”.
| Effort | Haiku 5.5: indice · cost pe sarcină | Sonnet 5.5: indice · cost pe sarcină |
|---|---|---|
low |
29,4 · 0,024 $ | 35,9 · 0,35 $ |
medium |
34,5 · 0,047 $ | 40,8 · 0,48 $ |
high |
37,8 · 0,079 $ | 46,8 · 0,88 $ |
xhigh |
41,2 · 0,124 $ | 51,9 · 2,01 $ |
max |
43,4 · 0,213 $ | 56,0 · 5,46 $ |
- Scor. La același nivel, Sonnet are între 6,4 și 12,6 puncte în plus. La
maxconduce pe nouă din zece evaluări; pe AA-LCR, raționament pe context lung, sunt la egalitate, 83 %. - Scor egal. Haiku la
xhigh(41,2) stă lângă Sonnet lamedium(40,8). Peste 43,4 ajunge doar Sonnet, de lahighîn sus, adică de la setarea lui implicită. - Costul lui Haiku 5.5 este aici un minim. Artificial Analysis îl calculează integral la tariful treptei mici: în datele paginii, cei 435 de milioane de tokeni de ieșire de la
maxcostă 217,6 $, adică 0,50 $ pe milion. Pe GDPval-AA lamaxarată 0,22 $ pe sarcină, iar graficul Anthropic 0,87 $; pentru Sonnet, sursele coincid (6,84 $ și 6,78 $).
Care e mai rapid: Haiku 5.5 sau Sonnet 5.5?
Etichetele Anthropic sunt „Fastest” pentru Haiku 5.5 și „Fast” pentru Sonnet 5.5. Artificial Analysis a măsurat 243 de tokeni de ieșire pe secundă față de 136 la max; pe celelalte niveluri, Haiku a generat de 1,3–1,8 ori mai repede. Viteza pe token nu e totuna cu timpul pe sarcină: la scor egal, Haiku la xhigh a avut nevoie de 291 s de generare pe sarcină, de 2,3 ori mai mult decât Sonnet la medium.
Când ajunge Haiku 5.5 și când nu: criteriul din date
| Tip de sarcină | Rândul de date | Verdict și condiție |
|---|---|---|
| Clasificare, extragere, rutare, rezumate scurte | destinația declarată de Anthropic; niciun rând dedicat în sursele citite | Haiku 5.5 implicit, dacă setul tău de test confirmă acuratețea |
| Documente și context lung | ProgramBench 82,0 % față de 79,7 %; AA-LCR 83 % la ambele | ajunge; peste 100.000 de tokeni, avantajul de preț scade la 4× |
| Muncă de birou cu livrabile | GDPval-AA: Haiku la max e peste Sonnet la high |
ajunge până la acel nivel; peste, nu |
| Computer use | OSWorld 2.1: 72,4 % față de 83,9 %; reușită strictă 37,1 % față de 48,8 % | ajunge unde o reluare e acceptabilă |
| Fluxuri de business cu multe unelte | AutomationBench-AA: 35 % la max, sub Sonnet la low (49 %) |
nu ajunge |
| Cod agentic în terminal și în depozite mari | Terminal-Bench 4.0 și SWE-Bench Pro: 31,4 și 16,5 puncte distanță | nu ajunge; excepția e FrontierCode la max |
| Răspunsuri din cunoștințe, fără căutare | AA-Omniscience: 11 față de 32 | nu ajunge fără căutare sau documente în prompt |
Fiecare rând e testul unui evaluator, la effort-ul ales de el; pe datele tale decide testul propriu.
Rutarea de jos în sus: Haiku 5.5 implicit, escaladare pe criterii măsurabile
1. Modelul se alege la începutul sarcinii. Rutele scurte, cu verificare automată (schemă, teste, regulă de business), pornesc pe Haiku 5.5 la medium; chatul și apelurile scurte de unelte, la low, cum recomandă documentația. Rutele cu verdictul „nu ajunge” pornesc pe Sonnet 5.5.
2. Escaladezi întâi effort-ul, până la high, apoi modelul. Ghidul de prompting al lui Haiku 5.5 cere ca xhigh și max să fie comparate cu Sonnet 5.5 la performanță, cost și viteză.
| Semnal măsurabil | Acțiune |
|---|---|
| Verificarea pică | reîncercare pe Haiku la high |
Pică din nou sau ruta ar cere xhigh ori max |
sarcina se reia pe Sonnet |
| Promptul trece de 100.000 de tokeni și nu se poate împărți | refaci calculul: avantajul e 4×, nu 20× |
| Apelurile de unelte trec de pragul fixat din evaluări | rutare directă pe Sonnet |
3. Reluarea se plătește singură. În scenariul 3, totul pe Haiku, cu 30 % din sarcini reluate pe Sonnet, costă 0,12 $ pe sarcină, cu 64 % sub „totul pe Sonnet”, și rămâne mai ieftin până la 94 % reluări. Ghidul Anthropic de optimizare a costului pune două condiții: un semnal de eșec de încredere și latență dublă pe sarcinile reluate.
Implementarea routerului (clasificator, scor de complexitate, try-cheap-first, metrici de acuratețe a rutării, lanț de fallback) este în modulul de orchestrare multi-model al cursului Integrare Avansată LLM în Aplicații de Producție, scris și el înainte de Haiku 5.5.
Ce se pierde când schimbi modelul în mijlocul conversației
- Cache-ul. „Prompt caches are per-model”, spune documentația: un context de 60.000 de tokeni se scrie din nou pe Sonnet cu 0,15 $, cât șapte sesiuni din scenariul 3 pe Haiku.
- Blocurile de thinking, într-un singur sens. Potrivit paginii Preserved thinking, Sonnet 5.5 citește blocurile lui Haiku 5.5 pe Claude API și pe Google Cloud, deci acolo escaladarea păstrează raționamentul. Invers nu: blocurile lui Sonnet 5.5 le citește doar Opus 5.5. Un bloc necitibil e eliminat de API fără eroare și fără semnal, dacă nu trimiți header-ul beta
thinking-binding-controls-2026-08-01.
Protocol de test pe sarcinile tale
- Alege 30–50 de sarcini din loguri, fiecare cu verificarea scrisă dinainte. Include cea mai grea zecime: ghidul Anthropic cere compararea pe coada distribuției, nu pe sarcina tipică.
- Renumără prompturile cu
modelsetat peclaude-haiku-5-5și marchează-le pe cele de peste 100.000 de tokeni. - Rulează Haiku 5.5 la
low,mediumșihighși Sonnet 5.5 lamediumșihigh, cu effort explicit, fiecare nivel în sesiune separată. - Păstrează
usagecomplet, timpul de răspuns și refuzurile; calculează costul pe sarcină reușită, cu tariful corect pentru fiecare cerere. - Decide după o regulă scrisă înainte de rezultate, de exemplu: „ruta coboară dacă rata de reușită e la cel mult două puncte sub Sonnet și cea mai grea zecime nu pică”.
Construcția setului (golden dataset, rubrici, model-judecător calibrat) și poarta de evaluare la schimbarea modelului sunt materia cursului AI Evals pentru LLM-uri în Producție; varianta scurtă, în cum evaluezi un model AI înainte de producție.
Ce alegi: cinci situații concrete
- Clasificare, triere, extragere din texte scurte. Haiku 5.5 la
lowsaumedium, prin Batch dacă nu așteaptă nimeni. - Asistent de suport cu baza de cunoștințe în cache. Haiku, cât timp prefixul stă sub 100.000 de tokeni.
- Întrebări repetate pe un document de peste 100.000 de tokeni. Raportul scade spre 2–3×: dacă documentul trebuie citit întreg, decide calitatea, nu prețul.
- Agent de cod în sesiuni lungi sau automatizare cu multe unelte. Sonnet. Haiku rămâne pentru pașii pe care îi numește Anthropic: compactare, rezumare, subagenți.
- Rute amestecate. Haiku implicit, reluare pe Sonnet la eșec verificat. Ce depășește și Sonnet urcă mai departe, după regulile din articolul despre treptele de sus.
Întrebări frecvente
Care este diferența dintre Claude Haiku 5.5 și Sonnet 5.5? Haiku 5.5 este modelul mic, pentru volum și latență, la 0,10 $ și 0,50 $ pe milionul de tokeni. Sonnet 5.5 costă 2 $ și 10 $ și are scoruri mai mari pe toate rândurile din tabelul paginii de lansare, cel mai clar pe Terminal-Bench 4.0: 70,6 % față de 39,2 %.
Cât costă Haiku 5.5 față de Sonnet 5.5? De 20 de ori mai puțin la intrare și la ieșire și de 10 ori mai puțin la citirea din cache, cât timp promptul are cel mult 100.000 de tokeni. Peste prag, rapoartele scad la 4× și 2×.
Care e mai rapid, Haiku 5.5 sau Sonnet 5.5?
Haiku 5.5: Artificial Analysis a măsurat 243 de tokeni pe secundă față de 136 la effort max. Pe sarcină, avantajul dispare dacă urci effort-ul lui Haiku ca să egalezi scorul lui Sonnet.
Au Haiku 5.5 și Sonnet 5.5 aceeași fereastră de context? Da: 1M tokeni de context și 128.000 la ieșire pe amândouă. Diferă prețul: Haiku 5.5 costă de cinci ori mai mult pe cererile cu prompt de peste 100.000 de tokeni.
Consumă Haiku 5.5 mai mulți tokeni decât Sonnet 5.5?
La intrare, nu: tokenizerul e același. La ieșire, în măsurătorile Artificial Analysis, Haiku 5.5 a produs la effort medium 32.800 de tokeni pe sarcină față de 20.900 și la max 162.000 față de 197.000.
Concluzie
Între Claude Haiku 5.5 și Sonnet 5.5, lista de prețuri spune 20×. La același consum de tokeni, raportul rămâne 18–20× pe prompturi scurte, coboară la 16× cu mult cache și la 4× peste 100.000 de tokeni. Benchmark-urile publicate arată o distanță mică pe documente și context lung și una mare pe cod agentic și pe fluxuri cu multe unelte. De aici, regula: Haiku implicit pe rutele scurte și verificabile, effort până la high, reluare pe Sonnet la eșec măsurat. Care rute coboară arată doar testul pe sarcinile tale.
Surse
- Anthropic: Introducing Claude Haiku 5.5
- Anthropic: Claude Haiku 5.5 System Card
- Anthropic Docs: Pricing
- Anthropic Docs: Preserved thinking
- Artificial Analysis: Claude Haiku 5.5 vs Claude Sonnet 5.5
Articol redactat la 8 octombrie 2026. Scorurile provin de la Anthropic și de la Artificial Analysis; nu am rulat modelele. Calculele de cost folosesc volume de tokeni ipotetice, declarate în text. Cursuri-AI.ro este furnizor de cursuri plătite, deci parte interesată.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.