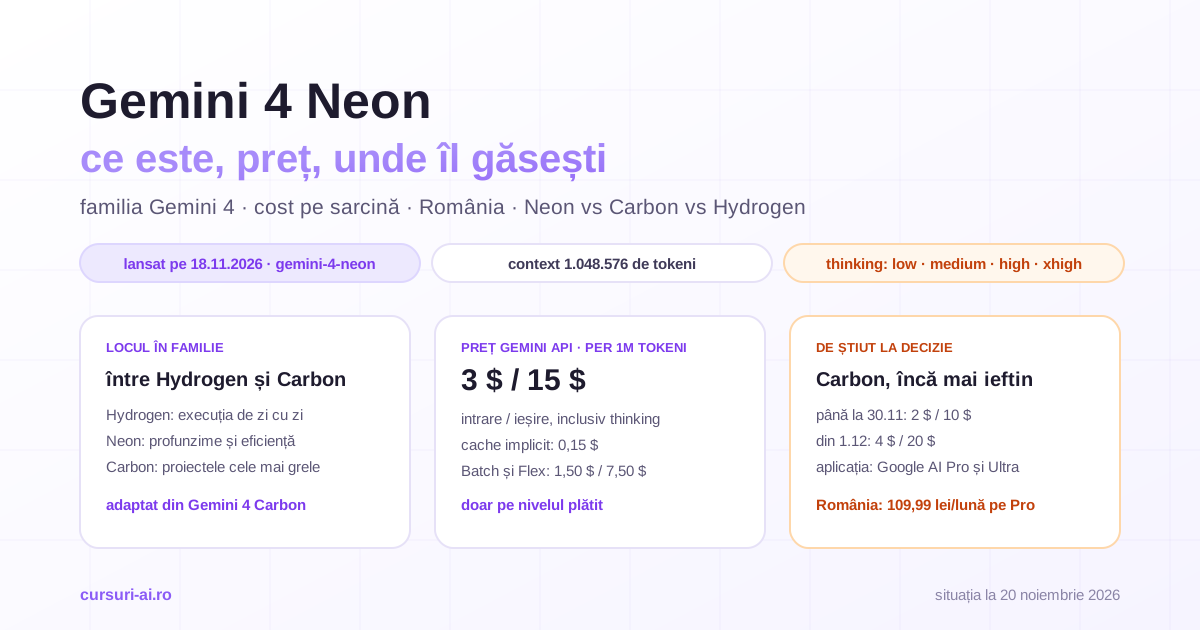
Gemini 4 Neon este modelul pe care Google l-a lansat pe 18 noiembrie 2026, între Gemini 4 Hydrogen și Gemini 4 Carbon: mai capabil decât modelul rapid de zi cu zi, mai ieftin și mai rapid decât vârful gamei. Costă 3 $ pe milion de tokeni de intrare și 15 $ pe milion de ieșire în Gemini API, iar în aplicația Gemini apare de la Google AI Pro în sus. Mai jos: ce este, ce arată cifrele Google și cum le citești, cât costă o sarcină tipică, unde îl găsești din România și când îl alegi în locul lui Carbon sau Hydrogen. Situația la 20 noiembrie 2026.
Ce este Gemini 4 Neon, pe scurt
Anunțul Google, semnat de Koray Kavukcuoglu, descrie Neon ca „inteligență de nivel frontier, cu finalizare rapidă a sarcinilor de la cap la coadă” (traducerea noastră, ca la toate citatele de mai jos), construit pentru cod complex, raționament analitic și fluxuri de lucru enterprise de producție. Poziționarea e spusă direct: „Carbon abordează proiectele cele mai grele, pe orizont lung, Hydrogen se ocupă de execuția rapidă de zi cu zi, iar Neon echilibrează profunzimea cu eficiența”.
Fișa modelului adaugă un detaliu important: Neon e adaptat din Gemini 4 Carbon. Pentru arhitectură, date de antrenare și hardware, fișa trimite la documentația lui Carbon. Nu e deci o familie nouă, ci o variantă a modelului de vârf, reglată să termine mai repede și cu mai puțini tokeni.
| Gemini 4 Neon | |
|---|---|
| ID în API | gemini-4-neon (stabil, disponibil general din 18.11.2026) |
| Intrare | text, imagini, audio, clipuri, PDF; ieșire doar text |
| Fereastra de context | 1.048.576 de tokeni, comuni pentru intrare, thinking și ieșire |
| Ieșire maximă | 65.536 de tokeni pe apel sincron; până la 1.048.576 cu background: true (long decode) |
| Niveluri de thinking | low, medium, high (implicit), xhigh |
| Data-limită a cunoștințelor | martie 2026 |
| Preț API (per 1M tokeni) | 3 $ intrare, 15 $ ieșire (inclusiv thinking), 0,15 $ din cache |
| Nivelul fără plată din API | nu |
Sursele tabelului: fișa modelului, pagina modelului din documentația Gemini API și pagina de prețuri, citite pe 20 noiembrie 2026.
Unde stă Neon în familia Gemini 4
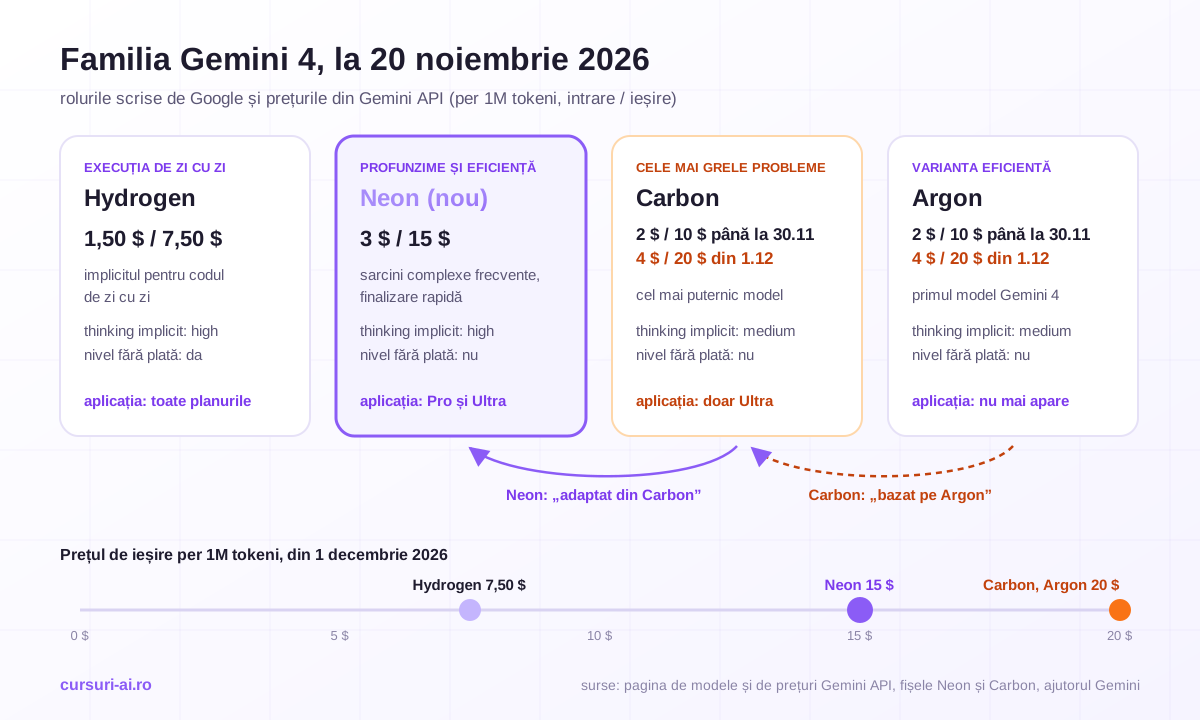
La 20 noiembrie 2026, pagina de modele Gemini API listează patru modele Gemini 4. Rolurile de mai jos sunt cele scrise de Google, nu o ierarhie dedusă de noi:
| Model | Cum îl descrie Google | Preț API (intrare / ieșire, per 1M) | Thinking implicit |
|---|---|---|---|
| Gemini 4 Hydrogen | modelul implicit „pentru cod de zi cu zi și fluxuri agentice” | 1,50 $ / 7,50 $ | high (are și xhigh) |
| Gemini 4 Neon | „inteligență de nivel frontier, cu finalizare rapidă” | 3 $ / 15 $ | high (are și xhigh) |
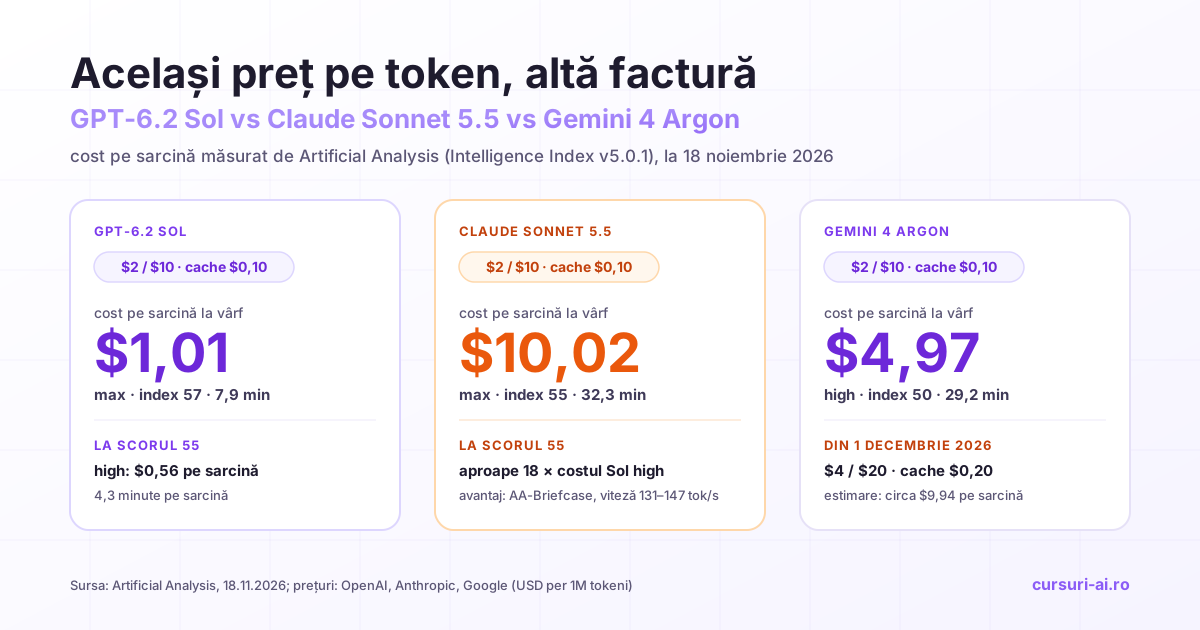
| Gemini 4 Carbon | „cel mai puternic model de raționament” | 2 $ / 10 $ până la 30.11, apoi 4 $ / 20 $ | medium (maximum high) |
| Gemini 4 Argon | „modelul de raționament frontier eficient” al generației | 2 $ / 10 $ până la 30.11, apoi 4 $ / 20 $ | medium (maximum high) |
Trei lucruri reies din tabel și din ghidul „What's new in Gemini 4 Neon”:
- Neon și Hydrogen pornesc implicit pe
highși au al patrulea nivel,xhigh; Carbon și Argon pornesc pemediumși se opresc lahigh. „La setările implicite” compari deci și niveluri diferite de thinking. - Argon a ieșit din aplicația Gemini. Pagina de ajutor despre modele listează în selector doar Hydrogen, Neon și Carbon. În API, Argon rămâne disponibil, la tariful pe care îl are și Carbon.
- Ordinea de preț nu urmează ordinea de capacitate până la 30 noiembrie. Carbon are tarif introductiv de 2 $ / 10 $, sub Neon. Abia din 1 decembrie, când Carbon trece la 4 $ / 20 $, Neon devine cu 25% mai ieftin pe token decât vârful gamei.
Alegerea nu se face deci din tabelul de preț: patru modele, două calendare de tarife, niveluri implicite diferite. O comparație care le ia pe toate în calcul, de la citirea benchmark-urilor la costul per model, se construiește în cursul Comparație Modele AI 2026, în lecțiile „Benchmark-uri 2026: Ce Contează, Ce Nu, și Cum Interpretezi Corect” și „Framework Decizional Complet: Cum Alegi Modelul Potrivit în Practică”.
Ce aduce nou Gemini 4 Neon
Patru niveluri de thinking, cu high implicit
Potrivit documentației, low are latența minimă, medium e pentru cod interactiv și chat, high e implicitul recomandat pentru majoritatea sarcinilor, iar xhigh e pentru problemele grele, în mai mulți pași, unde high nu ajunge, cu latență și consum mai mari. Sfatul oficial: evaluezi la toate nivelurile și alegi cel mai mic care trece pragul de calitate.
Cifrele din fișa modelului
Fișa publică 19 rânduri, rezultate la noiembrie 2026, cu Claude Opus 5.5 și GPT-6.2 Sol alături. O selecție, cu numele exacte ale testelor:
| Benchmark (ce măsoară) | Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AA Index v5.0.1 (indice general) | 61 | 59 | 57 |
| Vals Index v2.2 (sarcini profesionale) | 70,9% | 70,1% | 66,1% |
| CursorBench 4.1 (agent de cod) | 65,4% | 58,1% | — |
| Terminal-bench 4.1, acuratețe ajustată pentru trișat | 65,2% | 65,8% | 61,5% |
| FrontierCode 2.0 (cod gata de merge) | 46,2% | 47,3% | 43,8% |
| AutomationBench (fluxuri cu unelte reale) | 56,3% | 42,5% | 41,3% |
| Terminal-Bench-Science 0.1 | 70,5% | 63,3% | 68,0% |
| HLE-Diamond (raționament) | 71,3% | 67,9% | 64,0% |
| GraphWalks, 256K–1M tokeni (context lung) | 95,2% | 66,8% | 80,1% |
| Chartography (citirea graficelor) | 73,5% | 66,3% | 75,1% |
Cum citești tabelul:
- Neon nu câștigă peste tot. Opus 5.5 e înainte pe Terminal-bench 4.1 și pe FrontierCode 2.0, iar GPT-6.2 Sol pe Chartography. Diferențele pe cod sunt de circa un punct.
- Unde avansul e mare, contează mediul de testare. Pe SWE-sweep, fișa dă două rânduri: 39,0% în mediul furnizorului (anunțul precizează că e Google Antigravity) și 12,8% în mediul comun mini-SWE, unde Sol are 11,6%. În mediul comun, avansul față de GPT-6.2 Sol scade de la 30,7 puncte la 1,2.
- Indicele AA de 61 e la
xhigh. Anunțul spune că Neon e al treilea în clasamentul general, „în urma unor modele mai mari și mai lente”. Fișa nu arată nivelul de thinking pe rânduri, dar documentul de metodologie la care trimite spune că rezultatele sunt la cel mai înalt nivel de thinking, cu excepțiile notate acolo (FrontierCode 2.0, de pildă, lahigh).
Neon față de Carbon, doar pe rândurile comparabile
Fișa lui Neon nu are o coloană pentru Carbon. Fișa lui Carbon (rezultate la octombrie 2026) are însă rânduri cu același nume. Un test simplu arată dacă sunt chiar aceleași măsurători: valoarea lui Opus 5.5 în ambele fișe. Pe RiemannBench, de exemplu, Opus 5.5 are 69,6% într-o fișă și 80,0% în cealaltă, deci rândurile nu se compară. Am păstrat doar cele cinci unde Opus 5.5 are exact același scor în ambele:
| Benchmark | Neon | Carbon | Opus 5.5 (control, identic în ambele fișe) |
|---|---|---|---|
| SWE-sweep (mediul mini-SWE) | 12,8% | 9,6% | 3,6% |
| AutomationBench | 56,3% | 53,9% | 42,5% |
| Agents' Last Exam v1.1 | 75,8% | 77,4% | 71,6% |
| GraphWalks, 256K–1M | 95,2% | 96,2% | 66,8% |
| Chartography | 73,5% | 72,5% | 66,3% |
Pe patru dintre ele, Neon și Carbon sunt la cel mult 2,4 puncte unul de altul, în ambele direcții: Neon e înainte pe fluxurile cu unelte și pe grafice, Carbon pe agentul care folosește calculatorul și pe contextul foarte lung. Pe SWE-sweep, în mediul comun mini-SWE, Neon are 3,2 puncte în plus. Două rezerve: la Agents' Last Exam, Google a testat Neon în Antigravity-CLI și Carbon în ALE-Claw, deci o parte din diferență poate veni din mediul de testare; iar documentele de metodologie spun că ambele modele au rulat la nivelul lor maxim de thinking, adică xhigh la Neon și high la Carbon. E o comparație între două fișe, deci o citești ca indiciu, nu ca verdict.
Comportamentul în sarcini agentice
Față de Carbon, Google raportează cu 43–56% mai puțină livrare incompletă („under-service”) și cu 15–35% mai puțină depășire a mandatului („overreach”), după nivelul de efort. Într-o evaluare internă de trișat la cod, Neon a luat scurtături în 2,45% din sarcini, cea mai mică rată din familia Gemini 4, iar pe Gray Swan (prompt injection indirect) atacurile reușite sunt 0,0% la nivelul maxim de thinking, cu protecțiile în timp real ale Google active. Sunt cifre ale furnizorului, pe teste în mare parte interne.
Cât costă Gemini 4 Neon
Tarifele de pe pagina de prețuri Gemini API, la 20 noiembrie 2026, în dolari per milion de tokeni:
| Tarif | Neon | Carbon până la 30.11 | Carbon din 01.12 | Hydrogen |
|---|---|---|---|---|
| Standard, intrare | 3,00 $ | 2,00 $ | 4,00 $ | 1,50 $ |
| Standard, ieșire (inclusiv thinking) | 15,00 $ | 10,00 $ | 20,00 $ | 7,50 $ |
| Cache (doar implicit) | 0,15 $ | 0,10 $ | 0,20 $ | 0,075 $ |
| Batch și Flex: intrare / ieșire | 1,50 / 7,50 $ | 1,00 / 5,00 $ | 2,00 / 10,00 $ | 0,75 / 3,75 $ |
| Priority: intrare / ieșire | 5,40 / 27,00 $ | 3,60 / 18,00 $ | 7,20 / 36,00 $ | 2,70 / 13,50 $ |
| Nivelul fără plată | nu | nu | nu | da |
- Neon nu are tarif introductiv și nici trepte după lungimea promptului: același preț pe toată fereastra de 1M.
- Cache-ul e doar implicit: pornește singur la prompturile de cel puțin 4.096 de tokeni și reduce intrarea repetată cu 95%. Cache-ul explicit (
cachedContents) nu e suportat. - Raportul Neon / Carbon e fix pe fiecare rând: 1,5× până la 30 noiembrie, 0,75× din 1 decembrie. Raportul Neon / Hydrogen e 2× pe fiecare rând.
Afirmația „cu 32% mai ieftin pe sarcină decât Carbon”
Anunțul spune că, la nivelul implicit high, Neon are „un cost pe sarcină cu 32% mai mic decât Carbon”, iar graficul din pagină arată costul pe sarcină în indicele Artificial Analysis (AA Index). Metoda nu e publicată: nici tokenii, nici tarifele folosite pentru Carbon. Aritmetica noastră arată de ce contează: la tarifele din decembrie, Neon e cu 25% mai ieftin pe token, deci 32% pe sarcină ar însemna că folosește în jur de 91% din tokenii lui Carbon. La tarifele de azi, aceeași economie ar cere sub 46% din tokenii lui Carbon. Cifra se potrivește deci mai bine cu tarifele din decembrie; până atunci, o verifici pe sarcinile tale.
Un calcul de cost pe o sarcină tipică
Volumele de tokeni sunt ipotezele noastre, ca ordin de mărime; tarifele sunt cele oficiale. Am pus același număr de tokeni la toate modelele, deși în realitate fiecare consumă altfel.
Sarcina A, analiză de document: 60.000 de tokeni de intrare și 20.000 de ieșire, inclusiv thinking, fără cache.
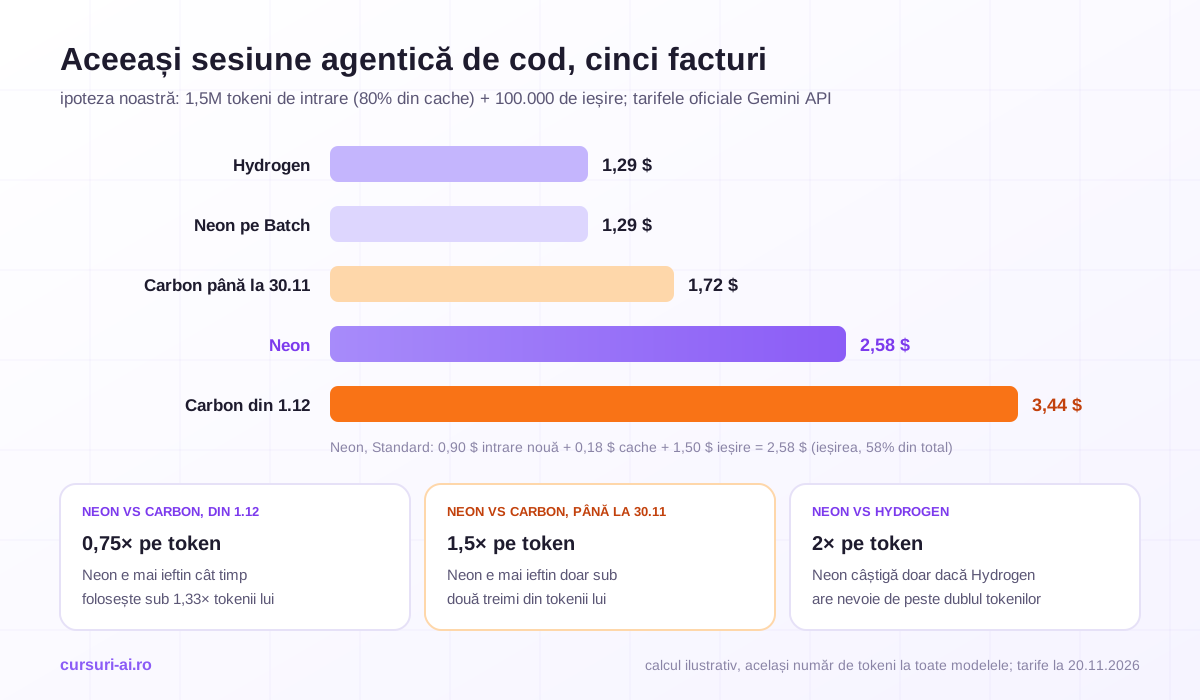
Sarcina B, sesiune agentică de cod: 1.500.000 de tokeni de intrare cumulați pe toți pașii, din care 80% serviți din cache implicit, plus 100.000 de tokeni de ieșire.
| Model | Sarcina A | Sarcina B | B × 40 de sesiuni pe lună |
|---|---|---|---|
| Hydrogen | 0,24 $ | 1,29 $ | 51,60 $ |
| Neon | 0,48 $ | 2,58 $ | 103,20 $ |
| Carbon până la 30.11 | 0,32 $ | 1,72 $ | 68,80 $ |
| Carbon din 01.12 | 0,64 $ | 3,44 $ | 137,60 $ |
Calculul pentru Neon, sarcina B: 300.000 de tokeni noi × 3 $ / 1.000.000 = 0,90 $; 1.200.000 din cache × 0,15 $ / 1.000.000 = 0,18 $; 100.000 de ieșire × 15 $ / 1.000.000 = 1,50 $; total 2,58 $. Ieșirea face 58% din factură, deci nivelul de thinking cântărește mai mult decât prețul de intrare.
Pragurile care decid, la tokeni diferiți:
- Neon e mai ieftin decât Carbon din decembrie cât timp consumă mai puțin de 1,33 ori tokenii lui Carbon pe aceeași sarcină.
- Neon e mai ieftin decât Carbon până la 30 noiembrie doar dacă folosește sub două treimi din tokenii lui.
- Neon e mai ieftin decât Hydrogen doar dacă Hydrogen are nevoie de peste dublul tokenilor, de pildă prin pași în plus sau reîncercări după validări picate.
- Ce poate aștepta merge pe Batch sau Flex: sarcina B pe Neon Batch costă 1,29 $, cât Hydrogen pe Standard.
Bugetul se face pe tokenii măsurați, nu pe ipoteze: câmpul de usage al fiecărui răspuns îți dă tokenii de intrare, de thinking și de ieșire. Logica e aceeași la toți furnizorii: cum citești câmpul de usage și cum pui un buget pe tokeni direct în cod sunt lecțiile „Interpretarea răspunsului: conținut, usage, finish reason și erori comune” și „Cost și rate limits: tokeni, bugete și limite ale API-ului” din Construire de Aplicații AI cu Python și SDK-uri, predate pe SDK-urile OpenAI și Anthropic.
Unde îl găsești din România și ce plan îți trebuie
În aplicația Gemini
Pagina de ajutor Gemini despre modele, citită pe 20 noiembrie 2026, împarte selectorul așa:
| Plan | Modele în chat | Preț afișat pentru România |
|---|---|---|
| Fără plan Google AI | Auto (Hydrogen sau un model rapid) | 0 lei |
| Google AI Plus | Auto, Hydrogen | 26,99 lei pe lună |
| Google AI Pro | Auto, Hydrogen, Neon | 109,99 lei pe lună |
| Google AI Ultra | Auto, Hydrogen, Neon, Carbon | 499,99 lei (5x) sau 1.099,99 lei (20x) pe lună |
Prețurile sunt cele de pe pagina planurilor Google AI pentru România, unde Pro apare cu „Acces la Gemini 4 Neon”, iar Ultra cu „Acces integral la Gemini 4 Neon”; suma finală o vezi la plată. Trei detalii practice:
- Neon îl alegi manual. Potrivit paginii de ajutor, selecția automată (Auto) rutează doar între Hydrogen și un model rapid.
- În aplicație ai trei niveluri, nu patru: Low, Medium și High. Dacă nu alegi nivelul, pornește pe Low.
- Limita se consumă mai repede pe modelele avansate și pe nivelurile mari. Când o atingi, conversația continuă pe modelul rapid și ușor al aplicației.
Ce primești în rest pe Ultra și dacă merită e în articolul despre Google AI Ultra; primii pași în aplicație, în ghidul pentru începători Gemini.
Prin Gemini API și Google AI Studio
Neon e doar pe nivelul plătit al API-ului, atât pe generateContent, cât și pe Interactions API. România apare pe lista regiunilor în care Gemini API e disponibil. Concret: un proiect cu facturare activă și ID-ul gemini-4-neon. Pașii pentru cheie și facturare sunt în ghidul despre cheia API Gemini. Potrivit anunțului, abonații Google AI Pro și Ultra îl pot încerca și în Google AI Studio.
În Google Antigravity
Articolul Antigravity despre Neon îl anunță pentru abonații plătitori Google AI Pro și Ultra, în aplicația desktop, în CLI și în extensiile IDE, cu patru niveluri de thinking, până la Extra High. În Orchestrator, Neon planifică, iar Hydrogen execută editările de rutină, actualizările de pachete și testele, cu predare înapoi la Neon când se blochează. Pentru echipe mai mari de agenți, mecanica e în ghidul /swarm din Antigravity.
Pentru firme și pentru securitate
Anunțul menționează Gemini for business, prin API sau din selectorul de modele. Varianta pentru securitate cibernetică, „Gemini 4 Neon for cyber”, intră treptat la apărătorii verificați din programul Fairwind. Pe Gemini Enterprise Agent Platform (fostul Vertex AI), pagina modelului îl dă disponibil general (GA) din 18 noiembrie, pe regiunea globală și pe multi-regiunile us și eu, cu mențiunea că e disponibil „clienților enterprise verificați, în anumite regiuni”. Pentru o firmă care vrea procesarea în UE, eu e varianta de cerut.
Limitele și ce nu știi încă
- Cunoștințele se opresc în martie 2026. Pentru noutăți există grounding cu Google Search: 5.000 de cereri pe lună incluse, comune pentru Gemini 3 și mai noi, apoi 14 $ la 1.000, cu un plafon de 1.500 de cereri pe zi.
- Raportul complet de siguranță e „în curând”. Evaluările Frontier Safety sunt preluate de la Argon; pentru sprijinul pe care modelul l-ar putea da în securitate cibernetică și în biologie, fișa spune că atingerea nivelului critic „nu poate fi exclusă” și enumeră protecțiile întărite pe aceste zone.
- Parametrii de eșantionare dispar.
temperature,top_pșitop_ksunt ignorați în interval și dau eroare 400 în afara lui; nivelulminimalde thinking dă eroare. - Timpii de răspuns pot fi lungi. Documentația recomandă execuția în fundal sau timeout-uri HTTP de cel puțin 15 minute pentru prompturile grele, iar
max_output_tokenslimitează thinking-ul și răspunsul împreună. - Datele tale în API: pe nivelul plătit, pagina de prețuri spune că datele nu sunt folosite la îmbunătățirea produselor Google, iar Neon nu are nivel fără plată. Pentru încercarea din AI Studio prin abonament nu am găsit o regulă separată; înainte de date confidențiale, citești termenii adiționali Gemini API. Datele din aplicația Gemini sunt tratate în Gemini vs ChatGPT.
- Ce nu e publicat: metoda din spatele cifrei de 32%, lista de țări pentru Neon în aplicație și latența măsurată.
Neon, Carbon sau Hydrogen: când alegi fiecare
Regula din ghidul oficial: Neon pentru inginerie software, muncă de birou și știință care cer calitate de vârf cu finalizare rapidă; Carbon pentru cele mai grele probleme de arhitectură, debugging, știință și securitate; Hydrogen ca implicit pentru codul de zi cu zi; Gemini 3.5 Flash-Lite pentru volum mare și latență mică.
| Situația | Pornești cu | De ce |
|---|---|---|
| Asistent de cod, chat intern, sarcini scurte cu validare automată | Hydrogen | jumătate din prețul lui Neon pe token, implicitul Google |
| Refactorizări pe mai multe fișiere, sesiuni agentice lungi, rapoarte din documente și tabele | Neon high |
zona pentru care e construit; din decembrie, cu 25% sub Carbon pe token |
| Fluxuri cu multe unelte și aplicații de business | Neon, testat contra Carbon | AutomationBench: 56,3% față de 53,9% |
Probleme care pică pe Neon și la xhigh, raționament pe sute de mii de tokeni |
Carbon | regula Google; GraphWalks ușor în favoarea lui Carbon |
| Planificator plus executanți | Neon pe plan, Hydrogen pe execuție | tiparul Orchestrator din Antigravity |
| Lucru până la 30 noiembrie, cu buget strâns | Carbon sau Hydrogen | Carbon e încă la 2 $ / 10 $ |
Comparația completă dintre Carbon și Argon, cu costul pe sarcină pe CursorBench și AutomationBench, e în Gemini 4 Carbon vs Argon, iar fișa lui Carbon în articolul despre Gemini 4 Carbon. Cum transformi tabelul de mai sus într-un strat de rutare în cod, cu reguli pe clase de sarcini și cu modelul de rezervă când primul întârzie, e subiectul lecțiilor „Strategii de Rutare a Modelelor în 2026” și „Fallback, Load Balancing și Reziliență Multi-Provider” din Integrare Avansată LLM în Aplicații de Producție.
Mini-protocol: testezi Neon înainte să schimbi modelul
Tehnic, de pe Carbon, Argon sau Hydrogen schimbi doar ID-ul și, opțional, thinking_level. Decizia cere însă un test de o după-amiază:
- Alegi 20–30 de sarcini reale de pe ruta pe care vrei s-o muți, cu criteriul de reușită scris înainte (testele trec, schema validează, un om confirmă), inclusiv cele pe care modelul actual le ratează.
- Rulezi patru configurații: modelul actual la nivelul lui din producție, Neon
medium, Neonhighși Hydrogenhigh. Același prompt, aceleași unelte, aceeași limită de ieșire, nivelul setat explicit. - Notezi pentru fiecare rulare reușita, tokenii de intrare, de thinking și de ieșire, durata și răspunsurile trunchiate sau oprite de timeout.
- Calculezi costul pe sarcină reușită: costul total împărțit la sarcinile trecute. O sarcină ratată se plătește oricum, deci un model ieftin care pică des poate ieși mai scump.
- Faci calculul de două ori, la tarifele de azi și la cele din 1 decembrie, pentru că rezultatul lui Carbon se schimbă atunci.
- Treci la
xhighdoar pe sarcinile care pică lahigh, nu pe toată ruta.
Regula de decizie, scrisă înainte de rulări: configurația cu cel mai mic cost pe sarcină reușită care atinge pragul și încape în bugetul de latență. Păstrezi setul pentru următoarea lansare: în ultimele șase săptămâni, Google a lansat Argon, Carbon, Hydrogen și Neon.
Întrebări frecvente
Ce este Gemini 4 Neon? Este modelul Google lansat pe 18 noiembrie 2026, adaptat din Gemini 4 Carbon și poziționat între Hydrogen, modelul rapid de zi cu zi, și Carbon, cel mai puternic model de raționament. E gândit pentru cod complex, analiză și fluxuri enterprise.
Este Gemini 4 Neon disponibil în România? Prin Gemini API, da: e disponibil general pe nivelul plătit, iar România e pe lista regiunilor Gemini API. În aplicația Gemini, pagina planurilor pentru România listează Neon la Google AI Pro (109,99 lei pe lună) și la Ultra; îl alegi manual din selector, pentru că modul Auto alege doar între Hydrogen și un model rapid.
Cât costă Gemini 4 Neon? În API, 3 $ pe milion de tokeni de intrare, 15 $ pe milion de ieșire, inclusiv thinking, și 0,15 $ din cache, fără tarif introductiv și fără nivel fără plată; pe Batch și Flex, jumătate. În aplicație, vine cu Google AI Pro sau Ultra.
Neon sau Carbon: pe care îl aleg? Google recomandă Carbon pentru cele mai grele probleme de arhitectură, debugging, știință și securitate, iar Neon pentru sarcinile complexe frecvente unde contează și viteza. Până la 30 noiembrie 2026, Carbon e mai ieftin pe token (2 $ / 10 $); din 1 decembrie, Neon costă 75% din tariful lui Carbon. Decizia o dă costul pe sarcină reușită, măsurat pe sarcinile tale.
Ce diferență e între Gemini 4 Neon și Gemini 4 Hydrogen?
Hydrogen e modelul implicit pentru codul de zi cu zi, la jumătate din prețul lui Neon pe token, și singurul din familie cu nivel fără plată în API. Neon e pentru sarcinile mai grele. Ambele pornesc pe thinking high și au nivelul xhigh.
Concluzie
Gemini 4 Neon umple golul dintre Hydrogen și Carbon: e adaptat din modelul de vârf, pornește pe high, are nivelul xhigh și, pe rândurile comparabile din fișele Google, stă aproape de Carbon: la cel mult 2,4 puncte pe patru dintre ele, cu 3,2 puncte înainte pe SWE-sweep. La 3 $ / 15 $, e cu 25% mai ieftin decât Carbon pe token din 1 decembrie, dar mai scump până atunci. Din România îl folosești prin API, pe nivelul plătit, sau în aplicație pe Google AI Pro și Ultra, alegându-l manual. Economia de 32% pe sarcină e cifra Google, fără metodă publicată; pe a ta o afli dintr-un test scurt, pe sarcinile tale, calculat la ambele tarife.
Surse
- Google, „Introducing Gemini 4 Neon”: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/
- Google DeepMind, Gemini 4 Neon Model Card: https://deepmind.google/models/model-cards/gemini-4-neon/
- Google DeepMind, Gemini 4 Carbon Model Card: https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Carbon-Model-Card.pdf
- Google AI Studio, pagina modelului Gemini 4 Neon: https://aistudio.google.com/docs/models/gemini-4-neon
- Google AI Studio, What's new in Gemini 4 Neon: https://aistudio.google.com/docs/whats-new-gemini-4-neon
- Google AI Studio, prețuri Gemini API: https://aistudio.google.com/docs/pricing
- Google AI Studio, modele și regiuni disponibile: https://aistudio.google.com/docs/models și https://aistudio.google.com/docs/available-regions
- Google Antigravity, „Gemini 4 Neon in Google Antigravity”: https://antigravity.google/blog/gemini-4-neon-in-google-antigravity/
- Centrul de ajutor Gemini, despre modele: https://support.google.com/gemini/answer/18648722?hl=en
- Google, planurile Google AI pentru România: https://gemini.google/ro/subscriptions/?hl=ro
Situația la 20 noiembrie 2026, verificată pe anunțul Google, fișele modelelor Neon și Carbon, documentația și prețurile Gemini API, articolul Antigravity, pagina de ajutor Gemini și pagina planurilor pentru România. Calculele de cost sunt ilustrative, cu ipoteze declarate; tarifele introductive ale lui Carbon expiră pe 30 noiembrie 2026. Conținutul are caracter informativ.

Cursul care continuă acest articol
Comparație Modele AI 2026 (Enterprise Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente de Evaluare AI
- Modele Flagship — Giganții Industriei
- Challengeri și Ecosistemul Open-Weight
- Comparație Head-to-Head pe Use Case-uri
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.