Claude Haiku 5.5 vs Opus 5.5 este, la 8 octombrie 2026, comparația dintre capetele scării Anthropic: același context de 1M, dar un preț pe token de 40 de ori mai mic la Haiku, cât timp promptul rămâne sub 100.000 de tokeni. În măsurătoarea independentă Artificial Analysis, la effort-ul implicit medium, Claude Haiku 5.5 vs Opus 5.5 înseamnă 34,5 față de 51,2 puncte de indice și 0,05 $ față de 1,34 $ pe sarcină. Cele două nu concurează pentru același loc: Anthropic îl recomandă pe Haiku ca subagent al lui Opus.
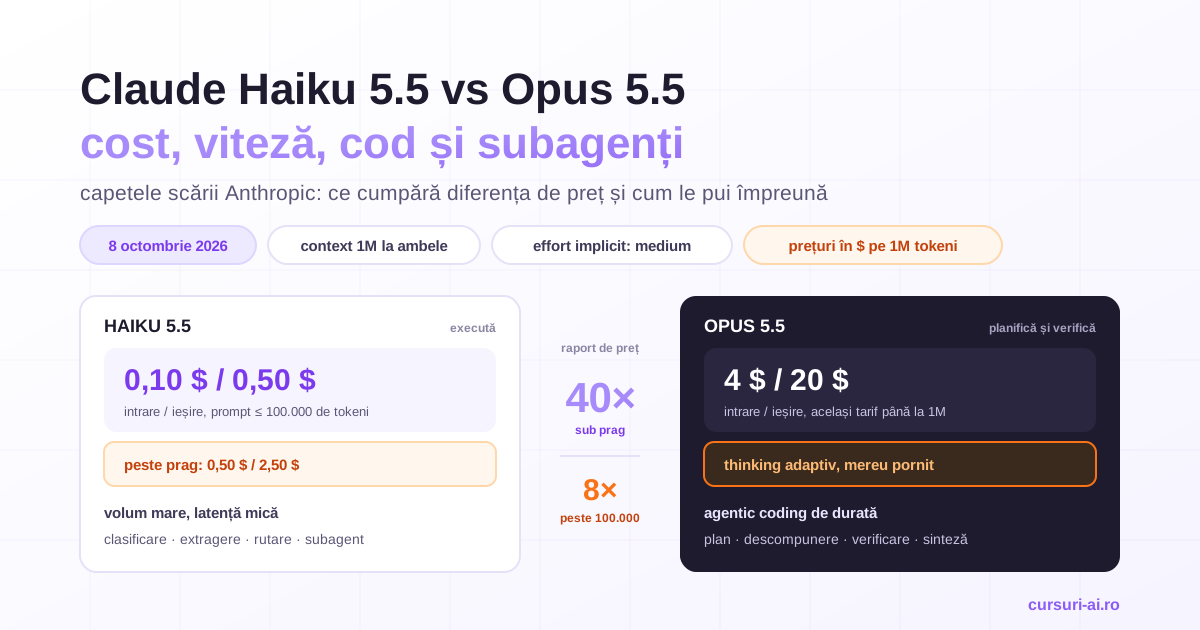
| Pe scurt | Haiku 5.5 | Opus 5.5 |
|---|---|---|
| Intrare / ieșire, pe 1M tokeni | 0,10 $ / 0,50 $, cu prompt de cel mult 100.000 de tokeni | 4 $ / 20 $ |
Artificial Analysis, medium: indice · cost pe sarcină |
34,5 · 0,05 $ | 51,2 · 1,34 $ |
Terminal-Bench 4.0 la Artificial Analysis, medium |
15 % | 53 % |
| Rolul din documentație | volum mare, latență mică, subagent | agentic coding de durată |
Claude Haiku 5.5 vs Opus 5.5: două roluri, nu două variante de preț
Documentația Anthropic descrie Haiku 5.5, lansat la 7 octombrie 2026, ca model pentru volum mare și latență mică (clasificare, extragere, rutare), iar Opus 5.5 ca model pentru „long-running agentic coding and knowledge work”, cu care pornesc majoritatea sarcinilor. Pagina de lansare spune că Haiku „pairs well with Opus 5.5 and Sonnet 5.5 as a subagent on coding work”.
Întrebarea practică este ce parte din muncă poate coborî pe modelul ieftin fără ca factura să se întoarcă pe altă ușă. Răspunsul ține mai puțin de prețul pe token și mai mult de proiectare: ce primește fiecare agent, cine verifică și când se oprește bucla. Tiparele acestea (orchestrator și workeri, plan-and-execute cu modele pe trepte, bugete pe sub-sarcină, handoff) sunt materia cursului AI Agents: Arhitectura și Automatizarea Sistemelor Autonome; cursul a fost scris înainte de Haiku 5.5, iar exemplele lui folosesc Haiku 4.5.
Ce nu reluăm: lansarea este în Claude Haiku 5.5: ce este și ce aduce nou, coborârea de pe Sonnet în Haiku 5.5 vs Sonnet 5.5, fișa modelului mare în Claude Opus 5.5, iar treapta de deasupra în Opus 5.5 vs Fable 5.1.
Haiku vs Opus la preț: fișa comparativă
Valori din pagina de prețuri, la 8 octombrie 2026, în dolari pe un milion de tokeni.
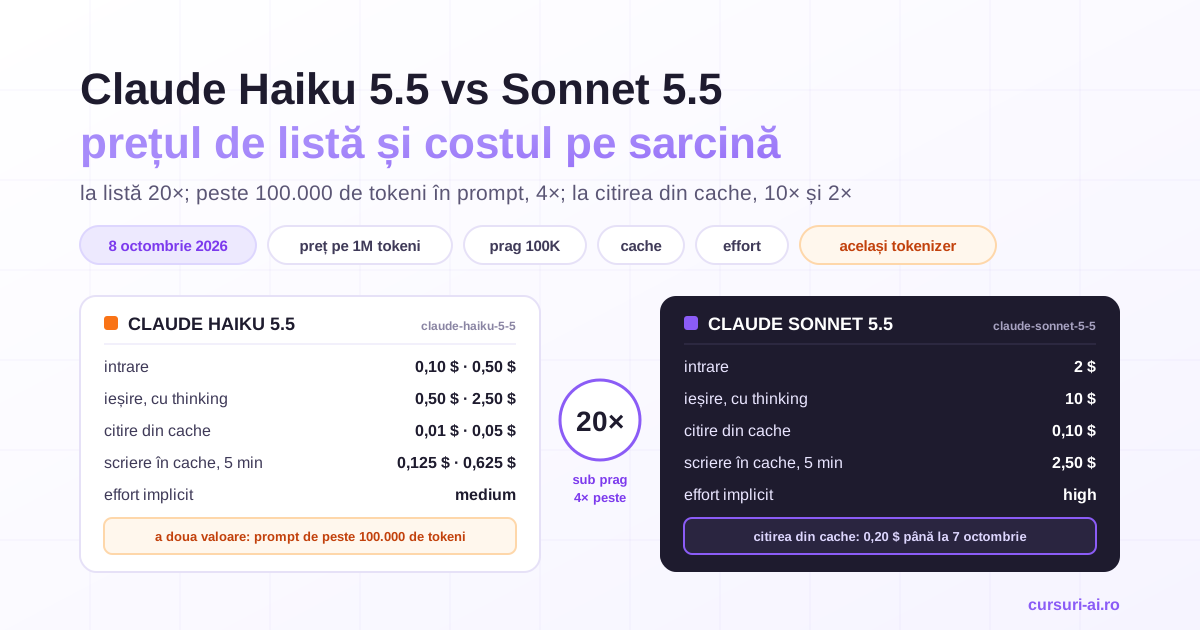
| Linie de preț | Haiku, prompt ≤ 100.000 | Haiku, prompt > 100.000 | Opus |
|---|---|---|---|
| Intrare / ieșire | 0,10 $ / 0,50 $ | 0,50 $ / 2,50 $ | 4 $ / 20 $ |
| Citire din cache | 0,01 $ | 0,05 $ | 0,20 $ |
| Scriere în cache, 5 minute | 0,125 $ | 0,625 $ | 5 $ |
| Cu cât e Opus mai scump | 40×; 20× la citirea din cache | 8×; 4× la citirea din cache |
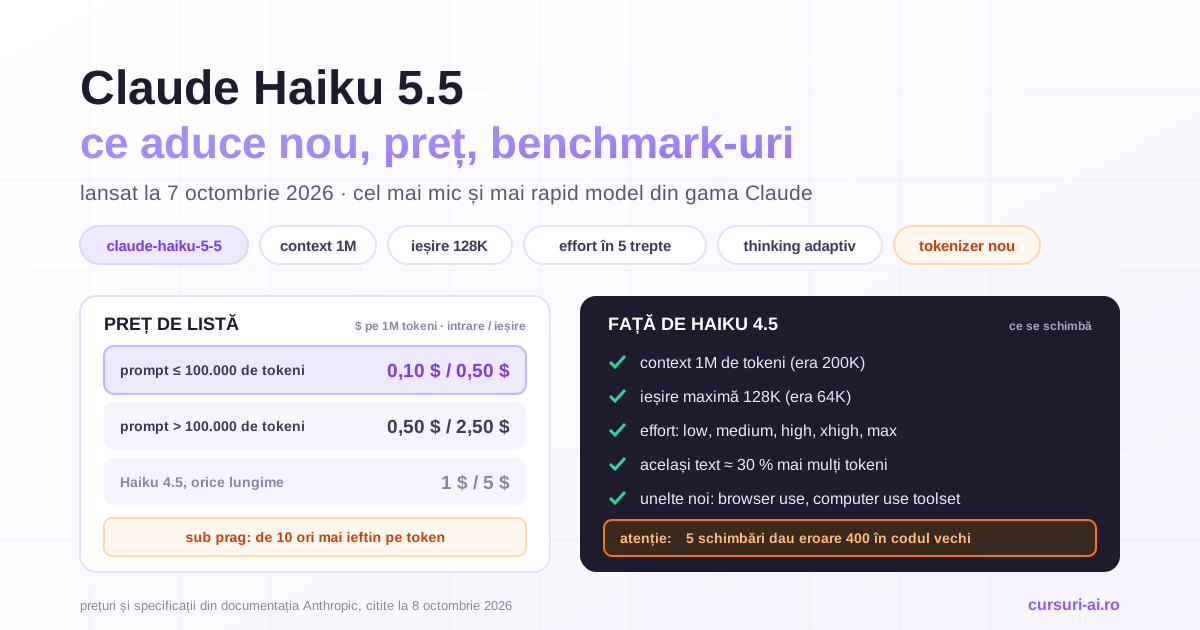
Restul fișei, din paginile celor două modele: ambele au context de 1M, ieșire maximă de 128K, effort implicit medium și același tokenizer. Thinking-ul e adaptiv la amândouă, dar pe Opus e mereu pornit, iar pe Haiku se poate opri din API până la high. Opus respinge cu eroare 400 un tool_choice forțat, pe care Haiku îl acceptă; are în schimb fast mode (research preview, 8 $ / 40 $) și fallback pe server la refuzurile clasificatoarelor de siguranță.
Două rânduri schimbă calculele de mai jos:
- Raportul de 40× nu se aplică citirii din cache. Opus are multiplicatorul redus, 5 % din prețul de intrare, iar Haiku pe cel standard, 10 %. În buclele de agent, dominate de citiri din cache, raportul real coboară spre 20×.
- Haiku 5.5 e singurul model curent taxat după lungimea promptului. Peste 100.000 de tokeni, toate liniile se înmulțesc cu cinci. Documentația nu precizează dacă tokenii citiți din cache intră în prag; calculele de aici presupun că se numără tot promptul.
Benchmark-uri: Anthropic nu le pune în același tabel de lansare
Tabelul de lansare îl compară pe Haiku 5.5 cu Haiku 4.5, GPT-6 Luna și Sonnet 5.5; Opus lipsește. Pe amândouă le rulează, la fiecare nivel de effort, Artificial Analysis: zece evaluări (Intelligence Index v4.3.2) și un cost mediu pe sarcină, calculat din tokenii consumați și prețurile de listă. Opus apare în configurația „Default Fallback”. Valori citite la 8 octombrie 2026; raportul e calculat de noi.
| Effort | Haiku: indice · cost pe sarcină | Opus: indice · cost pe sarcină | Raport de cost |
|---|---|---|---|
low |
29,4 · 0,02 $ | 42,3 · 0,55 $ | 23× |
medium |
34,5 · 0,05 $ | 51,2 · 1,34 $ | 28× |
high |
37,8 · 0,08 $ | 53,6 · 1,82 $ | 23× |
xhigh |
41,2 · 0,12 $ | 56,0 · 3,46 $ | 28× |
max |
43,4 · 0,21 $ | 57,6 · 5,98 $ | 28× |
- La același effort, Opus are 13–17 puncte în plus și costă de 23–28 de ori mai mult pe sarcină.
- Niciun nivel al lui Haiku nu ajunge la Opus
medium. Haiku lamaxstă lângă Opus lalow, la 39 % din cost, dar cu un timp de generare pe sarcină de cinci ori mai mare: 423 s față de 82 s. - Distanța depinde de sarcină. La
medium: 77 % față de 84 % pe AA-LCR (raționament pe context lung), dar 15 % față de 53 % pe Terminal-Bench 4.0.
Anthropic are și o măsurătoare directă, în ghidul de optimizare a costului: pe GPQA Diamond, rulat la 7 octombrie la effort-ul implicit, Haiku a avut 85 % la circa o douăzecime din costul pe întrebare al lui Opus, care a avut 91 % cu refuzurile numărate ca greșeli. Concluzia ghidului: Haiku se potrivește la muncă de volum „with checkable outputs”.
Rândurile cu același nume din cele două pagini de lansare nu se alătură: la Terminal-Bench 4.0, cifra lui Haiku (39,2 %) e la max, a lui Opus (66,4 %) la xhigh; la OSWorld 2.1 diferă subsetul, la Chartography folosirea uneltelor. Coincide doar GDPval-AA v2.1 la max: 1.620 față de 1.866 Elo, la Artificial Analysis.
Haiku 5.5 vs Opus 5.5 pentru cod
Pagina de lansare spune că Sonnet 5.5 și Opus 5.5 „remain better choices for complex agentic coding tasks like those measured by Terminal-Bench 4.0”, iar Haiku e pentru sarcini înguste: compaction, rezumare, muncă de subagent. În rularea Artificial Analysis, Haiku rezolvă 15 % din sarcini la medium și 33 % la max, iar Opus 53 % și 60 %. Costul pe sarcină la medium: 0,19 $ față de 4,04 $.
Merită să încerci întâi pe Haiku și să escaladezi eșecurile? Dacă eșecul se vede singur, din teste, economia față de „direct pe Opus”, ca fracție din costul lui, este p_H − c_H / c_O: rata de reușită a lui Haiku minus raportul costurilor pe sarcină. Pe Terminal-Bench 4.0 la medium: 15,2 % − 4,8 %, circa 10 %, plătite cu o rulare ratată înaintea fiecărei escaladări. Pe o sarcină pe care Haiku o rezolvă în 85 % din cazuri, aceeași formulă dă 80 %.
Ghidul de prompting avertizează că, la low și medium, Haiku raportează uneori o modificare ca terminată fără să o verifice, și dă un paragraf pentru promptul de sistem.
Haiku vs Opus la viteză: ce este publicat
Anthropic publică doar etichete, „Fastest” pentru Haiku și „Moderate” pentru Opus, nu cifre de latență, și notează că Haiku e cel mai rapid model la viteza standard, dar mai lent decât Opus în fast mode. Artificial Analysis a măsurat pe API-ul Anthropic 137 de tokeni pe secundă la Haiku și 76 la Opus, la medium. Pe sarcină, avantajul se subțiază, fiindcă Haiku scrie mai mult: 134 s față de 205 s timp de generare pe sarcina din indice.
Cum le folosești împreună: Opus planifică și verifică, Haiku execută
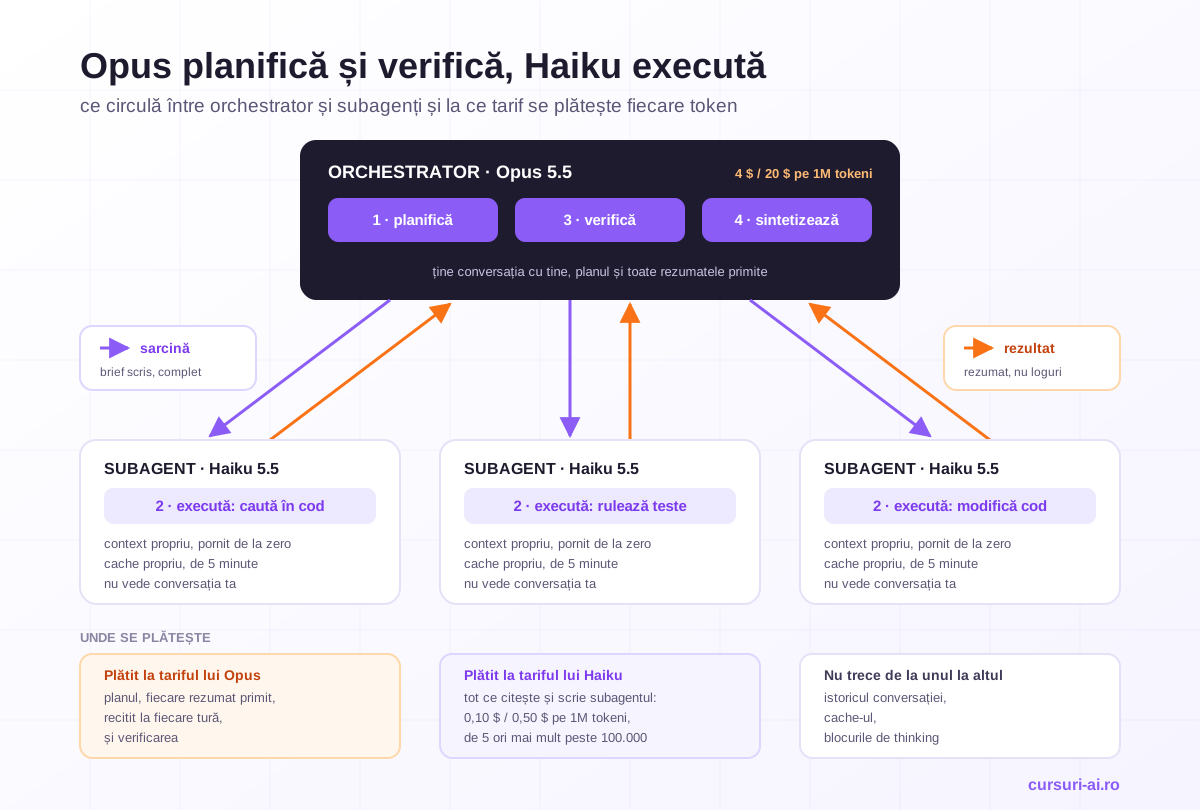
În tiparul orchestrator, modelul scump ține bucla: descompune sarcina, trimite fiecărui subagent un brief, primește rezumate și le verifică. Ghidul de optimizare e sobru: tiparul a economisit bani în doar două situații măsurate. Prima este munca de rutină cu o coadă de rulări foarte scumpe, unde delegarea mută spirala la tariful workerului. A doua este munca mai mare decât o fereastră de context, unde un coordonator cu 25 de workeri a costat cam jumătate față de modelul scump singur, cu un scor cu 10–12 puncte mai mic. Pe munca pe care o putea duce un singur model, același model la effort mai mic a fost mai ieftin de fiecare dată.
Măsurătorile au folosit Fable și Sonnet 5, la un raport de preț de 5×. Pentru workeri Haiku, la 40×, ghidul nu are încă date; calculul de mai jos e aritmetică pe ipoteze.
Când folosești Haiku 5.5 ca subagent în Claude Code
Un subagent Claude Code rulează în propria fereastră de context și întoarce doar un rezumat. Modelul lui se alege cu câmpul model din frontmatter. Exemplul din documentație, pentru .claude/agents/code-reviewer.md:
---
name: code-reviewer
description: Reviews code for quality and best practices
tools: Read, Glob, Grep
model: sonnet
---

You are a code reviewer. When invoked, analyze the code and provide
specific, actionable feedback on quality, security, and best practices.
model acceptă sonnet, opus, haiku, fable, un ID complet precum claude-opus-5-5, sau inherit; pentru Haiku, linia devine model: haiku.
- Fără
model, subagentul moștenește. Ordinea: parametrul dat de Claude la invocare, frontmatterul, variabilaCLAUDE_CODE_SUBAGENT_MODEL, modelul conversației. Pe o sesiune Opus, subagenții nesetați rulează pe Opus. - Aliasul
haikuînseamnă Haiku 5.5 doar pe Anthropic API, de la Claude Code v2.1.293. Pe Amazon Bedrock, Google Cloud, Microsoft Foundry și Claude Platform on AWS duce la Haiku 4.5; acolo scrii ID-ul complet. - Subagentul pornește cu context nou: promptul lui, mesajul de delegare, fișierele CLAUDE.md și starea git, fără istoricul conversației și fără cache-ul părintelui; își construiește unul propriu, de cinci minute.
- Controlul: câmpul
effortsetează nivelul pe subagent, iar/tasksarată modelul pe care rulează fiecare.
Oficial, pagina de costuri spune „For simple subagent tasks, specify model: haiku”, iar pagina de subagenți recomandă delegarea operațiilor cu mult output (teste, documentație, loguri) și un subagent Explore propriu, cu model: haiku, în locul celui încorporat, care rulează pe modelul conversației.
Definirea subagenților, permisiunile minime și riscurile paralelizării sunt un modul în Claude Code Mastery; cursul precedă Haiku 5.5. Diferența dintre skills, subagenți și hooks este în Agent Skills pentru cod, iar uneltele de cod puse alături, în Claude Code vs Cursor vs GitHub Copilot.
În API: advisor tool, Managed Agents, Agent SDK
- Advisor tool (beta): Haiku 5.5 e acceptat ca executor, cu Opus 5.5 ca advisor. În măsurătoarea Anthropic din 7 octombrie, fără un prompt care cere consultarea, Haiku nu l-a apelat la niciuna dintre cele 198 de întrebări GPQA Diamond, iar definiția uneltei a ridicat costul pe întrebare cu 12 %. Mecanica e în Sonnet 5.5 vs Opus 5.5 vs Fable 5.1.
- Claude Managed Agents (orchestrare multiagent, beta): un coordonator și cel mult 20 de agenți, fiecare cu modelul lui. Exemplul din documentație pune workeri
claude-haiku-4-5sub un coordonatorclaude-opus-5-5; ghidul de migrare spune că pentru Haiku 5.5 ajunge schimbarea numelui de model. - Agent SDK: câmpul
modelal unui subagent acceptă aceleași aliasuri sau un ID complet; vezi Claude Agent SDK în 2026.
Calcul de cost: aceeași sarcină pe Opus singur și orchestrată
Sarcina, ipotetică: aceeași modificare mecanică în 12 module independente, cu teste. Fiecare tură recitește din cache contextul de dinainte și scrie în cache tokenii noi, ca în ghidul Anthropic. Aritmetica e verificată cu un script; rezultatele sunt valabile doar la aceste ipoteze.
prefix P, g tokeni noi și o tokeni de ieșire pe tură, T ture
  scris  = P + g × (T − 1)
  citit  = (T − 1) × P + g × (T − 1) × (T − 2) / 2
  ieșire = o × T
- A. Opus singur, o sesiune: P = 30.000, g = 2.500, o = 600, 10 ture pe modul, deci T = 120.
- B. Orchestrat: Opus face 19 ture (șase de plan, cu 12 brief-uri de 400 de tokeni; una în care intră 12 rezumate de 1.500; 12 de verificare). Fiecare subagent Haiku: P = 12.000, T = 13, o = 800, cu g neschimbat; plusul de ture urmează plusul de 27 % la tokenii de ieșire măsurat de Artificial Analysis.
- C. Aceeași orchestrare, cu subagenți Opus: P = 12.000, T = 10, o = 600.
| Configurație | Tokeni citiți din cache | Cost |
|---|---|---|
| A. Opus singur, o sesiune | 21.122.500 | 7,30 $ |
| C. Orchestrat, subagenți Opus | 3.484.500 | 4,95 $ |
| B. Orchestrat, subagenți Haiku | 4.816.500 | 1,12 $ |
| din B: orchestratorul Opus | 1.108.500 | 0,96 $ |
| din B: cei 12 subagenți Haiku | 3.708.000 | 0,16 $ |
Între A și C, cu același model, izolarea contextului scade costul cu 32 %. Între C și B, schimbarea modelului pe subagenți duce totalul la 1,12 $. În B, orchestratorul face 86 % din factură: factura unei orchestrări cu Haiku este, practic, factura lui Opus, adică planul, rezumatele primite și verificarea.
Unde se strică economia
- Pragul de 100.000 de tokeni. Contextul duplicat e ieftin la tariful mic: 30.000 de tokeni comuni în fiecare subagent adaugă 0,09 $. Cu 90.000, promptul trece de prag la fiecare tură și subagenții costă 2,14 $ în loc de 0,16 $.
- Cache-ul nu se moștenește. Fiecare subagent își scrie prefixul: 0,018 $ pentru toți pe Haiku, 0,72 $ pe Opus.
- Ce se întoarce la orchestrator se scrie la prețul lui Opus și se recitește la fiecare tură. Cu 10.000 de tokeni de verificare pe modul în loc de 2.500, totalul crește cu 49 %.
- Rezultatele respinse. Un modul refăcut pe Opus adaugă 0,33 $. Riscul mai mare e verificarea care lasă să treacă un rezultat greșit.
Ce intră în brief și cât din rezultat se întoarce sunt decizii de context engineering; lecția despre izolare de context, sub-agenți și handoff din Context Engineering și Memorie pentru Agenți AI le tratează ca tipare, independent de model.
Ce nu dai lui Haiku 5.5 și ce nu merită dat lui Opus 5.5
| Rămâne pe Opus | Coboară pe Haiku |
|---|---|
| Agentic coding complex: 15 % față de 53 % pe Terminal-Bench 4.0 | Clasificare, extragere, rutare, rezumate, compaction |
| Planul, verificarea finală și ieșirile neverificabile automat | Explorare de cod, rulat teste, citit loguri, cu rezumat înapoi |
| Răspunsuri din cunoștințele modelului: acuratețe 34 % față de 65 % pe AA-Omniscience | Citit pe documente care încap în context: 77 % față de 84 % pe AA-LCR |
| Prompturi de peste 100.000 de tokeni, la volum: raportul scade la 8× | Întrebări cu răspuns verificabil: 85 % față de 91 % pe GPQA Diamond |
Cifrele sunt la medium, de la Artificial Analysis, cu excepția GPQA Diamond (Anthropic).
Capcane la trecerea muncii de la un model la altul
Între orchestrator și subagent circulă doar text; capcanele apar când aceeași conversație trece de pe un model pe altul.
- Cache separat pe model. Documentația Claude Code: „Each model has its own cache”. Un context de 80.000 de tokeni mutat de pe Haiku pe Opus se rescrie cu 0,40 $.
- Blocurile de thinking sunt legate de model. Potrivit paginii Preserved thinking, pe Claude API și Google Cloud, Opus 5.5 citește blocurile lui Haiku 5.5, deci escaladarea în sus păstrează raționamentul. Invers nu: blocurile lui Opus 5.5 le citesc doar Fable 5.1 și Mythos 5.1. API-ul le elimină în tăcere.
- Blocurile lui Haiku sunt legate și de cont, iar pe conturile create de la 31 august 2026 retrimiterea unui bloc după modificarea istoricului întoarce eroare 400.
- Aceeași cerere nu merge pe amândouă:
tool_choiceforțat șithinkingdezactivat trec pe Haiku și întorc 400 pe Opus.
Haiku vs Opus în abonament: ce consumă fiecare
Documentația Claude Code spune că cererile subagenților se scad din aceleași limite ca și conversația principală, că limitele de sesiune și săptămânale sunt comune tuturor modelelor și că există o limită pe familia Opus, după care poți continua pe alt model. Un raport de consum între modele nu este publicat; /usage arată ce parte din consum vine de la subagenți.
Cinci situații concrete și decizia
- Refactor într-un lanț de pași dependenți. Opus singur; reglezi effort-ul, nu orchestrezi.
- Aceeași modificare în zeci de module independente, cu teste. Opus planifică și verifică, subagenți Haiku execută.
- Audit pe un corpus mai mare decât fereastra de context. Orchestrare, cu un scor ceva mai mic.
- Triere, clasificare, extragere la volum. Haiku singur, prin Batch dacă nu așteaptă nimeni, cu un eșantion verificat.
- Asistent interactiv. Haiku la
lowsaumedium; lamax, timpul de generare pe sarcină depășește de cinci ori Opus lalow.
Lista de verificare:
- Baza de comparație e Opus singur, la două niveluri de effort.
- Munca se împarte în bucăți independente.
-
model: haikue scris explicit, iar promptul fiecărui subagent rămâne sub 100.000 de tokeni. - Brief-ul e complet, înapoi vine un rezumat, iar verificarea e automată.
Setul de sarcini și regula de notare sunt în cum evaluezi un model AI înainte de producție.
Întrebări frecvente
Claude Haiku 5.5 sau Opus 5.5: care este mai bun?
Opus, la orice nivel de effort: la Artificial Analysis are 51,2 față de 34,5 la medium. Haiku costă însă de 23–28 de ori mai puțin pe sarcină, iar Anthropic le recomandă împreună.
Cât costă Haiku 5.5 față de Opus 5.5? La listă, 0,10 $ / 0,50 $ față de 4 $ / 20 $ pe milionul de tokeni, de 40 de ori mai puțin, cât timp promptul are cel mult 100.000 de tokeni. Peste prag, raportul scade la 8×.
Este Haiku 5.5 bun pentru cod, comparat cu Opus 5.5? Ca agent principal pe sarcini complexe, nu: pe Terminal-Bench 4.0 la Artificial Analysis are 15 % față de 53 %. Ca subagent pe sarcini înguste și verificabile, da.
Consumă Haiku mai puțin din abonament decât Opus? Documentația Claude Code nu publică un raport de consum între modele; spune că subagenții intră în aceleași limite ca și conversația principală.
Cum folosesc Haiku 5.5 ca subagent în Claude Code?
Scrii model: haiku în frontmatterul fișierului din .claude/agents/; în afara Anthropic API scrii ID-ul complet.
Concluzie
Între Claude Haiku 5.5 și Opus 5.5, diferența de preț cumpără 13–17 puncte de indice și, la effort-ul implicit, de peste trei ori mai multe sarcini rezolvate pe Terminal-Bench 4.0; cumpără puțin la clasificare, extragere sau citit pe documente. La ipotezele de aici, o orchestrare cu subagenți Haiku costă 1,12 $ față de 7,30 $, iar 86 % din rest e orchestratorul. Economia se pierde la prompturi de subagent peste prag, la rezultate prea mari întoarse la Opus și la o verificare care nu prinde eșecurile.
Surse
- Anthropic: Introducing Claude Haiku 5.5
- Anthropic Docs: Pricing
- Anthropic Docs: Optimizing for cost and intelligence
- Anthropic Docs: Preserved thinking
- Claude Code Docs: Create custom subagents
- Artificial Analysis: Claude Haiku 5.5 vs Claude Opus 5.5
Articol redactat la 8 octombrie 2026. Calculele de cost folosesc tarife de listă și volume de tokeni ipotetice, nu măsurători. Cursuri-AI.ro este furnizor de cursuri plătite, deci parte interesată.

Cursul care continuă acest articol
AI Agents: Arhitectura și Automatizarea Sistemelor Autonome
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Agenților AI Autonomi
- Memoria, Starea și Raționamentul Avansat
- Framework-uri și SDK-uri pentru Agenți AI
- Model Context Protocol (MCP) și Interoperabilitate
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.