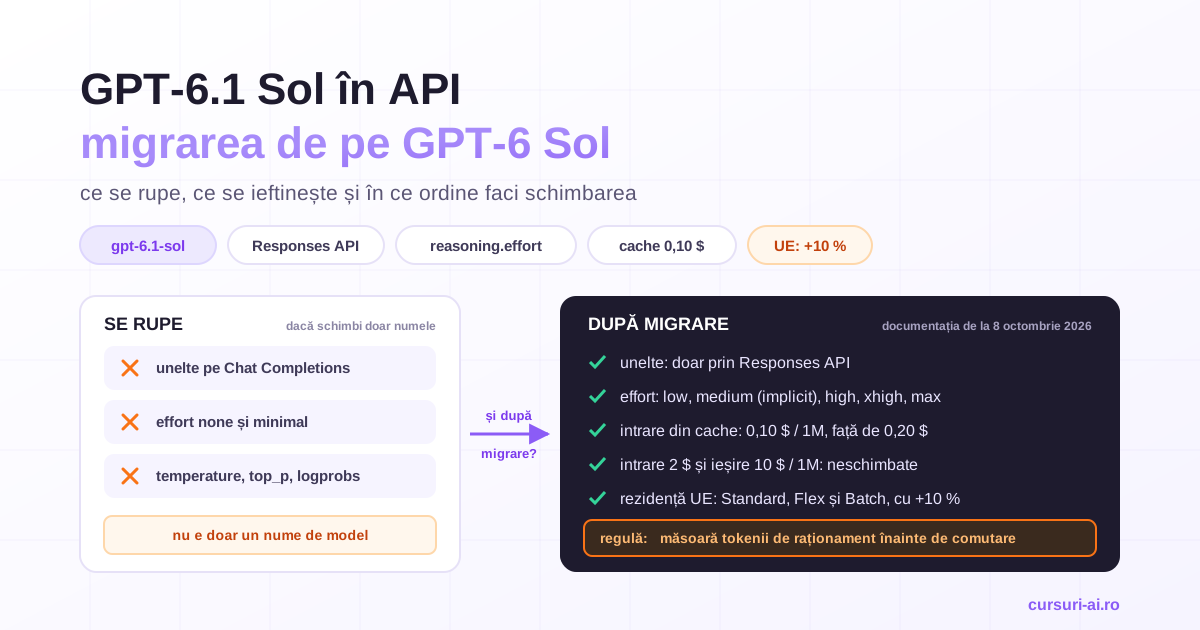
GPT-6.1 Sol API înseamnă un identificator nou, gpt-6.1-sol, disponibil din 29 septembrie 2026 pe Responses API, Chat Completions și Batch, la același preț de intrare și de ieșire ca gpt-6-sol. Trecerea la GPT-6.1 Sol API nu se face însă schimbând doar numele modelului: uneltele nu mai merg pe Chat Completions, reasoning.effort nu mai acceptă none, iar intrarea citită din cache costă jumătate. Ghidul arată ce se rupe, ce se ieftinește și în ce ordine faci schimbarea, pe documentația OpenAI citită la 8 octombrie 2026.
| Pe scurt | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Unelte (function calling) | Responses API; pe Chat Completions doar cu effort none |
doar Responses API |
reasoning.effort |
de la none la max |
de la low la max |
| Intrare, din cache, ieșire (per 1M tokeni) | 2 $, 0,20 $, 10 $ | 2 $, 0,10 $, 10 $ |
| Stare la 8 octombrie 2026 | activ, fără dată de retragere | activ, lansat la 29 septembrie |
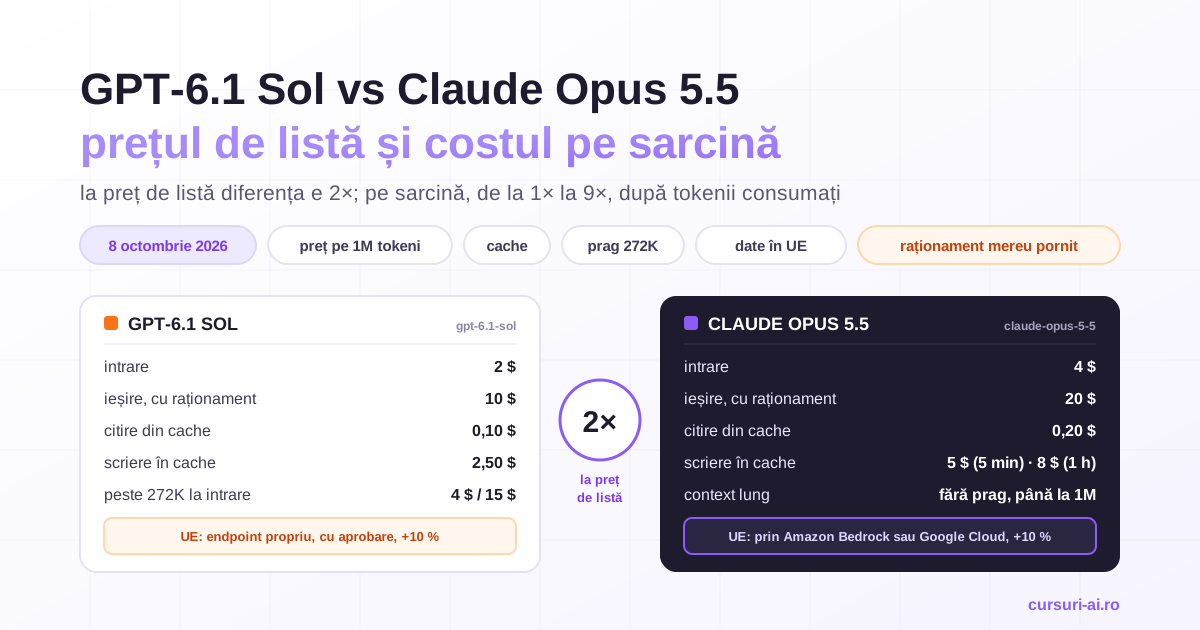
Ce este modelul și ce a anunțat OpenAI la lansare se află în analiza GPT-6.1 Sol, iar alegerea între furnizori în comparația GPT-6.1 Sol vs Claude Opus 5.5. Aici rămâne doar diferența față de gpt-6-sol, în API.
GPT-6.1 Sol API: ce se rupe dacă schimbi doar numele modelului
Fereastra de context (1.050.000 de tokeni), endpoint-urile și uneltele găzduite sunt identice pe cele două fișe de model. Trei lucruri opresc însă o cerere care mergea pe gpt-6-sol: două sunt scrise explicit în documentație, al treilea decurge din ele.
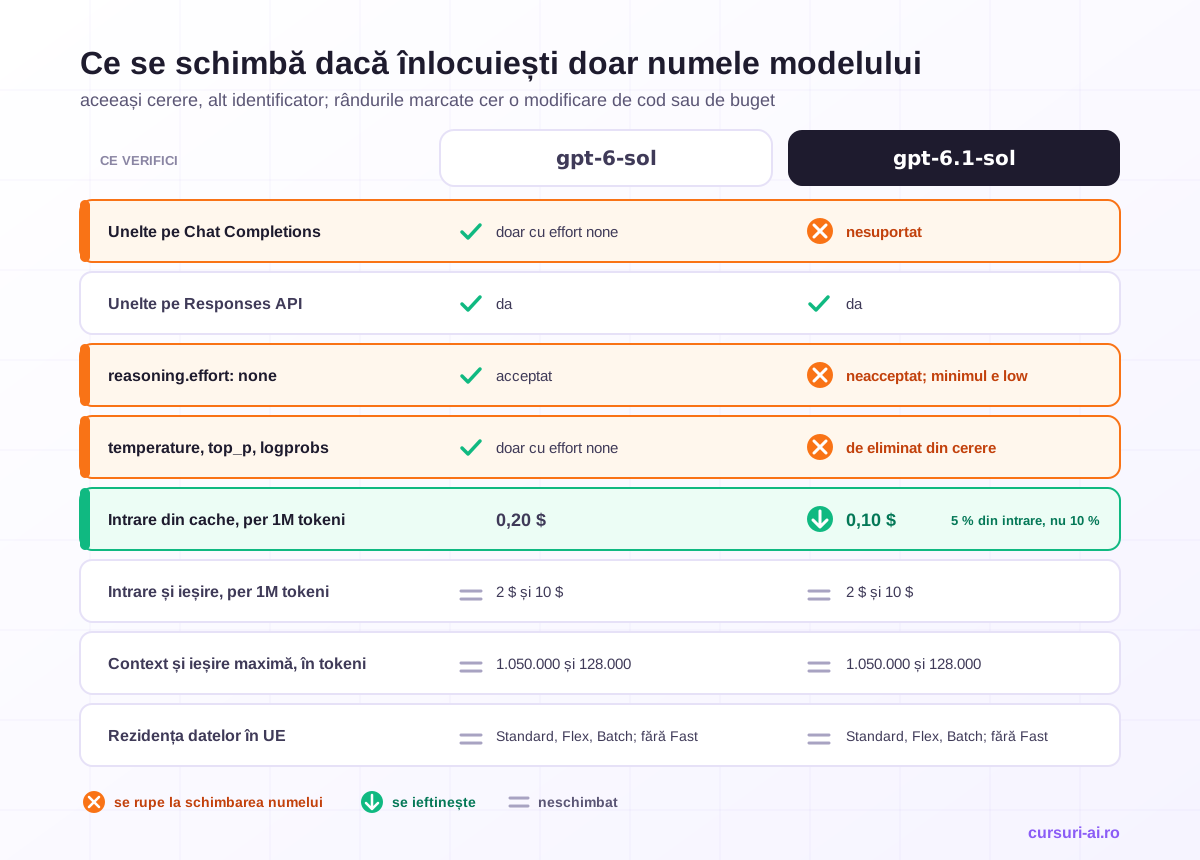
1. Uneltele pe Chat Completions. Fișa modelului spune: „Use the Responses API for tool calling. Chat Completions is supported without tool calling.” Pe gpt-6-sol, Chat Completions accepta function calling numai cu reasoning_effort pe none. Pe gpt-6.1-sol, none nu mai există, deci calea dispare. Ce primești dacă trimiți totuși tools pe Chat Completions nu este documentat: nici cod de stare, nici mesaj de eroare.
2. reasoning.effort pe none. Fișa listează low, medium (implicit), high, xhigh și max și adaugă că none și minimal nu sunt suportate. Pentru GPT-6 Astra, ghidul de raționament precizează că none întoarce HTTP 400; pentru GPT-6.1 Sol, același paragraf spune doar că valorile nu sunt suportate, fără cod de stare. minimal vine din familia GPT-5; nici gpt-6-sol nu îl avea în listă.
3. temperature, top_p și logprobs. Ghidul de migrare cere ca, atunci când effort nu este none, să elimini temperature, top_p și top_logprobs, plus logprobs pe Chat Completions. Pe gpt-6.1-sol effort nu poate fi none, deci regula se aplică fiecărei cereri. Deducția este a noastră.
Tool calling pe GPT-6.1 Sol: de pe Chat Completions pe Responses API
Mutarea schimbă forma apelului, nu proiectarea uneltelor. Schema JSON, validarea argumentelor și principiul că modelul propune, iar aplicația decide rămân aceleași. Ele sunt materia modulului „Function Calling și Tool Use” din cursul Integrare Avansată LLM în Aplicații de Producție, ale cărui exemple OpenAI rulează pe Chat Completions cu gpt-6-sol și effort none, formă care rămâne validă pe acel model. Bucla pe Responses API nu apare acolo ca exemplu: o găsești mai jos.
Ambele fragmente pornesc de la exemplul din ghidul oficial de function calling, cu altă funcție și cu alt model. Înainte, pe Chat Completions:
import json
from openai import OpenAI

client = OpenAI()

tools = [
    {
        "type": "function",
        "function": {
            "name": "stoc_produs",
            "description": "Întoarce stocul curent pentru un cod de produs.",
            "parameters": {
                "type": "object",
                "properties": {"cod": {"type": "string"}},
                "required": ["cod"],
            },
        },
    },
]


def stoc_produs(cod: str) -> str:
    return f"{cod}: 14 bucăți în depozit."


messages = [{"role": "user", "content": "Mai avem pe stoc produsul SKU-4471?"}]

response = client.chat.completions.create(
    model="gpt-6-sol",
    reasoning_effort="none",  # pe gpt-6-sol, uneltele merg aici doar cu none
    messages=messages,
    tools=tools,
)
messages.append(response.choices[0].message)

for tool_call in response.choices[0].message.tool_calls or []:
    args = json.loads(tool_call.function.arguments)
    messages.append(
        {"role": "tool", "tool_call_id": tool_call.id, "content": stoc_produs(**args)}
    )
# urmează al doilea apel, identic, cu messages completat
După, pe Responses API, cu aceeași funcție stoc_produs:
# definiție plată: conținutul sub-obiectului "function" urcă lângă "type"
tools = [{"type": "function", **t["function"]} for t in tools]

input_list = [{"role": "user", "content": "Mai avem pe stoc produsul SKU-4471?"}]

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},
    tools=tools,
    input=input_list,
)
input_list += response.output  # tot ce a întors modelul, cu itemii de raționament

for item in response.output:
    if item.type == "function_call":
        args = json.loads(item.arguments)
        input_list.append(
            {
                "type": "function_call_output",
                "call_id": item.call_id,
                "output": stoc_produs(**args),
            }
        )

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "low"},
    tools=tools,
    input=input_list,
)
print(response.output_text)
Patru diferențe produc erori dacă le tratezi mecanic:
- Definiția uneltei este plată.
name,descriptionșiparametersstau lângătype. strictare alt implicit. Pe Chat Completions funcțiile sunt non-stricte. Pe Responses, fărăstrict, API-ul încearcă modul strict și revine la non-strict dacă schema nu e compatibilă.- Apelul și rezultatul sunt Items separate, legate prin
call_id. Mesajul curole: "tool"dispare, iar textul final se citește dinresponse.output_text. - Itemii de raționament se trimit înapoi. Ghidul de raționament recomandă să retrimiți neatins tot ce se află între ultimul mesaj al utilizatorului și rezultatul funcției.
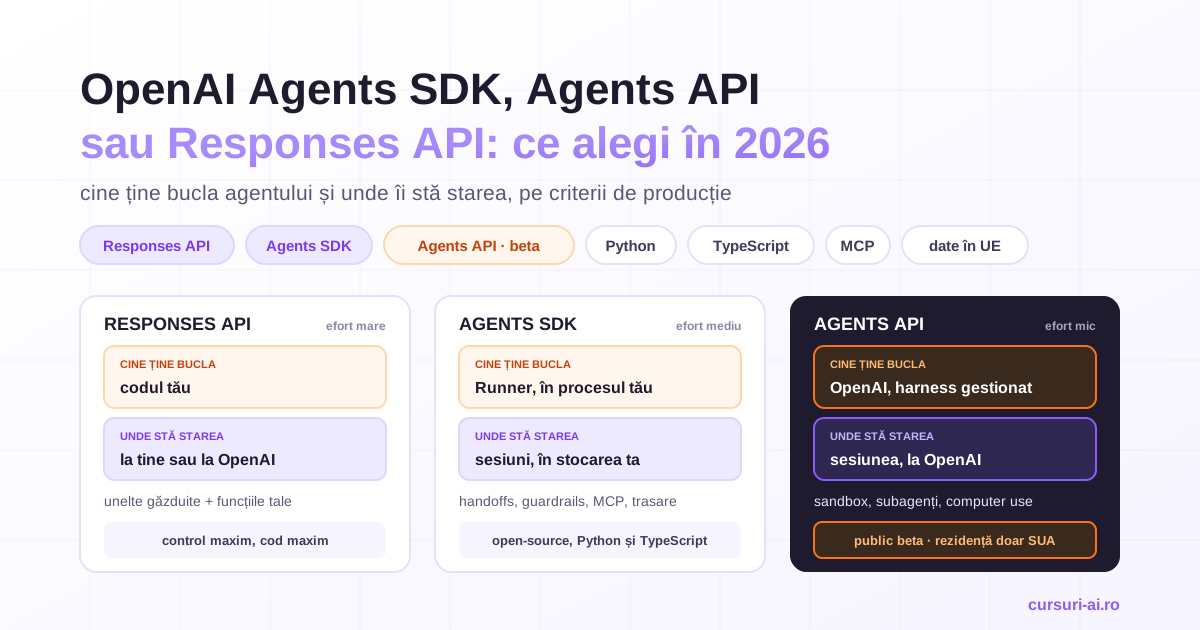
Bucla completă, cu limită de pași, este în ghidul Agents SDK, Agents API sau Responses API.
reasoning.effort pe GPT-6.1 Sol: fără none și fără minimal
Scala de la none la max este explicată în ghidul de migrare pe GPT-6 Sol și Luna. La 6.1 diferă capătul de jos. Implicitul rămâne medium, deci cererile fără parametru nu se schimbă. Unde setai none, ghidul de migrare spune să treci pe low și să compari pe sarcini reprezentative:
tichet = "Clasifică tichetul: «Nu pot descărca factura din cont.»"

# înainte, pe gpt-6-sol
response = client.responses.create(
    model="gpt-6-sol", reasoning={"effort": "none"}, input=tichet
)

# după, pe gpt-6.1-sol: treapta cea mai joasă acceptată este low
response = client.responses.create(
    model="gpt-6.1-sol", reasoning={"effort": "low"}, input=tichet
)
print(response.usage.output_tokens_details.reasoning_tokens)
Forma parametrului este cea din ghidul de raționament. Trei detalii din același ghid:
- Chat Completions fără unelte rămâne valid, cu parametrul plat:
reasoning_effort="low". - Effort se poate schimba între răspunsuri fără să strici prefixul din cache, cu un item
configuration_updateîninput. Merge doar în modul standard, cu un singur agent. - Raționamentul persistat se refolosește numai în aceeași familie de modele. Documentația nu spune dacă
gpt-6-solșigpt-6.1-solsunt aceeași familie, deci nu comuta modelul în mijlocul unei conversații.
Ghidul oficial de migrare pe GPT-6.1 Sol, pas cu pas
Secțiunea „Migration quickstart” din ghidul familiei GPT-6 începe cu o comandă pentru Codex, bazată pe skill-ul OpenAI Docs: $openai-docs migrate this project to the GPT-6 model family. Urmează lista, în ordinea din ghid:
- Modelul. Setezi
modelpegpt-6-astra,gpt-6.1-solsaugpt-6-luna. - Reasoning effort. Păstrezi effort-ul de acum, unde este suportat. Astra și GPT-6.1 Sol nu acceptă
none: foloseștilow, la fel ca atunci când vii de peminimal. - Tool calling. Astra și GPT-6.1 Sol suportă Chat Completions, dar tool calling cere Responses API.
- Parametri nesuportați. Cu effort diferit de
none, eliminitemperature,top_pși variantele de logprobs. - Rezidența datelor. Fast mode nu este disponibil cu rezidență în UE; Ultrafast mode merge doar cu rezidență în SUA și cu procesare globală.
- Schimbarea effort-ului. Între răspunsuri folosești
configuration_update. - Prompt caching.
prompt_cache_retentiondevineprompt_cache_options.ttldoar dacă vii de pe GPT-5.5 sau mai vechi; de pegpt-6-solnu schimbi nimic. - Pauze de aprobare. Dacă modelul cere confirmări prea des, ghidul oferă prompturi pentru execuție autonomă.
De reținut: pasul 1 nu mai numește gpt-6-sol printre ținte.
Prețul GPT-6.1 Sol în API: cache la 0,10 $ și trei calcule
Mecanismul de cache este descris în ghidul despre GPT-6 Sol și Luna citat mai sus. La 6.1 se schimbă o singură cifră: citirea din cache costă 5 % din tariful de intrare, nu 10 %. Tarifele standard de pe pagina de prețuri, per 1M tokeni, la 8 octombrie 2026:
| Tokeni de intrare în cerere | Intrare | Din cache, gpt-6-sol |
Din cache, gpt-6.1-sol |
Scriere în cache | Ieșire |
|---|---|---|---|---|---|
| până la 272.000 | 2,00 $ | 0,20 $ | 0,10 $ | 2,50 $ | 10,00 $ |
| peste 272.000 | 4,00 $ | 0,40 $ | 0,20 $ | 5,00 $ | 15,00 $ |
Batch și Flex costă jumătate din aceste tarife, Fast dublul lor. Tokenii de raționament nu apar în răspuns, dar, potrivit ghidului de raționament, „are billed as output tokens”. De aici vine riscul migrării: un token de raționament în plus anulează economia de la 100 de tokeni citiți din cache.
Trei calcule, la tarif standard:
- Asistent cu prefix cache-uit. Ipoteze: 800.000 de cereri pe lună; la fiecare, 8.000 de tokeni citiți din cache, 1.000 de tokeni noi și 400 de ieșire, la fel pe ambele modele.
- Agent de cod cu context mare. Ipoteze: 150 de pași; la fiecare, 250.000 de tokeni citiți din cache, 10.000 de tokeni noi scriși în cache și 2.000 de ieșire.
- Asistentul din calculul 1, cu raționament în plus. Ipoteze: pe
gpt-6-solrula cu effortnone; pegpt-6.1-sol, culow, apar în medie 300 de tokeni de raționament pe cerere. Cifra este o ipoteză, nu o măsurătoare.
| Calcul | gpt-6-sol |
gpt-6.1-sol |
Diferență |
|---|---|---|---|
| 1. Asistent, pe lună | 0,0076 $ pe cerere, 6.080 $ | 0,0068 $ pe cerere, 5.440 $ | −10,5 % |
| 2. Agent, pe sesiune | 0,095 $ pe pas, 14,25 $ | 0,070 $ pe pas, 10,50 $ | −26,3 % |
3. Asistent cu low, pe lună |
0,0076 $ pe cerere, 6.080 $ | 0,0098 $ pe cerere, 7.840 $ | +28,9 % |
În calculul 1, cache-ul era doar 21 % din factură, deci înjumătățirea lui se vede puțin. În calculul 2, economia de 0,025 $ pe pas acoperă 2.500 de tokeni de raționament în plus. În calculul 3, pragul de echilibru este de 80 de tokeni de raționament pe cerere. La o clasificare în Batch fără cache (5.000.000 de documente, 1.500 de tokeni de intrare, 50 de ieșire) nu ai ce economisi: 200 de tokeni de raționament în plus pe document duc totalul de la 8.750 $ la 13.750 $.
Documentația nu publică un consum de raționament pe treaptă; spune doar că poate merge de la câteva sute la zeci de mii de tokeni. Cifra ta se citește din usage. Dacă folosești funcția calculate_input_cost din ghidul de prompt caching, treci cache_input_multiplier=0.05 pentru gpt-6.1-sol.
Cât din intrare ajunge să fie citit din cache ține de structura promptului, nu de model. Stratul stabil al contextului și economia de tokeni cu prompt caching sunt lecții din cursul Context Engineering și Memorie pentru Agenți AI. Imediat după comutare cache-ul este rece, iar primele cereri plătesc scrierea.
Latența fără none: ce pierzi și ce alternative documentează OpenAI
Ghidul de raționament descrie none ca treapta pentru sarcini critice ca latență: voce, regăsire rapidă de informație, clasificare. Despre low spune că aduce o creștere modestă de latență. Cifre pe treaptă nu există în documentație, deci le măsori pe cererile tale. Alternativele documentate:
- Rămâi pe
gpt-6-solcunonepentru fluxurile acelea. gpt-6-luna, care acceptănoneși este prezentat ca modelul cel mai rapid și mai ieftin al familiei.- Fast mode, cu
service_tier="fast", descris în ghidul lui ca „up to 2.5× faster”, la dublul tarifului. Dacă traficul crește prea repede, unele cereri sunt procesate și facturate standard. - Un preambul scurt, cerut modelului înaintea raționamentului lung, pentru un prim token vizibil mai rapid.
Ultrafast mode nu există pentru GPT-6.1 Sol: este disponibil pentru GPT-6 Astra, al cărui cost este analizat în ghidul GPT-6 Astra în API.
Multi-agent în Responses API: ce este și ce limite are în beta
Jurnalul de modificări din 29 septembrie notează că GPT-6.1 Sol suportă Multi-agent în beta: într-o singură cerere, modelul pornește subagenți care lucrează în paralel, fiecare cu contextul lui, și le sintetizează rezultatele. Îl activezi cu multi_agent.enabled, prin client.beta.responses și beta-ul responses_multi_agent=v1. Ghidul îl listează pentru GPT-6.1 Sol și pentru modelele GPT-5.6; gpt-6-sol nu apare în enumerare.
Limitele documentate: max_concurrent_subagents este implicit 3; compactarea automată se activează implicit, iar /responses/compact nu este suportat; reasoning.summary și max_tool_calls nu sunt suportate; schemele itemilor se pot schimba cât timp funcția e în beta. Nu-l folosești când pașii depind strict unul de altul, când agenții ar scrie în aceeași stare sau când ai nevoie de un graf de execuție fix.
Rezidența datelor în UE pentru GPT-6.1 Sol: ce merge și ce nu
România intră în regiunea „Europe (EEA + Switzerland)” din ghidul despre controlul datelor. La 8 octombrie 2026, pentru gpt-6.1-sol:
- Merge: stocare și procesare regională pe endpoint-urile Responses, Chat Completions și Batch, în modurile Standard, Flex și Batch. Cererile se trimit către
eu.api.openai.com, de exemplu cuclient.with_options(base_url="https://eu.api.openai.com/v1"). - Nu merge: Fast mode.
- Costă: un adaos de 10 % pe endpoint-urile regionale, pentru modelele lansate începând cu 5 martie 2026. Peste tarifele standard, asta înseamnă 2,20 $ la intrare, 0,11 $ din cache și 11 $ la ieșire, per 1M tokeni.
- Cere: eligibilitate stabilită cu echipa de vânzări, aprobare pentru un control de retenție (de exemplu Zero Data Retention) și un amendament contractual.
Rezidența acoperă conținutul clientului, nu și datele de sistem. Acestea sunt fapte de documentație, nu o analiză juridică.
Lista de verificare a migrării de pe gpt-6-sol pe gpt-6.1-sol
În ordinea în care o greșeală costă cel mai puțin:
- Inventarul. Cauți
gpt-6-sol,reasoning_effort,"effort",temperature,top_p,logprobsși apelurilechat.completionscutools. Procesul general este în ghidul de migrare la retragerea unui model. - Referința. Pe
gpt-6-solmăsori rata de reușită, latența, tokenii pe categorii și costul pe sarcină reușită. - Endpoint-ul înaintea modelului. Muți fluxurile cu unelte pe Responses API cât ești încă pe
gpt-6-sol, care suportă și el această cale. Dacă ceva se strică, știi că e endpoint-ul. - Parametrii. Scoți
temperature,top_pși logprobs; mapezinonepelow. - Spațiul pentru raționament. Un
max_output_tokensdimensionat pentru effortnonese mărește: la limită, răspunsul vineincompleteși plătit. - Comutarea treptată. Schimbi identificatorul pe o parte mică din trafic și urmărești
cached_tokensșicache_write_tokens. - Costul. Alertele de buget urmăresc separat tokenii de raționament.
- Decizia și întoarcerea. Compari cu referința de la pasul 2;
gpt-6-solrămâne în comutator.
Pachetul openai era la versiunea 3.26.0 pe PyPI la 8 octombrie 2026 și cere Python 3.10 sau mai nou. Dacă abia scrii prima integrare, drumul de la primul apel la bucla de unelte, pe Chat Completions cu gpt-6-sol, este cel din cursul Construire de Aplicații AI cu Python și SDK-uri, rezumat în ghidul de la API la produs.
Când NU migrezi încă pe GPT-6.1 Sol
- Sarcini scurte pe effort
none, fără cache: clasificare, extragere, rutare. Pierzinoneși nu ai ce câștiga din cache. - Fluxuri în care latența depinde de
noneși nu ai încă măsurători pelow. - Chat Completions cu unelte pe care nu-l poți rescrie acum, de pildă printr-o bibliotecă terță.
- Dependență de
temperature,top_psau logprobs, de exemplu scoruri de încredere calculate din logprobs. - Nicio suită de evaluare. Fără cifra de dinainte, cea de după nu spune nimic.
- Multi-agent ca unic motiv. Este în beta, cu scheme care se pot schimba.
Ce se întâmplă cu gpt-6-sol: depreciere și dată de retragere
La 8 octombrie 2026, pagina de deprecări din documentația OpenAI nu listează gpt-6-sol nici ca depreciat, nici cu dată de retragere. Identificatorul apare într-un singur loc: ca înlocuitor recomandat pentru gpt-5.3-codex și gpt-5.1, în anunțul din 1 octombrie 2026, la două zile după lansarea lui GPT-6.1 Sol. Fișa lui este activă și trimite la GPT-6.1 Sol drept „the newer Sol model”.
Politica de pe aceeași pagină promite cel puțin șase luni de preaviz pentru modelele disponibile general. Totuși, catalogul de modele și ghidul familiei pun în prim-plan Astra, GPT-6.1 Sol și Luna. gpt-6-sol este suportat, nu promovat.
Întrebări frecvente
Ce este gpt-6.1-sol și cu ce diferă de gpt-6-sol în API?
Este identificatorul din API al lui GPT-6.1 Sol, lansat la 29 septembrie 2026. Față de gpt-6-sol cere Responses API pentru tool calling, nu acceptă effort none și taxează intrarea din cache cu 0,10 $ per 1M tokeni în loc de 0,20 $.
Merge GPT-6.1 Sol pe Chat Completions? Da, fără unelte. Pentru function calling folosești Responses API.
Ce valori acceptă reasoning.effort pe GPT-6.1 Sol?
low, medium (implicit), high, xhigh și max. none și minimal nu sunt suportate; ghidul de migrare recomandă low în locul lor.
Cât costă GPT-6.1 Sol în API și cât costă intrarea din cache? La tarif standard, până la 272.000 de tokeni de intrare: 2 $ la intrare, 0,10 $ din cache, 2,50 $ la scrierea în cache și 10 $ la ieșire, per 1M tokeni. Tokenii de raționament se facturează ca ieșire.
Pot procesa date în UE cu GPT-6.1 Sol?
Da, dacă organizația are rezidența datelor aprobată: Standard, Flex și Batch, prin eu.api.openai.com, cu un adaos de 10 %. Fast mode nu este disponibil.
Este GPT-6 Sol depreciat după lansarea lui GPT-6.1 Sol? Nu. La 8 octombrie 2026, pagina de deprecări nu îl listează și nu există o dată de retragere.
Concluzie
Migrarea de pe gpt-6-sol pe gpt-6.1-sol se reduce la trei modificări de cod și un calcul. Uneltele se mută pe Responses API, none devine low, iar temperature, top_p și logprobs ies din cereri. Calculul compară 0,10 $ câștigați la un milion de tokeni citiți din cache cu 10 $ plătiți la un milion de tokeni de raționament în plus. Agenții cu context mare servit din cache ies în câștig; clasificările scurte pe effort none ies în pierdere și pot rămâne pe gpt-6-sol. Ordinea sigură: endpoint-ul înaintea modelului, măsurătoarea înaintea comutării.
Surse
Toate sursele au fost citite la 8 octombrie 2026.
- OpenAI: fișa modelului GPT-6.1 Sol
- OpenAI: Using GPT-6, cu „Migration quickstart”
- OpenAI: Function calling
- OpenAI: Reasoning models
- OpenAI: Data controls in the OpenAI platform
- OpenAI: Deprecations
Consultate și: pagina de prețuri, fișa GPT-6 Sol, jurnalul de modificări, ghidurile Migrate to the Responses API, Prompt caching, Fast mode și Multi-agent, PyPI.
Articol redactat la 8 octombrie 2026; prețurile și parametrii se pot schimba. Calculele de cost sunt exemple cu ipoteze declarate, nu măsurători. Exemplele de cod au fost rulate local pe SDK-ul openai 3.26.0, pe un transport HTTP simulat; niciunul nu a fost rulat pe API-ul real. Cursuri-AI.ro este furnizor de cursuri plătite, deci parte interesată.

Cursul care continuă acest articol
Integrare Avansată LLM în Aplicații de Producție
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamentele Integrării LLM în 2026
- Streaming și Error Handling
- Function Calling și Tool Use
- Model Context Protocol (MCP)
+ încă 5 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.