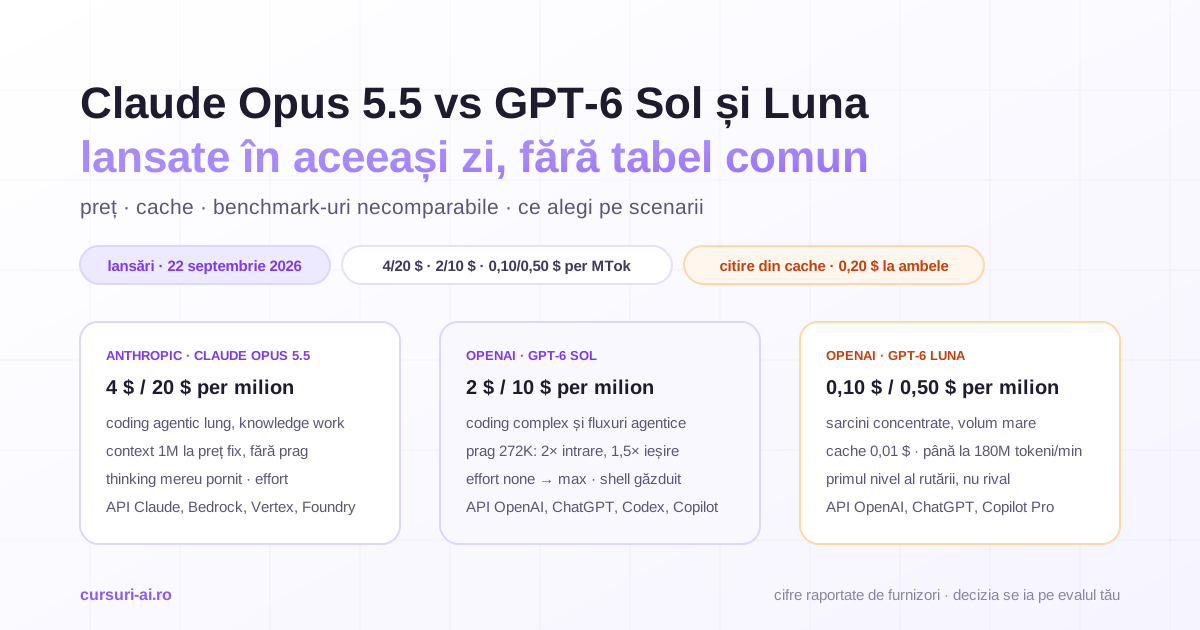
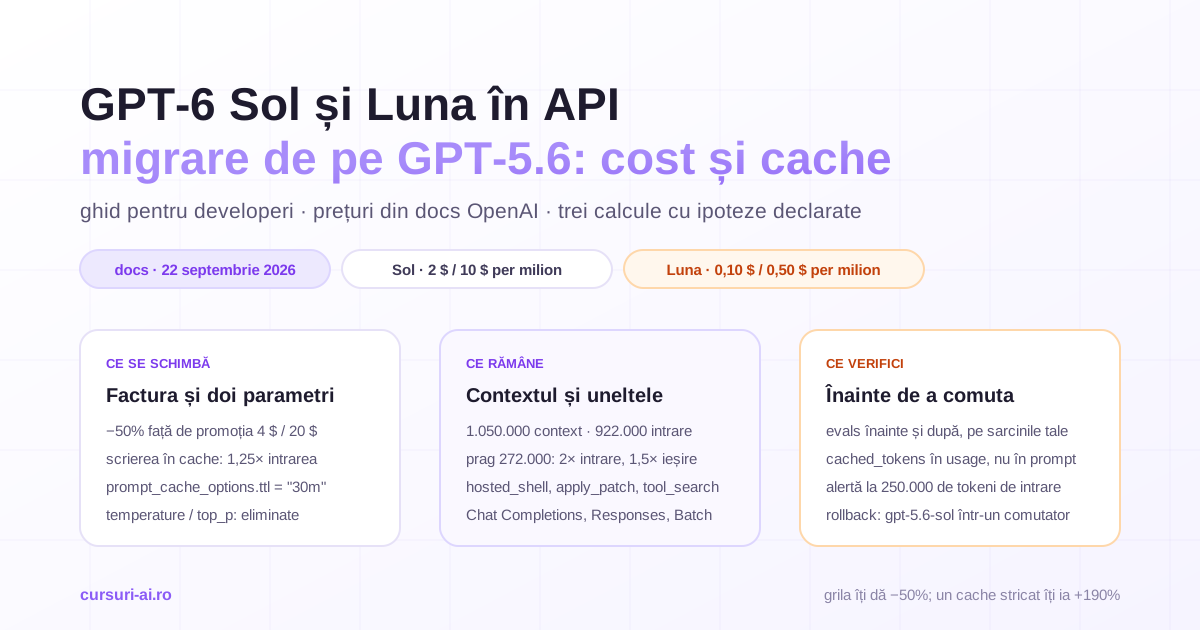
GPT-6 Sol API și GPT-6 Luna au apărut în documentația OpenAI pe 22 septembrie 2026, la 19 zile după GPT-6 Astra, cu o singură promisiune care contează pentru cine are aplicații în producție: același context și aceleași unelte ca GPT-5.6, la jumătate din prețul promoțional actual. Ghidul de față nu discută benchmark-uri; discută ce primești exact, cât te costă pe trei sarcini tipice cu ipotezele scrise, ce parametri îți pică la migrare și cum verifici că economia din grilă ajunge pe factura ta.
Ce primești exact cu GPT-6 Sol și GPT-6 Luna
Fișele celor două modele din documentația OpenAI pentru dezvoltatori, consultate la 23 septembrie 2026:
| Specificație | gpt-6-sol |
gpt-6-luna |
|---|---|---|
| Snapshot | gpt-6-sol (același nume) |
gpt-6-luna (același nume) |
| Fereastra de context | 1.050.000 de tokeni | 1.050.000 de tokeni |
| Intrare maximă | 922.000 de tokeni | 922.000 de tokeni |
| Ieșire maximă | 128.000 de tokeni | 128.000 de tokeni |
| Cunoștințe până la | 20 aprilie 2026 | 18 mai 2026 |
| Modalități | text și imagini la intrare, text la ieșire | la fel |
reasoning.effort |
none, low, medium (implicit), high, xhigh, max |
la fel |
| Endpoint-uri | Chat Completions, Responses, Batch | la fel |
| Unelte găzduite | web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP, tool search | la fel |
Patru lucruri din tabel devin pași de migrare:
- Nu există snapshot datat. Identificatorul e și snapshot-ul; fixezi
gpt-6-solși te bazezi pe politica de deprecare (mai jos). - Endpoint-urile lipsă sunt explicite. Fișele listează ca nesuportate Realtime (inclusiv translation și transcription), Live, Assistants, fine-tuning, embeddings, generare de imagini și de clipuri, speech, moderation și Completions (legacy). Dacă ai voce în timp real pe Astra, Sol nu e înlocuitorul ei.
- Uneltele nu s-au schimbat față de GPT-5.6. Fișa lui
gpt-5.6-sollistează aceleași unelte:hosted_shell,apply_patch,tool_search,skills,computer_use,mcpexistau deja. Nu rescrii definițiile, doar le retestezi. - Cutoff-ul diferă: Luna (18 mai) e mai recent decât Sol (20 aprilie).
Cum citești o fișă de model, cum bugetezi tokenii, cum tratezi usage și erorile — toate sunt materia primului sfert din cursul Construire de Aplicații AI cu Python și SDK-uri, care pornește de la primul apel și ajunge la un produs cu cost, retry și logging.
Grila de prețuri: Sol, Luna și reperul GPT-5.6
Toate valorile sunt în dolari per milion de tokeni, din pagina de prețuri OpenAI și din fișele modelelor, la 23 septembrie 2026.
| Model | Intrare | Intrare din cache | Scriere în cache | Ieșire |
|---|---|---|---|---|
gpt-6-sol |
2,00 $ | 0,20 $ | 2,50 $ | 10,00 $ |
gpt-6-luna |
0,10 $ | 0,01 $ | 0,125 $ | 0,50 $ |
gpt-6-astra (reper) |
10,00 $ | 1,00 $ | 12,50 $ | 50,00 $ |
gpt-5.6-sol (promoțional) |
4,00 $ | 0,40 $ | 5,00 $ | 20,00 $ |
gpt-5.6-terra |
2,00 $ | 0,20 $ | 2,50 $ | 12,00 $ |
gpt-5.6-luna |
0,20 $ | 0,02 $ | 0,25 $ | 1,20 $ |
Regulile de peste tabel, pentru Sol și Luna:
- Pragul de 272.000 de tokeni de intrare. Peste el se aplică 2× la intrare, la intrarea din cache și la scrierea în cache, și 1,5× la ieșire, pentru toată cererea, nu doar pentru ce depășește pragul. Mecanica e aceeași ca la Astra și e explicată în ghidul despre GPT-6 Astra în API; aici o vezi în cifre în calculul al treilea.
- Batch și Flex: 50% din tariful standard. Batch e asincron, cu fereastră de 24 de ore; Flex e sincron, mai lent, cu erori 429 când nu există capacitate (ghidul Flex, la Surse, recomandă timeout de 15 minute).
- Fast mode: 2× tarifele aplicabile. Procesare regională: +10%.
„Jumătate de preț” — față de ce, exact
TechCrunch citează OpenAI: seria 6 e „la jumătate din costul seriei 5.6 pentru Sol și Luna”. Cifrele din docs sunt mai nuanțate:
- Sol: −50% la intrare și la ieșire, dar față de prețul promoțional de 4 $ / 20 $, pe care fișa lui
gpt-5.6-solîl marchează valabil „cel puțin până la 21 noiembrie 2026”. Față de prețul de listă de la lansarea din iulie — 5 $ / 30 $, consemnat în analiza GPT-5.6 — reducerea e de 60% la intrare și 67% la ieșire. Bugetul aprobat pe cifra de listă are mai mult spațiu decât spune titlul; cel aprobat pe promoție, exact jumătate. - Luna: −50% la intrare (0,20 → 0,10 $) și −58% la ieșire (1,20 → 0,50 $).
- Terra nu are echivalent în seria 6:
gpt-6-solcostă la fel la intrare și mai puțin la ieșire (10 față de 12 $).
Trei calcule de cost, cu ipoteze declarate
Fiecare calcul spune ipotezele ca să le înlocuiești cu ale tale. Toate folosesc tarifele standard de mai sus și presupun, pentru tokenii noi care intră în cache, tariful de scriere în cache (1,25× intrarea), regula pentru GPT-5.6 și modelele ulterioare. Verifică raportul exact în usage, nu în calculul nostru.
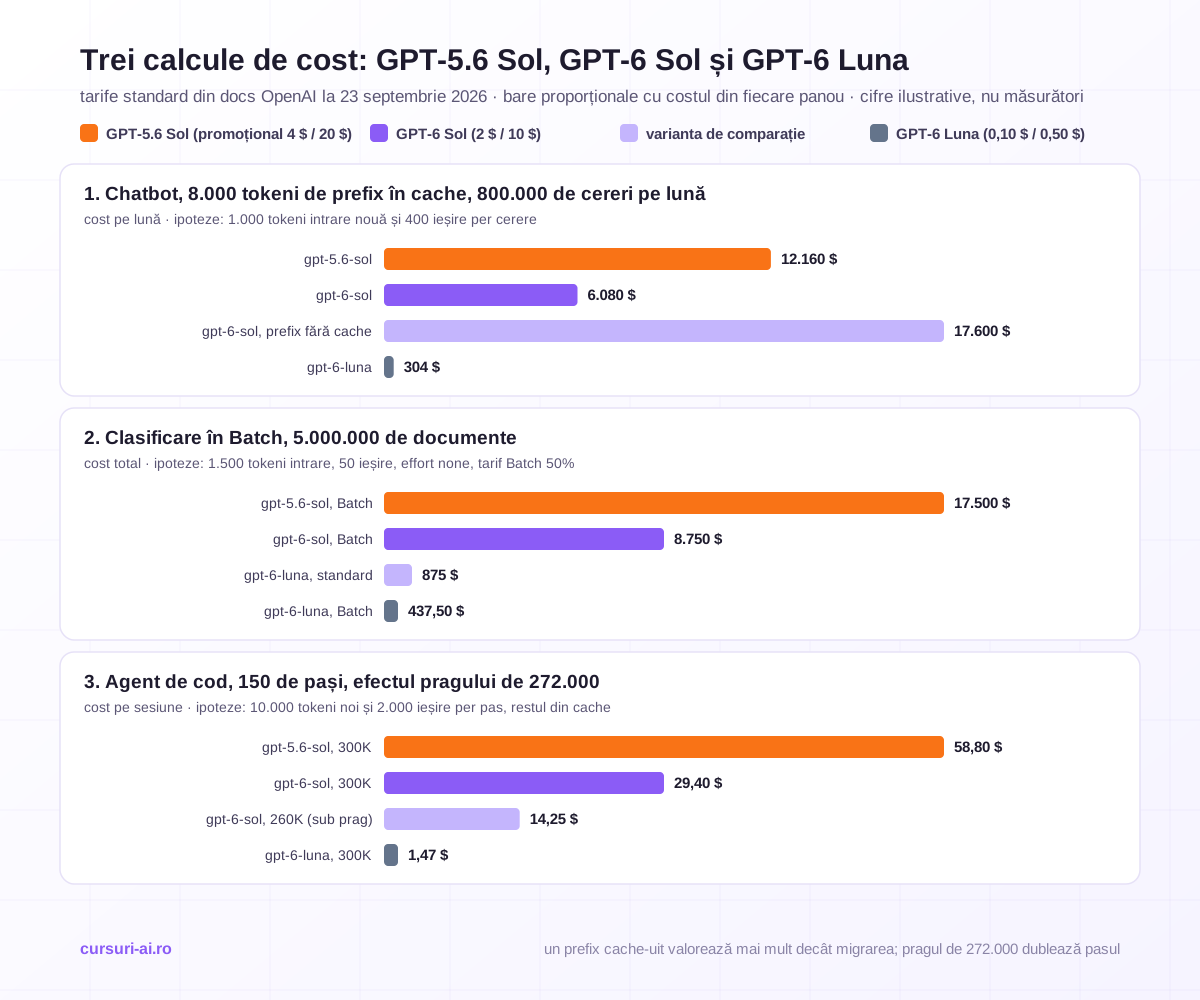
1. Chatbot cu prompt de sistem de 8.000 de tokeni, 200.000 de conversații pe lună
Ipoteze: 200.000 de conversații pe lună, în medie 4 tururi fiecare, deci 800.000 de cereri; la fiecare cerere, 8.000 de tokeni de prefix (instrucțiuni + unelte) serviți din cache, 1.000 de tokeni de intrare nouă (mesajul și istoricul turului) la tarif standard, 400 de tokeni de ieșire; scrierile în cache pentru prefix sunt neglijabile la acest volum, pentru că prefixul stă cald.
| Model | Prefix din cache | Intrare nouă | Ieșire | Per cerere | Pe lună |
|---|---|---|---|---|---|
gpt-5.6-sol |
0,0032 $ | 0,0040 $ | 0,0080 $ | 0,0152 $ | 12.160 $ |
gpt-6-sol |
0,0016 $ | 0,0020 $ | 0,0040 $ | 0,0076 $ | 6.080 $ |
gpt-6-luna |
0,00008 $ | 0,0001 $ | 0,0002 $ | 0,00038 $ | 304 $ |
Observația care contează mai mult decât diferența dintre modele: dacă prefixul nu se cache-uiește (o dată generată la fiecare cerere, unelte serializate în altă ordine), pe gpt-6-sol aceleași cereri costă 9.000 × 2 $/M + 0,004 $ = 0,022 $ fiecare, adică 17.600 $ pe lună — aproape triplu, pe același model. Migrarea îți dă −50%; un cache stricat îți ia +190%.
2. Pipeline de clasificare în Batch pe Luna, 5 milioane de documente
Ipoteze: 5.000.000 de documente, 1.500 de tokeni de intrare fiecare (instrucțiuni + document), 50 de tokeni de ieșire (eticheta și o justificare de un rând), reasoning.effort pe none, fără cache pentru că documentele diferă; rulat în Batch, la 50% din tarif. Total: 7,5 miliarde de tokeni de intrare, 250 de milioane de ieșire.
| Model, în Batch | Intrare | Ieșire | Total |
|---|---|---|---|
gpt-5.6-sol |
15.000 $ | 2.500 $ | 17.500 $ |
gpt-6-sol |
7.500 $ | 1.250 $ | 8.750 $ |
gpt-5.6-luna |
750 $ | 150 $ | 900 $ |
gpt-6-luna |
375 $ | 62,50 $ | 437,50 $ |
Aceeași sarcină pe Luna în procesare standard costă 875 $. Din ghidul Batch: un lot acceptă maximum 50.000 de cereri și 200 MB, deci 5 milioane de documente înseamnă cel puțin 100 de loturi, iar Batch are propriul bazin de rate limits, separat de cel sincron. Ipoteza fragilă e ieșirea: la effort peste none, tokenii de raționament se facturează ca ieșire, iar cei 50 pot deveni câteva sute. Măsoară pe 1.000 de documente înainte să lansezi 5 milioane.
3. Agent de cod pe Sol cu context de 300.000 de tokeni — efectul pragului
Ipoteze: o sesiune de 150 de pași; la fiecare pas, contextul recitit din cache plus 10.000 de tokeni noi (rezultate de unelte) scriși în cache la 1,25× intrarea; 2.000 de tokeni de ieșire. Comparăm 260.000 de tokeni (sub prag) cu 300.000 (peste prag, toată cererea la 2× intrare/cache și 1,5× ieșire).
| Model și context | Cache citit | Tokeni noi (scriere) | Ieșire | Per pas | 150 de pași |
|---|---|---|---|---|---|
gpt-6-sol, 260K |
0,050 $ | 0,025 $ | 0,020 $ | 0,095 $ | 14,25 $ |
gpt-6-sol, 300K |
0,116 $ | 0,050 $ | 0,030 $ | 0,196 $ | 29,40 $ |
gpt-5.6-sol, 260K |
0,100 $ | 0,050 $ | 0,040 $ | 0,190 $ | 28,50 $ |
gpt-5.6-sol, 300K |
0,232 $ | 0,100 $ | 0,060 $ | 0,392 $ | 58,80 $ |
gpt-6-luna, 300K |
0,0058 $ | 0,0025 $ | 0,0015 $ | 0,0098 $ | 1,47 $ |
Cele 40.000 de tokeni în plus (15% mai mult context) dublează costul pasului: 0,095 → 0,196 $. Și mai important pentru migrare: gpt-5.6-sol sub prag (28,50 $) costă cât gpt-6-sol peste prag (29,40 $). Dacă migrezi și lași contextul să treacă de 272.000, factura rămâne pe loc și concluzia greșită e că migrarea nu a adus nimic. Luna apare doar ca ordin de mărime; dacă e potrivită pentru un agent de cod se decide pe evals, nu pe această coloană.
Cache-ul pe GPT-6: ce s-a schimbat față de generația 5.5
Regulile generale — prefix stabil octet cu octet, ce variază la coadă — sunt în ghidul Astra și nu le repet. Ce e specific pentru GPT-5.6 și seria 6, conform ghidului de prompt caching:
- Cache-ul e pornit implicit, pe potrivire de prefix, cu 90% reducere la citire (0,1× intrarea).
- Scrierea în cache se plătește: 1,25× tariful de intrare necache-uită. Pe modelele mai vechi nu exista; pe GPT-6 apare în
usage. - Pragul minim de la care un prefix devine cache-uibil: 1.024 de tokeni vizibili de intrare.
- Retenția se cere cu
prompt_cache_options.ttlpe"30m"— singura valoare acceptată.prompt_cache_retention(cuin_memorysau24h) aparține modelelor GPT-5.5 și mai vechi; ghidul de migrare spune explicit să îl înlocuiești. - Breakpoint-uri explicite:
prompt_cache_options.modepe"explicit"și marcajeprompt_cache_breakpointîn input, dacă vrei să controlezi unde se taie prefixul.
Cum verifici, într-un apel real pe Responses API, cu parametri care există în docs:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-sol",
    instructions=PROMPT_DE_SISTEM_STABIL,   # prefixul, identic la fiecare apel
    reasoning={"effort": "low"},
    prompt_cache_options={"ttl": "30m"},
    input=[{"role": "user", "content": intrebare}],
)

print(response.output_text)
detalii = response.usage.input_tokens_details
print("citite din cache:", detalii.cached_tokens)
print("scrise în cache:", detalii.cache_write_tokens)
Regula de acceptare din testul de integrare: după al doilea apel cu același prefix, cached_tokens trebuie să fie cel puțin egal cu lungimea prefixului; dacă rămâne zero, ai un invalidator tăcut înainte de breakpoint. Cum proiectezi memoria unui agent ca prefixul să rămână stabil pe zeci de pași e subiectul cursului Context Engineering și Memorie pentru Agenți AI.
reasoning.effort de la none la max: ce e documentat și ce e recomandare
Documentat în ghidul de raționament și în ghidul de migrare la GPT-6:
- Sol și Luna acceptă șase trepte:
none,low,medium(implicit),high,xhigh,max. Astra nu acceptănone(întoarce 400); dacă vii de peminimal, pornește de lalow. - Tokenii de raționament se facturează ca ieșire și ocupă loc în context.
max_output_tokenslimitează totalul (raționament + text vizibil); la limită, răspunsul vineincomplete, plătit, fără text util. OpenAI recomandă să rezervi cel puțin 25.000 de tokeni la început. - Când
efforte diferit denone,temperature,top_pșitop_logprobstrebuie eliminate (pe Chat Completions șilogprobs; pe Responses,message.output_text.logprobsdininclude). - Pe Chat Completions, function calling merge doar cu
reasoning_effort: "none"pe Sol și Luna. Pentru unelte cu raționament, endpoint-ul e Responses. - În modul fără stare (
store: false), elementele de raționament vin cuencrypted_content, pe care îl trimiți înapoi neschimbat la turul următor.
Recomandări de practician, nu din docs: pentru clasificare, extragere și reformulare, none sau low pe Luna sunt punctul de plecare; pentru un agent de cod pe Sol, medium implicit e rezonabil până când evals-urile arată că high schimbă rata de reușită. Docs nu publică nici tokeni consumați pe treaptă, nici latență; le măsori din usage.output_tokens_details.reasoning_tokens și din timestamps.
Lista de verificare: de pe GPT-5.6 Sol/Luna/Terra pe GPT-6 Sol/Luna
În ordinea în care lucrurile se strică dacă le sari.
- Inventarul identificatorilor. Grep pe
gpt-5.6-sol,gpt-5.6-terra,gpt-5.6-lunaîn cod, configurații și fișiere de lot. Mapare: Sol și Terra →gpt-6-sol, Luna →gpt-6-luna. Ține identificatorul într-o singură variabilă; stratul de integrare care face asta ieftin e descris în ghidul de migrare și deprecare. - Evals înainte, evals după. Rulează suita de regresie pe modelul vechi și înregistrează rata de reușită, tokenii și costul per sarcină reușită; abia apoi schimbi identificatorul. Fără cifra „înainte”, orice diferență e o impresie.
- Parametrii de sampling.
temperaturesautop_pcueffortdiferit denoneînseamnă cereri eșuate. Scoate-i sau condiționează-i. - Cache-ul.
prompt_cache_retentiondevineprompt_cache_options={"ttl": "30m"}; verificăcached_tokensșicache_write_tokensdupă migrare — o schimbare de prompt făcută „cu ocazia” poate muta ceva în fața breakpoint-ului. - Pragurile de context. Intrare maximă 922.000, prag de tarif 272.000. Alertă pe
usage.input_tokensla 250.000 și compactare înainte de prag, nu după. - Timeout-urile. Pe Flex, docs recomandă 15 minute;
xhighșimaxrulează mult mai mult decâtmedium. Un timeout moștenit taie răspunsuri plătite. - Structured outputs. Schema cu
strict: truemerge pe Responses întext.format; în SDK-ul Python,client.responses.parse(..., text_format=ModelPydantic). Re-rulează testele de schemă: modelul nou poate umple altfel câmpurile opționale. Validarea ieșirilor structurate și gestiunea erorilor în producție sunt tratate în Integrare Avansată LLM. - Uneltele găzduite. Definițiile rămân; se retestează comportamentul: ghidul de migrare notează că modelele GPT-6 pun mai des întrebări de clarificare și sunt mai sensibile la instrucțiunile din fișierele de skills, deci promptul de „lucrează autonom până la capăt” poate cere o propoziție în plus.
- Chat Completions cu unelte. Function calling cu
effortdiferit denoneînseamnă că migrezi endpoint-ul pe Responses, nu doar modelul. - Rollback. Păstrează identificatorul vechi într-un comutator.
gpt-5.6-solnu are anunț de deprecare la data scrierii, iar politica OpenAI din pagina de deprecări promite minimum 6 luni de preaviz pentru modelele disponibile general.
Un apel de clasificare pe Luna, cu ieșire structurată:
from pydantic import BaseModel
from openai import OpenAI

class Clasificare(BaseModel):
    categorie: str
    justificare: str

client = OpenAI()
raspuns = client.responses.parse(
    model="gpt-6-luna",
    reasoning={"effort": "none"},
    instructions=INSTRUCTIUNI_CLASIFICARE,
    input=[{"role": "user", "content": document}],
    text_format=Clasificare,
)
rezultat = raspuns.output_parsed
De pe Astra pe Sol: când are sens
Sensul invers e tratat în ghidul Astra. Acesta apare pentru echipele care au pus Astra în producție în septembrie și văd factura: Sol costă a cincea parte pe fiecare poziție din grilă. Ce se schimbă:
- Câștigi
none, pe care Astra nu îl are, deci muți sarcinile deterministe pe efort zero. - Pierzi Realtime: Astra e expus și pe Realtime, Sol și Luna nu. Fluxurile de voce rămân pe Astra.
- Contextul, pragul, uneltele și regulile de cache sunt identice, deci codul de gestiune a contextului nu se atinge.
- La evals testezi afirmația OpenAI că Sol atinge „fiabilitate de nivel Astra” la cost mult mai mic — o afirmație a furnizorului, discutată în analiza lansării GPT-6 Sol și Luna — pe sarcinile unde Astra a fost ales tocmai pentru fiabilitate.
Codex și GitHub Copilot: ce ajunge la echipă fără API
Codex. Pagina de modele din documentația Codex (la Surse) listează Astra, Sol și Luna ca modele recomandate, cu GPT-5.5 în retragere din Codex la 14 octombrie 2026. Tabelul de planuri arată Sol și Luna pe Plus, Pro, Business, Enterprise, Edu și pe nivelurile neplătite ale ChatGPT (inclusiv Go), Astra pe toate mai puțin cele neplătite — disponibilitatea depinde de rollout și de client, iar presa din ziua lansării vorbea doar de Luna pentru nivelurile neplătite, deci verifică în aplicația ta. Selecția: model = "gpt-6-sol" în config.toml, codex --model gpt-6-sol sau /model în sesiune.
GitHub Copilot. Conform changelog-ului GitHub din 22 septembrie 2026: GPT-6 Sol pe Copilot Pro+, Max, Business și Enterprise; GPT-6 Luna și pe Pro. Ambele sunt facturate usage-based, în toate suprafețele (VS Code, Visual Studio, JetBrains, Xcode, Eclipse, CLI, agentul cloud, github.com, aplicația mobilă), cu rollout gradual. Politica de administrare: sub „default model enablement”, modelele noi se activează automat, dacă administratorul nu a oprit implicitul global sau nu a dezactivat explicit modelul — deci într-o organizație cu listă de modele aprobate, Sol și Luna sunt deja pornite în IDE-uri, dacă nimeni nu a bifat contrariul înainte de 22 septembrie.
Ce nu scrie în grila de prețuri
Rate limits pe tiers. Fișele publică tabelul standard: Tier 1, 500 RPM și 500.000 TPM pentru ambele modele; Tier 5, 15.000 RPM și 40 de milioane TPM pentru Sol, 30.000 RPM și 180 de milioane TPM pentru Luna; cozile de Batch au limite separate. Un lot sincron pe Luna la 1.500 de tokeni per cerere atinge 500.000 TPM la 333 de cereri pe minut, deci la Tier 1 Batch nu e o opțiune, e singura.
Latență. Nici fișele, nici pagina de prețuri nu publică latență sau tokeni pe secundă pentru Sol și Luna. Ce știm e structural: Fast mode costă dublu, Flex e „mai lent, cu resurse ocazional indisponibile”. Cifrele le produci tu, pe fiecare treaptă.
UE și rezidența datelor. Pagina despre datele tale documentează: API-ul nu antrenează pe datele trimise fără opt-in explicit; jurnalele de monitorizare a abuzului se păstrează implicit până la 30 de zile; Zero Data Retention e eligibil pentru /v1/responses și /v1/chat/completions; rezidența datelor există în 11 regiuni, iar procesarea regională (inferența) doar în SUA, Europa (SEE + Elveția) și Emirate, cu un adaos de 10% pentru modelele lansate după 5 martie 2026. Ghidul de migrare adaugă că, pentru modelele GPT-6, rezidența datelor e disponibilă doar cu procesare standard — nu în Batch, Flex sau Fast. Pentru o firmă din România cu obligație contractuală de procesare în UE, calculul 2 se reface la tarif standard plus 10%: 962,50 $ în loc de 437,50 $ pe Luna. Nedocumentat: din ce zi procesarea europeană e activă pentru Sol și Luna; verifici în lista de modele a proiectului regional.
Calendarul de retragere al GPT-5.6. Nu există. Pagina de deprecări listează retrageri către GPT-5.6 (GPT-5 și variantele lui, la 11 decembrie 2026), nu retrageri ale lui GPT-5.6. Promoția 4 $ / 20 $ are însă o dată — 21 noiembrie 2026 — iar prețul lui GPT-5.6 Sol de după ea nu are de ce să fie mai mic decât al lui GPT-6 Sol. Nu e o deprecare, dar e un stimulent cu termen.
Întrebări frecvente
Cât costă GPT-6 Sol în API? La tarif standard, 2 $ per milion de tokeni la intrare, 0,20 $ pentru intrarea din cache, 2,50 $ pentru scrierea în cache și 10 $ la ieșire. Peste 272.000 de tokeni de intrare, intrarea și cache-ul se dublează și ieșirea crește cu 50%, pentru toată cererea. Batch și Flex înjumătățesc tarifele; Fast mode le dublează.
GPT-6 Sol e cu adevărat la jumătate din prețul lui GPT-5.6 Sol? Da, față de prețul promoțional de 4 $ / 20 $ afișat în documentație pentru GPT-5.6 Sol cel puțin până la 21 noiembrie 2026. Față de prețul de listă de la lansare, 5 $ / 30 $, reducerea e de 60% la intrare și 67% la ieșire. Pentru Luna, intrarea scade cu 50% și ieșirea cu 58%.
Ce parametri trebuie să schimb când migrez de pe GPT-5.6 pe GPT-6 Sol sau Luna?
Identificatorul; prompt_cache_retention devine prompt_cache_options cu ttl pe "30m"; temperature, top_p și top_logprobs se elimină când reasoning.effort nu e none; pe Chat Completions, function calling merge doar cu efort none, altfel treci pe Responses. Uneltele găzduite existau deja pe GPT-5.6.
Cum verific că prompt caching funcționează pe GPT-6?
În răspuns, citești usage.input_tokens_details.cached_tokens (tokeni citiți din cache) și usage.input_tokens_details.cache_write_tokens (tokeni scriși). Prefixul trebuie să aibă cel puțin 1.024 de tokeni vizibili și să fie identic de la un apel la altul; al doilea apel cu același prefix trebuie să raporteze cached_tokens cel puțin egal cu lungimea prefixului.
Ce înseamnă reasoning.effort pentru cost pe GPT-6 Sol și Luna?
Fiecare treaptă de la none la max produce mai mulți tokeni de raționament, facturați ca ieșire — 10 $ per milion pe Sol, 0,50 $ pe Luna. Documentația nu publică un consum pe treaptă; îl măsori din usage.output_tokens_details.reasoning_tokens. none există pe Sol și Luna, nu pe Astra.
Concluzie
GPT-6 Sol și Luna nu schimbă arhitectura aplicațiilor construite pe GPT-5.6: același context de 1.050.000 de tokeni cu intrare de maximum 922.000, același prag de 272.000, aceleași unelte și endpoint-uri. Schimbă factura — la jumătate față de promoția actuală a lui GPT-5.6 Sol, la mai puțin de jumătate la ieșire pentru Luna — și câțiva parametri care, nesupravegheați, întorc erori 400 sau anulează cache-ul: prompt_cache_options.ttl, eliminarea temperature/top_p cu raționament activ, function calling doar pe Responses. Cele trei calcule arată unde se decide economia: prefixul cache-uit valorează mai mult decât migrarea în sine, Batch pe Luna face clasificarea la scară o sumă de trei cifre, iar pragul de 272.000 dublează costul unui agent care nu compactează. Lista în zece pași, cu evals înainte și după și rollback pregătit, e diferența dintre o migrare de o după-amiază și una de un trimestru.
Surse
- OpenAI Developers, fișa modelului GPT-6 Sol: https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI Developers, fișa modelului GPT-6 Luna: https://developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI Developers, fișa modelului GPT-5.6 Sol (preț promoțional până la 21 noiembrie 2026, unelte): https://developers.openai.com/api/docs/models/gpt-5.6-sol
- OpenAI Developers, fișa modelului GPT-5.6 Luna: https://developers.openai.com/api/docs/models/gpt-5.6-luna
- OpenAI Developers, Pricing: https://developers.openai.com/api/docs/pricing
- OpenAI Developers, Prompt caching: https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI Developers, Batch API: https://developers.openai.com/api/docs/guides/batch
- OpenAI Developers, Flex processing: https://developers.openai.com/api/docs/guides/flex-processing
- OpenAI Developers, Reasoning models: https://developers.openai.com/api/docs/guides/reasoning
- OpenAI Developers, ghid de migrare la modelele GPT-6: https://developers.openai.com/api/docs/guides/latest-model
- OpenAI Developers, Structured outputs: https://developers.openai.com/api/docs/guides/structured-outputs
- OpenAI Developers, Deprecations: https://developers.openai.com/api/docs/deprecations
- OpenAI Developers, Your data (retenție, ZDR, regiuni): https://developers.openai.com/api/docs/guides/your-data
- Codex, pagina de modele: https://learn.chatgpt.com/docs/models
- GitHub Changelog, 22 septembrie 2026: https://github.blog/changelog/2026-09-22-openais-gpt-6-sol-and-gpt-6-luna-now-available/
- TechCrunch, „OpenAI launches GPT-6 Sol and Luna”, 22 septembrie 2026: https://techcrunch.com/2026/09/22/openai-launches-gpt-6-sol-and-luna/
Articol informativ, publicat la 23 septembrie 2026. Prețurile, limitele și parametrii provin din documentația OpenAI pentru dezvoltatori, consultată la 23 septembrie 2026, și se pot schimba; calculele de cost sunt exemple cu ipoteze declarate, nu măsurători, iar tratamentul scrierilor în cache e o presupunere de calcul pe care o verifici în câmpul usage al răspunsurilor tale. Recomandările despre treptele de efort sunt opinii de practician, nu cifre publicate de OpenAI. Conținutul nu constituie consultanță juridică sau financiară.

Cursul care continuă acest articol
Construire de Aplicații AI cu Python și SDK-uri (OpenAI, Anthropic): de la API la Produs
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente: de la API de LLM la mediul tău Python
- Primul apel: chat completions, mesaje și parametri
- Streaming și UX: răspunsuri în timp real
- Function calling / tool use: conectează modelul la codul tău
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.