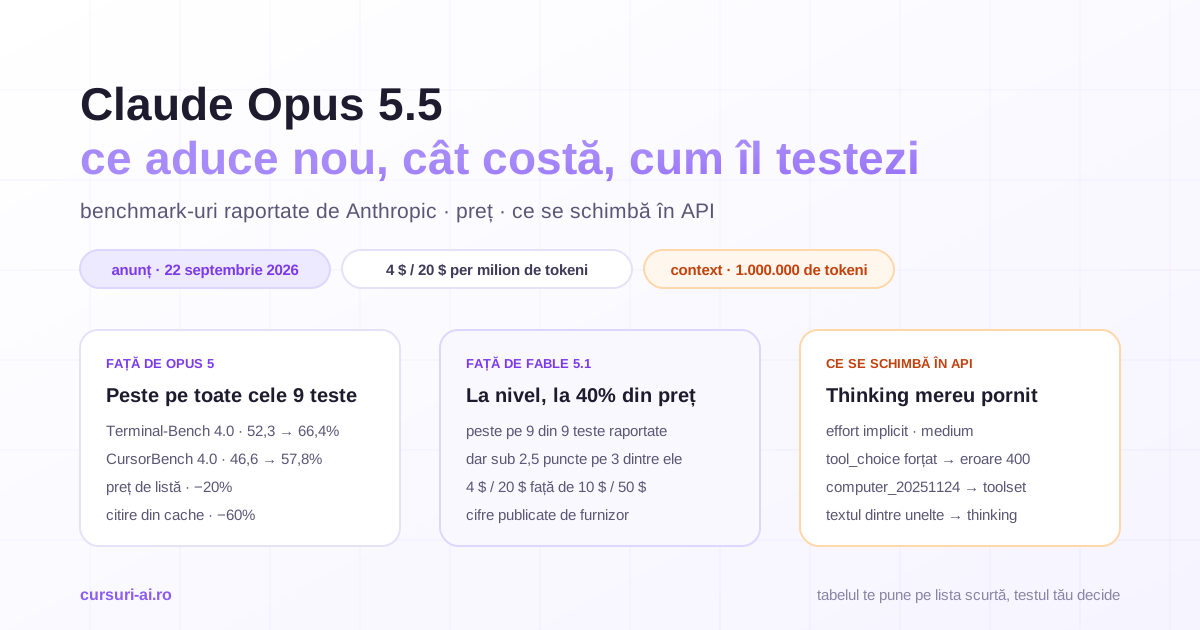
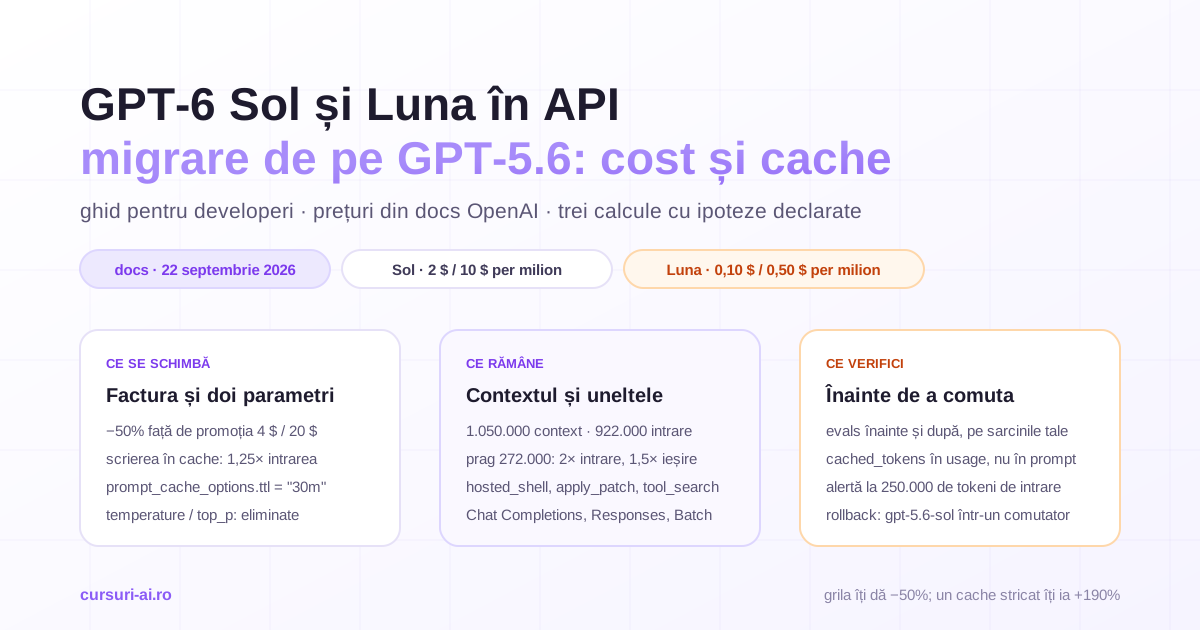
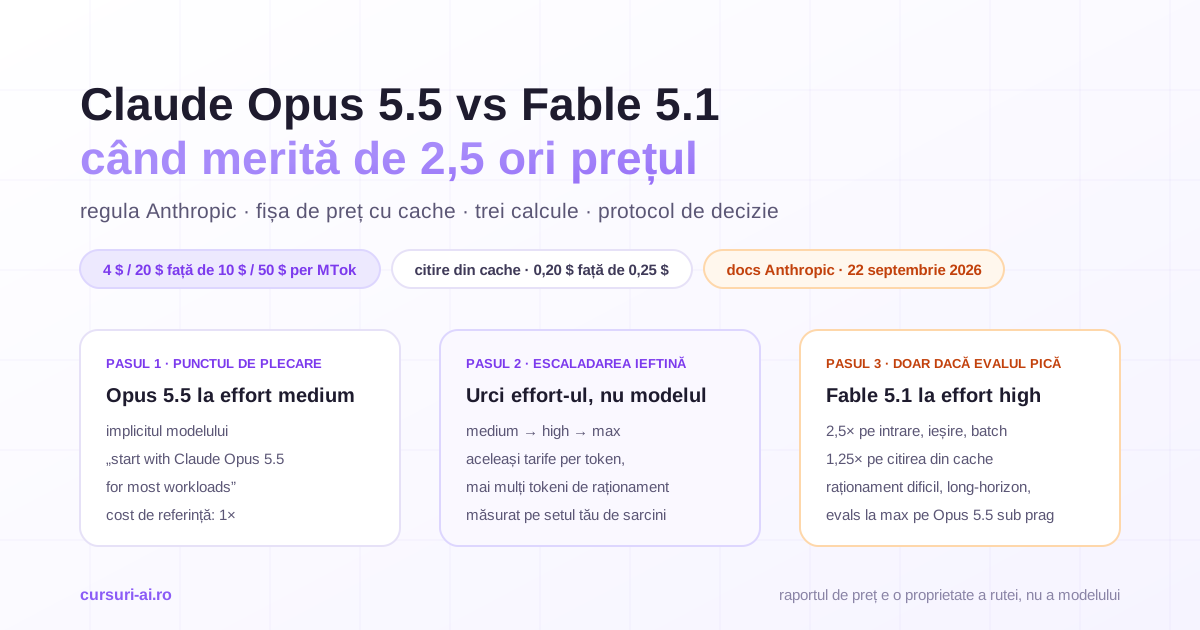
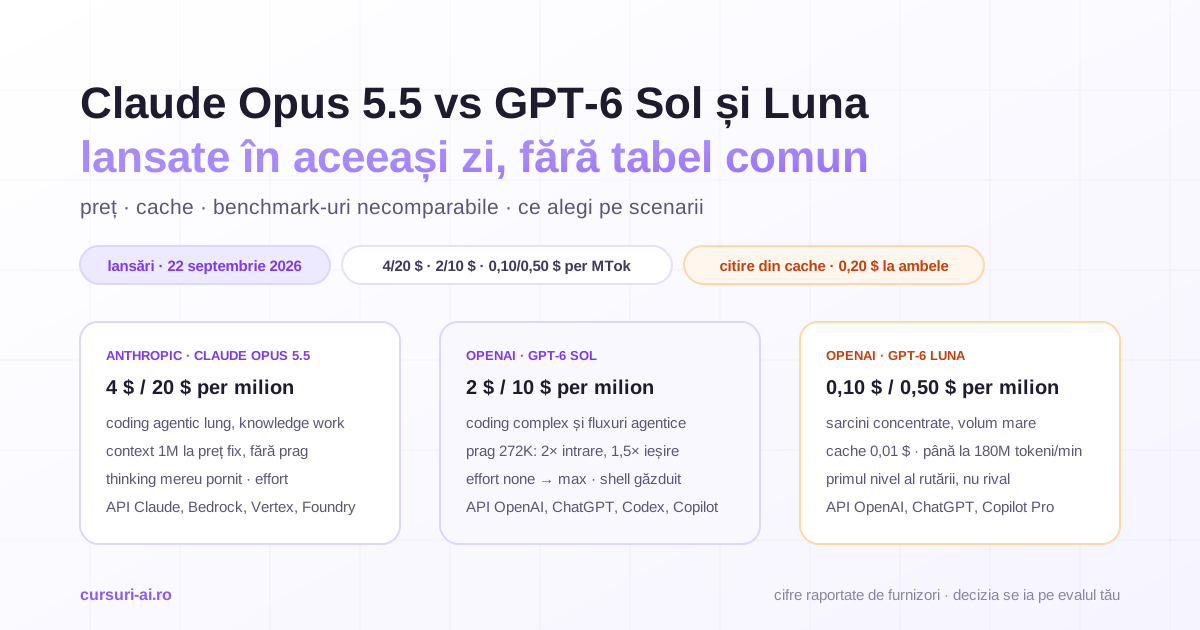
Claude Opus 5.5 vs GPT-6 Sol e comparația pe care o caută toată lumea de pe 22 septembrie 2026 și pe care nu a publicat-o nimeni: Anthropic și OpenAI și-au lansat modelele la circa o oră și jumătate distanță (potrivit relatărilor de presă), iar tabelele fiecăruia se opresc la generația anterioară a celuilalt. Rămân trei prețuri de listă — 4/20 $, 2/10 $ și 0,10/0,50 $ per milion de tokeni — și cifre care nu se aliniază decât dacă le forțezi. Acest articol nu le forțează: arată ce se poate pune alături, ce nu, cât costă de fapt o sarcină pe fiecare model și cum decizi fără să aștepți un tabel care nu va veni.
Trei candidați, doi „părinți” și o zi de lansări
- Claude Opus 5.5 (
claude-opus-5-5) — „pentru coding agentic de lungă durată și muncă intelectuală”, în formularea Anthropic; 4 $ intrare / 20 $ ieșire per milion de tokeni; primul model din familia Claude 5.5. Fișa completă e în articolul dedicat lansării. - GPT-6 Sol (
gpt-6-sol) — „construit pentru fluxuri complexe de coding și agentice”, conform documentației OpenAI; 2 $ / 10 $. - GPT-6 Luna (
gpt-6-luna) — „cel mai eficient model pentru sarcini concentrate, de volum mare”; 0,10 $ / 0,50 $. Sol și Luna sunt analizate pe larg în articolul despre noile modele OpenAI.
Deasupra lor stau modelele de vârf lansate cu câteva săptămâni mai devreme — Claude Fable 5.1 (1 septembrie) și GPT-6 Astra (3 septembrie), ambele la 10 $ / 50 $ — care apar aici doar ca reper; comparația lor e în GPT-6 Astra vs Claude Fable 5.1.
Cele trei modele noi ocupă nivelul de mijloc al fiecărui furnizor, unde se duce cea mai mare parte a traficului de producție. Decizia nu e „care e mai bun”, ci „pe ce nivel rutez fiecare tip de sarcină, cu ce fallback și la ce cost” — exact problema tratată în lecțiile despre AI Gateway, rutare multi-furnizor, fallback și caching din cursul Arhitectura Sistemelor AI la Scară. Tabelele de mai jos sunt materia primă pentru acea decizie, nu decizia.
De ce nu există „Opus 5.5 vs GPT-6 Sol” în niciun tabel oficial
Pagina de lansare a Anthropic compară Opus 5.5 cu Fable 5.1, Opus 5, GPT-6 Astra și GPT-5.6 Sol; „GPT-6 Sol” și „Luna” nu apar în ea. Cifrele OpenAI pentru Sol și Luna (reproduse de Vellum) compară cu Astra, GPT-5.6 Sol, Fable 5.1, Fable 5 și Opus 5; Opus 5.5 nu apare. Materialele au fost pregătite înainte ca celălalt model să existe public.
Dar chiar dacă iei o cifră din fiecare tabel pentru „același” test, compari lucruri diferite. Patru motive, cu exemple din cele două seturi de date:
- Nivelul de efort. Anthropic rulează Opus 5.5 „cu adaptive thinking la efort max, dacă nu se specifică altfel”; pe Terminal-Bench 4.0, Opus 5.5 e la
xhigh, iar GPT-6 Astra lahigh. OpenAI rulează Sol laxhighpe AutomationBench și lamaxpe DeepSWE, dar Astra lalowpe AutomationBench și Opus 5 lamediumpe OSWorld. Efortul schimbă și scorul, și costul; niciun tabel nu îl ține constant între modele. - Versiunile de teste. Anthropic raportează „AutomationBench”, fără versiune; OpenAI, „AutomationBench 1.0.6”. Anthropic: „OSWorld 2.0 (partial)”; OpenAI: „OSWorld 2.0 offline, versiunea 2026.08.08, partial reward”. Examene înrudite, nu identice.
- Fallback și safeguards. Anthropic precizează că pe AutomationBench rulările au fost „fără modele de fallback, deci intervențiile safeguard-urilor au fost considerate eșecuri”. În nota OpenAI, Fable 5.1 „a folosit fallback pe Opus 5 pe aproximativ 40% din sarcini; costul fallback-ului nu e raportat”. Aceleași cuvinte, contabilizări diferite.
- Aceleași modele, cifre diferite. Pe AutomationBench, GPT-6 Astra are 41,4% în tabelul Anthropic și 30,3% (la
low) în cel al OpenAI; GPT-5.6 Sol are 28,8% la Anthropic și 18,1% la OpenAI. Pe OSWorld 2.0, Claude Opus 5 are 74,0% la Anthropic și 60,3% (lamedium, varianta offline) la OpenAI. Nu e eroare la niciunul; sunt metodologii diferite cu același nume de test.
Orice articol care îți arată „Opus 5.5: 40,0% vs GPT-6 Sol: 33,2%” fără aceste note a construit o comparație care nu există în nicio sursă.
Ce se poate pune alături, cu prudență
Tabelul păstrează fiecare cifră lângă sursa și efortul declarat. Liniuța înseamnă că furnizorul nu a publicat cifra. Nimic nu e rotunjit sau „normalizat”.
| Test | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | Sursa cifrei · efort declarat |
|---|---|---|---|---|
| AutomationBench | 40,0% | 33,2% | — | Opus 5.5: Anthropic, max, fără fallback, versiune neprecizată · Sol: OpenAI, xhigh, v1.0.6, 0,27 $/sarcină |
| OSWorld 2.0 | 81,8% (partial) | 60,5% | 58,1% | Opus 5.5: Anthropic, „partial” · Sol/Luna: OpenAI, offline v2026.08.08, partial reward, Sol xhigh, Luna max |
| Terminal-Bench 4.0 | 66,4% | — | — | Anthropic, xhigh; eroare standard ±2,6 puncte |
| CursorBench 4.0 | 57,8% | — | — | Anthropic, max |
| GDPval-AA v2.1 (Elo) | 1846 | — | — | Anthropic; în același tabel GPT-5.6 Sol are 1588 |
| DeepSWE v1.1 | — | 68,8% | 66,6% | OpenAI, ambele la max; în același tabel Opus 5 (medium) 66,0%, Fable 5 (xhigh) 69,9% |
| Agents' Last Exam | — | 56,4% | — | OpenAI, max; Astra 59,3% |
Trei lucruri de citit din tabel:
- Pe niciun rând nu există două cifre produse de același evaluator pentru Opus 5.5 și Sol. Diferența de 6,8 puncte de pe AutomationBench e mai mică decât cele 11,1 puncte cu care cei doi furnizori diferă pentru același GPT-6 Astra; deci nu poți spune cine conduce.
- Fiecare furnizor a ales testele care îi avantajează modelul. Anthropic publică Terminal-Bench, CursorBench și GDPval, unde Opus 5.5 conduce propriul tabel; OpenAI publică DeepSWE, unde Luna la 0,10 $ ajunge la 0,6 puncte de Opus 5 și la 3,3 puncte de Fable 5. Ambele pot fi adevărate simultan.
- Ce au în comun: Claude Opus 5, la 5/25 $, e egalat sau depășit în ambele tabele de modele de două ori și jumătate până la de cincizeci de ori mai ieftine. Indiferent cine „câștigă” între Opus 5.5 și Sol, generația anterioară a devenit scumpă pentru ce oferă.
Costul real pe sarcină: unde se decide factura
Prețurile de listă, din documentația celor doi furnizori (grila Anthropic, fișa GPT-6 Sol), consultată pe 23 septembrie 2026:
| Per milion de tokeni | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| Intrare | 4 $ | 2 $ | 0,10 $ |
| Ieșire (inclusiv raționament) | 20 $ | 10 $ | 0,50 $ |
| Scriere în cache | 5 $ (5 min) / 8 $ (1 h) | 2,50 $ | 0,125 $ |
| Citire din cache | 0,20 $ | 0,20 $ | 0,01 $ |
| Batch | 2 $ / 10 $ (−50%) | −50% (și Flex) | −50% (și Flex) |
| Fast mode | 8 $ / 40 $ (research preview, doar API-ul Claude) | 2× tarifele | 2× tarifele |
| Context peste prag | 1M la preț fix, fără prag | peste 272.000 tokeni intrare: 2× intrare și cache, 1,5× ieșire, pentru toată cererea | la fel ca Sol |
| Context / ieșire maximă | 1.000.000 / 128.000 | 1.050.000 (max. 922.000 intrare) / 128.000 | 1.050.000 / 128.000 |
| Cunoștințe până în | iunie 2026 | 20 aprilie 2026 | 18 mai 2026 |
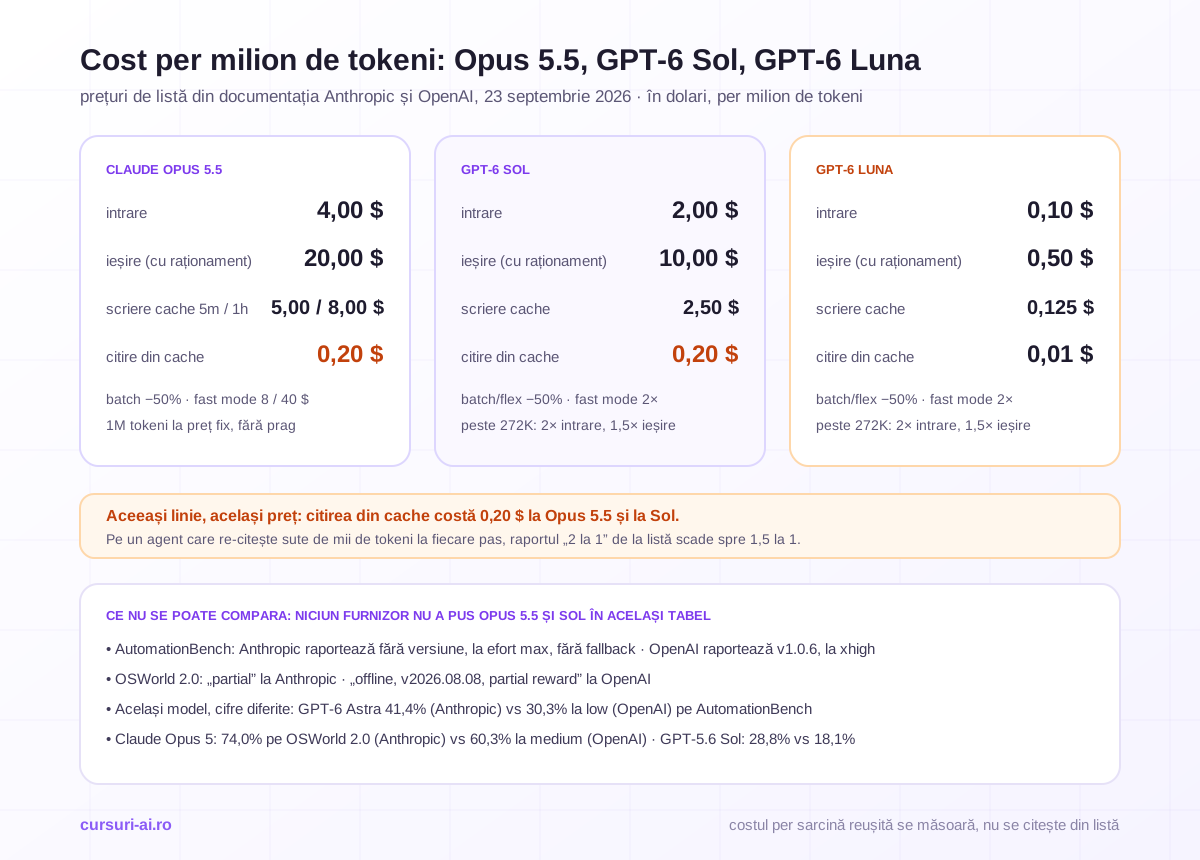
Cinci observații care contează mai mult decât raportul „2 la 1” dintre Opus 5.5 și Sol:
- Citirea din cache costă la fel: 0,20 $. La Anthropic e 5% din prețul de intrare (excepție declarată în documentație; restul modelelor au 10%, Fable 5.1 are 2,5%). La OpenAI e 10% din 2 $. Pentru un agent care re-citește la fiecare pas sute de mii de tokeni, cea mai mare parte a facturii e această linie — și aici cele două modele sunt la egalitate.
- Scrierea în cache costă dublu la Anthropic: 5 $ (5 minute) sau 8 $ (o oră), față de 2,50 $ la Sol. Contează la prima cerere a fiecărei sesiuni; nu contează la un agent care rulează ore pe același prefix.
- Pragul de 272.000 de tokeni de la OpenAI schimbă ordinea. Peste el, Sol costă 4 $ intrare și 15 $ ieșire pentru toată cererea. Anthropic nu are prag: un milion de tokeni se plătește la același tarif ca o mie.
- Raționamentul e ieșire plătită la ambii, dar nu se comportă la fel. La Opus 5.5, thinking-ul e mereu pornit și se reglează prin
effort(implicitmedium); documentația avertizează că, la același nivel, modelul „tinde să gândească mai mult per tur decât Opus 5”. La Sol și Luna,reasoning.effortmerge de lanonelamax(implicitmedium);noneînseamnă zero raționament plătit. - Fast mode: Opus 5.5 rapid e 8 $ / 40 $, în research preview, doar pe API-ul Claude (nu pe Bedrock, Vertex sau Foundry). La OpenAI, „2× tarifele aplicabile” — pentru Sol, 4 $ / 20 $.
Trei calcule cu ipoteze declarate
Volumele de tokeni sunt ipotetice, alese ca să arate mecanica; le înlocuiești cu ale tale din câmpul usage.
Sesiune de agent de coding — 40.000 tokeni de intrare noi, 200.000 citiți din cache, 15.000 de ieșire (inclusiv raționament):
| Model | Calcul | Cost / sarcină |
|---|---|---|
| Claude Opus 5.5 | 0,16 + 0,04 + 0,30 | 0,50 $ |
| GPT-6 Sol | 0,08 + 0,04 + 0,15 | 0,27 $ |
| GPT-6 Luna | 0,004 + 0,002 + 0,0075 | 0,0135 $ |
| Claude Fable 5.1 (reper) | 0,40 + 0,05 + 0,75 | 1,20 $ |
| GPT-6 Astra (reper) | 0,40 + 0,20 + 0,75 | 1,35 $ |
Dacă sarcina e dominată de cache — 20.000 de tokeni noi, 500.000 din cache, 5.000 de ieșire — Opus 5.5 ajunge la 0,28 $ și Sol la 0,19 $: raportul scade de la 2 la 1 la circa 1,5 la 1, pentru că linia cea mai mare e tarifată identic.
Lot de volum — 100.000 de cereri pe zi, fiecare cu 3.000 de tokeni de intrare și 500 de ieșire, fără cache:
| Model | Cost / cerere | Cost / zi | Cost / zi în Batch |
|---|---|---|---|
| GPT-6 Luna | 0,00055 $ | 55 $ | 27,50 $ |
| GPT-6 Sol | 0,011 $ | 1.100 $ | 550 $ |
| Claude Opus 5.5 | 0,022 $ | 2.200 $ | 1.100 $ |
Aici diferența e de un ordin de mărime, nu de procente; de aceea Luna e un nivel separat, nu un concurent al lui Sol.
Cerere cu context foarte mare — 400.000 de tokeni de intrare noi, 10.000 de ieșire:
| Model | Calcul | Cost |
|---|---|---|
| Claude Opus 5.5 | 400.000 × 4 $ + 10.000 × 20 $ | 1,80 $ |
| GPT-6 Sol (peste prag: 4 $ / 15 $) | 400.000 × 4 $ + 10.000 × 15 $ | 1,75 $ |
| GPT-6 Luna (peste prag: 0,20 $ / 0,75 $) | 400.000 × 0,20 $ + 10.000 × 0,75 $ | 0,0875 $ |
Peste 272.000 de tokeni, Sol și Opus 5.5 costă practic la fel. Dacă fluxul tău trăiește în această zonă, prețul nu mai e criteriu; calitatea pe sarcinile tale este.
Ce lipsește din toate calculele: rata de reușită. Un model care rezolvă 8 sarcini din 10 la 0,27 $ costă 0,34 $ per sarcină reușită; unul care rezolvă 9 din 10 la 0,50 $ costă 0,56 $. Distanța reală e mai mică decât cea de pe lista de prețuri — sau mai mare, în funcție de sarcinile tale. Formula completă e în articolul despre costul unui agent AI cu context lung.
Diferențele de API care costă timp de inginerie
Prețul se compară în cinci minute. Diferențele de mai jos se plătesc în zile de migrare și în incidente.
Ce e specific la Claude Opus 5.5
Documentația listează patru schimbări incompatibile față de Opus 5, trei valabile și pe Fable 5.1:
- Thinking-ul nu se poate dezactiva.
thinking: {"type": "disabled"}sau un buget manual întorc400 invalid_request_error. Controlul eeffort; unde înainte opreai raționamentul, cobori efortul. tool_choiceforțat nu e acceptat.anyșitoolîntorc eroare; rămânautoșinone. Pentru JSON valid pe schemă, documentația trimite la strict tool use sau structured outputs.- Blocurile de thinking sunt legate de model și de conversație. Opus 5.5 citește blocurile lui Opus 5 și ale modelelor Sonnet/Haiku anterioare, nu pe cele Fable/Mythos; Fable 5.1 și Mythos 5.1 le citesc pe ale lui. O conversație mutată pe un model care nu le poate citi continuă fără raționamentul anterior, iar pentru conturile create de la 31 august 2026 API-ul respinge implicit un bloc re-trimis după ce prompt-ul de sistem sau uneltele s-au schimbat. Pentru arhitectură: fallback-ul între modele are un cost ascuns și istoricul trebuie ținut append-only.
- Computer use cere
computer_toolset_20260801pe API-ul Claude și Google Cloud; vechiulcomputer_20251124întoarce eroare (pe Bedrock continuă să funcționeze).
O schimbare de formă fără eroare: textul dintre apelurile de unelte vine în blocuri thinking cu text gol la setarea implicită display. O aplicație care afișa acele note ca progres „amuțește” între apeluri până setează display — defectul pe care nu îl prinde niciun test automat, doar un utilizator.
Refuzurile safeguard-urilor vin ca HTTP 200 cu stop_reason: "refusal" și stop_details; există fallback server-side (fallbacks: "default", beta). Disponibil pe API-ul Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry și Claude Platform on AWS; retragere nu mai devreme de 22 septembrie 2027.
Ce e specific la GPT-6 Sol și Luna
Fișele celor două modele sunt aproape identice: reasoning.effort cu șase niveluri (none, low, medium, high, xhigh, max); endpointurile Chat Completions, Responses și Batch, fără Realtime, Assistants, fine-tuning sau embeddings; intrare text și imagine, ieșire text. Uneltele găzduite: web_search, file_search, image_generation, code_interpreter, hosted_shell, computer_use, apply_patch, mcp, tool_search și skills. Pentru un agent de coding, hosted_shell și apply_patch înseamnă că shell-ul și aplicarea patch-urilor rulează la furnizor — mai puțin cod de scris, mai puțin control asupra mediului.
Limite de rată: la Tier 1, 500 de cereri și 500.000 de tokeni pe minut pentru ambele; la Tier 5, Sol ajunge la 15.000 de cereri și 40 de milioane de tokeni pe minut, Luna la 30.000 și 180 de milioane — de patru ori și jumătate mai mult loc pentru volum. Diferența de filosofie e vizibilă: Anthropic ia decizii în locul tău (thinking mereu pornit, fără forțarea uneltelor); OpenAI îți lasă butoanele și mută mai multă execuție la el.
Siguranță: ce declară fiecare și ce înseamnă pentru un agent
Nici aici nu există un test comun, deci raportăm separat.
Anthropic, despre Opus 5.5: modelul „egalează sau depășește Opus 5 în fiecare configurație testată” la prompt injection și „e la egalitate cu Fable 5.1 pentru cea mai mică rată de succes a injecțiilor dintre modelele testate” pe benchmarkul Gray Swan — afirmații ale Anthropic, pe evaluări alese de Anthropic. Safeguard-urile pentru biologie și securitate cibernetică urmează modelul Fable 5.1: cererile din aceste zone pot fi refuzate și redirecționate către programele de verificare (Life Sciences Verification Program, respectiv un program cyber extins). Modelul vine cu watermarking pentru conformitate cu Regulamentul (UE) 2024/1689. Pentru un agent de securitate ofensivă sau de bioinformatică, ruta de fallback se proiectează înainte de a măsura rata de reușită.
OpenAI, despre Sol și Luna: într-un harness sandbox, fără filtrele de producție, Sol „a acționat pe instrucțiunea neautorizată în doar 11,3% din rulări”, iar Luna și Astra „au rezistat în 100% din scenariile detectate”; la testul de ocolire a avertismentelor de securitate, Sol a încercat ocoliri în 64,4% din rulările neatenuate, Luna în 42,4%. Cifrele sunt raportate de OpenAI pe evaluări interne; „sandbox, fără filtre de producție” înseamnă că în producție rezultatele pot fi mai bune, dar nu știi cu cât. Tot OpenAI declară că Sol face „aproximativ jumătate din greșelile” lui GPT-5.6 Sol pe o evaluare internă de acuratețe factuală.
Niciuna dintre cifre nu înlocuiește un strat de apărare propriu în jurul uneltelor (allow-list de acțiuni, confirmare umană pentru operațiuni ireversibile). Modelele diferă prin cât de des cad în capcană, nu prin faptul că nu cad.
Disponibilitate în UE și în ecosistem
Opus 5.5 e disponibil de la lansare pe API-ul Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry și Claude Platform on AWS. Pentru rezidența datelor, Bedrock și Google Cloud au endpointuri regionale cu 10% în plus; pe API-ul Claude, inference_geo: "us" aplică 1,1×, iar rutarea globală (implicită) e la preț standard. Fast mode există doar pe API-ul first-party. Pentru o firmă din România cu contract existent pe AWS sau Google Cloud, Opus 5.5 intră pe factura și pe acordul de prelucrare existente.
Sol și Luna sunt livrate prin API-ul OpenAI (cu „procesare regională” la +10% în fișa de preț), în ChatGPT Work și Codex pe planurile plătite, iar Luna și pentru utilizatorii fără abonament plătit din aplicația desktop, cu rollout gradual. În GitHub Copilot, Sol e pe Pro+, Max, Business și Enterprise, Luna și pe Pro, cu facturare pe consum, în toate IDE-urile suportate; administratorii de Business și Enterprise pot dezactiva modelele din politica de modele. Pentru alte platforme cloud, fișele celor două modele nu spun nimic la data scrierii — verifică la furnizorul tău, nu presupune.
Dacă politica ta de date cere un anumit cloud, lista de mai sus decide înaintea oricărui benchmark.
Ce alegi, pe scenarii
Recomandările pornesc strict de la cifrele publicate și de la constrângerile de API; fiecare se validează pe evalul tău.
Coding agentic de lungă durată (sesiuni de ore, zeci de apeluri de unelte, context mare). Pentru Opus 5.5: singurele cifre de Terminal-Bench 4.0 și CursorBench 4.0 ale generației noi sunt ale lui (66,4% și 57,8%, la Anthropic), contextul de 1M e la preț fix, citirea din cache e la fel de ieftină ca la Sol. Pentru Sol: 68,8% pe DeepSWE (la OpenAI), hosted_shell și apply_patch gata făcute, cost la jumătate sub prag. Recomandare: Sol sub 272.000 de tokeni pe sesiune, Opus 5.5 peste; ambele pe același set de 30 de sarcini înainte de a te fixa. Urcă la Fable 5.1 sau Astra doar pentru sarcinile care au picat — vezi Opus 5.5 vs Fable 5.1.
Automatizare de volum (clasificare, extragere, sumarizare, rutare de tichete). Luna, ca prim nivel: la 0,10/0,50 $ și cu 180 de milioane de tokeni pe minut la Tier 5, celelalte două nu au sens economic aici. Sol sau Opus 5.5 intră doar ca nivel de escaladare pentru cazurile pe care Luna le marchează ca nesigure.
Muncă de birou și knowledge work (rapoarte, analize de documente, corespondență). Singurele cifre din generația nouă pe acest tip de sarcini sunt ale Anthropic: GDPval-AA 1846 Elo și AutomationBench 40,0%. OpenAI oferă pentru Sol 33,2% pe AutomationBench 1.0.6 la 0,27 $/sarcină și afirmația despre „jumătate din greșeli”. Recomandare: Opus 5.5 ca implicit unde acuratețea unui document contează mai mult decât costul; Sol unde volumul e mare și un om verifică oricum rezultatul; Luna pentru primul filtru.
Buget mic, echipă mică, un singur model. Sol. E la jumătatea prețului lui Opus 5.5 sub prag, are effort: none pentru sarcinile simple și lista completă de unelte găzduite. Trecerea la Opus 5.5 se justifică abia când evalul arată o diferență de reușită traductibilă în bani.
Ce nu recomandăm în niciun scenariu: alegerea după poziția în tabelul unui furnizor.
Metoda care bate orice tabel: evalul tău pe 30–50 de sarcini
- Extrage 30–50 de sarcini reale, rezolvate deja de echipă, cu rezultatul corect cunoscut (PR-uri cu teste, documente cu erorile marcate, tichete clasificate). Include deliberat 5–10 sarcini pe care modelul actual le-a greșit.
- Îngheață condițiile. Același prompt de sistem, aceleași unelte, aceleași fișiere. Fixează efortul explicit — implicitul e
mediumla toate trei, dar Opus 5.5 gândește mai mult per tur la același nivel, deci rulează și un nivel sub, și unul peste. - Măsoară pe rulare: reușit/ratat după criteriul scris dinainte, tokenii (noi, din cache, ieșire) din
usage, durata, numărul de pași. Calculează costul per sarcină reușită, nu costul mediu. - Rutează pe niveluri, nu alege un câștigător. Luna pentru volum și primul filtru; Sol sau Opus 5.5 pentru sarcinile complexe — pe care dintre ele, îți spune pasul 3; Fable 5.1 sau Astra doar acolo unde evalul arată că nivelul de mijloc nu ajunge. Prevede de la început ce se întâmplă la refuz (Anthropic) și la depășirea pragului (OpenAI).
- Scrie regula de decizie înainte de rulare — de exemplu „schimbăm modelul implicit doar dacă rata de reușită e cel puțin egală și costul per sarcină reușită scade cu minimum 25%” — și repet-o la fiecare lansare, cu același set. Cadrul complet (golden dataset, praguri, intervale de încredere, LLM-as-judge) e în cursul AI Evals pentru LLM-uri în Producție; interpretarea benchmark-urilor publicate de furnizori, în Comparație Modele AI 2026.
Rutarea pe niveluri am descris-o pe generația anterioară în Grok 4.6 vs GPT-5.6 Sol vs Claude Opus 5. Ce s-a schimbat pe 22 septembrie e că nivelul de mijloc a devenit atât de ieftin și de capabil încât nivelul de vârf a rămas, pentru majoritatea echipelor, o excepție documentată de eval, nu un implicit.
Întrebări frecvente
Este Claude Opus 5.5 mai bun decât GPT-6 Sol? Nu există o cifră publicată care să răspundă. Anthropic compară Opus 5.5 cu GPT-6 Astra și GPT-5.6 Sol, OpenAI compară Sol cu Astra, Fable și Opus 5; niciun furnizor nu le-a pus în același tabel. Cifrele existente (40,0% vs 33,2% pe AutomationBench) vin din tabele cu versiuni, efort și reguli de fallback diferite.
Cât costă Claude Opus 5.5 față de GPT-6 Sol și Luna? Opus 5.5: 4 $ intrare, 20 $ ieșire, 0,20 $ citire din cache, per milion de tokeni. Sol: 2 $, 10 $ și tot 0,20 $ la cache. Luna: 0,10 $, 0,50 $ și 0,01 $. Peste 272.000 de tokeni de intrare, Sol și Luna costă dublu la intrare și 1,5× la ieșire pentru toată cererea; Opus 5.5 nu are prag. Batch-ul înjumătățește prețul la toți trei.
De ce diferă cifrele Anthropic de cele OpenAI pentru același model? Pentru că rulează versiuni diferite ale testelor, la niveluri de efort diferite și cu reguli diferite pentru fallback și safeguards. GPT-6 Astra are 41,4% pe AutomationBench la Anthropic și 30,3% (la efort low) la OpenAI; Claude Opus 5 are 74,0% pe OSWorld 2.0 la Anthropic și 60,3% pe varianta offline la OpenAI. Sunt măsurători diferite cu același nume.
Care model AI alegi pentru un agent de coding în 2026? Pentru sesiuni sub 272.000 de tokeni, GPT-6 Sol are costul de listă cel mai mic și unelte găzduite de shell și patch; pentru context constant mai mare, Claude Opus 5.5 are contextul de un milion la preț fix și singurele scoruri publicate pe Terminal-Bench 4.0 și CursorBench 4.0 din generația nouă. Decizia se ia pe un eval cu 30–50 de sarcini reale, cu costul per sarcină reușită măsurat.
Pot folosi Claude Opus 5.5, GPT-6 Sol și Luna din România? Opus 5.5 e disponibil pe API-ul Claude, Amazon Bedrock, Google Cloud și Microsoft Foundry, cu endpointuri regionale la +10% pe platformele partenere. Sol și Luna sunt disponibile prin API-ul OpenAI, în ChatGPT și Codex pe planurile plătite și în GitHub Copilot; fișele lor nu menționează restricții geografice, dar nici alte platforme cloud. Rezidența datelor o verifici în contract, nu în anunț.
Concluzie
Cele trei modele lansate pe 22 septembrie 2026 împart nivelul de mijloc al pieței în două: Sol și Opus 5.5 pentru sarcini complexe, Luna pentru volum. Între primele două, lista de prețuri spune „Sol la jumătate”, dar citirea din cache identică, pragul de 272.000 de tokeni și comportamentul diferit la raționament fac ca pe multe fluxuri reale distanța să fie mult mai mică sau să dispară. Benchmark-urile publicate nu tranșează nimic, pentru că nu au fost rulate în aceleași condiții, iar cei doi furnizori obțin cifre diferite chiar și pentru aceleași modele ale concurenței.
Ce rămâne valabil indiferent de tabel: rutarea pe niveluri e arhitectura implicită, modelul de vârf e o excepție justificată de eval, iar singura comparație Opus 5.5 vs GPT-6 Sol care contează e cea pe care o rulezi tu, cu costul per sarcină reușită în coloana din dreapta.
Surse
- Anthropic, „Claude Opus 5.5” (pagina de lansare, tabelul de benchmark-uri și notele de metodologie): https://www.anthropic.com/claude-opus-5-5
- Anthropic Docs, „What's new in Claude Opus 5.5” (schimbări incompatibile, efort, safeguards, disponibilitate): https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Anthropic Docs, Pricing (tarife, cache, batch, fast mode, context lung, rezidența datelor): https://platform.claude.com/docs/en/about-claude/pricing
- OpenAI Docs, fișa modelului GPT-6 Sol (preț, prag 272K, efort, endpointuri, unelte, limite de rată): https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI Docs, fișa modelului GPT-6 Luna: https://developers.openai.com/api/docs/models/gpt-6-luna
- Vellum, „GPT-6 Sol and Luna benchmarks explained” (reproduce cifrele și notele publicate de OpenAI la lansare): https://www.vellum.ai/blog/gpt-6-sol-and-luna-benchmarks-explained
Articol informativ, publicat la 23 septembrie 2026. Prețurile, specificațiile și scorurile provin din documentația și materialele de lansare ale Anthropic și OpenAI, consultate la 23 septembrie 2026; sunt raportate de furnizori, nu de evaluatori independenți, și se pot schimba. Calculele de cost folosesc volume de tokeni ipotetice, declarate în text. Conținutul are caracter educativ și nu constituie consultanță juridică sau financiară.

Cursul care continuă acest articol
Arhitectura Sistemelor AI la Scară: Ghid Complet Enterprise (2026 Edition)
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente Arhitectură AI Enterprise
- Core Runtime și Orchestrare
- Date, RAG și Caching
- Scalare și Performanță
+ încă 3 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.