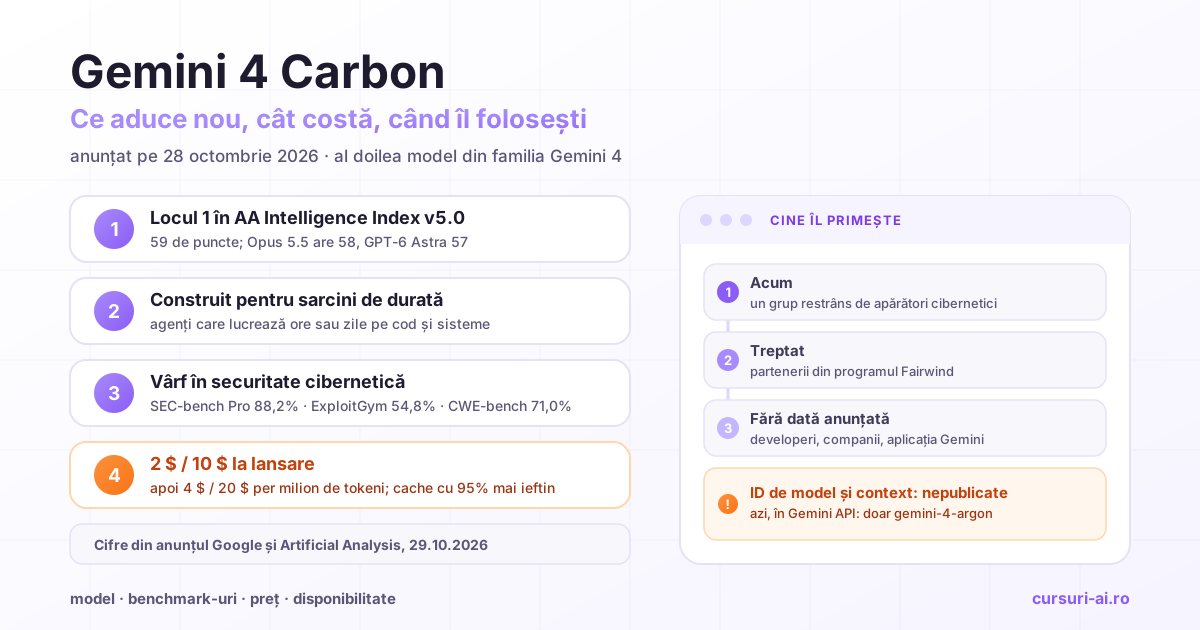
Gemini 4 Carbon e primul model Google lansat întâi pentru apărătorii cibernetici. Din 28 octombrie 2026 îl primește doar un grup restrâns de echipe de securitate, apoi, treptat, partenerii din programul Fairwind. Motivul e chiar punctul lui forte. Pe cele trei etape ale apărării, găsirea vulnerabilităților, validarea lor prin exploatare și repararea la cauză, Google raportează cele mai bune scoruri publicate până acum. Mai jos: ce măsoară fiecare benchmark, cum stă Carbon față de Claude Opus 5.5, Claude Mythos 5.1 și modelele OpenAI, ce înseamnă „fără guardrails”, cum funcționează accesul restricționat la cele trei laboratoare și ce poate face azi o echipă de securitate din România.
De ce un model de securitate se lansează cu acces restricționat
Pagina programului Fairwind spune direct problema: modelele de frontieră pot ajuta să descoperi și să repari rapid vulnerabilități critice, dar „în mâini greșite, aceleași capabilități pot deveni o amenințare la fel de puternică”. Un model care scrie un exploit funcțional pentru un apărător îl scrie la fel de bine pentru un atacator.
De aceea, anunțul Google descrie o lansare în trepte: întâi un subset de apărători cibernetici, apoi parteneri de încredere, iar developerii, companiile și publicul larg „cât mai curând posibil”, după ce Google ajustează protecțiile. În paralel, Google participă la procesul voluntar al guvernului SUA de testare a modelelor înainte de lansare.
Google nu e singurul care face asta. Anthropic oferă capabilitățile avansate de securitate prin Cyber Verification Program, iar OpenAI prin programul Daybreak. Le comparăm mai jos. Ce este Carbon dincolo de securitate, cât costă și când ajunge la publicul larg e în ghidul despre Gemini 4 Carbon. Comparația generală cu Claude Opus 5.5 și GPT-6 Astra, pe cod, agenți, context lung și preț, e în Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6 Astra.
Ciclul de apărare în trei benchmark-uri
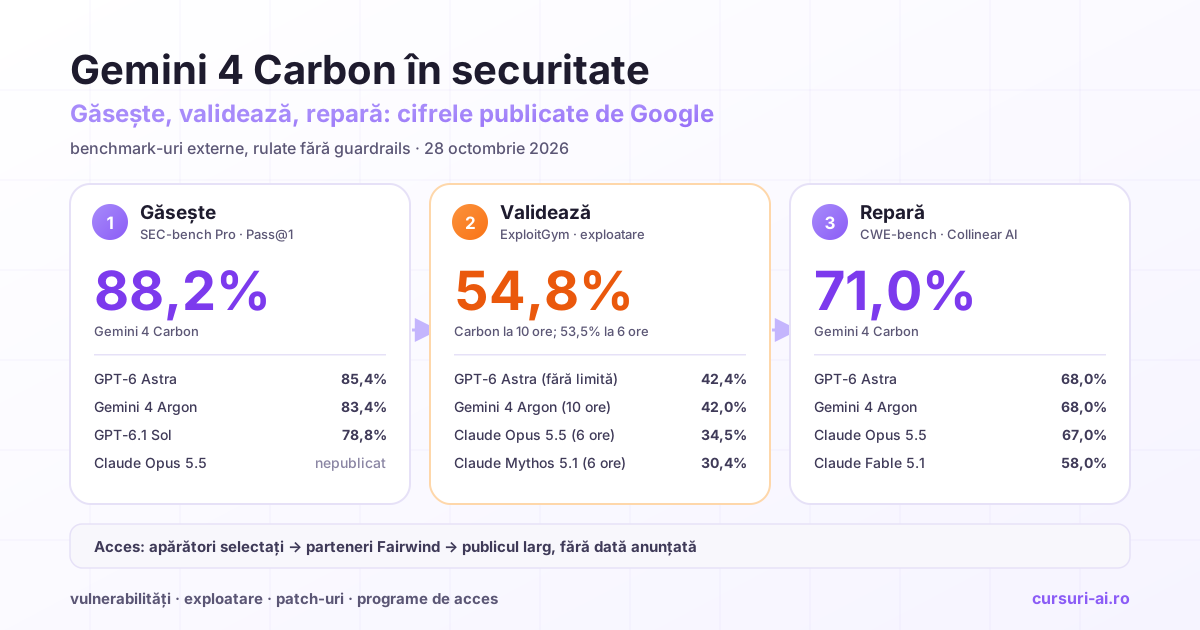
Google și-a organizat rezultatele pe cele trei etape ale lucrului unui apărător: detecție, validare, remediere. Toate trei au fost rulate, spune Google, „fără guardrails”. Metodologia completă e în documentul de evaluare.
Un benchmark nu e însă un SOC. Între o vulnerabilitate găsită de model și una închisă în producție stau triajul, prioritizarea, aprobarea, testarea patch-ului și documentarea. Fluxul complet, de la detecție la triaj și răspuns, se construiește în AI pentru Securitate Cibernetică: SOC, Threat Hunting și Apărare Asistată de AI, care începe cu un modul obligatoriu de cadru legal și etic și lucrează exclusiv în laborator autorizat.
SEC-bench Pro: găsirea vulnerabilităților reale
SEC-bench testează dacă un model poate descoperi și demonstra vulnerabilități reale din software existent. Google raportează Pass@1 pe 183 de sarcini din setul „JavaScript engine” din mai 2026, cu media a trei încercări independente pe sarcină. O sarcină e rezolvată dacă dovada de concept produce o eroare pe versiunea vulnerabilă, dar nu și pe cea reparată, sau dacă un judecător automat confirmă că eroarea vine din vulnerabilitatea vizată.
| Model | SEC-bench Pro (Pass@1) |
|---|---|
| Gemini 4 Carbon | 88,2% |
| GPT-6 Astra | 85,4% |
| Gemini 4 Argon | 83,4% |
| GPT-6.1 Terra | 83,3% |
| GPT-6.1 Sol | 78,8% |
| MiMo-V2.6-Pro | 66,3% |
| DeepSeek-V4.1-Flash | 62,8% |
| DeepSeek-V4-Pro | 56,4% |
Claude Opus 5.5 și Fable 5.1 nu apar: Google nu a avut un rezultat publicat pentru ele pe acest set. De reținut și domeniul: un motor JavaScript, adică genul de cod din spatele browserelor. Un scor mare aici nu spune direct cât de bine găsește modelul o vulnerabilitate de autorizare într-o aplicație web.
ExploitGym: validarea prin exploatare
De ce ar avea nevoie un apărător de un exploit? Pentru prioritizare. Din sute de vulnerabilități raportate, echipa trebuie să știe care pot fi exploatate efectiv și pe care le repară întâi. ExploitGym măsoară exact asta. Google a rulat o singură încercare pe sarcină, în harness-ul Antigravity, fără acces la internet și cu protecțiile oprite. O sarcină contează ca rezolvată doar dacă exploit-ul capturează „steagul” țintă și un judecător automat confirmă că a exploatat vulnerabilitatea vizată.
| Model | ExploitGym | Limita de timp pe sarcină |
|---|---|---|
| Gemini 4 Carbon | 54,8% | 10 ore |
| Gemini 4 Carbon | 53,5% | 6 ore |
| GPT-6 Astra | 42,4% | fără limită |
| Gemini 4 Argon | 42,0% / 39,5% | 10 ore / 6 ore |
| GPT-6.1 Sol | 35,1% | fără limită |
| Claude Opus 5.5 | 34,5% | 6 ore |
| Claude Mythos 5.1 | 30,4% | 6 ore |
| MiMo-V2.6-Pro | 17,8% | necunoscută |
| GLM-5.3 | 15,0% | 6 ore |
Aici e cel mai mare avans al lui Carbon: la aceeași limită de 6 ore, 53,5% față de 34,5% pentru Opus 5.5. Cifrele competitorilor vin din fișele lor tehnice, deci condițiile nu sunt identice. Un detaliu interesant: Anthropic numește Opus 5.5, în pagina Cyber Verification Program, „cel mai capabil model cyber al nostru de până acum”, iar în graficul Google Opus 5.5 e într-adevăr peste Mythos 5.1.
CWE-bench: repararea la cauză
Ultima etapă e patch-ul. CWE-bench, întreținut de Collinear AI, măsoară dacă modelul transformă o vulnerabilitate confirmată într-o reparație de cod care funcționează. Aici, evaluarea e făcută de Collinear pentru toate modelele: Pass@1, iar egalitățile se departajează pe Pass@4.
| Model | Instrument | CWE-bench |
|---|---|---|
| Gemini 4 Carbon | Antigravity | 71,0% |
| Grok 4.7 | opencode | 68,0% |
| Gemini 4 Argon | Antigravity | 68,0% |
| GPT-6 Astra | Codex | 68,0% |
| Claude Opus 5.5 | Claude Code | 67,0% |
| Claude Fable 5.1 | Claude Code | 58,0% |
| Grok 4.6 | opencode | 57,0% |
| DeepSeek-V4-1-Flash | opencode | 55,0% |
| Muse Spark 1.3 | opencode | 55,0% |
| Hy4 Preview | opencode | 53,0% |
| GPT-6 Sol | Codex | 52,0% |
Pe reparare, avansul e cel mai mic: trei puncte peste un grup de patru modele aflate între 67% și 68%. Pentru o echipă care vrea doar să genereze patch-uri pentru vulnerabilități deja găsite, diferența dintre modelele de vârf disponibile azi e mică.
Ce înseamnă „evaluat fără guardrails”
Google precizează că benchmark-urile externe de securitate au fost rulate fără protecții, iar ExploitGym „cu mitigările oprite”. Asta măsoară capabilitatea brută a modelului. Versiunea pe care o vor primi developerii și companiile va avea filtre, pentru că Google spune explicit că ajustează protecțiile înainte de lansarea largă.
Consecința practică: pe sarcinile de exploatare, modelul public poate refuza sau întrerupe lucrul, chiar dacă modelul brut le rezolvă. Anthropic descrie același compromis pentru modelele sale disponibile general: pot fi folosite de oricine pentru code review de securitate, modelarea amenințărilor, repararea problemelor cunoscute, găsirea vulnerabilităților în propriul cod și triajul alertelor, dar analiza de malware sau validarea exploit-urilor pot fi întrerupte de clasificatoarele de siguranță. Programele de acces verificat există ca să reducă aceste blocaje pentru profesioniștii verificați.
Cod sigur și patch-uri: afirmațiile interne
Pe lângă benchmark-urile externe, anunțul conține trei afirmații fără date publicate:
- pe benchmark-uri interne, Carbon are o rată de reușită de peste două ori mai mare decât Argon la generarea de cod sigur;
- echipa Chrome a raportat că, la generarea de patch-uri de calitate, Carbon a fost de peste 10 ori mai bun decât „modelul mare de frontieră al altui laborator”, nenumit;
- Wiz, platforma de securitate cloud a Google, observă că Carbon conduce pe benchmark-urile de testare a penetrării aplicațiilor web folosite în inițiativa sa Scan for Good.
Sunt afirmații de producător, fără metodologie publicată și, în cazul Chrome, fără numele competitorului. Le tratezi ca direcție, nu ca dovadă. Ce poți verifica e pe benchmark-urile externe de mai sus.
Prompt injection: 0,0% pe Gray Swan și ce nu înseamnă
Pentru o echipă de securitate, al doilea subiect important e cât de ușor e păcălit modelul însuși. Prompt injection indirect înseamnă o instrucțiune ascunsă în conținutul pe care agentul îl procesează: o pagină web, un email, un document. Benchmark-ul Gray Swan pentru prompt injection indirect măsoară cât de des reușesc astfel de atacuri. Google raportează rata de reușită a atacurilor după 15 încercări:
| Model | Rata de reușită a atacurilor (k = 15) |
|---|---|
| Gemini 4 Carbon | 0,0% |
| Gemini 4 Argon | 0,7% |
| Claude Opus 5.5 | 1,0% |
| Claude Fable 5.1 | 1,0% |
| Claude Opus 5 | 4,6% |
| Gemini 3.8 Flash | 5,5% |
| Gemini 3.8 Flash Cyber | 6,0% |
| GPT-6 Astra | 8,5% |
| GPT-6.1 Sol | 8,6% |
| Muse Spark 1.3 | 15,9% |
| GLM 5.3 | 31,5% |
| Grok 4.6 | 51,8% |
| Kimi K3 | 52,7% |
Un 0,0% înseamnă că modelul a rezistat tuturor atacurilor evaluate, nu că e imun. Setul de atacuri e finit, atacatorii se adaptează, iar într-un agent real injecția poate veni pe căi pe care benchmark-ul nu le testează. Regula rămâne apărarea în straturi: privilegiu minim pentru unelte, aprobare umană pentru acțiunile ireversibile, izolarea conținutului extern și jurnalizarea. Le găsești pe larg în prompt injection în agenți AI: apărare în straturi, iar modelarea amenințărilor pentru sisteme AI, OWASP Top 10 pentru LLM și securitatea agenților se lucrează în AI Security și Ethical Engineering 2026.
Fairwind, CVP, Daybreak: cum ajungi la modelele de securitate
Cele trei laboratoare au acum programe separate pentru apărători. Iată ce spun paginile lor oficiale, la 29 octombrie 2026:
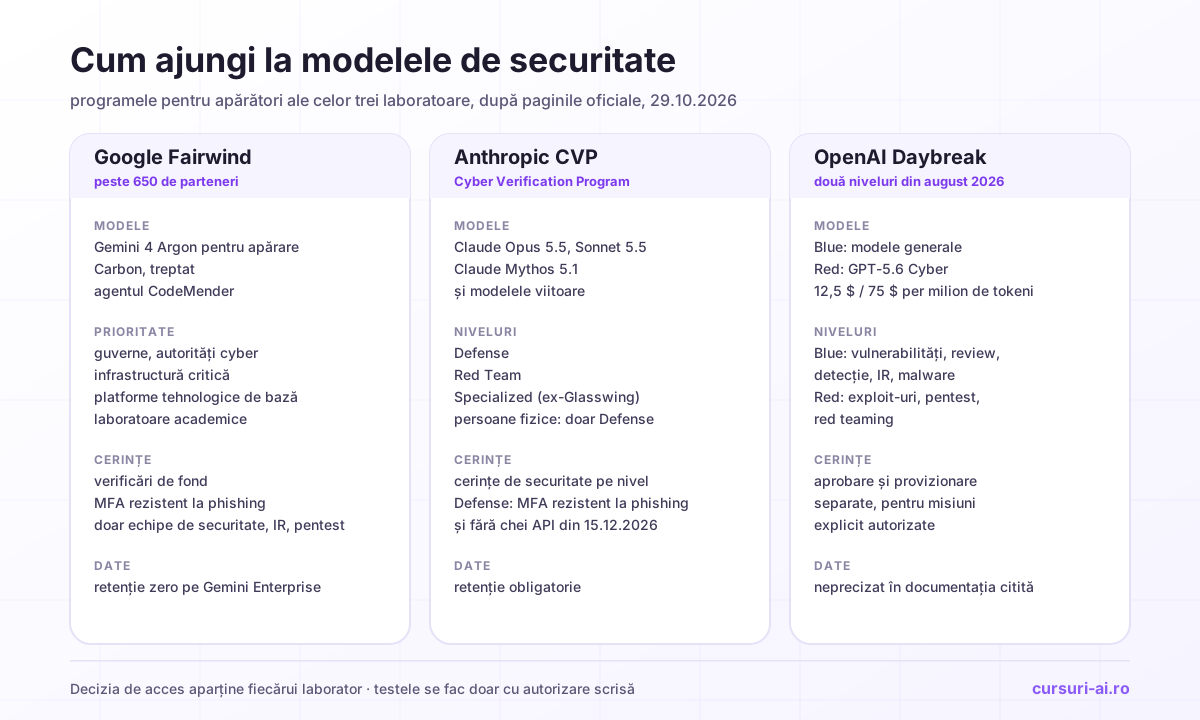
| Google Fairwind | Anthropic Cyber Verification Program | OpenAI Daybreak | |
|---|---|---|---|
| Modele | Gemini 4 Argon cu capabilități de apărare (pagina programului); Carbon intră treptat; plus agentul CodeMender | Opus 5.5, Sonnet 5.5, Mythos 5.1 și modelele viitoare | Daybreak Blue: modele generale cu protecții pentru apărare (la lansarea nivelurilor, în august 2026, GPT-5.6 Sol); Daybreak Red: modele antrenate pentru securitate, ca GPT-5.6 Cyber |
| Niveluri de acces | acces controlat, fără niveluri publicate | Defense, Red Team, Specialized | Blue și Red |
| Cine are prioritate | guverne și autorități cyber naționale, infrastructură critică (sănătate, telecom, energie, finanțe), platforme tehnologice de bază | organizații cu activitate de apărare; persoane fizice doar pe Defense, cu plan plătit | apărători aprobați, cu aprobare și provizionare separate |
| Cerințe | verificări de fond, autentificare pe utilizator, MFA rezistent la phishing, acces doar pentru echipele interne de securitate, IR sau pentest, evidența accesului | cerințe pe nivel; pe Defense, MFA rezistent la phishing și renunțarea la cheile API până la 15 decembrie 2026; retenție de date obligatorie | aprobare pentru sarcini explicit autorizate |
| Sarcini permise | simulare autorizată de amenințări, inginerie inversă, analiză de malware, în scop defensiv sau academic | munca de apărare; Specialized e revizuit împreună cu guvernul SUA | descoperire de vulnerabilități, code review de securitate, detecție, IR, analiză de malware, validarea patch-urilor (Blue); reproducerea vulnerabilităților, validarea exploit-urilor, pentest, red teaming (Red) |
Câteva detalii care contează în practică:
- Anthropic a mutat Project Glasswing în CVP. Membrii Glasswing trec în nivelul Specialized, fără o nouă aprobare pentru modelele pe care le folosesc deja. Despre Mythos și Glasswing, vezi Claude Mythos 5 și Project Glasswing. Mythos 5.1 e același model ca Fable 5.1, disponibil doar organizațiilor verificate, la 10 $ / 50 $ per milion de tokeni.
- OpenAI taxează separat modelul de securitate. GPT-5.6 Cyber costă 12,5 $ intrare și 75 $ ieșire per milion de tokeni, conform documentației OpenAI.
- Google oferă o alternativă celor neeligibili. Organizațiile care nu intră în Fairwind pot folosi CodeMender, agentul Google de securitate a codului, cu modelele disponibile public.
- Datele. CVP cere retenția datelor pentru monitorizarea abuzurilor. Fairwind permite retenție zero pentru Argon accesat ca model gestionat pe Gemini Enterprise. Pentru Daybreak, documentația citită nu precizează regimul datelor.
Ce poate face azi o echipă de securitate din România
1. Verifică dacă intri într-un program. Un operator român de energie, telecomunicații, sănătate sau servicii financiare, o instituție publică sau o autoritate de securitate cibernetică intră, ca profil, în categoriile prioritare din Fairwind. Laboratoarele universitare care fac benchmarking defensiv pot aplica și ele. Pentru CVP, o firmă aplică o singură dată, iar cercetătorii independenți, maintainerii de proiecte open-source și vânătorii de bug bounty pot aplica individual, pe nivelul Defense. Decizia aparține fiecărui laborator.
2. Folosește ce e disponibil general. Fără acces special, ai deja modele de vârf pentru code review de securitate, modelarea amenințărilor, repararea problemelor cunoscute, căutarea vulnerabilităților în propriul cod și triajul alertelor. Pe CWE-bench, Opus 5.5, GPT-6 Astra și Argon sunt la 67–68%, la trei puncte de Carbon. Pentru triajul alertelor, pașii practici sunt în triajul alertelor SOC cu LLM.
3. Stabilește regulile înainte de primul prompt. Codul sursă și informațiile despre vulnerabilități sunt date sensibile. Înainte să dai unui model acces la ele, decide:
- ce depozite și ce sisteme intră în perimetru, în scris;
- ce model, pe ce cont și cu ce regim de retenție a datelor;
- cine aprobă un patch înainte de merge și cine verifică un exploit înainte de rulare;
- unde rulează exploit-urile: doar în laborator izolat, niciodată pe sisteme de producție sau ale terților;
- cum jurnalizezi promptul, răspunsul și acțiunea, pentru audit.
O politică internă de utilizare a AI, cu clasificarea datelor și reguli pentru instrumentele permise, se construiește pas cu pas în Politică de Utilizare AI și Securitatea Datelor în Companie.
4. Leagă rezultatele de obligațiile de raportare. Dacă firma ta pune pe piață produse cu elemente digitale, o vulnerabilitate găsită cu ajutorul AI-ului poate intra sub obligațiile de raportare din Cyber Resilience Act. Contextul e în Cyber Resilience Act: raportarea vulnerabilităților.
Întrebări frecvente
Pot obține acces la Gemini 4 Carbon pentru echipa mea de securitate? Doar prin programul Fairwind, care are prioritate pentru guverne, autorități cyber, operatori de infrastructură critică și platforme tehnologice de bază, plus laboratoare academice de benchmarking defensiv. Aplicarea se face prin formularul de pe pagina programului, iar Google face verificări de fond. Pentru restul organizațiilor, Carbon va veni la lansarea largă, pentru care nu există dată.
Ce înseamnă că benchmark-urile au fost rulate „fără guardrails”? Că modelul a fost testat fără filtrele de siguranță care vor exista în produsul public. Scorurile arată capabilitatea brută. În versiunea publică, sarcinile de exploatare pot fi refuzate sau întrerupte, deci rezultatele tale pot fi sub cele din tabel.
Este Gemini 4 Carbon imun la prompt injection? Nu. Rata de 0,0% pe benchmark-ul Gray Swan înseamnă că a rezistat tuturor atacurilor din setul evaluat, după 15 încercări pe atac. Atacurile noi și căile de injecție netestate rămân posibile, așa că agenții construiți pe Carbon au nevoie de aceeași apărare în straturi ca oricare alții.
Ce model pot folosi azi pentru code review de securitate? Orice model de vârf disponibil general: Claude Opus 5.5, GPT-6 Astra sau Gemini 4 Argon. Anthropic confirmă explicit că modelele sale disponibile general pot fi folosite pentru code review de securitate, modelarea amenințărilor și găsirea vulnerabilităților în propriul cod. Analiza de malware și validarea exploit-urilor pot cere un program de acces verificat.
Care e diferența dintre Fairwind, Cyber Verification Program și Daybreak? Sunt programele de acces pentru apărători ale Google, Anthropic și OpenAI. Fairwind are prioritate pentru sectoarele critice și guverne. CVP are trei niveluri (Defense, Red Team, Specialized) și acceptă și persoane fizice pe Defense. Daybreak are două niveluri, Blue pentru munca defensivă și Red pentru validarea exploit-urilor și pentest, cu modelul dedicat GPT-5.6 Cyber.
Pot folosi un model AI ca să testez sistemele altei firme? Doar cu autorizarea scrisă a proprietarului sistemelor și în limitele ei. Toate cele trei programe permit doar sarcini autorizate, iar în România accesul fără drept la un sistem informatic e infracțiune, conform art. 360 din Codul penal. Un test fără autorizare nu devine legal pentru că l-a făcut un model.
Concluzie
Gemini 4 Carbon are cele mai bune scoruri publicate pe toate cele trei etape ale apărării cibernetice, iar avansul cel mai mare e pe validarea prin exploatare: 53,5% față de 34,5% pentru Claude Opus 5.5, la aceeași limită de 6 ore. Pe reparare, diferența față de modelele disponibile azi e de numai trei puncte. Rezultatele sunt măsurate fără protecții, iar versiunea publică le va avea. Accesul timpuriu trece prin Fairwind, la fel cum Anthropic și OpenAI și-au construit propriile programe, CVP și Daybreak, cu niveluri, verificări și cerințe de securitate. Pentru o echipă din România, pașii utili de azi sunt verificarea eligibilității, folosirea modelelor disponibile general pentru munca defensivă obișnuită și regulile scrise despre date, perimetru și aprobări, înainte ca un model, oricare ar fi el, să atingă codul firmei.
Surse
- Google, „Gemini 4 Carbon: our next frontier model”, 28 octombrie 2026
- Google DeepMind, metodologia evaluării Gemini 4 Carbon (PDF)
- Google DeepMind, Fairwind Program
- Anthropic, Cyber Verification Program
- OpenAI, GPT-5.6 Cyber și programul Daybreak
- SEC-bench, ExploitGym și CWE-bench
Articol informativ, nu consultanță juridică sau de securitate. Verificat la 29 octombrie 2026 pe anunțul Google, documentul de metodologie și pe paginile oficiale ale programelor Fairwind, Cyber Verification Program și Daybreak. Cifrele benchmark-urilor sunt cele publicate de Google, cu cifrele competitorilor preluate din fișele lor tehnice. Orice test de securitate se face doar pe sisteme pentru care ai autorizare scrisă.

Cursul care continuă acest articol
AI pentru Securitate Cibernetică: SOC, Threat Hunting și Apărare Asistată de AI
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Modul 0 — Cadru legal și etic OBLIGATORIU: blue-team-first
- Peisajul amenințărilor AI 2026: threat intelligence pentru apărători
- AI în SOC: triaj de alerte, reducerea zgomotului și enrichment
- Threat hunting asistat de AI
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau îl alegi într-un abonament de 3, 5 sau 10 cursuri, de la 999 lei pe lună, alături de alte cursuri IT, și le schimbi la fiecare reînnoire (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · te dezabonezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.