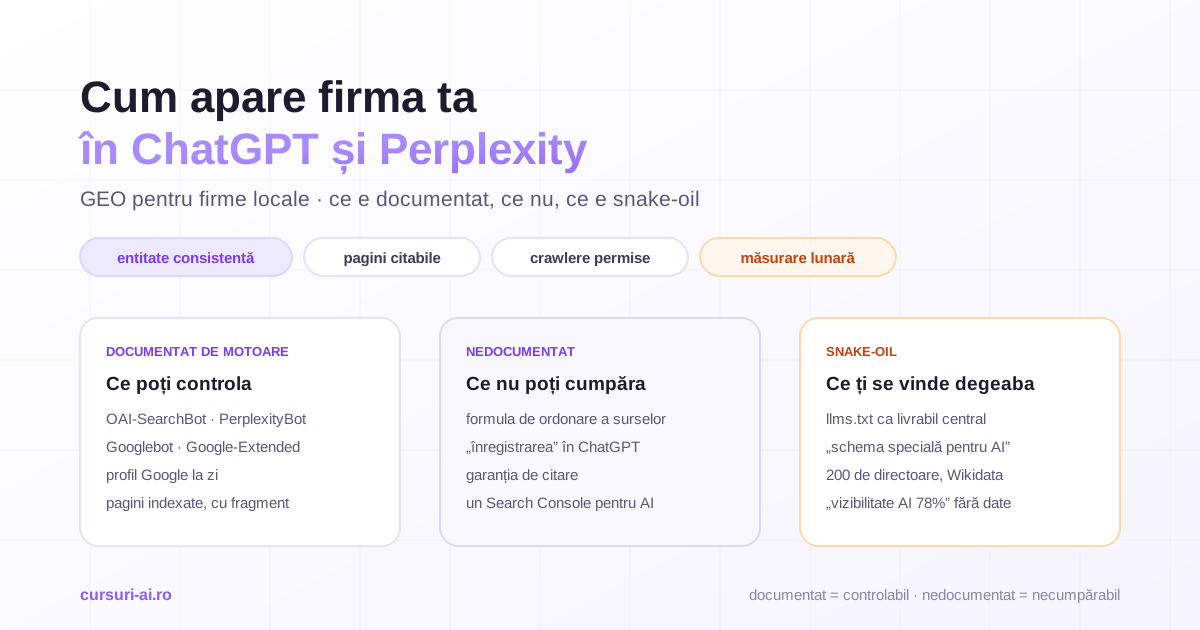
Cum apare firma ta în ChatGPT și în Perplexity nu se decide dintr-un panou de administrare, ci în trei locuri pe care le controlezi doar parțial: ce știu motoarele despre firma ta ca entitate, ce pagini de-ale tale merită citate și dacă roboții lor au voie să le citească. Felul în care fiecare motor alege sursele e documentat public doar în parte, iar tot ce depășește documentația e speculație vândută ca metodă. Ghidul de față e pentru o firmă locală sau un IMM: ce faci concret, în ce ordine și cum verifici după 30, 60 și 90 de zile dacă a avut efect.
Ce se întâmplă când cineva întreabă „cel mai bun service de biciclete din Cluj”
Trei motoare, trei mecanisme și un singur punct comun: niciunul nu publică formula după care ordonează sursele. Ce e documentat public, la 22 septembrie 2026:
ChatGPT. Documentația OpenAI despre crawlere separă trei roboți: OAI-SearchBot există ca site-urile să apară în rezultatele funcției de căutare din ChatGPT, GPTBot colectează conținut pentru antrenarea modelelor, iar ChatGPT-User deschide pagini la cererea unui utilizator. Fraza care contează pentru o firmă: site-urile care refuză OAI-SearchBot „nu vor fi afișate în răspunsurile căutării din ChatGPT, deși pot apărea în continuare ca linkuri de navigare”. Cum alege ChatGPT între sursele pe care are voie să le afișeze nu e documentat public.
Perplexity. Documentația Perplexity pentru webmasteri descrie PerplexityBot ca robotul „proiectat să afișeze și să lege site-uri în rezultatele de căutare din Perplexity”, nefolosit pentru antrenarea modelelor de bază; Perplexity-User vizitează pagini când un utilizator întreabă ceva și, spune Perplexity, „în general ignoră regulile din robots.txt”. Răspunsurile vin cu citări numerotate, ceea ce face din Perplexity cel mai ușor motor de diagnosticat: vezi exact cine a fost citat în locul tău. Ordonarea surselor nu e descrisă public nici aici; produsul e prezentat în ghidul despre Perplexity.
Google AI Overviews și AI Mode. Modul AI e disponibil în România și în limba română din octombrie 2025, conform anunțului Google România, care descrie și mecanismul: „instrumentul împarte întrebarea în subiecte secundare și le caută simultan pe fiecare dintre ele”. Documentația Google Search Central despre funcțiile AI spune că nu există „cerințe suplimentare” ca să apari în AI Overviews sau AI Mode — pagina trebuie să fie indexată și eligibilă pentru un fragment în Căutare — și că „nu trebuie să creezi fișiere noi citibile automat, fișiere text pentru AI sau markup” pentru aceste funcții. Tot acolo apare singura mențiune explicită despre firme: „asigură-te că informațiile din Merchant Center și din Business Profile sunt la zi”. Profilul Google alimentează direct răspunsul, nu doar harta.
Tot ce urmează e construit pe această asimetrie: ce e documentat e ce poți controla; ce nu e documentat e ce nu poți cumpăra. Vocabularul (SEO, AEO, GEO), datele despre clickuri și poziția Google că „AEO și GEO sunt tot SEO” sunt tratate în ghidul general despre SEO în era AI; aici rămânem la firma concretă. Metodologia completă — de la auditul de vizibilitate până la raportarea onestă către un client — e parcursă pas cu pas în cursul SEO și AEO/GEO în era AI; articolul de față e versiunea pentru o singură firmă, cu buget de timp, nu de agenție.
Exemplu de lucru: „Atelier Roată”, service de biciclete din Cluj-Napoca
Firma de mai jos e fictivă, construită ca să urmărim un caz de la capăt la capăt; problemele ei sunt cele pe care le găsești la majoritatea firmelor locale.
Atelier Roată are un site de patru pagini făcut în 2021, un profil Google cu 60 de recenzii și un cont de Instagram activ. Proprietarul pune aceeași întrebare în ChatGPT cu căutarea activată, în Perplexity și în AI Mode: „cel mai bun service de biciclete din Cluj-Napoca”. Rezultatul:
| Motor | Firme numite | Atelier Roată | Surse citate |
|---|---|---|---|
| ChatGPT (căutare) | 4 | nu | două directoare, un forum, un blog local |
| Perplexity | 5 | da, ultima, cu numele greșit („Atelierul Roată”) | profilul Google, un director, site-ul unui concurent |
| Google AI Mode | 3 | nu | profiluri Google, o pagină de comparație de pe un blog local |
Trei constatări, fiecare cu o cauză precisă:
- Numele apare în trei variante. Pe site „Atelier Roată SRL”, pe profilul Google „Atelierul Roată”, într-un director vechi „Roata Bike Service”. Motorul a preluat una dintre ele; entitatea e fragmentată.
- Site-ul nu răspunde la nicio întrebare. Pagina „Servicii” listează opt servicii fără prețuri, durată sau program. Sursele citate au fost cele care spuneau ceva concret: un blog care compara trei ateliere pe preț și timp de așteptare.
- Perplexity a citat profilul Google, nu site-ul. Profilul avea program, recenzii și fotografii; site-ul nu avea nimic verificabil.
Niciuna dintre cele trei probleme nu se rezolvă cu un fișier sau cu un abonament, ci cu cei patru piloni de mai jos.
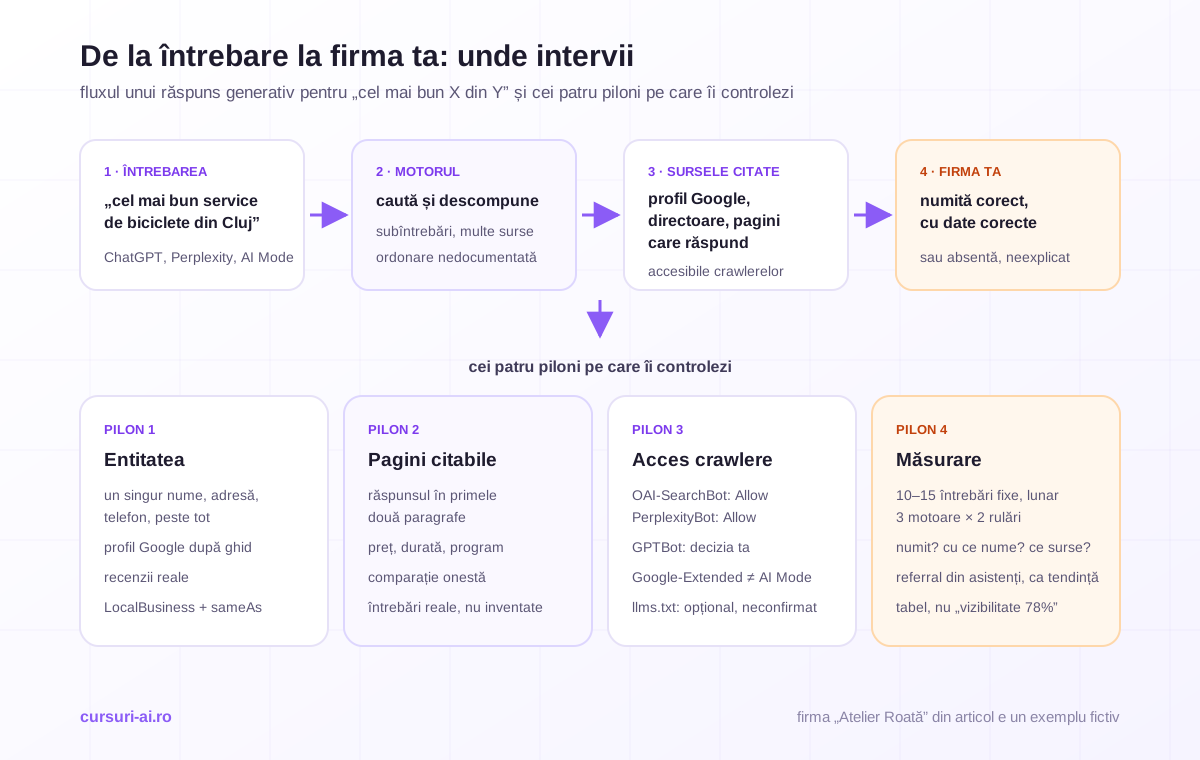
Pilonul 1: entitatea firmei — un singur nume, aceleași date, peste tot
Un motor generativ nu „știe” firma ta; știe un nod de informații găsite în mai multe locuri, pe care le consideră despre același lucru. Cu cât datele coincid, cu atât nodul e mai stabil; cu cât diferă, cu atât e mai probabil să te descrie greșit sau să te ignore.
NAP: nume, adresă, telefon — identice. Nu „aproape identice”. Alege o singură formă a numelui (cea de pe firmă și de pe factură), a adresei și a telefonului, apoi corectează fiecare loc în care apar altfel: site, profil Google, directoare, rețele sociale, semnătura de e-mail, platforme de rezervări. E o muncă de o zi, cu efect direct.
Profilul Google, după regulile Google. Ghidul oficial pentru reprezentarea firmei pe Google e explicit: numele „trebuie să reflecte numele real al firmei, așa cum e folosit consecvent pe fațadă, pe site, pe documente”, fără sloganuri, cuvinte-cheie sau localitate în nume; telefonul să fie local și direct, nu un call center; categoriile „cât mai puține”, alese pentru a completa propoziția „această firmă ESTE un…”. Un profil cu „Atelier Roată — Service Biciclete Cluj Reparații Rapide” în câmpul de nume încalcă ghidul și fragmentează entitatea. Întreținerea profilului, răspunsul la recenzii și postările sunt tratate în ghidul pentru afaceri locale cu AI; aici contează doar consistența.
Directoare puține; Wikidata deloc. Te înscrii în directoarele pe care motoarele le-au citat în testul de mai sus și în cele de profil (asociații, platforme de rezervări din domeniu); fiecare listare în plus e încă un loc în care datele pot diverge. Wikidata, cerută des în oferte ca pas obligatoriu, acceptă entități descrise prin referințe serioase, publice și independente; o firmă locală fără presă și fără articol de enciclopedie nu îndeplinește criteriul, iar un element creat pentru autopromovare poate fi propus la ștergere.
Recenzii reale, gestionate. Motoarele au citat profiluri cu recenzii pentru că recenziile sunt text verificabil despre firmă, scris de altcineva. Cere recenzii clienților reali, răspunde la toate, nu cumpăra niciuna: pe lângă riscul legal tratat în ghidul pentru afaceri locale, o recenzie falsă e exact textul pe care un motor îl poate contrazice cu alte surse.
Datele structurate pentru entitate. Pe pagina de contact, un bloc LocalBusiness (sau un subtip mai precis) cu aceleași nume, adresă și telefon ca peste tot, plus sameAs către profilurile oficiale. Nu ca „cod magic” — Google spune explicit că nu există schema specială pentru funcțiile AI — ci ca a doua declarație a entității, citibilă automat, care trebuie să coincidă cu prima.
Pilonul 2: pagini citabile — răspunsul înainte de argument
În exemplul nostru, motoarele au citat blogul care compara trei ateliere — nu pentru autoritate, ci pentru că răspundea la întrebare. Un site de firmă locală are, de regulă, zero pagini care răspund la o întrebare; are pagini care descriu. O pagină citabilă are răspunsul în primele două paragrafe, cu date verificabile, apoi detaliile. Pentru Atelier Roată, trei pagini noi ar schimba testul:
- Pagina de serviciu cu date, nu cu adjective. „Revizie completă: 180 lei, 24 de ore, include reglaj frâne și schimbător; programare la telefon sau online; program luni–vineri 9–18.” Preț, durată, ce include, cum programezi: fiecare cifră e o afirmație pe care motorul o poate extrage și atribui.
- Pagina de comparație onestă. „Revizie la atelier vs. acasă vs. în magazinul de unde ai cumpărat bicicleta: ce diferă, cât costă, când merită fiecare.” Comparațiile în care firma nu câștigă la toate rândurile sunt cele mai citate, pentru că par scrise pentru cititor.
- Pagina de întrebări reale. Cele zece întrebări pe care le primești la telefon, cu răspunsuri de două-trei propoziții, nu o listă inventată ca să încapă cuvinte-cheie.
Un detaliu pe care ofertele îl omit: Google afișează rezultatele îmbogățite de tip FAQ doar pentru „site-uri guvernamentale și medicale cunoscute și autoritare”, deci nu vei primi o casetă specială în rezultate. Markup-ul FAQPage rămâne util ca descriere a conținutului, nu ca instrument de afișare — pune-l dacă e simplu de întreținut, nu-l plăti separat.
Un exemplu de JSON-LD LocalBusiness
Documentația Google pentru datele structurate LocalBusiness cere doar două proprietăți — name și address — și recomandă, printre altele, telephone, openingHoursSpecification, geo, priceRange și url, cu îndemnul de a folosi „cel mai specific subtip LocalBusiness posibil”, de exemplu Restaurant, Dentist, Electrician, Plumber. Un bloc minim pentru atelierul fictiv, cu adresă și telefon generice:
{
  "@context": "https://schema.org",
  "@type": "LocalBusiness",
  "name": "Atelier Roată",
  "url": "https://exemplu.ro/",
  "telephone": "+40 264 000 000",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "Strada Exemplu 10",
    "addressLocality": "Cluj-Napoca",
    "postalCode": "400000",
    "addressCountry": "RO"
  },
  "openingHoursSpecification": [{
    "@type": "OpeningHoursSpecification",
    "dayOfWeek": ["Monday", "Tuesday", "Wednesday", "Thursday", "Friday"],
    "opens": "09:00",
    "closes": "18:00"
  }],
  "priceRange": "80-400 lei",
  "sameAs": ["https://www.instagram.com/exemplu"]
}
Două reguli din aceeași documentație Google: datele structurate trebuie să corespundă textului vizibil (un program în JSON-LD diferit de cel afișat e o inconsistență, nu o optimizare), iar blocul se validează înainte de publicare cu testul de rezultate îmbogățite al Google sau cu validatorul schema.org.
Pilonul 3: accesul crawlerelor — cine are voie să te citească
O firmă locală nu are, de obicei, motive să blocheze roboții de căutare AI; are motive să știe ce lasă și ce nu. Numele exacte, din documentațiile oficiale citate mai sus:
| Robot (token în robots.txt) | Furnizor | La ce servește | Respectă robots.txt |
|---|---|---|---|
OAI-SearchBot |
OpenAI | afișarea site-ului în căutarea din ChatGPT | da; schimbarea se reflectă în „aproximativ 24 de ore” |
GPTBot |
OpenAI | conținut pentru antrenarea modelelor | da |
ChatGPT-User |
OpenAI | pagini deschise la cererea unui utilizator | „regulile pot să nu se aplice” |
PerplexityBot |
Perplexity | afișarea și legarea site-urilor în rezultatele Perplexity | da |
Perplexity-User |
Perplexity | pagini vizitate când un utilizator întreabă | „în general ignoră” regulile |
Google-Extended |
antrenarea și fundamentarea în alte sisteme Google | da; nu afectează Căutarea |
Două lucruri pe care le confundă aproape toate ofertele:
Google-Extendednu te scoate din AI Overviews sau AI Mode. Documentația Google îl descrie drept controlul pentru „antrenarea și fundamentarea în alte sisteme Google”, fără user-agent propriu și fără efect asupra includerii în Căutare. Pentru funcțiile AI din Căutare se aplică aceleași controale ca pentru fragmente:nosnippet,data-nosnippet,max-snippet,noindex.- Roboții „User” nu sunt crawlere. Sunt un om care a întrebat ceva și un asistent care deschide pagina ta ca să răspundă. Dacă pagina cere consimțământ pentru cookie-uri înainte de a arăta conținutul sau e randată exclusiv în JavaScript, asistentul poate primi o pagină goală — o cauză de invizibilitate fără legătură cu
robots.txt.
Configurația rezonabilă pentru o firmă locală care vrea vizibilitate în răspunsuri și refuză antrenarea:
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /
Mecanica completă — grupurile din robots.txt, verificarea identității roboților după adresa IP, rezervarea drepturilor cu efect juridic — e în articolul despre crawlerele AI. Aici e suficient să verifici două lucruri într-un sfert de oră: că robots.txt nu blochează din greșeală roboții de căutare (un Disallow: / pus pentru * acum cinci ani îi blochează și pe ei) și că paginile răspund cu conținut real unei cereri făcute cu unul dintre user-agenții de mai sus.
llms.txt: statutul real la 22 septembrie 2026
Pentru că apare în aproape fiecare ofertă de „optimizare pentru AI”, merită o secțiune separată, doar cu ce se poate verifica.
Ce este. O propunere publicată pe llmstxt.org de Jeremy Howard, în septembrie 2024: un fișier Markdown în rădăcina site-ului, cu un titlu, un rezumat și liste de linkuri către paginile importante, gândit ca modelele de limbaj să găsească rapid ce contează. Pagina propunerii notează că laboratoarele AI publică astfel de fișiere pentru propria documentație pentru dezvoltatori; nu afirmă că vreunul consumă fișierul altor site-uri în produsele de căutare.
Ce a spus Google. Documentația Search Central citată mai sus e formularea oficială: nu ai nevoie de „fișiere text pentru AI” ca să apari în AI Overviews sau AI Mode. În iunie 2026, John Mueller a descris fișierul, potrivit Search Engine Journal, drept „pur speculativ deocamdată” și a formulat regula practică: fă-l în ziua în care o platformă AI care îți aduce clienți îți spune că are nevoie de el.
Ce au spus OpenAI și Perplexity. Nimic, din câte am putut verifica: documentațiile lor pentru webmasteri descriu roboții și robots.txt, nu llms.txt. La data articolului nu există o confirmare oficială din partea vreunui motor generativ major că fișierul e folosit ca semnal în produsele de căutare sau de răspuns. Dacă apare una, va fi datată și publică — și atunci merită reevaluat.
Ce faci, deci. Tratează-l ca pe o opțiune cu cost mic și beneficiu nedovedit: dacă îl poți genera automat din sitemap și nu-l lași să se învechească, nu strică; dacă cineva ți-l facturează ca livrabil central sau ca „înregistrare în motoarele AI”, ai un semnal de alarmă. Nu înlocuiește robots.txt, datele structurate sau paginile care răspund la întrebări. Singura utilitate practică observată e în documentația tehnică citită de asistenți de programare — irelevantă pentru un service de biciclete.
Pilonul 4: măsurarea — cum afli dacă a avut efect
Nu există un Search Console pentru ChatGPT sau Perplexity. Măsurarea e manuală, lunară și mai valoroasă decât orice raport cumpărat, cu condiția să fie făcută la fel de fiecare dată.
Setul de interogări de test. Zece–cincisprezece întrebări pe care le-ar pune un client real, în română, cu localitatea inclusă: „cel mai bun service de biciclete din Cluj”, „unde repar o frână hidraulică în Cluj”, „cât costă o revizie de bicicletă în Cluj-Napoca”, „service biciclete Cluj deschis sâmbăta”. Aceleași întrebări, în aceeași ordine, lunar, în cele trei motoare, cu căutarea activată în ChatGPT, de două ori fiecare: răspunsurile variază între rulări, iar două rulări arată dacă apariția e stabilă sau întâmplătoare.
Ce notezi, într-un tabel: data, motorul, întrebarea, dacă firma a fost numită, pe ce poziție, cu ce nume, ce s-a afirmat despre ea și ce surse au fost citate. Coloana cu sursele e cea mai utilă: îți spune pe cine crede motorul și unde trebuie să fii prezent corect.
Referral și Search Console. În analytics, vizitele din chatgpt.com și perplexity.ai apar ca trafic de referință atunci când asistentul afișează un link pe care cineva chiar dă click; sunt cifre mici pentru o firmă locală și nu măsoară mențiunile fără click, dar sunt singurele date de comportament real — urmărește-le ca tendință. Pentru Google, documentația spune că traficul din AI Overviews și AI Mode e raportat în raportul de performanță din Search Console, în tipul de căutare „Web”, fără separare: nu poți izola clickurile din funcțiile AI, dar poți urmări întrebările pentru care apari după ce publici paginile citabile.
Ce înseamnă o cifră. „Apărem la 6 din 12 întrebări în Perplexity, cu numele corect, în luna a treia, față de 1 din 12 în prima lună” e o măsurătoare. „Vizibilitate în AI 78%” dintr-un raport, fără lista de întrebări, motoare, dată și număr de rulări, nu e.
Planul pe 30, 60 și 90 de zile
Zilele 1–30: entitatea și accesul. Testul de referință cu setul de întrebări (o oră). Forma unică a numelui, adresei și telefonului, corectată peste tot (o zi). Profilul Google adus la ghidul Google: nume real, categorii puține, program, telefon local, fotografii recente (două ore). Verificarea robots.txt și a unei cereri cu user-agent de robot AI (un sfert de oră). Blocul LocalBusiness pe pagina de contact, validat (o oră).
Zilele 31–60: paginile citabile. Trei pagini: serviciul principal cu preț, durată, ce include și cum programezi; o comparație onestă pe o decizie reală a clientului; întrebările reale de la telefon, cu răspunsuri scurte. Fiecare cu răspunsul în primele două paragrafe și cu data actualizării vizibilă. Dacă produci conținutul cu un asistent AI, fluxul de briefing, verificare și voce de brand e subiectul cursului AI pentru Content Creation; regula care nu se negociază e că fiecare cifră de pe pagină e a ta și e adevărată.
Zilele 61–90: recenzii, mențiuni, a doua măsurătoare. Procesul de cerut recenzii de la clienți reali, după fiecare lucrare, cu răspuns la fiecare. Două–trei mențiuni legitime: o listare corectă într-un director de profil, un articol al unei publicații locale la care ai ceva de spus, un parteneriat real. A doua rulare completă a setului de întrebări, în același tabel, și comparația cu prima. Cum se leagă acest canal de restul marketingului firmei — profil, e-mail, campanii plătite — e tratat în cursul AI în Digital Marketing.
Ce nu e în plan: un abonament la o unealtă de monitorizare, un fișier care „te înregistrează în AI”, o campanie de mențiuni cumpărate. Trei luni de muncă pe patru piloni produc mai mult decât oricare dintre ele, iar la capăt ai un tabel pe care poți lua decizii.
Ce funcționează și ce e snake-oil
| Afirmația din ofertă | Verdict | De ce |
|---|---|---|
| „Aducem NAP-ul și profilul Google la zi și le ținem consistente” | funcționează | singura mențiune despre firme din documentația Google pentru funcțiile AI; entitatea e temelia |
| „Scriem pagini care răspund la întrebările clienților, cu prețuri și date reale” | funcționează | sursele citate în teste sunt cele care spun ceva concret |
| „Verificăm că roboții de căutare AI nu sunt blocați” | funcționează | site-urile care refuză OAI-SearchBot nu apar în răspunsurile căutării din ChatGPT, conform OpenAI |
| „Măsurăm lunar, cu aceleași întrebări, și raportăm ce s-a schimbat” | funcționează | singura măsurătoare pe care o poți verifica singur |
| „Te înregistrăm în ChatGPT și Perplexity” | snake-oil | nu există înregistrare; există eligibilitate prin indexare și acces |
| „Implementăm llms.txt ca să te vadă AI-ul” | snake-oil ca livrabil central | Google spune explicit că nu are nevoie de el; OpenAI și Perplexity nu au confirmat că îl folosesc |
| „Schema specială pentru AI Overviews” | snake-oil | Google: „nu există date structurate schema.org speciale pe care trebuie să le adaugi” |
| „Garantăm apariția în răspunsurile AI” | snake-oil și problemă legală | niciun motor nu garantează citarea; promisiunile de rezultat garantat sunt tratate în ghidul general |
| „Wikidata, 200 de directoare și mențiuni în 50 de bloguri” | snake-oil | fragmentează entitatea și riscă ștergeri; contează relevanța, nu numărul |
O delimitare pe care ofertele o încețoșează intenționat: tot ce e în acest articol e vizibilitate organică, neplătită, în răspunsuri. Reclamele din ChatGPT, disponibile în România din august 2026, sunt un canal plătit separat, cu propriile reguli, tratat în ghidul despre reclamele din ChatGPT. O agenție care le amestecă în același „pachet de vizibilitate AI” vinde confuzie.
Întrebări frecvente
Cum apare firma mea în ChatGPT când cineva caută un serviciu local?
Când căutarea e activată, ChatGPT consultă surse de pe web și le poate cita; OpenAI documentează un robot dedicat, OAI-SearchBot, și precizează că site-urile care îl refuză nu sunt afișate în răspunsurile căutării. Ca să fii printre sursele consultate, ai nevoie de o entitate consistentă (același nume, adresă și telefon peste tot), de pagini care răspund concret la întrebările clienților și de un robots.txt care nu blochează robotul de căutare. Cum ordonează ChatGPT sursele eligibile nu e documentat public.
Am nevoie de llms.txt ca să apar în ChatGPT, Perplexity sau Google? Nu, pe baza a ce se poate verifica la data articolului. Google spune în documentația oficială că nu ai nevoie de „fișiere text pentru AI” pentru AI Overviews sau AI Mode, iar reprezentanții săi au numit fișierul „pur speculativ deocamdată”. OpenAI și Perplexity nu au publicat nicio confirmare că îl folosesc. Dacă îl poți genera automat, nu strică; dacă cineva ți-l vinde ca livrabil central, e un semnal de alarmă.
Blocarea GPTBot mă scoate din răspunsurile ChatGPT?
Nu. GPTBot colectează conținut pentru antrenarea modelelor, iar afișarea în căutarea din ChatGPT ține de OAI-SearchBot; sunt roboți diferiți, cu reguli separate în robots.txt. Poți refuza antrenarea și rămâne eligibil pentru citare. La Google, Google-Extended controlează antrenarea și fundamentarea în alte sisteme Google și nu afectează includerea în Căutare, deci nici funcțiile AI din Căutare.
Cum măsor dacă firma apare în răspunsurile AI, fără o unealtă plătită? Cu un set fix de 10–15 întrebări reale, cu localitatea inclusă, rulate lunar în ChatGPT cu căutare, Perplexity și Google AI Mode, de două ori fiecare, și notate într-un tabel: dacă ești numit, cu ce nume, ce s-a spus despre tine și ce surse au fost citate. În analytics urmărești traficul de referință din chatgpt.com și perplexity.ai ca tendință. O cifră de „vizibilitate AI” fără lista de întrebări, motoare, dată și număr de rulări nu e o măsurătoare.
Ce contează mai mult pentru o firmă locală: site-ul sau profilul Google? Amândouă, cu roluri diferite. Profilul Google e sursa de date de bază (nume, program, recenzii, fotografii) și e menționat explicit în documentația Google pentru funcțiile AI; site-ul e locul unde răspunzi la întrebări cu prețuri, durate și comparații pe care profilul nu le poate găzdui. În exemplul din articol, Perplexity a citat profilul pentru că site-ul nu spunea nimic verificabil.
Concluzie
Vizibilitatea unei firme locale în ChatGPT, Perplexity și Google AI Mode se construiește din patru lucruri verificabile: o entitate consistentă, pagini care răspund la întrebări cu date reale, roboți de căutare lăsați să citească și o măsurătoare lunară făcută la fel de fiecare dată. Tot ce e documentat de motoare intră în aceste patru categorii; tot ce nu e documentat — formula de ordonare, „înregistrarea”, fișierele miraculoase — nu poate fi cumpărat de la nimeni.
Statutul lui llms.txt rezumă disciplina: o idee rezonabilă, fără confirmare de la vreun motor major, cu cost mic dacă o automatizezi și cu preț mare dacă o plătești ca livrabil. Verifică la zi, cere sursa datată pentru fiecare promisiune și păstrează tabelul cu întrebările de test — e singurul raport de vizibilitate în AI pe care îl poți verifica singur.
Surse
- OpenAI, prezentarea crawlerelor (OAI-SearchBot, GPTBot, ChatGPT-User): https://developers.openai.com/api/docs/bots
- Perplexity, crawlere și user-agenți (PerplexityBot, Perplexity-User): https://docs.perplexity.ai/guides/bots
- Google Search Central, „AI features and your website” (AI Overviews, AI Mode, ce nu ai nevoie, Business Profile, Google-Extended): https://developers.google.com/search/docs/appearance/ai-features
- Google Search Central, date structurate LocalBusiness: https://developers.google.com/search/docs/appearance/structured-data/local-business
- Google, ghidul pentru reprezentarea firmei pe Google (Business Profile): https://support.google.com/business/answer/3038177?hl=ro
- Google România, „Căutările Google în Modul AI, disponibile în România” (8 octombrie 2025): https://blog.google/intl/ro-ro/produse/cautarile-google-in-modul-ai-disponibile-in-romania/
- Propunerea llms.txt (Jeremy Howard, septembrie 2024): https://llmstxt.org/
- Search Engine Journal, „Google Confirms LLMs.txt Has No Current Implementation” (2 iunie 2026): https://www.searchenginejournal.com/google-says-llms-txt-is-purely-speculative-for-now/577576/
Articol informativ, publicat la 22 septembrie 2026. Firma „Atelier Roată” și rezultatele testului ei sunt un exemplu construit pentru ilustrare, nu o măsurătoare reală. Citatele din documentațiile OpenAI, Perplexity și Google au fost consultate la 22 septembrie 2026 și sunt traduse de noi; documentațiile se schimbă frecvent, verificați sursele înainte de a lua decizii. Conținutul nu constituie consultanță juridică sau de marketing.

Cursul care continuă acest articol
SEO și AEO/GEO în Era AI: Optimizare pentru Google, AI Overviews și Motoarele Generative
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Peisajul SEO 2026: de la SEO clasic la AEO/GEO
- Fundamente durabile care nu se învechesc
- SEO tehnic asistat de AI
- Keyword și intent research la scară cu AI
+ încă 6 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.499 lei pe lună pentru toate cele 25 de cursuri Non-IT (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.