Extragerea datelor din documente cu AI e unul dintre cele mai concrete proiecte cu LLM pentru back-office: facturi de la furnizori, bonuri, chitanțe și contracte transformate în câmpuri pe care un ERP le poate înregistra. Tot aici apar și erorile scumpe, pentru că un JSON impecabil cu un CUI citit greșit arată exact ca unul corect. Ghidul de mai jos descrie pipeline-ul care rezistă: când nu ai nevoie de LLM, cum construiești schema, ce garantează structured outputs și ce nu, ce verifică codul, când decide omul și cum măsori rezultatul pe fiecare câmp.
Extragere date din documente cu LLM: întâi, ai nevoie de model?
Cea mai ieftină extragere e cea pe care nu trebuie s-o faci. Pentru facturile dintre firmele din România, datele structurate există deja. Articolul 10 alineatul (1) din OUG nr. 120/2021 obligă emitentul unei facturi B2B, între persoane impozabile stabilite în România, să o transmită prin sistemul RO e-Factura. Articolul 4 alineatul (6) prevede că exemplarul original al facturii electronice este fișierul XML însoțit de sigiliul electronic al Ministerului Finanțelor, cu structura din standardul SR EN 16931-1 și specificațiile RO_CIUS (alineatul (1)). De la 1 ianuarie 2025, obligația acoperă și facturile B2C (art. 10^1 alin. (2)), cu excepții: de pildă, furnizorii care se identifică fiscal prin codul numeric personal nu au obligația de a folosi sistemul (art. 10^10, în forma dată de Legea nr. 88/2026).
Consecința pentru un flux de achiziții: facturile furnizorilor români le descarci ca XML și le parsezi determinist. PDF-ul e doar o reprezentare; dacă îl dai unui model ca să reconstituie ce există deja structurat, plătești pentru o sursă de erori. Ecosistemul din jur (SPV, SAF-T, e-TVA) e descris în ghidul despre e-Factura, SAF-T și e-TVA.
Pentru extragere rămân documentele fără echivalent structurat: facturile furnizorilor străini, bonurile fiscale care îndeplinesc condițiile facturii simplificate (exceptate de același articol 10), facturile furnizorilor care se identifică fiscal prin CNP, arhivele vechi, chitanțele, avizele, hârtia scanată și contractele.
| Document | Abordare | De ce |
|---|---|---|
| Factură de la un furnizor român, în RO e-Factura | Parser pe XML-ul descărcat | Originalul e XML-ul; nu există ambiguitate de citire |
| Document generat mereu de același sistem, cu aceeași machetă | Parser clasic pe stratul de text (expresii regulate, poziții) | Determinist, ieftin, ușor de testat |
| Facturi străine, bonuri, chitanțe, scanuri cu machete variate | LLM cu schemă, apoi validare în cod | Variabilitatea machetelor e exact ce gestionează bine un model |
| Contracte | LLM cu schemă și citatul-sursă pentru fiecare clauză | Text lung, nestandardizat; verificarea se face pe citat |
Mecanica de bază (apelul de API, clasa Pydantic, validarea, reîncercarea cu eroarea trimisă înapoi modelului) e predată pas cu pas în modulul „Structured outputs: JSON valid pentru aplicații reale” din Construire de Aplicații AI cu Python și SDK-uri, al cărui proiect final e chiar un asistent peste documentele tale. Ghidul de față pornește de acolo și adaugă ce e specific facturilor și contractelor românești.
Pipeline-ul în opt pași
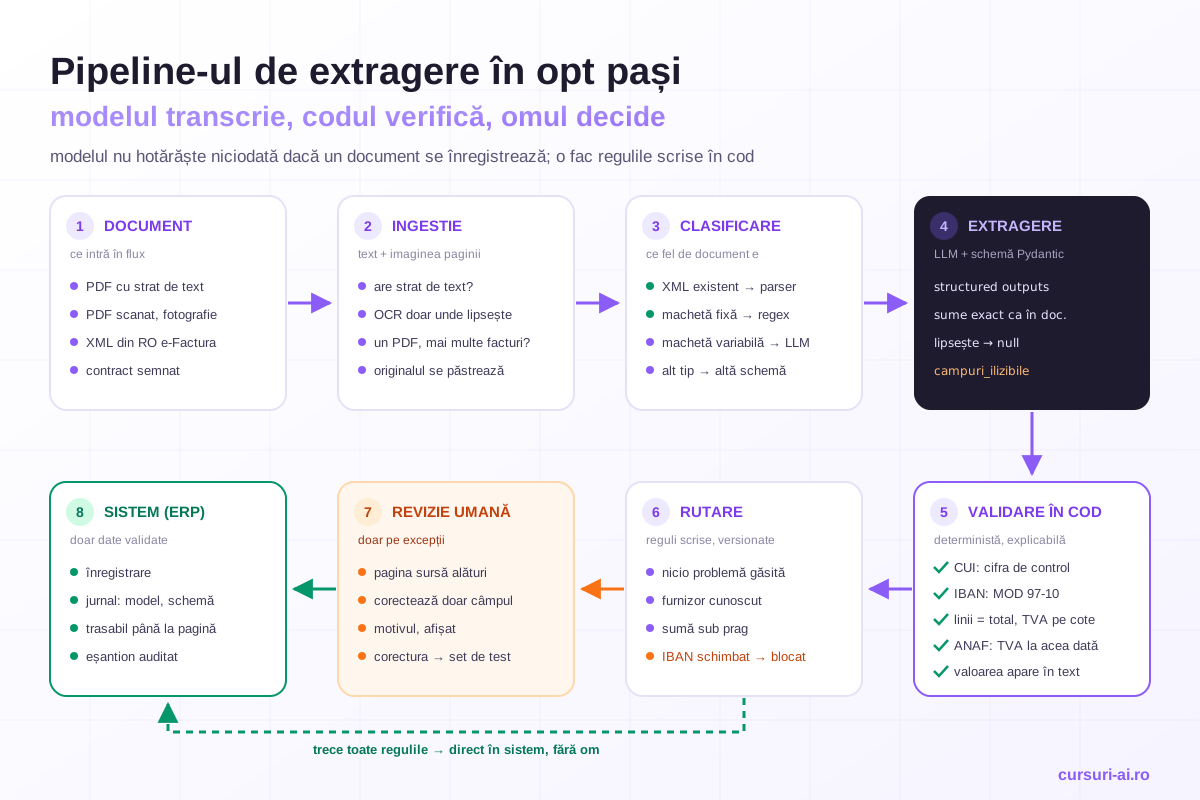
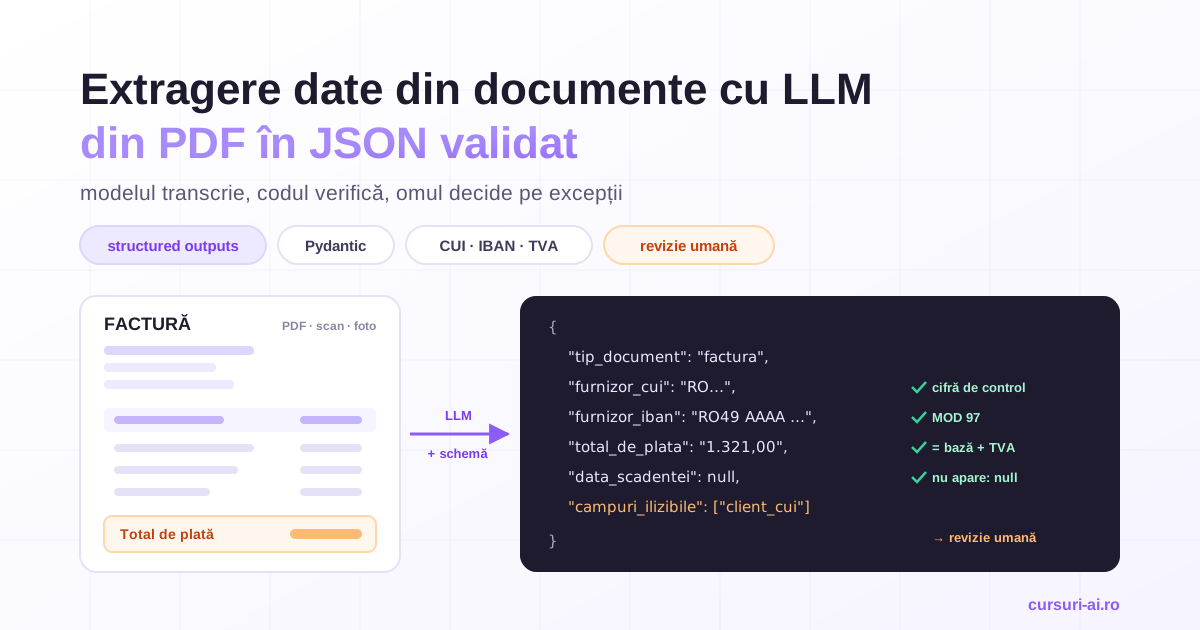
Regula care ține totul împreună: modelul transcrie, codul verifică, omul decide pe excepții. Modelul produce o propunere structurată; dacă documentul se înregistrează decid regulile scrise în cod. Fiecare pas are un singur rol și se testează separat.
Ingestie: PDF cu text, scan sau fotografie
Primul test e dacă PDF-ul are strat de text. Dacă are, îl păstrezi: cu el verifici mai târziu că o valoare extrasă chiar apare în document. Dacă nu are (scan, fotografie), alegi între OCR clasic, care dă textul cu coordonate, și un model cu viziune, care citește imaginea paginii.
Furnizorii mari acceptă PDF-ul direct: la Anthropic fiecare pagină e convertită în imagine și trimisă cu textul extras, la OpenAI (modele cu viziune) API-ul extrage textul și imaginile paginilor, iar Gemini procesează PDF-urile prin viziune nativă. Modelul vede deci și macheta: tabelul de linii, chenarul cu totaluri.
- Trimiți doar paginile utile. Anthropic estimează între 1.500 și 3.000 de tokeni de text pe pagină de PDF, plus costul imaginii fiecărei pagini. Anexele nu ajută la citirea totalurilor.
- Separi documentele înainte să extragi. Un teanc scanat ajunge des ca un singur PDF cu mai multe facturi: clasifici fiecare pagină, grupezi paginile pe document, apoi extragi.
- Păstrezi originalul și imaginea fiecărei pagini, ca omul care revizuiește să vadă sursa lângă câmpul marcat.
Scanurile românești au două capcane: pachetul de limbă al OCR-ului și diacriticele scrise cu sedilă sau cu virgulă, care strică potrivirea exactă. Ambele sunt tratate în articolul despre RAG pe documente românești; la extragere contează mai ales la verificarea citatelor din contracte.
Schema: ce îi ceri modelului și ce nu
Schema e contractul dintre model și restul sistemului. Patru reguli o fac robustă:
- Modelul transcrie, codul interpretează. Sumele vin ca text, exact cum apar („1.234,56”); conversia o face codul, care știe că în România virgula e separator zecimal și poate refuza un „1.234” ambiguu.
- „Nu știu” e o valoare legitimă. Câmpurile opționale acceptă
null, iarcampuri_ilizibilesepară „nu apare în document” (informație) de „apare, dar nu se poate citi sigur” (motiv de revizie). - Documentul greșit are unde să meargă.
tip_documentincludealt_document. Documentația OpenAI avertizează că modelul încearcă întotdeauna să respecte schema primită, ceea ce poate produce halucinații dacă intrarea nu are legătură cu ea. - Câmpurile obligatorii vin din lege. Articolul 319 alineatul (20) din Codul fiscal enumeră ce cuprinde obligatoriu o factură: numărul de ordine, data emiterii, datele și codul fiscal ale furnizorului, datele beneficiarului (și codul lui, dacă e persoană impozabilă sau persoană juridică neimpozabilă), denumirea și cantitatea bunurilor, baza de impozitare pe fiecare cotă, cota și suma taxei „exprimate în lei”, plus mențiuni precum „taxare inversă” sau „TVA la încasare”. Scadența și IBAN-ul nu sunt în listă, deci în schemă rămân opționale. Numărul de la Registrul Comerțului nu apare în art. 319, dar Legea nr. 31/1990 (art. 74 alin. (1)) îl cere pe facturile emise de societăți; în schemă e opțional pentru că furnizorii străini nu îl au, iar lipsa lui la o societate românească trimite documentul la revizie.
from datetime import date
from typing import Literal

from pydantic import BaseModel, Field


class Linie(BaseModel):
    descriere: str
    cantitate: str | None = Field(description="Exact ca în document, de ex. 1,5")
    pret_unitar: str | None = Field(description="Fără TVA, exact ca în document")
    valoare_fara_tva: str | None = Field(description="Exact ca în document")
    cota_tva: str | None = Field(description="Procentul de pe linie, de ex. 21; null dacă lipsește")


class Factura(BaseModel):
    tip_document: Literal["factura", "factura_storno", "proforma", "chitanta", "bon_fiscal", "alt_document"]
    serie_numar: str | None = Field(description="Seria și numărul, exact ca în document")
    data_emiterii: date | None
    data_scadentei: date | None = Field(description="null dacă documentul nu o menționează")
    furnizor_denumire: str | None
    furnizor_cui: str | None = Field(description="Cu prefixul RO, dacă apare în document")
    furnizor_reg_com: str | None = Field(description="Numărul de la Registrul Comerțului, exact ca în document")
    furnizor_iban: str | None
    client_cui: str | None
    moneda: str | None = Field(description="Cod ISO 4217, de ex. RON sau EUR")
    linii: list[Linie]
    total_fara_tva: str | None
    total_tva: str | None
    total_de_plata: str | None
    mentiuni: list[Literal["taxare inversă", "TVA la încasare", "scutire de TVA", "autofactură"]]
    campuri_ilizibile: list[str] = Field(
        description="Câmpurile care apar în document, dar nu pot fi citite sigur. Nu ghici."
    )
Detalii care contează în producție:
- Toate câmpurile sunt obligatorii, unele pot fi
null. În Pydantic v2, un câmpstr | Nonefără valoare implicită intră în listarequiredși acceptănull, exact forma cerută de OpenAI, unde opționalul se emulează printr-o uniune cunull. În versiunile testate la data scrierii (openai 3.22, anthropic 1.11), helperele de parsare adaugă singureadditionalProperties: false, cerut de ambii furnizori. - Numărul de la Registrul Comerțului e text liber, intenționat. Circulă două formate: cel vechi, cu bare (de tipul J40/1234/2015), și cel nou, YAAAAXXXXXXJJC, anunțat de ONRC: litera registrului, anul înmatriculării, numărul de ordine pe șase cifre, codul județului (00 după 26.07.2024) și o cifră de control. Firmele vechi îl primesc când înregistrează anumite mențiuni (denumire, sediu, obiect principal, formă juridică).
- Facturile în valută au nevoie de
total_tva_lei, pentru că litera j) a aceluiași alineat cere taxa exprimată în lei. - Schema are un buget de complexitate. La Anthropic, o cerere acceptă cel mult 16 parametri cu uniune (
str | None), iar schema de mai sus îi folosește pe toți. Un câmp nou catotal_tva_leicere fie un câmp fărănull(șir gol pentru lipsă), fie un al doilea apel, de exemplu doar pentru linii. - Majusculele din enum nu sunt garantate la Anthropic: o mențiune scrisă „Taxare inversă” ridică
ValidationErrorși trimite toată factura la revizie. Dacă abaterea devine frecventă, declari câmpul calist[str]și normalizezi în cod. - Descrierile câmpurilor sunt instrucțiuni și ajung în schema trimisă modelului: acolo scrii „exact ca în document” și „null dacă lipsește”.
Structured outputs: ce garantează fiecare furnizor
Toți cei trei furnizori mari constrâng forma răspunsului după o schemă JSON; diferă numele parametrilor și avertismentele din documentație:
| Furnizor | Mecanism | Helper Python cu Pydantic | Ce spune documentația despre limite |
|---|---|---|---|
| OpenAI | text.format cu type: "json_schema" și strict: true (Responses API) |
client.responses.parse(..., text_format=Factura), rezultatul în output_parsed |
„Structured Outputs can still contain mistakes”; toate câmpurile required, additionalProperties: false |
| Anthropic | output_config.format cu type: "json_schema", fără header beta; alternativ, tool use cu strict: true |
client.messages.parse(..., output_format=Factura), rezultatul în parsed_output |
la stop_reason refusal sau max_tokens ieșirea poate să nu respecte schema; minimum/maximum nu sunt suportate în schemă; majusculele valorilor din enum nu sunt garantate |
| Google Gemini | Interactions API: response_format cu mime_type: "application/json" și schema; în generateContent: response_mime_type și response_schema |
schema din model_json_schema(), validarea cu model_validate_json() |
„always validate values in your application” |
Pe scurt: structured outputs garantează forma, nu adevărul. Relația cu function calling și tool use e explicată în articolul despre function calling, tool use și MCP. Un apel complet, cu PDF-ul trimis direct:
import base64
import os

import anthropic
from pydantic import ValidationError

client = anthropic.Anthropic()  # cheia vine din ANTHROPIC_API_KEY

INSTRUCTIUNI = """Extragi câmpurile unei facturi din documentul atașat.
Copiezi sumele și codurile exact cum sunt scrise; nu calculezi și nu corectezi nimic.
Dacă un câmp nu apare în document, pui null.
Dacă apare, dar nu se poate citi sigur, pui null și îi treci numele în campuri_ilizibile.
Dacă documentul nu este o factură, completezi tip_document și lași restul null sau gol."""

with open("factura.pdf", "rb") as fisier:
    pdf = base64.standard_b64encode(fisier.read()).decode("utf-8")

try:
    raspuns = client.messages.parse(
        model=os.environ["MODEL_EXTRAGERE"],  # modelul stă în configurare, nu în cod
        max_tokens=4096,
        system=INSTRUCTIUNI,
        messages=[{"role": "user", "content": [
            {"type": "document",
             "source": {"type": "base64", "media_type": "application/pdf", "data": pdf}},
            {"type": "text", "text": "Extrage datele facturii."},
        ]}],
        output_format=Factura,
    )
    factura = raspuns.parsed_output if raspuns.stop_reason == "end_turn" else None
except ValidationError:  # refuz sau răspuns tăiat: textul nu respectă schema
    factura = None       # în ambele cazuri, documentul merge la revizie umană
Modelul e citit din configurare pentru că generațiile se schimbă de câteva ori pe an; la fiecare schimbare rulezi din nou setul de test descris mai jos. Pentru facturile lunare, care nu cer răspuns imediat, procesarea în lot e documentată la ambii furnizori cu 50% reducere față de apelurile sincrone: Batch API la OpenAI, într-o fereastră de 24 de ore (cererile neterminate expiră), și Message Batches la Anthropic, unde majoritatea loturilor se termină în mai puțin de o oră.
Validări deterministe: ce verifică codul, nu modelul
Structured outputs îți dă un obiect bine format; codul verifică dacă e plauzibil. Fiecare regulă e ieftină, deterministă și ușor de explicat unui auditor:
import re
from collections import defaultdict
from datetime import date
from decimal import Decimal, InvalidOperation


def suma(text: str | None) -> Decimal | None:
    """Interpretează o sumă așa cum e scrisă. None = lipsă sau ambiguă."""
    if text is None or "(" in text:  # (1.234,56) = sumă negativă în notație contabilă: la om
        return None
    s = re.sub(r"[^\d,.\-]", "", text)            # scoate „lei”, „RON”, spațiile
    if "," in s and "." in s:                     # ultimul separator e cel zecimal
        zec = "," if s.rfind(",") > s.rfind(".") else "."
        s = s.replace("." if zec == "," else ",", "").replace(zec, ".")
    elif s.count(",") == 1 or s.count(".") == 1:
        if len(re.split(r"[.,]", s)[1]) == 3:     # „1.234”: o mie sau 1,234?
            return None
        s = s.replace(",", ".")
    else:                                         # „1.234.567” sau fără separator
        s = s.replace(",", "").replace(".", "")
    try:
        return Decimal(s)
    except InvalidOperation:
        return None


def cui_valid(cui: str) -> bool:
    """Cifra de control a CUI/CIF, cu cheia de testare 753217532."""
    c = re.sub(r"\s", "", cui.upper()).removeprefix("RO")
    if not re.fullmatch(r"[1-9][0-9]{1,9}", c):  # doar cifre ASCII, 2–10, fără 0 la început
        return False
    corp = c[:-1].zfill(9)
    s = sum(int(d) * w for d, w in zip(corp, (7, 5, 3, 2, 1, 7, 5, 3, 2)))
    return s * 10 % 11 % 10 == int(c[-1])


def iban_valid(iban: str) -> bool:
    """ISO 13616: primele 4 caractere la final, literele devin 10–35, restul mod 97 = 1."""
    s = re.sub(r"\s", "", iban.upper())
    if not re.fullmatch(r"[A-Z]{2}\d{2}[A-Z0-9]{11,30}", s):
        return False
    if s.startswith("RO") and not re.fullmatch(r"RO\d{2}[A-Z]{4}[A-Z0-9]{16}", s):
        return False  # 24 de caractere: RO, control, 4 litere ale băncii, 16 caractere
    cifre = "".join(str(int(ch, 36)) for ch in s[4:] + s[:4])
    return int(cifre) % 97 == 1


TOL = Decimal("0.01")  # ilustrativ: o toleranță de rotunjire pe linie


def verifica(f: Factura) -> list[str]:
    probleme: list[str] = []
    if f.furnizor_cui and not cui_valid(f.furnizor_cui):
        probleme.append("CUI furnizor: cifra de control nu se potrivește")
    if f.furnizor_iban and not iban_valid(f.furnizor_iban):
        probleme.append("IBAN: lungime sau cifre de control greșite")

    baza, tva, total = suma(f.total_fara_tva), suma(f.total_tva), suma(f.total_de_plata)
    linii = [(suma(l.valoare_fara_tva), (l.cota_tva or "").strip(" %")) for l in f.linii]
    if None in (baza, tva, total) or any(v is None for v, _ in linii):
        probleme.append("sumă lipsă sau ambiguă")
    else:
        if abs(sum(v for v, _ in linii) - baza) > TOL * len(linii):
            probleme.append("suma liniilor diferă de totalul fără TVA")
        if abs(baza + tva - total) > TOL:
            probleme.append("total fără TVA + TVA diferă de totalul de plată")
        pe_cote: dict[str, Decimal] = defaultdict(Decimal)
        for v, cota in linii:
            pe_cote[cota] += v
        if all(c.isdigit() for c in pe_cote):
            tva_calculat = sum(b * int(c) / 100 for c, b in pe_cote.items())
            if abs(tva_calculat - tva) > TOL * len(pe_cote):
                probleme.append("TVA-ul nu corespunde bazelor pe cote")
        else:
            probleme.append("cotă lipsă sau nenumerică pe o linie: TVA neverificat")

    if f.data_emiterii:
        if f.data_emiterii > date.today():
            probleme.append("data emiterii e în viitor")
        if f.data_scadentei and f.data_scadentei < f.data_emiterii:
            probleme.append("scadența e înaintea emiterii")
        # Cota se stabilește după faptul generator (art. 291 alin. (4) Cod fiscal),
        # deci o abatere merge la om, nu se respinge automat.
        uzuale = {"21", "11", "0"} if f.data_emiterii >= date(2025, 8, 1) else {"19", "9", "5", "0"}
        for _, cota in linii:
            if cota and cota not in uzuale:
                probleme.append(f"cotă de TVA neobișnuită pentru data facturii: {cota}%")
    return probleme
De unde vine fiecare regulă:
- CUI/CIF. Cheia de testare 753217532, cu restul 10 transformat în 0, e algoritmul implementat și de biblioteca open-source python-stdnum (
stdnum.ro.cui), pe care o poți folosi în loc de funcția proprie. E o verificare de format: prinde majoritatea cifrelor citite greșit (nu pe toate, pentru că restul 10 devine 0) și nu dovedește că firma există. - Existența și statutul firmei. Pentru asta interoghezi serviciul web ANAF de verificare a contribuabililor (versiunea 9 la data scrierii): primești denumirea, numărul de la Registrul Comerțului și, la data cerută, înregistrarea în scopuri de TVA, starea de inactiv și prezența în Registrul RO e-Factura. Documentația limitează o cerere la 100 de CUI-uri și o cerere pe secundă. TVA facturat de un furnizor neînregistrat în scopuri de TVA la data facturii, sau o denumire diferită, trimite documentul la om.
- IBAN. Regulamentul BNR nr. 2/2004 stabilește pentru IBAN-ul românesc 24 de caractere (RO, două cifre de control, patru litere ale instituției, 16 caractere alfanumerice) și calculul cifrelor de control cu algoritmul MOD 97-10. Un IBAN valid, dar diferit de cel din fișa furnizorului, nu se acceptă niciodată doar pe baza facturii: e exact câmpul pe care îl modifică cineva care vrea să devieze o plată.
- Totaluri. Toleranța de un ban pe linie e ilustrativă; o calibrezi pe facturile reale, pentru că unii furnizori rotunjesc pe linie, alții pe total.
- Cotele de TVA. Legea nr. 141/2025 a stabilit, de la 1 august 2025, cota standard la 21% și cota redusă la 11% (art. 291 alin. (1) și (2) din Codul fiscal); înainte se aplicau 19%, 9% și 5%. Cota aplicabilă e însă cea de la data faptului generator (alin. (4)), iar legea a prevăzut dispoziții tranzitorii, de pildă cota de 9% pentru anumite locuințe, în condiții stricte și pe perioade limitate. De aceea o cotă neobișnuită trimite documentul la revizie, nu îl respinge.
- Valoarea apare în document. Când ai strat de text, verifici că CUI-ul, IBAN-ul și totalul extrase apar ca atare în text, fără spații. Un câmp care nu apare nicăieri a fost probabil reconstruit, nu citit.
- Duplicatul. Aceeași combinație de CUI al furnizorului și serie-număr, deja înregistrată, înseamnă oprire.
Lista goală întoarsă de verifica() e condiție necesară pentru trecerea automată, nu și suficientă.
Rutarea: când trece automat și când decide omul
Un „scor de încredere” cerut modelului în răspuns e tot text generat, nu o probabilitate măsurată pe documentele tale; nu-l folosi ca prag. Folosește semnale verificabile:
| Situație | Rută |
|---|---|
| Nicio problemă găsită, furnizor cunoscut, IBAN identic cu fișa, sumă sub pragul stabilit | Înregistrare automată; un eșantion e verificat periodic |
campuri_ilizibile nevid sau un câmp obligatoriu null |
Revizie: omul completează doar câmpurile marcate |
| Totaluri sau TVA care nu se închid | Revizie, cu diferența afișată lângă document |
| Cotă neobișnuită, „taxare inversă” sau scutire | Revizie de specialitate, la contabil |
| Furnizor nou, CUI negăsit la ANAF sau inactiv | Revizie și verificarea furnizorului |
| IBAN diferit de fișa furnizorului | Plata se blochează până la confirmarea pe alt canal |
| Răspuns oprit înainte de final sau eroare de validare | Revizie completă a documentului |
| Duplicat | Oprit, cu notificare |
Pragul de sumă e o decizie de risc, nu una tehnică: îl stabilește cine răspunde de plăți. Peste prag, un semnal suplimentar e o a doua extragere independentă (alt model sau alt prompt) care trebuie să coincidă pe câmpurile critice; dublează costul de API, deci o aplici doar acolo.
Revizia merge repede când omul vede pagina sursă lângă câmpurile marcate. Fiecare corectură se salvează cu valoarea extrasă și cea corectă, iar setul de test crește singur. Legătura cu contabilitatea (potrivirea comandă, recepție, factură și integrarea cu e-Factura) e tratată din perspectiva contabilului în lecția despre automatizarea facturilor din AI în Finanțe și Contabilitate.
Cum măsori: setul de test și acuratețea pe câmp
Fără un set etichetat nu știi dacă o schimbare te-a ajutat. Îl construiești din documente reale, stratificat pe furnizori, calitatea scanării și tipul documentului, etichetat de doi oameni, cu dezacordurile rezolvate explicit; promptul nu se ajustează pe documentele din set. Metodologia generală e în ghidul despre AI evals, iar curarea și etichetarea setului, inclusiv datele sintetice fără date personale, au un modul dedicat în AI Evals pentru LLM-uri în Producție.
Măsori pe câmp, nu pe document: o factură cu 15 câmpuri corecte și IBAN-ul greșit e un eșec, iar media pe document l-ar ascunde.
| Metrică | Cum se calculează | De ce contează |
|---|---|---|
| Exactitate pe câmp, potrivire exactă | valoarea extrasă e identică, caracter cu caracter, cu eticheta | pentru coduri: CUI, IBAN, serie și număr |
| Exactitate pe câmp, normalizată | egalitate după normalizare (spații, prefix RO, format de dată, sumă în Decimal) | pentru sume, date, denumiri |
| Rata valorilor inventate | câmpuri cu eticheta null la care modelul a dat o valoare, raportat la toate câmpurile cu eticheta null |
cea mai periculoasă eroare: arată ca o citire corectă |
| Rata de abținere | câmpuri prezente întoarse null sau marcate ilizibile, raportat la câmpurile prezente |
costă timp de revizie, nu plăți greșite |
| Exactitate pe linii | linii potrivite pe descriere și valoare, raportat la liniile etichetate | tabelele se strică primele |
| Rata de trecere automată | documente înregistrate fără om, raportat la total | măsura economiei |
| Eroarea în fluxul automat | erori găsite în eșantionul auditat, raportat la documentele eșantionate | măsura riscului rămas |
Ultimele două trag în direcții opuse: un prag mai permisiv crește trecerea automată și eroarea rămasă. Compromisul îl alegi pe setul etichetat și îl revezi la fiecare schimbare de model.
Cât costă un document
Costul real are trei componente: API-ul (tokenii de intrare, inclusiv imaginile paginilor, și cei de ieșire), revizia umană (cota revizuită × minute per document × costul unui minut) și reprocesările. Exemplu ilustrativ: 2.000 de facturi pe lună, 15% la revizie, două minute pe document înseamnă 600 de minute, adică zece ore de muncă. Pune cifra lângă factura de API din aceeași lună: abia așa vezi unde merită optimizat.
Pârghiile: validări care închid singure mai multe cazuri, doar paginile necesare, procesarea în lot și un model mai mic pe documentele simple, după ce setul de test arată că ține. Prețurile pe token le iei din pagina furnizorului în ziua calculului.
Extragerea datelor din contracte: aceeași metodă, plus citatul-sursă
La contracte, valorile sunt adesea interpretări ale unui paragraf, nu cifre dintr-un chenar. Extragerea devine verificabilă când fiecare clauză vine cu fragmentul copiat exact din document, iar codul confirmă că fragmentul există:
# Folosește importurile din blocurile de mai sus (re, date, Literal, BaseModel, Field).
class Parte(BaseModel):
    denumire: str
    cui: str | None
    rol: Literal["prestator", "beneficiar", "vânzător", "cumpărător", "altul"]


class Clauza(BaseModel):
    tip: Literal["durata", "prelungire_automata", "preaviz_incetare", "termen_plata",
                 "penalitati", "lege_aplicabila", "instanta_competenta", "date_personale"]
    rezumat: str
    citat: str = Field(description="Fragmentul copiat exact din contract, fără parafrazare")
    pagina: int | None


class Contract(BaseModel):
    parti: list[Parte]
    data_semnarii: date | None
    clauze: list[Clauza]
    clauze_negasite: list[str] = Field(description="Tipurile de clauze căutate și negăsite")


def citat_gasit(citat: str, text: str) -> bool:
    """Citatul trebuie să existe în textul contractului, nu doar să sune plauzibil."""
    def norm(s: str) -> str:
        s = s.translate(str.maketrans("\u015f\u0163\u015e\u0162", "șțȘȚ"))  # sedilă → virgulă
        s = re.sub(r"-\s*\n\s*", "", s)                        # despărțiri la capăt de rând
        return re.sub(r"\s+", " ", s).strip().lower()
    c = norm(citat)
    return len(c) >= 10 and c in norm(text)  # un citat gol sau de câteva litere nu dovedește nimic
- Datele derivate le calculează codul. Modelul extrage data intrării în vigoare, durata și preavizul; data expirării și ultima zi pentru notificarea neprelungirii le calculează codul.
- Lipsa unei clauze e o informație.
clauze_negasitespune, de pildă, că un contract nu are clauză de penalități. - Citatul negăsit trimite la revizie. Normalizarea diacriticelor și a despărțirilor în silabe evită alarmele false; o parafrază prezentată drept citat e exact ce vrei să prinzi.
- Citările Anthropic nu se combină cu structured outputs. Funcția întoarce pasajul exact din document, dar documentația precizează că, dacă activezi citările și trimiți și
output_config.format, API-ul întoarce eroarea 400. Alegi între câmpulcitatverificat de cod și două apeluri separate.
Interpretarea unei clauze (e abuzivă, e opozabilă?) nu e extragere și rămâne la jurist.
Date personale și AI Act, pe scurt
Facturile emise de PFA și de alte persoane fizice, ca și contractele cu persoane fizice, conțin date personale. Furnizorul de API le prelucrează în numele tău, deci se aplică articolul 28 din Regulamentul (UE) 2016/679: împuterniciți cu garanții suficiente și un contract care stabilește obiectul, durata, natura și scopul prelucrării, tipurile de date și categoriile de persoane vizate. Articolul 5 alineatul (1) se traduce direct în cod: litera (c), reducerea la minimum a datelor (trimiți doar paginile necesare), și litera (d), exactitatea (o valoare extrasă greșit despre o persoană fizică e o dată inexactă). Articolul 32 numește pseudonimizarea și criptarea printre măsurile de securitate; jurnalele păstrează identificatori și rezultate, nu documente întregi.
Politicile furnizorilor, la data consultării:
- OpenAI: din 1 martie 2023, datele trimise la API nu sunt folosite pentru antrenare decât dacă alegi explicit asta; jurnalele de monitorizare a abuzurilor se păstrează până la 30 de zile; retenția zero e disponibilă clienților eligibili, cu aprobare; pentru endpointurile și modelele eligibile există stocare și procesare în Europa, pentru conturile aprobate (cu amendament contractual și un cost suplimentar la modelele mai noi).
- Anthropic: termenii comerciali exclud antrenarea modelelor pe conținutul clienților și încorporează acordul de prelucrare (DPA); intrările și ieșirile API se șterg în 30 de zile, cu excepții precum Files API, aplicarea politicii de utilizare sau obligațiile legale.
- Google Gemini API: la serviciile plătite, prompturile nu sunt folosite pentru îmbunătățirea produselor și se prelucrează conform DPA; în SEE, Elveția și Regatul Unit, aceleași condiții se aplică tuturor serviciilor Gemini API. Verifici în contractul tău ce se aplică efectiv contului folosit.
În Regulamentul (UE) 2024/1689, articolul 6 alineatul (2) clasifică drept sisteme cu grad ridicat de risc pe cele din anexa III, iar extragerea câmpurilor din facturile furnizorilor nu e printre domeniile de acolo. Altfel stau lucrurile când extragerea alimentează un sistem din anexa III, cum ar fi filtrarea candidaturilor (pct. 4 lit. (a)) sau evaluarea bonității persoanelor fizice (pct. 5 lit. (b)): analizezi încadrarea întregului sistem, iar furnizorul care invocă o derogare, de pildă „sarcina procedurală restrânsă” (art. 6 alin. (3) lit. (a)), documentează evaluarea înainte de introducerea pe piață sau de punerea în funcțiune și înregistrează sistemul (alin. (4)); derogarea nu se aplică dacă sistemul creează profiluri ale persoanelor fizice. După Regulamentul (UE) 2026/1744, aceste obligații se aplică sistemelor din anexa III de la 2 decembrie 2027.
Întrebări frecvente
Pot extrage datele dintr-o factură primită prin e-Factura citind PDF-ul cu un model AI? Poți, dar n-ar trebui. Pentru facturile B2B dintre firme stabilite în România, originalul este fișierul XML cu sigiliul electronic al Ministerului Finanțelor (art. 4 alin. (6) din OUG nr. 120/2021). Îl descarci și îl parsezi determinist; modelul îl păstrezi pentru documentele fără echivalent structurat.
Structured outputs garantează că datele extrase sunt corecte? Nu. Garantează că răspunsul respectă schema: câmpurile există și au tipul cerut. Documentația OpenAI spune explicit că „Structured Outputs can still contain mistakes”, iar cea Gemini recomandă validarea valorilor în aplicație. Corectitudinea o verifică regulile deterministe și, pe excepții, omul.
OCR clasic sau model cu viziune pentru facturi scanate? Modelul cu viziune vede tabelul și chenarele, nu doar textul; OCR-ul clasic dă textul cu coordonate, util la verificare și la evidențierea sursei în revizie. Multe fluxuri le combină; decizia o iei pe setul tău de test.
Ce acuratețe pot aștepta de la extragerea datelor din facturi cu AI? Nu există o cifră care să se transfere de la un flux la altul: depinde de calitatea scanărilor, de varietatea machetelor și de câmpuri. Măsori pe câmp, pe documentele tale, și urmărești separat rata valorilor inventate, pentru că ea produce plățile greșite.
Pot trimite facturi cu date personale către un API de LLM? Da, în condițiile GDPR: contract de prelucrare cu furnizorul (art. 28), doar paginile necesare (art. 5 alin. (1) lit. (c)) și măsuri de securitate adecvate (art. 32). Verifică în termenii furnizorului dacă datele sunt folosite la antrenare, cât sunt păstrate și dacă ai acces la retenție zero sau la procesare în UE.
Concluzie
Extragerea datelor din documente cu LLM ține în producție când fiecare componentă face un singur lucru. Sursele structurate (XML-ul e-Factura, machetele fixe) nu trec prin model. Schema cere transcriere, nu interpretare, și lasă loc pentru „nu știu”. Structured outputs asigură forma, iar codul verifică fondul: CUI-ul, IBAN-ul, totalurile, cotele de TVA raportate la dată, statutul furnizorului la ANAF. Omul decide pe excepții, după reguli scrise, iar corecturile lui alimentează setul de test pe care măsori, câmp cu câmp, fiecare schimbare de model.
Surse
- OUG nr. 120/2021 privind sistemul RO e-Factura, forma consolidată (art. 4, 10, 10^1): https://legislatie.just.ro/Public/DetaliiDocument/247243
- Legea nr. 227/2015 privind Codul fiscal, forma consolidată (art. 291 și art. 319 alin. (20)): https://legislatie.just.ro/Public/DetaliiDocument/171282
- Legea nr. 31/1990 a societăților, forma consolidată (art. 74 alin. (1)): https://legislatie.just.ro/Public/DetaliiDocument/304533
- ONRC, noul format al numărului de ordine în registrul comerțului: https://www.onrc.ro/index.php/ro/?id=1367
- ANAF, serviciul web de verificare a contribuabililor, documentația versiunii 9: https://static.anaf.ro/static/10/Anaf/Informatii_R/Servicii_web/doc_WS_V9.txt
- OpenAI, Structured Outputs: https://developers.openai.com/api/docs/guides/structured-outputs
- Anthropic, Structured outputs: https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- Google, Gemini API, Structured output: https://ai.google.dev/gemini-api/docs/structured-output
- Regulamentul (UE) 2016/679 (GDPR), art. 5, 28 și 32: https://eur-lex.europa.eu/legal-content/RO/TXT/?uri=CELEX:32016R0679
Articol informativ. Sursele au fost consultate la 1 octombrie 2026: actele normative în formele consolidate de pe Portalul Legislativ și EUR-Lex (inclusiv Regulamentele (UE) 2024/1689 și 2026/1744), anunțul ONRC privind noul format al numărului de ordine, Regulamentul BNR nr. 2/2004, documentația și termenii OpenAI, Anthropic și Google. Codul a fost testat cu Pydantic 2.13, openai 3.22 și anthropic 1.11; exemplele numerice și toleranțele sunt ilustrative. Nu constituie consultanță fiscală sau juridică.

Cursul care continuă acest articol
Construire de Aplicații AI cu Python și SDK-uri (OpenAI, Anthropic): de la API la Produs
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- Fundamente: de la API de LLM la mediul tău Python
- Primul apel: chat completions, mesaje și parametri
- Streaming și UX: răspunsuri în timp real
- Function calling / tool use: conectează modelul la codul tău
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.