Un LLM pentru limba română pe care îl poți rula pe serverul tău există deja, dar nu e un singur model și nu are o singură licență. La 21 octombrie 2026, peisajul se împarte între familia OpenLLM-Ro (modele adaptate, majoritatea necomerciale), LLMic (antrenat de la zero, Apache 2.0) și modelele europene multilingve care includ româna, precum EuroLLM. Mai jos găsești cine le face, ce licență are fiecare, ce măsoară benchmark-urile românești și cum alegi fără să te bazezi pe impresii.
Ce înseamnă, concret, „model AI în limba română” în 2026
Când cineva spune „avem nevoie de un model care să știe românește”, de obicei amestecă patru lucruri diferite:
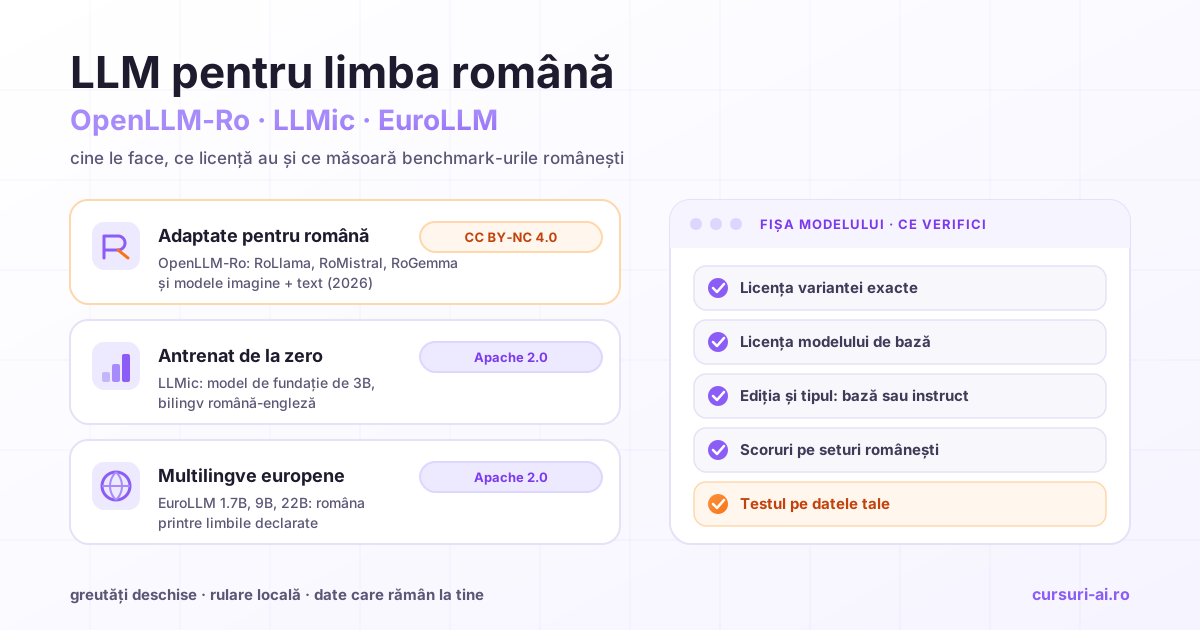
- Modele adaptate pentru română. Pleci de la un model existent (Llama, Mistral, Gemma, Qwen) și îl antrenezi în continuare pe date în română. Așa lucrează comunitatea OpenLLM-Ro.
- Modele antrenate de la zero cu româna în centru. Tokenizer, corpus și antrenare gândite pentru română. Singurul exemplu public pe care l-am găsit cu greutăți descărcabile e LLMic.
- Modele europene multilingve. Proiecte care acoperă toate limbile oficiale ale UE, deci și româna: EuroLLM, Teuken.
- Modele generaliste mari. Familiile open-weight globale, care „se descurcă” în română fără să fie optimizate pentru ea. Aici atenția trebuie să fie pe ce declară furnizorul. Cardul Llama 3.1 de la Meta enumeră opt limbi suportate oficial (engleză, germană, franceză, italiană, portugheză, hindi, spaniolă, thailandeză), iar româna nu e printre ele. Cardul Qwen3-8B vorbește despre „100+ languages and dialects”, fără o listă pe care să o poți verifica limbă cu limbă.
Un lucru trebuie spus direct: nu am găsit un „LLM național” al României finanțat public. Am căutat din nou în octombrie 2026. Proiectul RO AI Factory, găzduit de ICI București și cu kick-off-ul pe 5 octombrie 2026, e infrastructură de calcul și servicii pentru cercetători, firme și instituții. Nu a anunțat un model de limbaj pentru română. Contextul european al acestor fabrici de AI e explicat în articolul despre suveranitatea AI în Europa. Iar dacă te interesează firmele românești care construiesc produse AI, nu modele de limbaj, le găsești în articolul despre unelte AI făcute în România.
Dacă motivul pentru care cauți un model românesc e că datele nu au voie să plece din organizație, întrebarea „care model?” vine abia după întrebarea „cum îl rulez și îl guvernez local?”. Partea asta, de la instalare și cuantizare la citirea licențelor și GDPR, e acoperită în cursul LLM-uri locale cu Ollama: privacy, self-hosting și inferență offline. Cursul are un modul dedicat peisajului modelelor open-weight și unul despre citirea licențelor pentru uz comercial.
OpenLLM-Ro: familia RoLlama, RoMistral și RoGemma
OpenLLM-Ro e o comunitate lansată în mai 2024 de Universitatea Națională de Știință și Tehnologie POLITEHNICA București, Universitatea din București și Institutul de Logică și Știința Datelor, cu sprijinul BRD Groupe Société Générale. Presa de la lansare a mai consemnat că cercetătorii au lucrat pro bono și că POLITEHNICA a pus la dispoziție puterea de calcul. Metoda e descrisă în lucrarea „Vorbești Românește?” A Recipe to Train Powerful Romanian LLMs with English Instructions, publicată în Findings of EMNLP 2024.
Rețeta, pe scurt: modelul de bază e ajustat pe seturi de instrucțiuni traduse automat în română (Alpaca, Dolly, UltraChat și altele) și pe date românești existente. Variantele „DPO” trec apoi printr-o etapă de aliniere pe preferințe.
Ce există în organizația de pe Hugging Face
Pe 21 octombrie 2026, organizația OpenLLM-Ro de pe Hugging Face are 55 de repository-uri de modele. Familiile text sunt:
- RoLlama2 (7B, din Llama 2): variante Base, Instruct, Chat, DPO;
- RoMistral (7B, din Mistral 7B): Instruct și DPO;
- RoLlama3 și RoLlama3.1 (8B, din Llama 3 și Llama 3.1): Instruct și DPO;
- RoGemma (7B) și RoGemma2 (9B, din gemma-2-9b-it): Instruct și DPO.
Fiecare familie are mai multe ediții datate. Ultima rundă de modele text e cea din 23.04.2025 (de exemplu RoLlama3.1-8b-Instruct-2025-04-23). Există și repository-uri fără dată în nume, cum ar fi RoLlama3.1-8b-Instruct: verifică pe card ce ediție conțin înainte să le folosești ca reper.
În 2026 au apărut două lucruri noi:
- Modele vizual-lingvistice (imagine plus text în română), publicate la sfârșitul lui mai 2026: RoGemma3-4B-Instruct, RoQwen2-VL-2B, RoQwen2.5-VL-3B, RoQwen3-VL-2B și RoLlava-Next-Llama3-8B. Lucrarea care le însoțește, „Înțelegi românește?” A Recipe for Romanian Vision-Language Models (Masala, Leordeanu, Dascălu, Rebedea, mai 2026), introduce și setul de evaluare HoraVQA. Setul e construit din imagini cu licență deschisă de pe Wikimedia Commons, cu concepte culturale românești: monumente, mâncare, obiceiuri, viață de zi cu zi.
- RoLlama-3.2-1B, anunțat pe openllm.ro la 12.06.2026. Nu e un model de conversație. E un adaptor LoRA peste Llama-3.2-1B, preantrenat în continuare pe 2,4 miliarde de tokeni (80% română, 20% engleză) pe o singură placă RTX 3090. Cardul spune explicit că e făcut pentru a rula în 4 biți și că e destinat cercetării și ajustărilor ulterioare, nu folosirii directe ca asistent.
Ce spun scorurile publicate (și ce nu spun)
Cardul RoLlama3.1-8b-Instruct-2025-04-23 publică scorurile modelului alături de modelul de bază Llama-3.1-8B-Instruct și de varianta DPO din aceeași rundă. Am copiat valorile exact, fără să le recalculez:
| Set de evaluare (metrică) | Llama-3.1-8B-Instruct | RoLlama3.1-8b-Instruct-2025-04-23 | RoLlama3.1-8b-Instruct-DPO-2025-04-23 |
|---|---|---|---|
| Medie academică, 6 teste traduse (acuratețe %) | 49,87 | 53,36 | 53,76 |
| RoMT-Bench (scor mediu, judecător LLM) | 5,69 | 6,43 | 7,00 |
| RoCulturaBench (scor mediu, judecător LLM) | 3,54 | 4,28 | 4,73 |
| GSM8K tradus (acuratețe %) | 35,56 | 42,03 | 31,54 |
| WMT EN→RO, few-shot (BLEU) | 19,01 | 23,18 | 20,30 |
| XQuAD, few-shot (exact match) | 44,96 | 10,74 | 9,22 |
| STS, few-shot (Spearman) | 72,11 | 73,53 | 30,82 |
Sursa: cardul modelului pe Hugging Face, consultat la 21.10.2026.
Concluzia corectă nu e „modelul adaptat e mai bun”. E mai nuanțată:
- Pe conversație în română (RoMT-Bench) și pe cultură românească (RoCulturaBench), adaptarea aduce câștiguri clare, iar varianta DPO aduce încă unele.
- Pe întrebări cu răspuns extras dintr-un text (XQuAD, few-shot), modelul adaptat pierde masiv față de baza lui: 10,74 față de 44,96. Pentru un asistent care trebuie să citeze exact dintr-un document, asta e o informație mai importantă decât media.
- Varianta DPO câștigă la conversație, dar pierde la raționament matematic (GSM8K) și la similaritate semantică (STS).
Un studiu independent confirmă aceeași lecție. GRILE (Dumitran, Dănilă, Dumitran, august 2025) e un benchmark de 1.151 de întrebări-grilă de gramatică luate din examene românești: Evaluarea Națională, bacalaureat, admitere. Autorii raportează că Gemini 2.5 Pro ajunge la 83% acuratețe, în timp ce majoritatea modelelor open-weight rămân sub 65%. În experimentele few-shot, modelul de bază gemma-2-9b-it a avut o medie de 47,13%, peste toate variantele RoGemma2-9B, care au stat în jur de 39–42%. Adaptarea pentru română nu îmbunătățește automat fiecare abilitate în română.
La modelele vizual-lingvistice, cardul RoGemma3-4B-Instruct raportează o medie micro de 59,54, față de 55,53 pentru Gemma3-4B-it. Cel mai mare câștig e la documente în română (RoFinepdfs: 84,35 față de 67,12). Pe seturile culturale CVQA și ALM-Bench, modelul de bază rămâne ușor peste.
LLMic: model de fundație bilingv, antrenat de la zero
LLMic e lucrarea unei echipe de la POLITEHNICA București (Bădoiu, Dumitru, Gherghescu, Agache, Raiciu), publicată în ianuarie 2025. Greutățile stau în organizația faur-ai de pe Hugging Face. Ce declară cardul și lucrarea:
- 3 miliarde de parametri, arhitectură decoder-only de tip Llama 2, context de 2.048 de tokeni;
- antrenat pe 300 de miliarde de tokeni în română și 700 de miliarde în engleză;
- licență Apache 2.0, deci uz comercial permis;
- e un model de fundație, nu un asistent de conversație. E gândit ca bază pentru ajustări.
Două detalii schimbă felul în care citești rezultatele:
- Prima versiune lucra pe text fără majuscule și fără diacritice. Scorul de 41,01 BLEU pe WMT16 EN→RO, citat des, a fost obținut după o ajustare dedicată traducerii, pe date de test transformate în litere mici și fără diacritice. Nu e comparabil direct cu scorurile few-shot ale RoLlama din tabelul de mai sus.
- LLMic_v2, publicat pe 8 ianuarie 2026, păstrează aceeași arhitectură, dar adaugă majuscule și diacritice, conform cardului. Pentru orice text care ajunge la oameni, asta e versiunea de luat în calcul. Cardul v2 nu publică scoruri proprii.
LLMic e alegerea naturală dacă vrei să faci tu ajustarea (traducere, clasificare, extragere) și ai nevoie de licență permisivă pe un model mic. Nu e alegerea potrivită dacă vrei un asistent conversațional gata făcut.
EuroLLM, Teuken și modelele europene care includ româna
EuroLLM e un proiect finanțat de Uniunea Europeană, dezvoltat de un consorțiu din care fac parte Instituto Superior Técnico (Lisabona), Universitatea din Edinburgh, Unbabel, Universitatea Paris-Saclay, Universitatea din Amsterdam, Naver Labs, Sorbonne și alții. Cardurile enumeră 35 de limbi, printre care româna. În organizația utter-project găsești:
- EuroLLM-1.7B și EuroLLM-1.7B-Instruct;
- EuroLLM-9B-2512 și EuroLLM-9B-Instruct-2512, o versiune îmbunătățită a lui 9B, cu context extins;
- EuroLLM-22B-2512 și EuroLLM-22B-Instruct-2512: 22,6 miliarde de parametri, antrenat pe aproximativ 4.000 de miliarde de tokeni pe supercomputerul MareNostrum5, cu context de 32.768 de tokeni;
- EuroMoE-2.6B-A0.6B, un model mixture-of-experts cu 0,6 miliarde de parametri activi.
Toate acestea sunt sub Apache 2.0. Cardul 22B face două precizări de reținut: autorii afirmă că modelul e foarte bun la traducere între limbile UE, iar modelul „nu a fost aliniat la preferințe umane”, deci poate produce conținut problematic. Pentru un asistent public, ai nevoie de propriile filtre și de evaluare.
Teuken-7B (proiectul german OpenGPT-X: Fraunhofer, Forschungszentrum Jülich, TU Dresden, DFKI) acoperă cele 24 de limbi oficiale ale UE, inclusiv româna. E un exemplu bun pentru că aceeași familie are licențe diferite pe variante: Teuken-7B-instruct-commercial-v0.4 e sub Apache 2.0 și declarat pentru uz comercial, în timp ce Teuken-7B-instruct-v0.6 e sub CC BY-NC 4.0. Ambele cer acceptarea condițiilor pe Hugging Face înainte de descărcare.
Tabelul: cine, ce dimensiuni, ce licență
Tabelul conține doar ce scrie pe cardurile modelelor la 21.10.2026. Coloana „uz comercial” e o lectură a licenței, nu consultanță juridică.
| Model / familie | Cine îl publică | Dimensiuni | Licență (pe card) | Uz comercial | Unde îl găsești |
|---|---|---|---|---|---|
| RoLlama3 / RoLlama3.1 (Instruct, DPO) | OpenLLM-Ro | 8B | CC BY-NC 4.0 | Nu | Hugging Face, OpenLLM-Ro |
| RoMistral (Instruct, DPO) | OpenLLM-Ro | 7B | CC BY-NC 4.0 | Nu | Hugging Face, OpenLLM-Ro |
| RoGemma / RoGemma2 (Instruct, DPO) | OpenLLM-Ro | 7B / 9B | CC BY-NC 4.0 | Nu | Hugging Face, OpenLLM-Ro |
| RoLlama2-7b-Base | OpenLLM-Ro | 7B | Llama 2 Community License | Da, în condițiile Meta | Hugging Face, OpenLLM-Ro |
| RoLlama-3.2-1B (adaptor LoRA, model de bază) | OpenLLM-Ro | 1B | Llama 3.2 Community License | Da, în condițiile Meta | Hugging Face, OpenLLM-Ro |
| RoGemma3, RoQwen2-VL, RoQwen2.5-VL, RoQwen3-VL, RoLlava-Next (imagine + text) | OpenLLM-Ro | 2B–8B | CC BY-NC 4.0 | Nu | Hugging Face, OpenLLM-Ro |
| LLMic / LLMic_v2 (model de fundație) | echipă POLITEHNICA București (faur-ai) | 3B | Apache 2.0 | Da | Hugging Face, faur-ai |
| EuroLLM 1.7B / 9B / 22B, EuroMoE 2.6B | consorțiu EuroLLM, finanțare UE | 1.7B–22B | Apache 2.0 | Da | Hugging Face, utter-project |
| Teuken-7B-instruct-commercial-v0.4 | OpenGPT-X | 7B | Apache 2.0 (acces după acceptarea condițiilor) | Da | Hugging Face, openGPT-X |
| Teuken-7B-instruct-v0.6 | OpenGPT-X | 7B | CC BY-NC 4.0 | Nu | Hugging Face, openGPT-X |
Ce înseamnă licența, practic
CC BY-NC 4.0 e licența aproape tuturor modelelor instruct și vizual-lingvistice OpenLLM-Ro. Textul juridic definește „NonCommercial” ca folosire care nu e „în principal destinată sau orientată spre avantaj comercial sau compensație bănească”. Pentru o firmă care integrează modelul într-un produs, situația e clară: nu. Nici folosirea strict internă într-o firmă nu se separă ușor de avantajul comercial. Pentru o universitate care face cercetare, situația e de obicei în regulă. Pentru o instituție publică, depinde de ce face cu el, iar decizia se ia cu juristul, nu cu inginerul. Cardurile OpenLLM-Ro descriu modelele ca destinate cercetării în limba română și trec folosirea în alte limbi în afara scopului.
Licența modelului de bază se adaugă, nu dispare. RoLlama3.1 e construit din Llama 3.1, iar cardul afișează „Built with Meta Llama 3.1”. Licența Llama 3.1 cere, între altele, mențiunea „Built with Llama” când distribui modelul sau un produs care îl conține. Mai cere o licență separată de la Meta dacă ai peste 700 de milioane de utilizatori activi lunar. RoGemma moștenește termenii Gemma de la Google. Pentru RoLlama-3.2-1B se aplică licența Llama 3.2. Restricția pentru UE din politica de utilizare Llama 3.2 vizează doar modelele multimodale, nu varianta text de 1B.
Apache 2.0 (LLMic, EuroLLM, Teuken commercial) permite uz comercial, modificare și redistribuire, cu obligația de a păstra notificările de licență. Diferența dintre „open-weight” și „open source” e explicată în articolul despre LLM local cu Ollama și self-hosting. Dacă modelul ajunge într-un produs pentru clienți din UE, obligațiile din AI Act se adaugă peste licență. Le găsești rezumate în articolul despre EU AI Act pentru companiile românești.
Citirea licențelor pentru uz comercial (Apache 2.0, licențele Llama și Gemma, auditul intern al modelelor folosite) are un modul separat în cursul LLM-uri locale cu Ollama.
Secțiunea are caracter informativ și nu înlocuiește consultanța juridică de specialitate pentru cazul tău.
Benchmark-uri pentru limba română: ce măsoară fiecare
Un scor fără contextul setului de evaluare nu spune nimic. Iată ce se află în spatele numelor pe care le vei vedea pe carduri:
- Teste academice traduse (ARC, MMLU, Winogrande, HellaSwag, GSM8K, TruthfulQA). Sunt versiuni românești ale unor teste englezești, traduse automat. Lucrarea OpenLLM-Ro menționează traduceri cu ChatGPT pentru o parte și cu un sistem de traducere automată pentru restul. Măsoară raționament și cunoștințe generale, dar moștenesc stângăciile traducerii și contextul cultural al originalelor.
- LaRoSeDa. Clasificarea sentimentului în recenzii de produse dintr-un magazin online românesc, set publicat de Universitatea din București. Măsoară înțelegerea limbii reale, cu greșeli și argou.
- WMT EN↔RO. Traducere, măsurată în BLEU. BLEU penalizează orice formulare diferită de referință, chiar dacă e corectă.
- XQuAD (partea în română). Răspuns extras exact dintr-un paragraf. E cel mai apropiat de un asistent pe documente.
- STS. Cât de bine apreciază modelul similaritatea a două propoziții.
- RoMT-Bench. MT-Bench tradus manual în română: conversații în două replici, punctate de un model judecător (GPT-4o, conform lucrării). Răspunsurile care nu sunt în română primesc 0. De aceea cardurile raportează și „Answers in Ro: 160/160”.
- RoCulturaBench. 100 de cereri din 10 domenii, construite manual de cercetători români din științele umaniste, cu răspunsuri de referință. Le punctează tot un judecător LLM.
- GRILE. 1.151 de grile de gramatică din examene românești, plus evaluarea explicațiilor de către un expert lingvist.
- HoraVQA. Întrebări despre imagini cu conținut cultural românesc, pentru modelele vizual-lingvistice.
Codul de evaluare al OpenLLM-Ro e public pe GitHub, în fork-uri ale lm-evaluation-harness și FastChat, deci poți rula aceleași teste pe un model nou. Nu am găsit un clasament public întreținut care să compare la zi toate modelele de mai sus pe aceleași seturi. Orice comparație dintre familii o faci tu, cu aceleași setări.
Cum alegi: patru întrebări, în ordinea asta
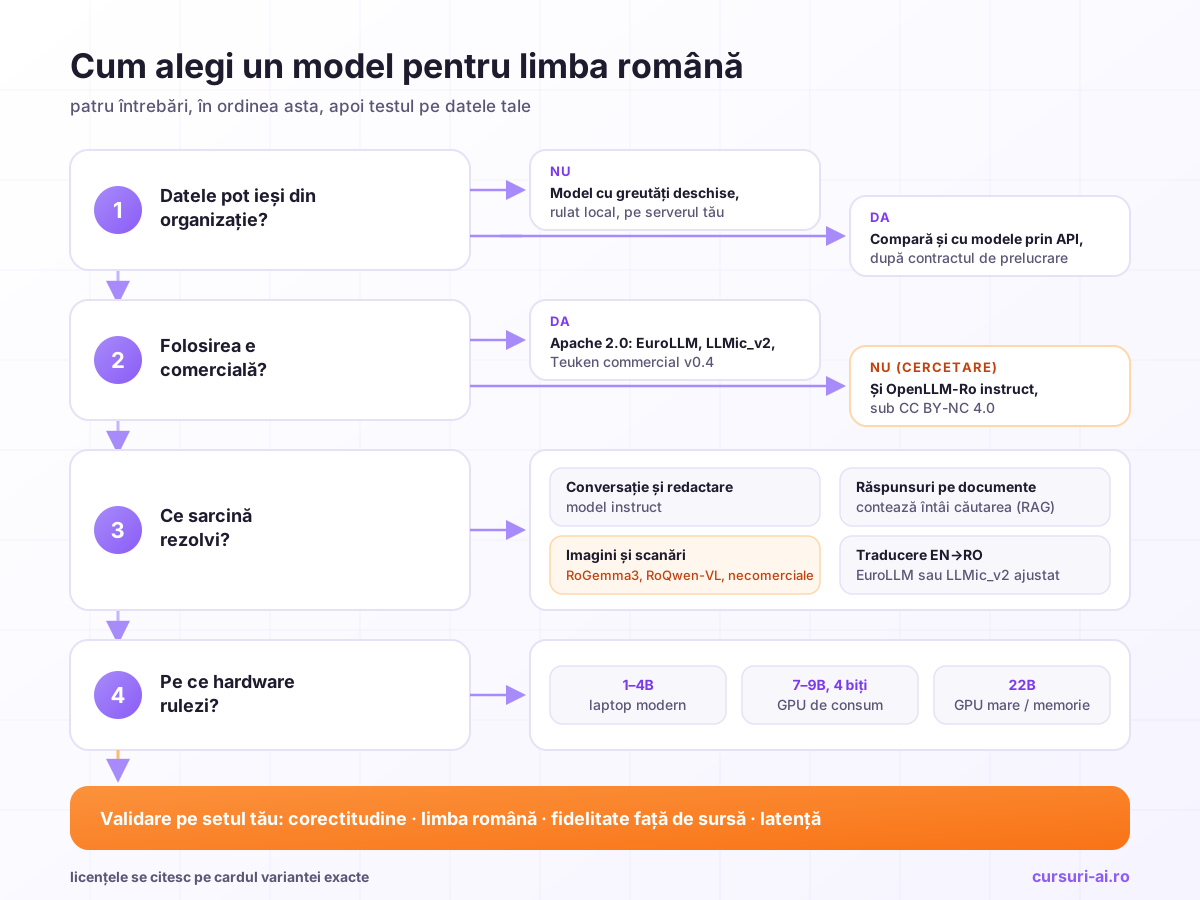
1. Datele au voie să iasă din organizație? Dacă nu, rămâi la modele cu greutăți deschise rulate local, iar lista de mai sus e punctul de plecare. Dacă da, compară și cu modelele comerciale prin API, cu contractul de prelucrare a datelor citit înainte. Regulile pentru datele clienților sunt în ghidul despre datele clienților în ChatGPT și GDPR.
2. Folosirea e comercială? Dacă da, OpenLLM-Ro instruct iese din discuție. Rămân LLMic (de ajustat), EuroLLM, Teuken commercial v0.4, modelele OpenLLM-Ro sub licențele Meta (RoLlama2-Base, RoLlama-3.2-1B, ambele modele de bază) și modelele generaliste cu licență permisivă, pe care le testezi în română. Dacă lucrezi în cercetare sau într-un context clar necomercial, familia OpenLLM-Ro devine opțiunea cea mai specializată.
3. Ce sarcină rezolvi?
- Conversație și redactare în română: un model instruct. Aici RoMT-Bench e semnalul public cel mai relevant.
- Răspunsuri pe documentele tale: contează mai puțin modelul și mai mult pipeline-ul de căutare. Atenție la scorul XQuAD de mai sus. Problemele specifice românei (OCR, diacritice, segmentare, căutare hibridă) sunt tratate în RAG pe documente românești.
- Documente scanate și imagini: modelele vizual-lingvistice RoGemma3 și RoQwen-VL, cu licența necomercială în minte.
- Traducere EN→RO pe volum: EuroLLM, care declară explicit traducerea ca punct forte, sau un LLMic_v2 ajustat pe perechile tale.
- Clasificare, extragere, rutare: un model mic (1–4B) ajustat pe exemplele tale poate ajunge suficient și e mai ieftin de rulat decât un model mare, dacă ai date etichetate; confirmi pe setul tău de evaluare.
- Vorbire: e altă clasă de modele, prezentată în articolul despre transcrierea în limba română.
4. Pe ce hardware? Un model de 1–4B rulează pe un laptop modern. 7–9B la 4 biți încape pe o placă grafică de consum. 22B cere o placă mare sau memorie unificată generoasă. Calculul exact (parametri × biți plus rezervă) și diferența dintre LM Studio și Ollama sunt în ghidul de hardware pentru LLM local.
Cum îl rulezi local: doar pașii documentați
Cu Transformers, cum arată cardurile. Toate modelele text de mai sus se încarcă din Python cu AutoTokenizer și AutoModelForCausalLM, cu ID-ul repository-ului. Exemplul de pe cardul RoLlama3.1:
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("OpenLLM-Ro/RoLlama3.1-8b-Instruct-2025-04-23")
model = AutoModelForCausalLM.from_pretrained("OpenLLM-Ro/RoLlama3.1-8b-Instruct-2025-04-23")
Excepție: RoLlama-3.2-1B e un adaptor. Cardul îl încarcă peste meta-llama/Llama-3.2-1B în 4 biți (nf4, prin bitsandbytes), cu biblioteca PEFT.
GGUF și Ollama. În organizațiile OpenLLM-Ro, utter-project și faur-ai nu există fișiere GGUF oficiale. OpenLLM-Ro a publicat doar câteva variante cuantizate în 4 biți (bitsandbytes, GPTQ) pentru modele mai vechi. Pe Hugging Face există însă conversii GGUF făcute de terți, de exemplu pentru RoLlama3.1-8b-Instruct-2025-04-23, EuroLLM-9B-Instruct-2512 și EuroLLM-22B-Instruct-2512. Nu sunt publicate de autori. Verifică cine le-a făcut și din ce versiune, iar licența rămâne cea a modelului original.
Pentru un GGUF de pe Hugging Face, documentația Hugging Face pentru Ollama dă forma ollama run hf.co/{utilizator}/{repository}:{cuantizare}. Fără tag, se alege implicit Q4_K_M, dacă există în repository. Pentru un fișier GGUF local, documentația Ollama de import folosește un Modelfile cu FROM /cale/catre/model.gguf, urmat de ollama create nume-model. Ollama nu re-cuantizează un GGUF la import, deci cuantizarea o alegi înainte. Pentru LLMic nu am găsit nicio conversie GGUF publică.
Dacă ținta e un asistent intern pentru mai mulți colegi, cu autentificare, roluri și jurnal de audit, arhitectura completă e în ChatGPT intern pentru firmă: LLM self-hosted pe serverul tău.
Evaluarea pe datele tale: de ce benchmark-urile publice nu ajung
Tabelul RoLlama3.1 arată de ce: același model urcă la conversație și coboară la extragere exactă. Media nu îți spune pe care parte a tabelului stă sarcina ta. Apoi, setul de evaluare e tradus, nu scris pentru domeniul tău. Iar două dintre seturi sunt punctate de un alt model AI, care are propriile preferințe.
Un set de evaluare intern util măsoară:
- corectitudinea față de o referință scrisă de un om din domeniu, pe întrebări reale din organizație;
- limba și forma: răspunde în română, cu ș și ț cu virgulă, nu cu sedilă, păstrează registrul cerut (diacriticele și registrul sunt discutate în ghidul de scriere corectă în română cu AI);
- fidelitatea față de sursă, dacă modelul lucrează pe documente: citează sau inventează?
- comportamentul la limită: refuză ce trebuie, nu refuză ce nu trebuie;
- costul operațional: latență și memorie pe hardware-ul tău, în cuantizarea pe care o vei folosi efectiv, nu în cea din card.
Compară cel puțin un model adaptat pentru română cu un model generalist de aceeași mărime, pe aceleași întrebări și cu aceiași parametri. Metodologia (set de referință, scoruri, judecători LLM, teste de regresie) e explicată în articolul despre cum evaluezi un model AI în producție.
Dacă evaluarea arată un gol constant, de exemplu terminologie de specialitate sau un format fix de răspuns, abia atunci ajustarea devine o opțiune serioasă. Cursul Fine-tuning și adaptarea modelelor AI acoperă designul seturilor SFT, LoRA și QLoRA, alinierea cu DPO și evaluarea înainte și după. Rețetele OpenLLM-Ro pornesc de la aceleași principii. Dacă golul ține de cunoștințe care se schimbă (proceduri, norme interne), soluția e de obicei căutarea în documente, nu ajustarea. Cursul RAG: Retrieval-Augmented Generation în practică tratează exact acest drum, iar articolul despre când merită fine-tuning-ul te ajută să tranșezi între cele două.
Scenariu ilustrativ: asistent intern într-o instituție care nu poate trimite date în afară
Scenariu ilustrativ, construit pentru a arăta raționamentul. Nu descrie o instituție reală.
O instituție publică vrea un asistent care să răspundă angajaților, în română, pe baza procedurilor interne și a corespondenței arhivate. Documentele conțin date personale și nu au voie să plece de pe serverele proprii.
- Datele rămân local. Lista se reduce la modele cu greutăți deschise.
- Licența. Juristul instituției analizează dacă folosirea internă intră în definiția „NonCommercial” din CC BY-NC 4.0. Până la un răspuns ferm, echipa tehnică pune pe lista scurtă un model cu licență permisivă (EuroLLM-9B-Instruct-2512, Apache 2.0) și un model RoLlama3.1 doar ca reper de comparație în faza de test.
- Sarcina. Întrebări pe documente, deci prioritatea e pipeline-ul de căutare (OCR, diacritice, căutare hibridă). Modelul generează doar răspunsul pe baza fragmentelor găsite.
- Hardware. Un server cu un singur GPU. Ambele modele încap în cuantizare de 4 biți.
- Evaluare. 150 de întrebări reale, cu răspunsuri de referință scrise de doi angajați cu experiență, punctate pe corectitudine, fidelitate față de sursă și limbă. Decizia se ia pe aceste cifre, nu pe cele de pe carduri.
- Guvernanță. Jurnal al întrebărilor, cu retenție stabilită, analiză de impact privind protecția datelor și o regulă scrisă despre ce nu se întreabă asistentul.
Rezultatul nu e dinainte cunoscut. Exact de aceea pasul 5 există.
Checklist înainte să alegi un model pentru română
- Ai citit licența pe cardul variantei exacte pe care o descarci, nu pe cel al familiei?
- Ai citit și licența modelului de bază (Llama, Gemma, Qwen, Mistral)?
- Știi dacă folosirea ta e comercială și ai acordul juristului, unde e cazul?
- Ai verificat data ediției (de exemplu 2025-04-23) și ce indică repository-urile fără dată?
- Știi dacă modelul e de bază sau instruct? LLMic și RoLlama-3.2-1B nu sunt asistenți gata de folosit.
- Ai verificat cine a făcut conversia GGUF, dacă folosești una?
- Ai un set de evaluare intern, cu referințe scrise de oameni din domeniu?
- Ai comparat cu un model generalist de aceeași mărime, în aceleași condiții?
- Ai stabilit cum se jurnalizează și cât se păstrează conversațiile?
Întrebări frecvente
Există un LLM românesc open source pe care îl pot folosi comercial? Da, cu precizări. LLMic și LLMic_v2 sunt sub Apache 2.0, dar sunt modele de fundație de 3B, gândite pentru ajustare, nu pentru conversație directă. Dintre modelele multilingve, EuroLLM (1.7B, 9B, 22B) și Teuken-7B-instruct-commercial-v0.4 sunt sub Apache 2.0 și includ româna. Modelele instruct OpenLLM-Ro sunt sub CC BY-NC 4.0, deci nu.
Este RoLlama mai bun decât Llama la română? Depinde de sarcină. Pe cardul RoLlama3.1-8b-Instruct-2025-04-23, modelul adaptat câștigă la RoMT-Bench (6,43 față de 5,69) și la RoCulturaBench (4,28 față de 3,54), dar pierde puternic la XQuAD few-shot (10,74 față de 44,96). Testează-l pe sarcina ta.
Pot rula aceste modele cu Ollama?
Da, dacă ai un fișier GGUF. Autorii nu publică GGUF oficial, dar pentru mai multe modele există conversii făcute de terți pe Hugging Face, care se rulează cu ollama run hf.co/{utilizator}/{repository}. Pentru un GGUF local folosești un Modelfile cu FROM și ollama create.
Ce benchmark să folosesc pentru limba română? Pentru conversație, RoMT-Bench. Pentru cultură, RoCulturaBench. Pentru gramatică, GRILE. Pentru imagini, HoraVQA. Pentru decizia finală, însă, un set intern construit din întrebările reale ale organizației tale. Benchmark-urile publice îți spun ce modele merită testate, nu care e cel potrivit pentru tine.
A lansat statul român un model AI național? Până la 21 octombrie 2026 nu am găsit un model de limbaj pentru română finanțat public. RO AI Factory, lansat la ICI București pe 5 octombrie 2026, oferă infrastructură de calcul și servicii, nu un model anunțat.
Concluzie
Un LLM pentru limba română nu se alege după nume și nici după media de pe card. OpenLLM-Ro oferă cele mai specializate modele adaptate, dar aproape toate sunt necomerciale, iar scorurile lor arată câștiguri la conversație și pierderi la extragerea exactă. LLMic_v2 e baza permisivă pentru cine vrea să ajusteze singur. EuroLLM și Teuken commercial acoperă cazul comercial cu modele multilingve sub Apache 2.0. Ordinea corectă rămâne aceeași: unde stau datele, ce permite licența, ce sarcină rezolvi, ce hardware ai și, la final, cum se comportă candidații pe întrebările tale.
Surse și resurse oficiale
- OpenLLM-Ro: openllm.ro (comunitatea, istoricul lansărilor și linkurile spre modele) și cardul RoLlama3.1-8b-Instruct-2025-04-23, de unde sunt scorurile citate.
- Lucrări: OpenLLM-Ro, Findings of EMNLP 2024, modelele vizual-lingvistice românești și HoraVQA (arXiv, 2026), GRILE (arXiv, 2025), LLMic (arXiv, 2025).
- Modele cu licență permisivă: LLMic_v2 și EuroLLM (organizația utter-project). Teuken-7B se găsește în organizația openGPT-X de pe Hugging Face.
- Licențe: CC BY-NC 4.0, text juridic și Llama 3.1 Community License. Termenii Gemma sunt publicați de Google pe ai.google.dev.
- Rulare locală: Ollama cu fișiere GGUF de pe Hugging Face; importul unui GGUF local e descris în documentația Ollama, la secțiunea „Import”.
Verificat la 21 octombrie 2026, pe cardurile modelelor de pe Hugging Face, pe lucrările citate și pe documentația oficială Ollama și Hugging Face. Modelele, edițiile și licențele se schimbă: reverifică pe card înainte de orice decizie.

Cursul care continuă acest articol
LLM-uri Locale cu Ollama: Privacy, Self-Hosting și Inferență Offline
Ai citit teoria. În curs o aplici: lecții structurate pe module, exerciții și quiz-uri cu feedback imediat, Profesorul AI integrat în fiecare lecție și progres salvat automat. La final primești o atestare privată de finalizare.
Din programa cursului
- De Ce LLM Local: Privacy, Data Residency și Cadrul Legal ca Motoare de Adopție
- Instalare și Fundamente Ollama: Primul Model și API-ul REST OpenAI-Compatible
- Peisajul Modelelor Open-Weight 2026: Criterii Reale de Alegere
- Cuantizare și Hardware: GGUF, q4_K_M vs q8_0 și Dimensionare Realistă
+ încă 7 module în programa completă
499 lei pe lună pentru acest curs, TVA 21% inclus · sau 1.999 lei pe lună pentru toate cele 25 de cursuri IT Pro (vezi ce înveți în tot parcursul).
Abonament lunar, cu reînnoire automată · anulezi oricând din contul tău · conținut digital cu acces imediat, vezi condițiile de retragere. Atestarea confirmă parcurgerea cursului și este privată — nu este diplomă și nu este calificare recunoscută de stat.